

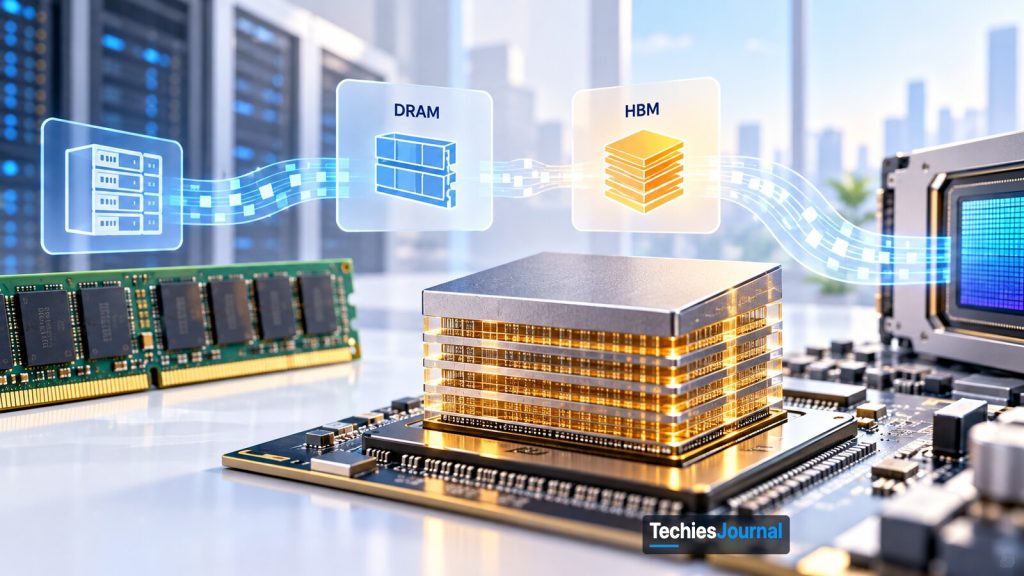
La DRAM conventionnelle et la mémoire à haute bande passante jouent des rôles différents dans les systèmes de calcul d’IA. Illustration conceptuelle éditoriale fournie par le propriétaire du site ; il ne s’agit ni d’une disposition physique précise ni d’une photographie de produit d’un fabricant.
Les processeurs d’IA ont besoin d’une mémoire capable de conserver les données et de les fournir assez vite. Découvrez comment la DRAM, la HBM, l’encapsulation avancée et la concurrence entre fabricants de mémoire influent sur le calcul d’IA et sur son coût.
Un processeur d’IA dépend de la mémoire qui l’alimente
Un accélérateur d’IA travaille sur des données, et ces données doivent bien venir de quelque part. La mémoire contient les données que traite le processeur, et elle doit les lui fournir assez vite pour qu’il reste occupé. Quand la mémoire ne suit pas, le processeur attend.
Deux propriétés comptent. La capacité est la quantité de données que la mémoire peut contenir. La bande passante est la quantité de données qu’elle peut déplacer par seconde ; pour la mémoire à haute bande passante, SK hynix la décrit comme la capacité totale de données qu’un boîtier mémoire peut traiter par seconde.
C’est pourquoi la mémoire est devenue un sujet à part entière dans l’infrastructure d’IA. Un processeur plus rapide ne sert pas à grand-chose si la mémoire placée à côté de lui ne peut pas fournir les données au même rythme, et la meilleure mémoire ne sert à rien si l’on ne peut pas en fabriquer suffisamment.
DRAM conventionnelle et HBM ne font pas le même travail
La DRAM conventionnelle est la mémoire qu’utilisent depuis longtemps la plupart des systèmes informatiques. Dans les serveurs, elle se présente généralement sous forme de modules tels que les RDIMM, et TrendForce rapporte que les fournisseurs cloud et les fabricants de serveurs achètent davantage de bits pour répondre à la demande de RDIMM destinés aux serveurs généralistes qui prennent en charge des charges de travail d’IA agentique (TrendForce, 30 septembre 2026).
La mémoire à haute bande passante, ou HBM, est construite différemment. SK hynix la décrit comme l’interconnexion verticale de plusieurs puces DRAM, ce qui augmente considérablement la vitesse de traitement des données par rapport à la DRAM conventionnelle, et Micron la qualifie de DRAM empilée en 3D conçue pour l’IA, le calcul haute performance et les charges de travail intensives en données. SK hynix compte la HBM4 comme la sixième génération, après la HBM d’origine, la HBM2, la HBM2E, la HBM3 et la HBM3E.
| Aspect | DRAM conventionnelle | HBM |
|---|---|---|
| Construction | Puces DRAM montées sur des modules tels que les RDIMM pour serveurs | Plusieurs puces DRAM empilées et interconnectées, avec une puce de base par pile |
| Place dans les systèmes d’IA | Mémoire principale des serveurs généralistes, y compris ceux qui exécutent des charges de travail d’IA agentique | Mémoire associée aux accélérateurs d’IA, conçue pour un débit de données très élevé |
| Ce qui limite l’offre | Capacité en procédés avancés et en plaquettes (wafers) | La même capacité en procédés avancés et en plaquettes, avec des rendements et une production de produits de nouvelle génération encore en montée en charge |
| Évolution des coûts | Des prix contractuels qui, selon les projections de TrendForce, augmenteront au quatrième trimestre 2026 | Une puce de base par pile, si bien que le coût ne baisse pas proportionnellement au nombre de couches |
Les deux ne sont pas des mondes séparés. TrendForce rapporte que la croissance continue de la demande en serveurs d’IA maintient la HBM et la DRAM conventionnelle en concurrence pour une capacité limitée en procédés avancés et en plaquettes. Sources : TrendForce, 29 septembre 2026, TrendForce, 30 septembre 2026, SK hynix et Micron.
La HBM4 fait progresser les chiffres, selon les fabricants
Le principal changement de la HBM4 est une interface plus large. SK hynix indique avoir doublé le nombre de terminaux d’E/S par rapport à la génération précédente, pour le porter à 2048, et Samsung décrit le même passage de 1024 à 2048 broches. Une interface plus large et une vitesse plus élevée par broche augmentent toutes deux la quantité de données qu’une pile peut déplacer.
La vitesse par broche est le second levier. La vitesse de fonctionnement standard de la JEDEC pour la HBM4 est de 8 Gbps par broche, et chaque fabricant annonce fonctionner au-delà. Multiplier le nombre de broches par la vitesse puis diviser par huit donne un pic théorique par pile : c’est le calcul que suivent les chiffres ci-dessous.
Ce que la vitesse par broche change pour une pile HBM4
Sélectionnez une vitesse par broche pour voir la bande passante maximale théorique d’une pile dotée d’une interface de 2048 broches.
8 Gbps
Calcul de TechiesJournal : 2048 × 8 Gbps ÷ 8 = 2,05 TB/s
La vitesse de fonctionnement standard de la JEDEC pour la HBM4, que SK hynix mentionne et que Samsung appelle la norme du secteur. Les fabricants annoncent fonctionner au-delà.
Plus de 10 Gbps
Calcul de TechiesJournal : 2048 × 10 Gbps ÷ 8 = 2,56 TB/s
SK hynix annonce des vitesses de fonctionnement supérieures à 10 Gbps pour sa HBM4, sans donner de chiffre de bande passante. Cette ligne prend 10 Gbps comme plancher : le chiffre réel est donc plus élevé.
11,7 Gbps
Calcul de TechiesJournal : 2048 × 11,7 Gbps ÷ 8 = 3,00 TB/s
Samsung annonce une vitesse constante de 11,7 Gbps. Micron annonce plus de 11 Gb/s et plus de 2,8 TB/s, ce qui concorde avec le même calcul.
13 Gbps
Calcul de TechiesJournal : 2048 × 13 Gbps ÷ 8 = 3,33 TB/s
Samsung indique que sa HBM4 peut monter jusqu’à 13 Gbps, soit un maximum de 3,3 TB/s par pile, ce qui correspond à ce résultat.
Un pic théorique par pile, calculé à partir de la largeur de l’interface et de la vitesse par broche. Ce n’est pas le débit d’un système complet, et les chiffres sont ceux des fabricants eux-mêmes.
Les trois fabricants décrivent leur HBM4 de manières différentes, à des dates différentes et sur des bases de test différentes. Le tableau rassemble ce que chacun a annoncé : c’est un relevé d’affirmations, pas un banc d’essai.
| Entreprise | Stade annoncé | Vitesse par broche | Bande passante par pile | Efficacité énergétique annoncée et référence indiquée |
|---|---|---|---|---|
| SK hynix | Développement achevé et système de production en série prêt, 12 septembre 2025 | Plus de 10 Gbps | Doublée par rapport à la génération précédente | Améliorée de plus de 40 %, sans référence indiquée dans le communiqué |
| Samsung | Production en série lancée et livraisons commerciales, 12 février 2026 | 11,7 Gbps, jusqu’à 13 Gbps | Jusqu’à 3,3 TB/s | Meilleure de 40 % que la HBM3E |
| Micron | Production en grand volume de HBM4 de 36 GB à 12 couches, selon sa page produit | Plus de 11 Gb/s | Plus de 2,8 TB/s, selon les tests internes de Micron | Meilleure de plus de 20 % que la HBM3E |
La capacité dépend du nombre de couches empilées. Samsung propose de la HBM4 de 24 Go à 36 Go avec un empilement de 12 couches et prévoit un empilement de 16 couches pour atteindre jusqu’à 48 Go, tandis que la page produit de Micron mentionne une pile de 36 Go à 12 couches. SK hynix indique aussi s’attendre à des performances de service d’IA jusqu’à 69 % supérieures grâce à sa HBM4, une projection de l’entreprise qui dépend du système qui l’entoure.
Comme le stade, la date et la base de test diffèrent, il ne faut pas classer les trois lignes les unes par rapport aux autres. La comparaison utile est celle qu’un acheteur ferait avec un accélérateur précis, à une hauteur de pile précise et pour une charge de travail précise. Sources : SK hynix, 12 septembre 2025, Samsung, 12 février 2026 et Micron.
L’offre et le coût déterminent ce qui se construit
La mémoire n’est pas qu’une question de performances. TrendForce s’attend à ce que l’offre de HBM reste contrainte jusqu’en 2027 et a revu à la hausse ses perspectives de prix de la HBM pour 2027, avec une hausse projetée de 121 % sur un an du prix de vente moyen toutes gammes confondues. Ce sont des prévisions, qui dépendent de rendements, d’une production et d’une demande susceptibles d’évoluer.
Une réponse consiste à modifier la quantité de HBM que porte chaque accélérateur. TrendForce rapporte que les fabricants de GPU et d’ASIC envisagent des piles à 8 couches à la place des piles à 12 couches prévues initialement, en raison d’une offre limitée et de la hausse des coûts des systèmes, et non d’une demande plus faible. Moins de couches réduisent le coût par pile et permettent à une même production de HBM d’équiper davantage d’accélérateurs.
Pourquoi une pile à 8 couches n’est pas moins chère par gigabit
Passez d’une pile HBM à 12 couches à une pile à 8 couches pour voir ce qui est partagé et ce qui ne l’est pas.
Pile à 12 couches
Douze couches DRAM se partagent le coût d’une seule puce de base. Selon TrendForce, les plans initiaux de nombreux GPU et ASIC reposaient sur cette hauteur.
Pile à 8 couches
Huit couches réduisent le coût par pile et le coût global des composants de l’accélérateur. Le coût de la puce de base ne baisse pas en proportion, si bien que le coût par gigabit est plus élevé. TrendForce prévoit un surcoût d’environ 10 à 20 % par gigabit en 2027 ; il s’agit d’une prévision.
Une représentation simplifiée de l’explication de TrendForce, pas un modèle de coûts. Les seuls chiffres sont ceux de la prévision de TrendForce.
Moins de couches ne rendent pas pour autant la mémoire moins chère par gigabit. Chaque pile HBM nécessite une puce de base dont le coût ne baisse pas proportionnellement au nombre de couches DRAM ; une pile à 8 couches répartit donc ce coût sur une capacité moindre. TrendForce prévoit que les produits à 8 couches coûteront environ 10 à 20 % de plus par gigabit que les produits à 12 couches en 2027, et ne s’attend pas à ce que les réductions de capacité inversent la tendance générale à la hausse des prix de la HBM.
La DRAM conventionnelle subit la même pression. TrendForce prévoit une hausse de 10 à 15 % d’un trimestre à l’autre des prix contractuels de la DRAM conventionnelle au quatrième trimestre 2026, indique que les fournisseurs continuent de donner la priorité à la capacité en procédés avancés pour les produits serveurs haute performance, et s’attend à ce que l’offre de DRAM pour serveurs reste insuffisante au quatrième trimestre 2026. Le cabinet cite parmi les contraintes l’approvisionnement en composants, la capacité d’encapsulation et de test, et la flexibilité de la production en amont (front-end). Il indique aussi que l’offre de DRAM pour PC pourrait diminuer en 2027, à mesure qu’une plus grande part de la capacité bascule vers les serveurs. Sources : TrendForce, 29 septembre 2026 et TrendForce, 30 septembre 2026.
L’annonce de CXMT concerne la DRAM conventionnelle, pas la HBM4
La course à la mémoire ne se limite pas aux trois fabricants cités plus haut. Le 20 septembre 2026, CXMT a annoncé la production en série de sa plateforme technologique DRAM de cinquième génération, qu’elle appelle G5, lors de la World Manufacturing Convention 2026 à Hefei (CXMT, 20 septembre 2026).
CXMT indique que G5 atteint un demi-pas de zone active (active-area half-pitch) de 11,95 nm et au moins 50 % de puces en plus par plaquette que sa plateforme précédente, à densité normalisée de 8 Gb, et qu’elle réduit l’écart avec ce qu’elle appelle les plateformes de mémoire produites en volume les plus avancées au monde. Les premiers produits annoncés sont deux composants LPDDR5X de 24 Gb par puce, destinés aux smartphones et à l’électronique grand public portable, et CXMT affirme qu’ils sont déjà en production en série.
Il s’agit d’une annonce portant sur de la DRAM conventionnelle basse consommation pour appareils grand public. Elle ne dit rien de la HBM4, et une position renforcée dans la DRAM conventionnelle ne prouve pas que CXMT produit de la HBM à l’échelle commerciale. La distinction compte et, selon la lecture de TechiesJournal, c’est aussi pourquoi l’annonce mérite malgré tout l’attention, car TrendForce rapporte que la HBM et la DRAM conventionnelle se disputent une capacité limitée en procédés avancés et en plaquettes.
Ce que cela signifie pour ceux qui planifient une infrastructure d’IA
Cette section présente la lecture des sources par TechiesJournal ; il ne s’agit de la recommandation d’aucun fabricant. Les points pratiques découlent de ce que rapportent les sources.
- Demander la configuration mémoire, pas seulement le nom du processeur. La génération de HBM, la hauteur de pile, la capacité par accélérateur et le fournisseur de mémoire influent tous sur ce que fournit un système et sur ce qu’il coûte.
- Comparer les chiffres des fabricants sur une même base. La vitesse par broche, la hauteur de pile, les conditions de test et le stade de production diffèrent d’une annonce à l’autre, et la bande passante théorique d’une pile n’est pas le débit d’un système complet.
- Prévoir une offre tendue et des prix en hausse. Les perspectives de TrendForce courent jusqu’en 2027, mais les prévisions changent : il faut donc garder une marge de révision.
- Ne pas oublier la mémoire serveur conventionnelle. Les serveurs généralistes, y compris ceux qui exécutent des charges de travail d’IA agentique, utilisent des modules de DRAM conventionnelle, et TrendForce s’attend à ce que l’offre de DRAM pour serveurs reste insuffisante au quatrième trimestre 2026.
- Traiter les annonces comme des annonces. Une étape de développement, une première livraison et une production en grand volume sont des stades différents, et chaque source de cet article précise celui dont elle parle.
La course à la mémoire consiste à savoir qui peut fabriquer assez de la bonne mémoire, l’empiler, l’encapsuler et la livrer à temps. Pour quiconque achète ou construit de la capacité d’IA, cela détermine désormais le coût et la disponibilité autant que le processeur.
Pour aller plus loin
Sources examinées le 21 octobre 2026. Les chiffres des fabricants sont communiqués par les entreprises elles-mêmes et les chiffres de marché sont des prévisions. Aucun banc d’essai indépendant n’est revendiqué.
Annonces des fabricants
- SK hynix, Completes World’s First HBM4 Development and Readies Mass Production, 12 septembre 2025, achèvement du développement et préparation de la production en série.
- Samsung, Ships Industry-First Commercial HBM4, 12 février 2026, livraisons et caractéristiques communiquées par l’entreprise.
- Micron, High-bandwidth memory (HBM), gamme de produits et description du stade actuel de chaque produit.
- CXMT, Announces Mass Production of 5th-Generation DRAM Technology Platform, 20 septembre 2026, DRAM conventionnelle et LPDDR5X.
Études de marché
- TrendForce, HBM Supply Constraints Persist, 2027 Price Outlook Revised Upward, 29 septembre 2026, prévisions.
- TrendForce, AI Server Demand Sustains Memory Contract Price Increases in 4Q26, 30 septembre 2026, prévisions.
À lire aussi sur TechiesJournal
- Qu’est-ce que la HBM, et pourquoi la mémoire limite-t-elle l’IA ? (en anglais), pour les bases de la HBM sur lesquelles s’appuie cet article.
- Choisir un moteur d’inférence d’IA pour la production : les critères à comparer (en anglais), pour comprendre comment les logiciels de service de modèles gèrent le cache KV dans la mémoire de l’accélérateur.