

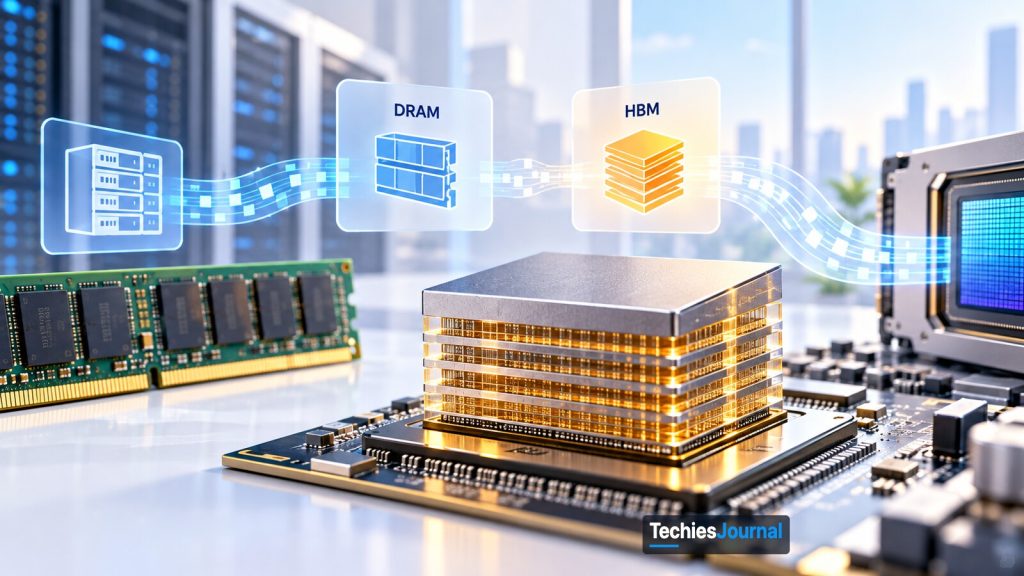
पारंपरिक DRAM और high-bandwidth memory AI कंप्यूटिंग सिस्टम में अलग-अलग भूमिकाएँ निभाती हैं। यह मालिक द्वारा उपलब्ध कराया गया संपादकीय वैचारिक चित्र है, सटीक भौतिक लेआउट या किसी वेंडर के उत्पाद की तस्वीर नहीं।
AI processors को ऐसी मेमोरी चाहिए जो डेटा को रख भी सके और उसे पर्याप्त तेज़ी से पहुँचा भी सके। जानिए कि DRAM, HBM, advanced packaging और मेमोरी निर्माताओं की होड़ AI कंप्यूटिंग और उसकी लागत को कैसे प्रभावित करती है।
AI processor उस मेमोरी पर निर्भर करता है जो उसे डेटा देती है
AI accelerator अपना काम डेटा पर करता है, और वह डेटा कहीं से आना चाहिए। मेमोरी वह डेटा रखती है जिस पर processor काम करता है, और उसे यह डेटा इतनी तेज़ी से पहुँचाना होता है कि processor व्यस्त रहे। जब मेमोरी साथ नहीं दे पाती, तो processor इंतज़ार करता है।
दो गुण मायने रखते हैं। Capacity यह है कि मेमोरी कितना डेटा रख सकती है। Bandwidth यह है कि वह प्रति सेकंड कितना डेटा आगे भेज सकती है, और SK hynix इसे high-bandwidth memory के लिए उस कुल डेटा क्षमता के रूप में बताता है जिसे एक मेमोरी पैकेज प्रति सेकंड प्रोसेस कर सकता है।
इसी वजह से मेमोरी AI इन्फ़्रास्ट्रक्चर में अपने आप में एक विषय बन गई है। अगर उसके बगल की मेमोरी उसी गति से डेटा न दे सके, तो तेज़ processor का ज़्यादा फ़ायदा नहीं होता, और अगर सबसे अच्छी मेमोरी का बहुत कम हिस्सा बन पाए, तो वह किसी काम की नहीं।
पारंपरिक DRAM और HBM अलग-अलग काम करते हैं
पारंपरिक DRAM वह मेमोरी है जिसका उपयोग ज़्यादातर कंप्यूटिंग सिस्टम लंबे समय से करते आए हैं। सर्वरों में यह आमतौर पर RDIMM जैसे modules के रूप में आती है, और TrendForce के अनुसार क्लाउड प्रदाता और सर्वर निर्माता agentic AI workloads को सपोर्ट करने वाले general सर्वरों की RDIMM माँग पूरी करने के लिए ज़्यादा bits खरीद रहे हैं (TrendForce, 30 September 2026)।
High-bandwidth memory, यानी HBM, अलग तरह से बनी होती है। SK hynix इसे कई DRAM chips को खड़ी दिशा में आपस में जोड़ने वाली मेमोरी बताता है, जो पारंपरिक DRAM की तुलना में डेटा प्रोसेसिंग की गति को बहुत बढ़ा देती है, और Micron इसे AI, high-performance computing और डेटा-गहन workloads के लिए बनी 3D-stacked DRAM कहता है। SK hynix HBM4 को छठी पीढ़ी गिनता है, जो मूल HBM, HBM2, HBM2E, HBM3 और HBM3E के बाद आई है।
| पहलू | पारंपरिक DRAM | HBM |
|---|---|---|
| बनावट | सर्वर RDIMM जैसे modules पर लगे DRAM chips | कई DRAM dies एक के ऊपर एक जुड़े हुए, हर stack में एक base die |
| AI सिस्टम में कहाँ दिखती है | general-purpose सर्वरों की main memory, जिनमें agentic AI workloads चलाने वाले सर्वर भी शामिल हैं | AI accelerators से जुड़ी मेमोरी, जो बहुत ऊँचे डेटा throughput के लिए बनी है |
| आपूर्ति को क्या सीमित करता है | advanced-process और wafer क्षमता | वही advanced-process और wafer क्षमता, साथ में अगली पीढ़ी के उत्पादों की yields और उत्पादन का अब भी बढ़ना |
| लागत का स्वरूप | contract prices, जिनके 4Q26 में बढ़ने का TrendForce का अनुमान है | हर stack में एक base die, इसलिए लागत layers की संख्या के अनुपात में नहीं घटती |
दोनों अलग-अलग दुनिया नहीं हैं। TrendForce के अनुसार AI सर्वर की माँग में लगातार वृद्धि HBM और पारंपरिक DRAM को सीमित advanced-process और wafer क्षमता के लिए आपस में होड़ में रखती है। स्रोत: TrendForce, 29 September 2026, TrendForce, 30 September 2026, SK hynix और Micron।
निर्माताओं के अनुसार HBM4 आँकड़े बढ़ाती है
HBM4 में सबसे बड़ा बदलाव चौड़ा इंटरफ़ेस है। SK hynix के अनुसार उसने पिछली पीढ़ी से I/O terminals की संख्या दोगुनी करके 2,048 कर दी है, और Samsung इसी बदलाव को 1,024 से 2,048 pins बताता है। चौड़ा इंटरफ़ेस और प्रति pin ऊँची गति, दोनों मिलकर एक stack जितना डेटा भेज सकता है उसे बढ़ाते हैं।
Pin की गति दूसरा कारक है। HBM4 के लिए JEDEC मानक की संचालन गति प्रति pin 8 Gbps है, और हर निर्माता इससे ऊपर चलने की जानकारी देता है। Pins को गति से गुणा करके आठ से भाग देने पर प्रति stack सैद्धांतिक अधिकतम मिलता है, और नीचे के आँकड़े इसी गणित पर चलते हैं।
Pin की गति का एक HBM4 stack के लिए क्या मतलब है
कोई pin गति चुनें और देखें कि 2,048-pin इंटरफ़ेस वाले एक stack की सैद्धांतिक अधिकतम bandwidth कितनी है।
8 Gbps
TechiesJournal का गणित: 2,048 × 8 Gbps ÷ 8 = 2.05 TB/s
HBM4 के लिए JEDEC मानक की संचालन गति, जिसे SK hynix पहचानता है और Samsung उद्योग मानक कहता है। निर्माता इससे ऊपर चलने की जानकारी देते हैं।
10 Gbps से ऊपर
TechiesJournal का गणित: 2,048 × 10 Gbps ÷ 8 = 2.56 TB/s
SK hynix अपने HBM4 में 10 Gbps से ऊपर की संचालन गति बताता है और कोई bandwidth आँकड़ा नहीं देता। यह पंक्ति 10 Gbps को न्यूनतम मानती है, इसलिए असली आँकड़ा इससे ऊँचा है।
11.7 Gbps
TechiesJournal का गणित: 2,048 × 11.7 Gbps ÷ 8 = 3.00 TB/s
Samsung लगातार 11.7 Gbps बताता है। Micron 11 Gb/s से ऊपर और 2.8 TB/s से ज़्यादा बताता है, जो इसी गणित से मेल खाता है।
13 Gbps
TechiesJournal का गणित: 2,048 × 13 Gbps ÷ 8 = 3.33 TB/s
Samsung के अनुसार उसका HBM4 13 Gbps तक ले जाया जा सकता है, यानी प्रति stack अधिकतम 3.3 TB/s, जो इस नतीजे से मेल खाता है।
इंटरफ़ेस की चौड़ाई और pin की गति से प्रति stack सैद्धांतिक अधिकतम। यह पूरे सिस्टम का throughput नहीं है, और आँकड़े निर्माताओं के अपने हैं।
तीनों निर्माता अपने HBM4 को अलग-अलग तरह से, अलग-अलग तारीखों पर और अलग-अलग परीक्षण आधारों के साथ बताते हैं। नीचे की table में हर किसी की बताई जानकारी जुटाई गई है, और यह दावों का रिकॉर्ड है, benchmark नहीं।
| कंपनी | बताया गया चरण | Pin की गति | प्रति stack bandwidth | बिजली दक्षता का दावा और उसका बताया गया आधार |
|---|---|---|---|---|
| SK hynix | विकास पूरा और mass-production प्रणाली तैयार, 12 September 2025 | 10 Gbps से ऊपर | पिछली पीढ़ी से दोगुनी | 40% से ज़्यादा बेहतर, release में कोई आधार नहीं बताया गया |
| Samsung | mass production शुरू और व्यावसायिक शिपमेंट, 12 February 2026 | 11.7 Gbps, अधिकतम 13 Gbps तक | अधिकतम 3.3 TB/s तक | HBM3E से 40% बेहतर |
| Micron | 36 GB 12-high HBM4 का high-volume production, अपने product page के अनुसार | 11 Gb/s से ऊपर | 2.8 TB/s से ज़्यादा, Micron के आंतरिक परीक्षण के आधार पर | HBM3E से 20% से ज़्यादा बेहतर |
Capacity stack की layers की संख्या के साथ बढ़ती है। Samsung 12-layer stacking के साथ HBM4 को 24 GB से 36 GB तक उपलब्ध कराता है और 48 GB तक के लिए 16-layer stacking की योजना बनाता है, जबकि Micron का product page 36 GB का 12-high stack सूचीबद्ध करता है। SK hynix यह भी कहता है कि उसे अपने HBM4 से AI सेवा की परफ़ॉर्मेंस में 69% तक सुधार की उम्मीद है, जो कंपनी का अनुमान है और आसपास के सिस्टम पर निर्भर करता है।
चूँकि चरण, तारीख और परीक्षण का आधार अलग हैं, इसलिए तीनों पंक्तियों को एक-दूसरे के मुकाबले क्रम में नहीं रखना चाहिए। उपयोगी तुलना वही है जो कोई खरीदार किसी खास accelerator, खास stack height और खास workload के लिए करेगा। स्रोत: SK hynix, 12 September 2025, Samsung, 12 February 2026 और Micron।
आपूर्ति और लागत तय करती हैं कि क्या बनेगा
मेमोरी केवल परफ़ॉर्मेंस का सवाल नहीं है। TrendForce को उम्मीद है कि HBM 2027 तक आपूर्ति की कमी में रहेगी, और उसने 2027 के लिए HBM की कीमत का अनुमान बढ़ा दिया है, जिसके अनुसार blended औसत बिक्री मूल्य साल-दर-साल 121% बढ़ेगा। ये अनुमान हैं, और ये yields, उत्पादन और माँग पर निर्भर हैं जो बदल सकते हैं।
एक प्रतिक्रिया यह है कि हर accelerator में कितनी HBM लगे, इसे बदला जाए। TrendForce के अनुसार GPU और ASIC निर्माता 12-high stacks की पहले की योजनाओं की जगह 8-high stacks पर विचार कर रहे हैं, जिसकी वजह सीमित आपूर्ति और बढ़ती सिस्टम लागत है, कमज़ोर माँग नहीं। कम layers प्रति stack लागत घटाती हैं और उतने ही HBM उत्पादन से ज़्यादा accelerators को सेवा देने देती हैं।
8-high stack प्रति gigabit सस्ता क्यों नहीं है
12-high और 8-high HBM stack के बीच बदलकर देखें कि क्या साझा होता है और क्या नहीं।
12-high stack
बारह DRAM layers एक base die की लागत साझा करती हैं। TrendForce के अनुसार कई GPU और ASIC की पहले की योजनाएँ इसी ऊँचाई मानकर बनी थीं।
8-high stack
आठ layers प्रति stack लागत और accelerator के कुल bill of materials को घटाती हैं। Base die की लागत अनुपात में नहीं घटती, इसलिए प्रति gigabit लागत ज़्यादा है। TrendForce को 2027 में प्रति gigabit लगभग 10 से 20% के premium की उम्मीद है, यह एक अनुमान है।
TrendForce की व्याख्या का सरल चित्र, लागत का मॉडल नहीं। एकमात्र आँकड़े TrendForce के अनुमान के हैं।
फिर भी कम layers प्रति gigabit मेमोरी को सस्ता नहीं बनातीं। हर HBM stack को एक base die चाहिए जिसकी लागत DRAM layers की संख्या के अनुपात में नहीं घटती, इसलिए 8-high stack वह लागत कम capacity पर बाँटता है। TrendForce को उम्मीद है कि 2027 में 8-high उत्पादों पर 12-high उत्पादों की तुलना में प्रति gigabit लगभग 10 से 20% का premium रहेगा, और वह नहीं मानता कि capacity में कटौती HBM की कीमतों में बढ़ोतरी के व्यापक रुझान को उलट देगी।
पारंपरिक DRAM भी यही दबाव महसूस करती है। TrendForce का अनुमान है कि 4Q26 में पारंपरिक DRAM की contract prices तिमाही-दर-तिमाही 10 से 15% बढ़ेंगी, वह कहता है कि आपूर्तिकर्ता high-performance सर्वर उत्पादों के लिए advanced-process क्षमता को प्राथमिकता देना जारी रखे हुए हैं, और उसे उम्मीद है कि 4Q26 में server DRAM की आपूर्ति कम रहेगी। वह बाधाओं में component आपूर्ति, packaging और testing क्षमता, और front-end उत्पादन में लचीलेपन का नाम लेता है। वह यह भी कहता है कि 2027 में PC DRAM की आपूर्ति घट सकती है क्योंकि और क्षमता सर्वरों की ओर जा रही है। स्रोत: TrendForce, 29 September 2026 और TrendForce, 30 September 2026।
CXMT की घोषणा पारंपरिक DRAM के बारे में है, HBM4 के बारे में नहीं
मेमोरी की दौड़ ऊपर बताए गए तीन निर्माताओं तक सीमित नहीं है। 20 September 2026 को CXMT ने Hefei में 2026 World Manufacturing Convention में अपने पाँचवीं पीढ़ी के DRAM टेक्नोलॉजी प्लेटफ़ॉर्म के mass production की घोषणा की, जिसे वह G5 कहता है (CXMT, 20 September 2026)।
CXMT के अनुसार G5 में active-area half-pitch 11.95 nm तक पहुँचता है और पिछले प्लेटफ़ॉर्म की तुलना में प्रति wafer कम से कम 50% ज़्यादा die मिलते हैं, जो 8 Gb density baseline पर normalised है, और यह उस चीज़ से अंतर कम कर रहा है जिसे वह दुनिया के सबसे उन्नत volume-production मेमोरी प्लेटफ़ॉर्म कहता है। उसने जिन पहले उत्पादों के नाम बताए वे प्रति die 24 Gb वाले दो LPDDR5X parts हैं, जो स्मार्टफ़ोन और पोर्टेबल कंज़्यूमर इलेक्ट्रॉनिक्स के लिए हैं, और वह कहता है कि ये पहले से mass production में हैं।
यह कंज़्यूमर डिवाइसों की पारंपरिक low-power DRAM के बारे में घोषणा है। यह HBM4 के बारे में कुछ नहीं कहती, और पारंपरिक DRAM में मज़बूत स्थिति इस बात का प्रमाण नहीं है कि CXMT व्यावसायिक पैमाने पर HBM बना रही है। यह अंतर मायने रखता है, और TechiesJournal की समझ में यही वजह है कि यह घोषणा फिर भी ध्यान देने लायक है, क्योंकि TrendForce के अनुसार HBM और पारंपरिक DRAM सीमित advanced-process और wafer क्षमता के लिए आपस में होड़ करती हैं।
AI इन्फ़्रास्ट्रक्चर की योजना बनाने वालों के लिए इसका क्या मतलब है
यह सेक्शन स्रोतों के बारे में TechiesJournal की अपनी समझ है, किसी निर्माता की सिफ़ारिश नहीं। व्यावहारिक बातें उसी से निकलती हैं जो स्रोत बताते हैं।
- केवल processor का नाम नहीं, मेमोरी configuration भी पूछें। HBM पीढ़ी, stack height, प्रति accelerator capacity और मेमोरी वेंडर, सब इस पर असर डालते हैं कि सिस्टम क्या देता है और उसकी लागत क्या होती है।
- वेंडरों के आँकड़ों की तुलना एक ही आधार पर करें। घोषणाओं में pin की गति, stack height, परीक्षण की स्थितियाँ और उत्पादन का चरण अलग होते हैं, और सैद्धांतिक stack bandwidth पूरे सिस्टम का throughput नहीं होती।
- आपूर्ति की तंगी और बढ़ती कीमतों के लिए योजना बनाएँ। TrendForce का अनुमान 2027 तक जाता है, लेकिन अनुमान बदलते हैं, इसलिए संशोधन की गुंजाइश रखें।
- पारंपरिक सर्वर मेमोरी को न भूलें। General-purpose सर्वर, जिनमें agentic AI workloads चलाने वाले सर्वर भी शामिल हैं, पारंपरिक DRAM modules इस्तेमाल करते हैं, और TrendForce को उम्मीद है कि 4Q26 में server DRAM की आपूर्ति कम रहेगी।
- घोषणाओं को घोषणा ही मानें। विकास का पड़ाव, पहला शिपमेंट और high-volume production अलग-अलग चरण हैं, और इस लेख का हर स्रोत बताता है कि उसका मतलब कौन-सा है।
मेमोरी की दौड़ इस सवाल की है कि सही मेमोरी पर्याप्त मात्रा में कौन बना सकता है, उसे stack कर सकता है, पैकेज कर सकता है और समय पर पहुँचा सकता है। AI क्षमता खरीदने या बनाने वाले किसी भी व्यक्ति के लिए यह अब लागत और उपलब्धता को उतना ही तय करता है जितना processor।
और गहराई में
स्रोतों की समीक्षा October 21, 2026 को की गई। निर्माताओं के आँकड़े कंपनियों द्वारा बताए गए हैं और बाज़ार के आँकड़े अनुमान हैं। कोई स्वतंत्र benchmark का दावा नहीं किया गया है।
निर्माताओं की घोषणाएँ
- SK hynix, Completes World’s First HBM4 Development and Readies Mass Production, September 12, 2025, विकास पूरा होना और mass-production की तैयारी।
- Samsung, Ships Industry-First Commercial HBM4, February 12, 2026, कंपनी द्वारा बताए गए शिपमेंट और स्पेसिफ़िकेशन।
- Micron, High-bandwidth memory (HBM), उत्पाद पोर्टफ़ोलियो और उत्पादों के मौजूदा चरण का विवरण।
- CXMT, Announces Mass Production of 5th-Generation DRAM Technology Platform, September 20, 2026, पारंपरिक DRAM और LPDDR5X।
बाज़ार शोध
- TrendForce, HBM Supply Constraints Persist, 2027 Price Outlook Revised Upward, September 29, 2026, अनुमान।
- TrendForce, AI Server Demand Sustains Memory Contract Price Increases in 4Q26, September 30, 2026, अनुमान।
TechiesJournal पर संबंधित लेख
- HBM क्या है, और मेमोरी AI को क्यों सीमित कर रही है? HBM की उन बुनियादी बातों के लिए जिन पर यह लेख आधारित है।
- प्रोडक्शन के लिए AI इन्फरेंस इंजन चुनना: किन बातों की तुलना करें यह समझने के लिए कि serving सॉफ़्टवेयर accelerator मेमोरी में KV cache को कैसे सँभालता है।