

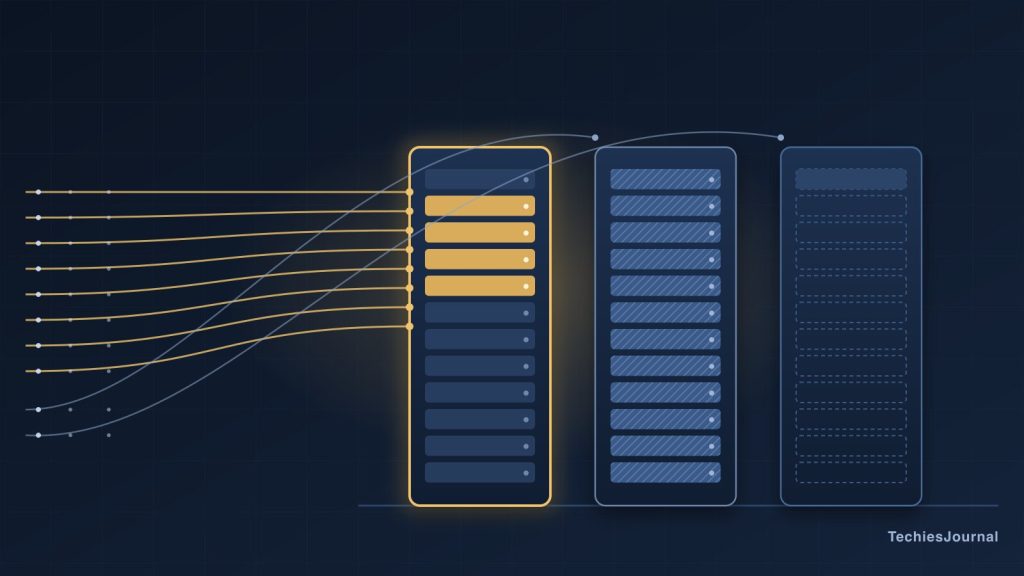
वर्षों से load balancing एक सीधे-सादे विचार पर चलती आई है।
एक request आती है। सिस्टम कोई उपलब्ध server ढूँढता है और request वहीं भेज देता है।
ज़्यादातर applications के लिए यह आज भी ठीक काम करता है।
AI इसमें एक दिलचस्प उलझन जोड़ देता है।
किसी large language model के साथ सबसे अच्छा server ज़रूरी नहीं कि हमेशा वही हो जिसके पास सबसे कम काम हो।
कभी-कभी किसी दूसरे server ने नई request के लिए ज़रूरी ज़्यादातर जानकारी पहले ही process कर रखी होती है।
इसका मतलब है कि AI infrastructure अब एक अलग सवाल पूछने लगा है।
केवल यह पूछने के बजाय:
कौन-सा server खाली है?
वह यह भी पूछ सकता है:
इस खास request को संभालने के लिए कौन-सा server सबसे ज़्यादा तैयार है?
यह छोटा-सा बदलाव बड़े AI सिस्टम में traffic के routing का तरीका बदलने लगा है।
एक सरल उदाहरण
मान लीजिए किसी कंपनी के पास 1,000 कर्मचारियों के इस्तेमाल के लिए एक internal AI assistant है।
किसी भी कर्मचारी को जवाब देने से पहले AI को कंपनी की वही जानकारी मिलती है:
- security के नियम
- internal निर्देश
- उपलब्ध tools
- product documentation।
इसके बाद हर कर्मचारी अलग सवाल पूछता है।
कोई invoice के बारे में पूछता है।
कोई contract के बारे में।
कोई application की किसी समस्या के बारे में।
सवाल अलग हैं, लेकिन हर सवाल से पहले AI को जो मिलता है, उसका एक बड़ा हिस्सा एक जैसा ही होता है।
एक साधारण load balancer शायद उन requests को उपलब्ध servers में बस बाँट दे।
AI infrastructure संभवतः इससे ज़्यादा समझदारी से काम कर सकता है।
अगर किसी AI server ने कंपनी की वह साझा जानकारी पहले ही process कर ली है, तो इसी तरह की दूसरी request उसी server पर भेजने से उस पुराने काम का कुछ हिस्सा दोबारा इस्तेमाल हो सकता है।
किसी दूसरे server को वही काम फिर से शुरू करना पड़ सकता है।
इसलिए दो servers, जो समान रूप से उपलब्ध दिखते हैं, ज़रूरी नहीं कि समान रूप से कुशल भी हों।
AI processing का कुछ हिस्सा याद रख सकता है
Large language models जवाब का पहला शब्द दिखने से पहले काफ़ी काम करते हैं।
किसी prompt को process करते समय model कुछ अस्थायी जानकारी बनाता है, जिसे memory में रखा जा सकता है।
इसे आमतौर पर KV cache कहा जाता है।
इसका महत्व समझने के लिए आपको इसके पीछे का गणित समझने की ज़रूरत नहीं है।
इसे अस्थायी कामकाजी नोट्स की तरह सोचिए।
अगर model कंपनी के निर्देशों का एक लंबा सेट पहले ही process कर चुका है, तो उन कामकाजी नोट्स को रखने से कभी-कभी वह वही गणना दोबारा करने से बच सकता है, जब कोई दूसरी request उसी जानकारी से शुरू होती है।
इसे prefix caching कहा जाता है।
और जब वह cache किया हुआ काम कीमती बन जाता है, तो यह मायने रखने लगता है कि request कहाँ भेजी जाए।
सबसे कम व्यस्त server हमेशा सबसे अच्छा server नहीं होता
दो AI servers के बारे में सोचिए।
Server A के पास पहले की किसी मिलती-जुलती request की उपयोगी जानकारी पहले से है।
Server B के पास नहीं है।
अगर दोनों समान रूप से व्यस्त हैं, तो Server A संभवतः बेहतर गंतव्य है, क्योंकि वह पिछले काम का कुछ हिस्सा दोबारा इस्तेमाल कर सकता है।
लेकिन अब मान लीजिए Server A पर requests की लंबी कतार लगी है जबकि Server B लगभग खाली है।
क्या सिस्टम को तब भी request Server A को ही भेजनी चाहिए?
शायद नहीं।
अब routing सिस्टम को दो बातों के बीच संतुलन बनाना होता है:
पिछले काम का दोबारा इस्तेमाल
और
ज़रूरत से ज़्यादा भार वाले server से बचना।
इसी वजह से AI load balancing और दिलचस्प होती जा रही है।
अब शायद कोई एक सरल नियम न रहे, जैसे:
request हमेशा सबसे कम व्यस्त machine को भेजो।
इस चित्र का accessible text विकल्प
दो रास्ते अगल-बगल। पारंपरिक routing में request किसी उपलब्ध, स्वस्थ server को जाती है। Inference-aware routing में request को चल रहे model, किसी भी cached काम, मौजूदा load और compute की तैयारी के आधार पर जाँचा जाता है, और फिर वह सबसे उपयुक्त inference target तक पहुँचती है।
यह पहले से हो रहा है
यह केवल कोई सैद्धांतिक विचार नहीं है।
AWS ने हाल ही में SageMaker HyperPod Inference Gateway पेश किया है।
इसकी routing प्रणाली AI inference से जुड़ी खास जानकारी पर विचार कर सकती है, जैसे कोई AI server कितना व्यस्त है और क्या वहाँ पहले process की गई उपयोगी prompt जानकारी पहले से मौजूद है।
AWS अपने कुछ benchmark workloads में उस समय की उल्लेखनीय कमी बताता है जो users को पहला generated token दिखने से पहले इंतज़ार करना पड़ता है।
ये AWS के अपने benchmark परिणाम हैं, इसलिए इन्हें हर application के लिए पक्की गारंटी वाले सुधार नहीं मानना चाहिए।
लेकिन सबसे महत्वपूर्ण बात यही architecture है।
अब routing layer AI workload के बारे में कुछ समझती है।
Open-source सिस्टम भी इसी तरह की चीज़ें कर रहे हैं।
vLLM, जो एक व्यापक रूप से इस्तेमाल होने वाला LLM serving platform है, ऐसी routing को सपोर्ट करता है जो यह देखती है कि किसी inference server के पास पहले से उपयोगी cached prompt जानकारी है या नहीं।
Google भी GKE के लिए inference-routing technology विकसित कर रहा है, ताकि AI requests को GPU और TPU resources के बड़े pools में ज़्यादा प्रभावी ढंग से बाँटा जा सके।
अलग-अलग products इस समस्या तक अलग तरीक़ों से पहुँच रहे हैं।
साझा विचार ज़्यादा महत्वपूर्ण है:
AI requests अब ऐसी चीज़ बनती जा रही हैं जिसे infrastructure केवल आगे भेजने के बजाय समझ सकता है।
cached जानकारी के अलावा भी बहुत कुछ देखना होता है
Caching दो AI servers के बराबर न होने के कारणों में से केवल एक है।
हो सकता है एक server पर ज़रूरी model पहले से चल रहा हो।
दूसरे के पास ज़्यादा GPU क्षमता उपलब्ध हो सकती है।
एक के पास कई requests इंतज़ार में हो सकती हैं।
दूसरा लगभग खाली हो सकता है।
बड़े environments में models के अलग-अलग versions या खास तरह के variations भी चल सकते हैं।
इसलिए AI routing का फ़ैसला धीरे-धीरे यह बन सकता है:
कौन-सी machine इस खास request को सबसे प्रभावी ढंग से संभाल सकती है?
इसके बजाय कि:
अगली request किस machine को मिलनी चाहिए?
यह पारंपरिक traffic distribution से कम और workload scheduling से ज़्यादा मिलता-जुलता दिखने लगता है।
क्या हर AI application को इसकी ज़रूरत है?
नहीं।
किसी छोटी कंपनी की साधारण-सी AI application को अपने आप उन्नत inference routing की ज़रूरत नहीं पड़ती।
अगर कोई application एक ही model इस्तेमाल करती है, उसका traffic अपेक्षाकृत कम है और वह थोड़े-से infrastructure पर चलती है, तो साधारण load-balancing setup पूरी तरह पर्याप्त हो सकता है।
यह तब ज़्यादा महत्वपूर्ण हो जाता है जब संगठन चलाते हैं:
- बड़े models
- कई GPUs
- ऊँचे request volumes
- लंबे prompts
- दोहराए जाने वाले निर्देश या साझा documents
- कई models
- कड़ी response-time ज़रूरतें।
उस पैमाने पर गैरज़रूरी AI computation को दोहराना महँगा पड़ सकता है।
बेहतर routing संगठन को अपने मौजूदा AI infrastructure का ज़्यादा कुशलता से उपयोग करने में मदद कर सकती है।
लेकिन जटिलता उतनी ही होनी चाहिए जितनी समस्या माँगती है।
जिस workload को इसकी ज़रूरत नहीं, उसके लिए उन्नत AI routing बनाने का कोई ख़ास फ़ायदा नहीं है।
Infrastructure teams को इसकी परवाह क्यों करनी चाहिए
हाल तक model caching और inference optimization जैसी अवधारणाएँ मुख्य रूप से machine-learning engineering teams के दायरे में आती थीं।
यह सीमा अब बदलने लगी है।
Platform engineers, SRE और cloud architects को ऐसे सवालों का सामना अब ज़्यादा बार करना पड़ सकता है:
Model कहाँ चल रहा है?
GPUs कितने व्यस्त हैं?
क्या इस request का कुछ हिस्सा कहीं पहले ही process हो चुका है?
क्या request पिछली computation का दोबारा इस्तेमाल कर सकती है?
किस गंतव्य से तेज़ जवाब मिलने की संभावना ज़्यादा है?
ये infrastructure के सवाल हैं।
AI platforms चलाने वालों को transformers के काम करने के तरीक़े का विशेषज्ञ बनने की ज़रूरत नहीं है।
लेकिन अच्छे infrastructure फ़ैसले लेने के लिए उन्हें inference के व्यवहार के बारे में पर्याप्त समझ की ज़रूरत पड़ सकती है।
यह पारंपरिक load balancing की जगह नहीं लेता
पारंपरिक load balancers ग़ायब नहीं हो रहे।
AI applications अब भी gateways, proxies और load balancers जैसे जाने-पहचाने networking components इस्तेमाल करती हैं।
फ़र्क़ model के ज़्यादा क़रीब दिखाई देता है।
एक सामान्य load balancer request को AI platform के अंदर पहुँचा सकता है।
उस platform के अंदर एक और routing layer तय कर सकती है कि असल में कौन-सा model server या GPU वह काम करे।
इसे दो फ़ैसलों की तरह सोचिए:
पहला: application की request कहाँ जाए?
फिर:
AI की computation कहाँ हो?
सरल सिस्टम में ये दोनों फ़ैसले व्यावहारिक रूप से एक ही हो सकते हैं।
बड़े AI platforms में ये दोनों फ़ैसले धीरे-धीरे अलग हो सकते हैं।
नज़रिया
दिलचस्प बदलाव यह नहीं है कि AI को किसी खास नए तरह के load balancer की ज़रूरत है।
बदलाव यह है कि AI, routing के फ़ैसले में workload को ही ज़्यादा महत्वपूर्ण बना देता है।
पारंपरिक applications में दो स्वस्थ servers को अक्सर समान माना जा सकता है।
AI inference में एक server की memory में पहले से उपयोगी काम हो सकता है, दूसरे के पास सही model तैयार हो सकता है, और तीसरे के पास बस ज़्यादा GPU क्षमता उपलब्ध हो सकती है।
इसलिए infrastructure अब इस सोच से आगे बढ़ने लगा है:
कोई उपलब्ध server ढूँढो।
इस सोच की ओर:
AI के इस खास काम को करने की सबसे अच्छी जगह ढूँढो।
छोटी AI applications के लिए यह अंतर शायद मायने न रखे।
बड़े inference environments के लिए यह अंतर अब ज़्यादा मायने रखने लगा है।
और AI inference के load balancing को बदलने की बात समझने का शायद सबसे आसान तरीक़ा यही है: सिस्टम अब केवल traffic को route नहीं कर रहा। वह computation को route करने लगा है।
संबंधित लेख: Cloud Capacity Is Not Cloud Availability एक और ऐसी जगह देखता है जहाँ server का उपलब्ध होना काम के लिए तैयार होने के बराबर नहीं है, और AI Cost per Task देखता है कि AI के काम की असल लागत क्या होती है।
स्रोत और आगे पढ़ने के लिए
स्रोत समीक्षा: 5 अक्टूबर 2026।
- AWS — Amazon SageMaker HyperPod Inference Gateway for scalable LLM inference. AWS द्वारा gateway, उसके routing संकेतों और AWS के बताए first-token latency परिणामों की घोषणा।
- AWS Documentation — SageMaker HyperPod managed tiered KV cache and routing. Prefix-aware routing requests को उन replicas तक कैसे भेजती है जिनके पास संबंधित cached काम पहले से है।
- AWS Machine Learning Blog — Introducing Amazon SageMaker HyperPod Inference Gateway. AWS के अपने benchmark workloads और शर्तें। परिणाम vendor द्वारा बताए गए हैं, और AWS नोट करता है कि स्थिर traffic में एकसमान fleets पर तुलनीय प्रदर्शन मिलता है।
- Google Cloud — About GKE Inference Gateway. GKE पर GPU और TPU accelerators में generative AI के लिए prefix-cache aware और load-aware routing।
- vLLM Documentation — Prefix-aware routing. एक ही prompt prefix साझा करने वाली requests को एक ही instance पर भेजना, ताकि cached काम का दोबारा इस्तेमाल हो सके।
- vLLM Documentation — Load-aware routing. cached काम के फ़ायदे को इस बात के साथ तौलना कि हर instance पर कितना load है।
- vLLM Documentation — Automatic prefix caching. साझा prompt prefix का cached काम कैसे दोबारा इस्तेमाल होता है, और यह सबसे ज़्यादा कहाँ मदद करता है।