

| भाग | लेख | क्या शामिल है |
|---|---|---|
| 1 | मुफ़्त बनाम भुगतान वाले AI मॉडल: शब्दों का असली मतलब | हर टियर का मतलब क्या है, $0 पर आप क्या खो देते हैं, लाइसेंस, एक निर्णय ढाँचा |
| 2 | ओपन AI मॉडल ख़ुद चलाना: इसमें वाक़ई क्या लगता है (यह लेख) | हार्डवेयर, टूल, कौशल, और ख़ुद-होस्ट करने की असली चुनौतियाँ |
| 3 | ओपन AI मॉडल कहाँ ढूँढें और सुरक्षित रूप से जाँचें | भरोसेमंद स्रोत, छेड़छाड़ की गई डाउनलोड पहचानना, सुरक्षित तरीक़े |
| 4 | अभी जानने लायक़ ओपन AI मॉडल (तारीख़-अंकित स्नैपशॉट) | 18 मौजूदा मुफ़्त और ओपन-वेट मॉडलों की फ़ील्ड गाइड |
इस शृंखला में नए हैं? भाग 1 बताता है कि इस लेख के व्यावहारिक होने से पहले “भुगतान वाला,” “मुफ़्त,” और “ओपन-वेट” का असल में क्या मतलब है।
वह हिस्सा जिसे डेमो वीडियो छोड़ देता है
एक दर्शक एक ट्यूटोरियल का पालन करता है: यह फ़ाइल डाउनलोड करें, एक कमांड चलाएँ, और एक निजी AI असिस्टेंट उनके अपने लैपटॉप पर, हमेशा के लिए मुफ़्त चलने लगता है। कमांड चलती है। फिर लैपटॉप के पंखे तेज़ हो जाते हैं, जवाब आने में नब्बे सेकंड लगते हैं, और जवाब उससे साफ़ तौर पर कमज़ोर होता है जो वही व्यक्ति किसी मुफ़्त चैटबॉट ऐप से पाता है। वीडियो में यह हिस्सा किसी ने नहीं जोड़ा।
इसका मतलब यह नहीं कि ओपन-वेट मॉडल बुरा विचार हैं — भाग 1 में इन्हें चुनने की असली वजहें बताई गई थीं, ख़ासकर गोपनीयता। इसका मतलब है कि “डाउनलोड करना मुफ़्त” और “अच्छी तरह चलाना आसान” दो अलग-अलग दावे हैं, और इनमें से केवल पहला ही सच है। यह लेख दूसरे को ईमानदारी से बताता है: पाठक को असल में कौन-सा हार्डवेयर चाहिए, लोग वाक़ई कौन-से टूल इस्तेमाल करते हैं, और वे ख़ास ट्रेड-ऑफ़ जो तय करते हैं कि अनुभव एक सक्षम असिस्टेंट जैसा लगेगा या एक निराश करने वाला प्रयोग।
आपकी मेमोरी असल में क्या खाती है
किसी ओपन-वेट मॉडल का आकार आमतौर पर उसके पैरामीटर काउंट से बताया जाता है — एक 7B मॉडल में क़रीब 7 अरब आंतरिक नंबर होते हैं। मॉडल चलते समय इन नंबरों में से हर एक को मेमोरी (RAM, या ग्राफ़िक्स कार्ड की VRAM) में फ़िट होना पड़ता है, और हर नंबर कितनी जगह लेता है यह उसकी प्रिसिज़न पर निर्भर करता है।
| प्रिसिज़न | प्रति पैरामीटर बाइट्स | इसे कौन इस्तेमाल करता है |
|---|---|---|
| fp16 (हाफ़ प्रिसिज़न) | 2 बाइट्स | मूल, पूरी गुणवत्ता वाला रिलीज़ जिसे ज़्यादातर प्रकाशक पहले अपलोड करते हैं |
| int8 (8-बिट) | 1 बाइट | एक मध्यम संपीड़न, fp16 की लगभग आधी मेमोरी |
| int4 (4-बिट) | ~0.5 बाइट्स | सबसे आम “क्वांटाइज़्ड” डाउनलोड जिसे लोग वाक़ई घर पर चलाते हैं |
यह किसी अतिरिक्त ओवरहेड से पहले एक अनुमानित मेमोरी अनुमान देता है (Hugging Face: Quantization overview):
| मॉडल आकार | fp16 (पूरी गुणवत्ता) | int8 | int4 (सामान्य घरेलू सेटअप) |
|---|---|---|---|
| 3B | ~6 GB | ~3 GB | ~1.5–2 GB |
| 7B | ~14 GB | ~7 GB | ~4 GB |
| 13B | ~26 GB | ~13 GB | ~7 GB |
| 34B | ~68 GB | ~34 GB | ~17–20 GB |
| 70B | ~140 GB | ~70 GB | ~35–40 GB |
ये आँकड़े सिर्फ़ मॉडल के वेट के लिए हैं। बातचीत को ख़ुद चाहिए “वर्किंग मेमोरी” के लिए लगभग 10–20% और जोड़ें (आगे बताया गया है), साथ ही ऑपरेटिंग सिस्टम और पहले से चल रहे अन्य ऐप जो इस्तेमाल कर रहे हैं वह भी। तालिका में दिए गए ठीक उतने ही आँकड़े वाली मशीन व्यवहार में आमतौर पर काफ़ी नहीं होगी।
एक लंबी बातचीत “फ़िट” हो चुके मॉडल को क्यों क्रैश कर सकती है
एक बड़े कॉन्टेक्स्ट विंडो के साथ विज्ञापित मॉडल — वह बातचीत जिसे यह एक साथ याद रख सकता है, जिसे अक्सर टोकन में “128K context” जैसा प्रचारित किया जाता है — उस कॉन्टेक्स्ट के लिए अतिरिक्त मेमोरी चाहता है, जो पहले से इस्तेमाल हो रहे वेट की मेमोरी से अलग है। यह वर्किंग मेमोरी, जिसे KV cache कहते हैं, बातचीत लंबी होने के साथ बढ़ती है।
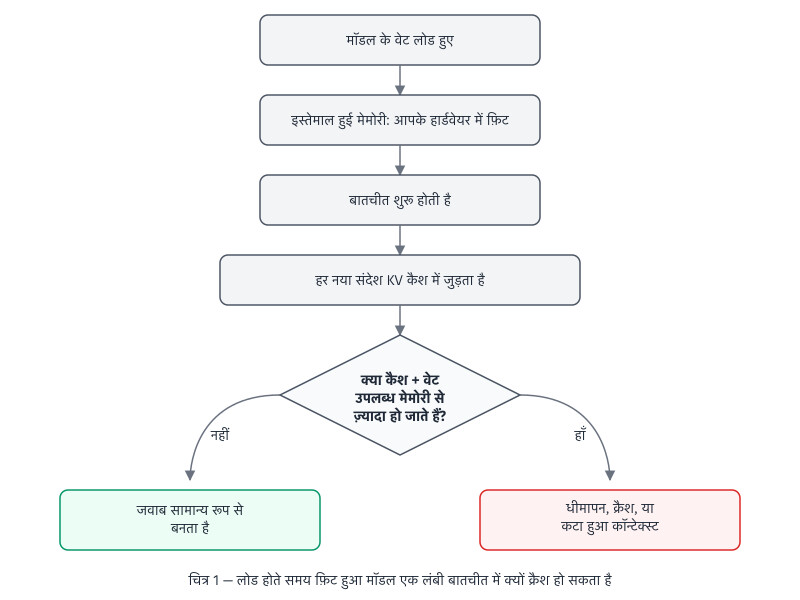
यही वजह है कि जो मॉडल ठीक से लोड होता है और पहले सवाल का अच्छा जवाब देता है, वह एक घंटे लंबे सेशन, एक लंबे दस्तावेज़ अपलोड, या एक बड़े पेस्ट किए गए कोडबेस में विफल हो सकता है या रेंगने लगता है — वेट कभी पूरी कहानी नहीं थे।
वे टूल जो लोग वाक़ई इस्तेमाल करते हैं
लगभग कोई भी अपना इन्फ़रेंस सेटअप शुरू से हाथ से नहीं बनाता। तीन टूल ज़्यादातर वास्तविक इस्तेमाल को कवर करते हैं:
| टूल | यह क्या है | किसके लिए सबसे अच्छा | प्लेटफ़ॉर्म |
|---|---|---|---|
| Ollama | एक कमांड-लाइन टूल और सरल लोकल सर्वर; एक कमांड से मॉडल डाउनलोड होकर चलने लगता है | डेवलपर और टर्मिनल में सहज तकनीकी पाठक | macOS, Windows, Linux |
| LM Studio | एक ग्राफ़िकल डेस्कटॉप ऐप: पॉइंट करके और क्लिक करके मॉडल ब्राउज़, डाउनलोड, और उनसे चैट करें | वे लोग जो कमांड लाइन छुए बिना ओपन-वेट मॉडल चाहते हैं | macOS, Windows, Linux |
| llama.cpp | वह अंतर्निहित इंजन जिस पर इस इकोसिस्टम का ज़्यादातर हिस्सा, Ollama समेत, बना है | पूरा नियंत्रण चाहने वाले, या मॉडल को अपने ही ऐप्लिकेशन में एम्बेड करने की योजना बना रहे डेवलपर | C++ टूलचेन वाला कोई भी प्लेटफ़ॉर्म |
ऊपर दी गई मेमोरी तालिका के क्वांटाइज़्ड (int4/int8) मॉडल फ़ॉर्मैट तीनों में चलते हैं, और तीनों इस्तेमाल के लिए मुफ़्त हैं। पाठक जो टूल चुनता है वह यह नहीं बदलता कि मॉडल क्या कर सकता है — यह बदलता है कि वहाँ तक पहुँचने में कितनी तकनीकी सहजता चाहिए।
असली चुनौतियाँ जिन्हें इन्फ़्लुएंसर कंटेंट छोड़ देता है
- क्वांटाइज़ेशन एक असली ट्रेड-ऑफ़ है, मुफ़्त छूट नहीं। किसी मॉडल को fp16 से 4-बिट में संपीड़ित करना इसकी मेमोरी ज़रूरत को लगभग चार गुना घटा देता है, लेकिन यह सटीकता को भी नापने लायक़ घटाता है, सबसे ज़्यादा सटीक रीज़निंग, गणित, और कोड पर — भारी क्वांटाइज़्ड मॉडल सामान्य चैट में ठीक लग सकता है और फिर भी उन कामों में विफल हो सकता है जिनके लिए किसी व्यक्ति को इसकी असल में ज़रूरत थी।
- बड़े कॉन्टेक्स्ट विंडो को अपनी अलग मेमोरी चाहिए, जैसा ऊपर दिखाया गया — एक लंबी बातचीत, एक बड़ा पेस्ट किया गया दस्तावेज़, या पूरा कोडबेस उस हार्डवेयर पर भी मेमोरी ख़त्म कर सकता है जिसने मॉडल को ख़ुद आराम से लोड कर लिया था।
- डाउनलोड बड़े होते हैं। 4-बिट क्वांटाइज़्ड फ़ाइलें भी आमतौर पर कुछ गीगाबाइट से लेकर कई दर्जन तक होती हैं; सबसे बड़े मॉडलों के मूल fp16 रिलीज़ सैकड़ों गीगाबाइट तक जाते हैं। पहली बार चलाने में असली इंतज़ार और असली मुफ़्त डिस्क स्पेस लगता है, पाँच-सेकंड का इंस्टॉल नहीं।
- कोई सपोर्ट लाइन नहीं है। ड्राइवर कॉन्फ़्लिक्ट, कोई रहस्यमय क्रैश, या लोड होने से इनकार करता मॉडल — इन्हें कम्युनिटी फ़ोरम, GitHub issues, और आज़माइश-ग़लती से सुलझाया जाता है — कभी किसी चैट-सपोर्ट एजेंट से नहीं।
- कुछ भी ख़ुद पैच नहीं होता। सुरक्षा सुधार, बग फ़िक्स, और बेहतर क्वांटाइज़्ड वर्शन लगातार आते रहते हैं, लेकिन डाउनलोड की गई मॉडल फ़ाइल तभी सुरक्षित या बेहतर होती है जब पाठक ख़ुद वापस जाकर अपडेट डाउनलोड करे।
- मॉडल के व्यवहार को बदलना बिल्कुल अलग कौशल है। मॉडल को जैसा प्रकाशित हुआ वैसा चलाना आसान है। फ़ाइन-ट्यूनिंग के ज़रिए इसे नया व्यवहार सिखाना एक गहरा मशीन-लर्निंग कौशल है, और यह इस लेख के दायरे से बाहर है।
- गर्मी, शोर, और बिजली असली लागतें हैं। लगातार लोकल इन्फ़रेंस लैपटॉप के पंखों को ज़ोर से चलाता है और बैटरी तेज़ी से ख़त्म करता है; एक समर्पित GPU अच्छी-ख़ासी बिजली खींचता है। यह इस शृंखला के भाग 1 में बताया गया “छिपा हुआ बिल” है — बस यह सब्सक्रिप्शन की बजाय बिजली में चुकाया जाता है।
कौशल की न्यूनतम सीमा, ईमानदारी से
Ollama या LM Studio इस्तेमाल करने के लिए कोड लिखना आना ज़रूरी नहीं। इसके लिए चाहिए:
- टर्मिनल से सॉफ़्टवेयर इंस्टॉल करने में सहजता, या डाउनलोड किए डेस्कटॉप ऐप पर भरोसा करना और उसे कॉन्फ़िगर करना
- अपने हार्डवेयर के लिए सही क्वांटाइज़्ड वर्शन चुनने के लिए मॉडल का अपना दस्तावेज़ीकरण (“मॉडल कार्ड”) पढ़ना, अनुमान लगाने के बजाय
- बुनियादी समस्या-निवारण: एरर मैसेज पढ़ना, यह जाँचना कि ग्राफ़िक्स ड्राइवर इंस्टॉल है और अप-टू-डेट है
- कई-गीगाबाइट डाउनलोड और कभी-कभार विफल हो जाने वाले डाउनलोड के लिए धैर्य
कोड लिखना, Python इस्तेमाल करना, या अंतर्निहित आर्किटेक्चर को समझना तभी ज़रूरी है जब लक्ष्य मॉडल के ऊपर कोई उत्पाद बनाना हो, सिर्फ़ एक का इस्तेमाल करना नहीं।
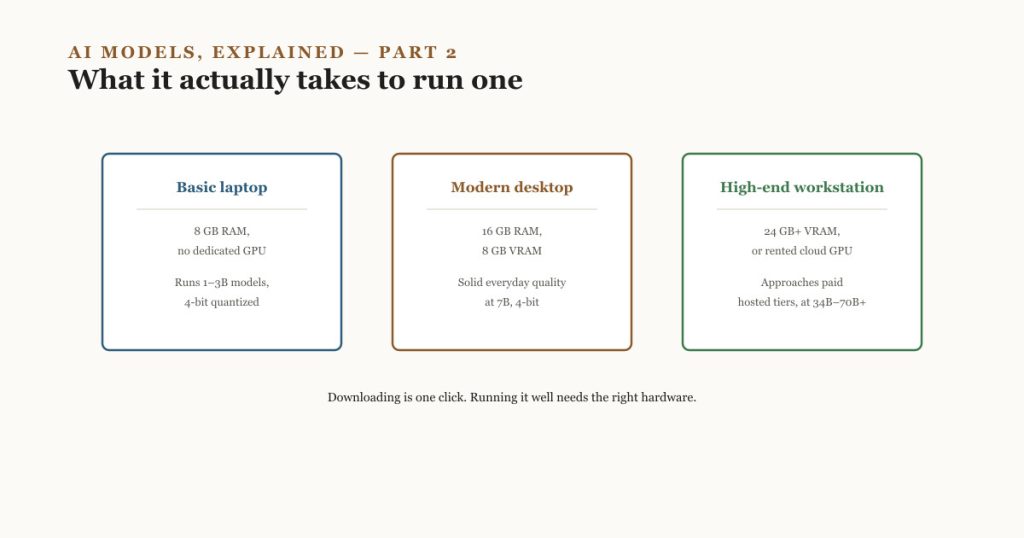
आपके हार्डवेयर को उससे मिलाना जो आप वाक़ई चला सकते हैं
| आपका सेटअप | आराम से क्या चलता है | क्या उम्मीद करें |
|---|---|---|
| बुनियादी लैपटॉप, 8 GB RAM, कोई समर्पित GPU नहीं | 1–3B मॉडल, 4-बिट | ड्राफ़्टिंग और सरल सवालों के लिए ठीक; जटिल रीज़निंग पर धीमा और सतही |
| आधुनिक लैपटॉप या डेस्कटॉप, 16 GB RAM, 8 GB VRAM | 7B, 4-बिट | ठोस रोज़मर्रा की गुणवत्ता, मध्यम-स्तरीय मुफ़्त होस्टेड चैटबॉट के लगभग बराबर |
| गेमिंग या क्रिएटर डेस्कटॉप, 16–24 GB VRAM | 13B–24B, 4-बिट | साफ़ तौर पर मज़बूत रीज़निंग और कोडिंग क्षमता |
| हाई-एंड वर्कस्टेशन या किराए का क्लाउड GPU | 34B–70B+ | कई भुगतान वाले होस्टेड टियर जो देते हैं उसके क़रीब पहुँचता है, असली हार्डवेयर या क्लाउड किराए के ख़र्च की क़ीमत पर |
भाग 1 का पैटर्न यहाँ भी लागू होता है: हर टियर पर बेहतर नतीजे मिल सकते हैं, लेकिन “मुफ़्त” हमेशा किसी न किसी चीज़ के बदले आता है — इस मामले में, हार्डवेयर की लागत, सेटअप का समय, और लगातार बिजली।
यह शृंखला जारी रखें
- भाग 1 — मुफ़्त बनाम भुगतान वाले AI मॉडल: शब्दों का असली मतलब। अगर भुगतान वाले, मुफ़्त, और ओपन-वेट के बीच का अंतर अभी भी साफ़ नहीं है तो यहाँ से शुरू करें।
- भाग 3 — ओपन AI मॉडल कहाँ ढूँढें और सुरक्षित रूप से जाँचें। अब जब एक चलाना संभव है, तो अगला सवाल यह है कि फ़ाइल असल में कहाँ से लें, और किसी वैध मॉडल को छेड़छाड़ किए गए मॉडल से कैसे पहचानें।
- भाग 4 — अभी जानने लायक़ ओपन AI मॉडल। मौजूदा मुफ़्त और ओपन-वेट मॉडलों की तारीख़-अंकित फ़ील्ड गाइड, ताकि ऊपर दिए हार्डवेयर मार्गदर्शन को ख़ास विकल्पों से मिलाया जा सके।
और गहराई से जानें
- Quantization overview — Hugging Face. ऊपर दी तालिकाओं में इस्तेमाल किया गया प्रिसिज़न-से-मेमोरी संबंध। सितंबर 2026 में समीक्षित।
- Ollama — ऊपर चर्चा किए गए कमांड-लाइन टूल की आधिकारिक साइट और मॉडल लाइब्रेरी।
- LM Studio — ऊपर चर्चा किए गए ग्राफ़िकल डेस्कटॉप टूल की आधिकारिक साइट।
- llama.cpp — लोकल-AI टूलिंग इकोसिस्टम के ज़्यादातर हिस्से के पीछे मौजूद ओपन-सोर्स इन्फ़रेंस इंजन, इसकी अपनी क्वांटाइज़ेशन डॉक्यूमेंटेशन समेत।
हार्डवेयर की ज़रूरतें और टूल की क्षमताएँ हर रिलीज़ साइकिल के साथ बदलती हैं। ऊपर दी मेमोरी तालिका को एक योजना अनुमान की तरह लें, और हार्डवेयर पर पैसा लगाने से पहले किसी ख़ास मॉडल के अपने पेज पर इसकी असली फ़ाइल साइज़ जाँचें।