

Microsoft 2027 में अपने AI inference इन्फ्रास्ट्रक्चर का विस्तार करने की योजना बना रही है। दिलचस्प सवाल यह नहीं है कि एक चिप कितनी तेज़ चलती है, बल्कि यह है कि उपलब्ध बिजली में एक डेटा सेंटर कितना उपयोगी AI काम कर सकता है।
जब कोई AI असिस्टेंट से सवाल पूछता है, तो जवाब कुछ ही सेकंड में आ सकता है। इसके पीछे प्रोसेसर मॉडल का डेटा लोड करते हैं, जानकारी को मेमोरी में इधर से उधर भेजते हैं और जवाब एक-एक token करके तैयार करते हैं। इस काम को लाखों अनुरोधों से गुणा कर दें, तो AI को चलाते रहने की लगातार लगने वाली लागत इन्फ्रास्ट्रक्चर की एक बड़ी समस्या बन जाती है।
यह चुनौती तब और बढ़ जाती है जब एप्लिकेशन सिर्फ़ एक छोटे सवाल का जवाब देने से ज़्यादा काम करते हैं। एक AI एजेंट लंबा दस्तावेज़ पढ़ सकता है, कई टूल इस्तेमाल कर सकता है और कई चरणों में जवाब तैयार कर सकता है। वह ज़्यादा देर तक कंप्यूटिंग क्षमता खर्च कर सकता है, और उसका प्रदर्शन इस पर निर्भर करता है कि नीचे का सिस्टम मेमोरी और कम्युनिकेशन को कितनी कुशलता से संभालता है, सिर्फ़ इस पर नहीं कि प्रोसेसर कितना अंकगणित कर सकता है।
यही Microsoft की October 12, 2026 की घोषणा की पृष्ठभूमि है। Microsoft का कहना है कि उसका Maia 200 accelerator पहले से ही प्रोडक्शन वर्कलोड चला रहा है, जिनमें Microsoft Copilot भी शामिल है। कंपनी 2027 में Maia 300 की तैनाती शुरू करने और उसी साल से Maia इन्फ्रास्ट्रक्चर परिवार को मल्टी-गीगावाट स्तर तक बढ़ाने की योजना बना रही है। ये अलग-अलग पड़ाव हैं। Maia 200 आज चालू है, जबकि Maia 300 के बताए गए सुधार और बड़े पैमाने का विस्तार भविष्य की योजनाएँ हैं।
Inference को एक अलग तरह के इन्फ्रास्ट्रक्चर की ज़रूरत क्यों है
Training में बड़ी मात्रा की कंप्यूटिंग से किसी मॉडल को बनाया या बेहतर किया जाता है। Inference वह काम है जो वह प्रशिक्षित मॉडल हर बार कोई अनुरोध संभालते समय करता है। Training एक बड़ा एकमुश्त या समय-समय पर होने वाला निवेश हो सकता है, जबकि लोकप्रिय सेवाओं को inference की लागत लगातार चुकानी पड़ती है।
Inference के लिए सिर्फ़ प्रोसेसिंग की ताक़त जवाब का एक हिस्सा है। मॉडल के पैरामीटर और अस्थायी वर्किंग डेटा को प्रोसेसर तक तेज़ी से पहुँचना चाहिए। लंबी बातचीत में सिस्टम को अनुरोध के पहले हिस्सों की जानकारी भी रखनी और दोबारा हासिल करनी पड़ती है। अगर प्रोसेसर डेटा का इंतज़ार कर रहे हैं, तो सिर्फ़ अंकगणितीय क्षमता बढ़ाने से उपयोगी आउटपुट में उतनी ही बढ़ोतरी नहीं मिल सकती।
इसीलिए Microsoft की Maia 300 इंजीनियरिंग व्याख्या कम डेटा इधर से उधर भेजने और उसे वहीं रखने पर इतना ज़ोर देती है जहाँ कंप्यूटेशन होता है। Maia 300 में multi-chiplet डिज़ाइन है (chiplet यानी चिप के छोटे अलग-अलग हिस्से), जो कंप्यूट, मेमोरी-कंट्रोल और कम्युनिकेशन के कामों को अलग करता है। इसका सॉफ़्टवेयर-निर्देशित तरीक़ा डेटा को उस प्रोसेसर के पास रखने का लक्ष्य रखता है जिसे उसकी ज़रूरत है, जबकि कम-प्रिसिज़न वाले नंबर फ़ॉर्मेट कुछ inference ऑपरेशनों में डेटा को कम मात्रा में भेजने और संग्रहीत करने की ज़रूरत घटाते हैं।
इसमें समझौते भी हैं। कम प्रिसिज़न को संबंधित वर्कलोड के लिए मॉडल के स्वीकार्य व्यवहार को बनाए रखना होगा, और असल कुशलता सॉफ़्टवेयर, मॉडल की विशेषताओं और सिस्टम के उपयोग पर निर्भर करती है। हार्डवेयर स्पेसिफ़िकेशन से यह तय नहीं होता कि ग्राहक को कैसा अनुभव मिलेगा।
Microsoft के अनुसार Maia 300 क्या देगा
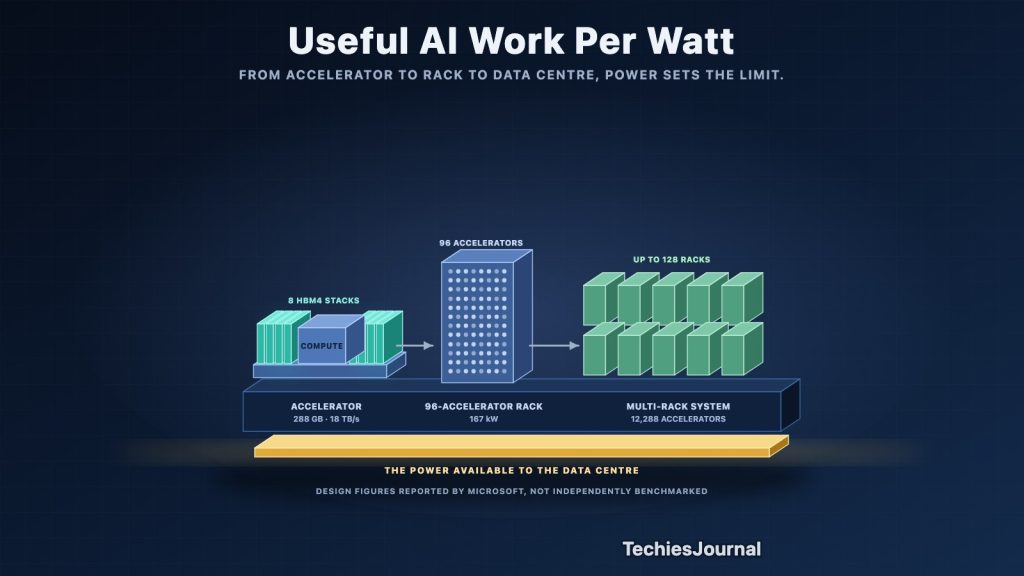
Microsoft की रिपोर्ट के अनुसार Maia 300 में आठ HBM4 मेमोरी stack होंगे, जिनकी क्षमता 288 GB और प्रति accelerator पीक बैंडविड्थ 18 TB/s होगी। HBM यानी high-bandwidth memory, जो कंप्यूटिंग हार्डवेयर के बहुत पास रखी जाती है, और ज़्यादा बैंडविड्थ बड़े मॉडलों पर काम कर रहे प्रोसेसरों को डेटा पहुँचाने में मदद करती है। एक नियोजित रैक में 167 kW पावर एन्वेलप के भीतर 96 accelerator होंगे, जिनमें 27.6 TB HBM और लगभग 1.7 PB/s कुल मेमोरी बैंडविड्थ होगी।
ये संख्याएँ पूरे डिज़ाइन का वर्णन करती हैं, ऐसे प्रोडक्ट का नहीं जिसे ग्राहक फ़िलहाल प्रोडक्शन में बेंचमार्क कर सकें। Microsoft को उम्मीद है कि Maia 300, जिन्हें वह अग्रणी GPU-आधारित सिस्टम कहती है, उनसे 40% ज़्यादा token प्रति मेगावाट देगा। वह यह भी बताती है कि पूरे 96-accelerator कॉन्फ़िगरेशन में यह Maia 200 के मुक़ाबले रैक-स्तर पर token थ्रूपुट का सात गुना तक हो सकता है।
इस तुलना को सावधानी से पढ़ना ज़रूरी है। Maia 300 रैक में उसके पूर्ववर्ती से दोगुने accelerator हैं, इसलिए रैक थ्रूपुट के सात गुना होने का मतलब यह नहीं कि अकेला Maia 300 accelerator सात गुना तेज़ है। 40% का आँकड़ा घोषणा में बिना बताए गए GPU-आधारित सिस्टमों और वर्कलोड के सेट के मुक़ाबले एक कुशलता का दावा है। यह कोई सार्वभौमिक स्पीडअप नहीं है, और न ही ग्राहकों के बिलों में सत्यापित कमी है।
| Maia 300 डिज़ाइन आँकड़ा | Microsoft द्वारा बताया गया मान |
|---|---|
| प्रति accelerator HBM | 288 GB (आठ HBM4 stack) |
| प्रति accelerator पीक HBM बैंडविड्थ | 18 TB/s |
| प्रति रैक accelerator | 96 |
| रैक पावर एन्वेलप | 167 kW |
| प्रति रैक HBM | 27.6 TB |
| रैक की कुल HBM बैंडविड्थ | 1.7 PB/s |
स्रोत: Microsoft की October 12, 2026 की घोषणा और आर्किटेक्चर डीप डाइव। ये बताए गए डिज़ाइन स्पेसिफ़िकेशन हैं, स्वतंत्र प्रोडक्शन बेंचमार्क के नतीजे नहीं।
नेटवर्क और डेटा सेंटर भी डिज़ाइन का हिस्सा हैं
बड़े AI वर्कलोड के लिए कई accelerator को मिलकर काम करना पड़ सकता है। जब मॉडल का डेटा या बीच के नतीजे उनके बीच भेजने पड़ते हैं, तो कम्युनिकेशन बाधा बन सकता है। Maia 300 को accelerator और रैक के बीच साझा कम्युनिकेशन तरीक़े के साथ डिज़ाइन किया गया है। Microsoft का प्रस्तावित superpod (यानी कई रैक जोड़कर बना एक बड़ा सिस्टम) 128 रैक में 12,288 accelerator तक पहुँचता है, जिसमें Ethernet-आधारित ट्रांसपोर्ट और रैक के बीच ऑप्टिकल लिंक इस्तेमाल होते हैं।
यह आर्किटेक्चर संचालन से जुड़ी माँगें भी पैदा करता है। 167 kW वाले रैक को बिजली मिलनी चाहिए, उसे गर्मी बाहर निकालनी चाहिए और उसकी सर्विसिंग संभव रहनी चाहिए। Microsoft रैक के ज़्यादातर थर्मल लोड के लिए लिक्विड कूलिंग का वर्णन करती है, साथ ही पावर टेलीमेट्री का भी, जो वर्कलोड की जगह तय करने में जानकारी दे सकती है। ये सहायक ब्योरे नहीं हैं। ये तय करने में मदद करते हैं कि किसी डेटा सेंटर की सीमाओं में असल में कितनी inference क्षमता चलाई जा सकती है।
वादा किया गया मल्टी-गीगावाट रोलआउट यह बात ख़ास तौर पर साफ़ कर देता है। गीगावाट बिजली का माप है, AI मॉडल की गुणवत्ता या जवाब की गति का माप नहीं। Microsoft उस पैमाने का संकेत दे रही है जिस पर वह Maia सिस्टम चलाना चाहती है, लेकिन घोषणा से यह साबित नहीं होता कि सारी नियोजित क्षमता पहले से बन चुकी है या इस्तेमाल में है।
क्लाउड और AI टीमों के लिए इसका क्या मतलब है
ज़्यादातर संगठन अलग-अलग accelerator chiplet नहीं चुनेंगे और न ही AI डेटा सेंटर के कूलिंग सिस्टम डिज़ाइन करेंगे। फिर भी वे ऐसे फ़ैसले लेंगे जो इन घटनाक्रमों से आकार लेते हैं: कौन-सा मॉडल चलाना है, कितना context भेजना है, जवाब में कितनी देरी स्वीकार्य है और नतीजे में वर्कलोड की लागत क्या बैठती है।
किसी मॉडल-सर्विंग सेवा को आख़िरकार उसके असली वर्कलोड पर परखा जाना चाहिए। प्रति सेकंड token और प्रति वॉट token उपयोगी माप हैं, लेकिन उपयोगकर्ता जवाब की देरी, गुणवत्ता, उपलब्धता और पूरे हुए प्रति कार्य की लागत की भी परवाह करते हैं। कई टूल कॉल करने वाले एजेंट की लागत का स्वरूप एक सरल चैट अनुरोध से बहुत अलग हो सकता है, भले ही दोनों एक ही मॉडल इस्तेमाल करें।
इसलिए Maia 300 पर नज़र रखना सार्थक है, लेकिन Microsoft की प्रदर्शन अपेक्षाओं को इंडस्ट्री के तय बेंचमार्क मान लेना ठीक नहीं। इसका व्यापक महत्व यह है कि चिप, मेमोरी, नेटवर्क, सॉफ़्टवेयर और डेटा सेंटर को एक ही inference सिस्टम के रूप में डिज़ाइन करने की ओर क़दम बढ़ रहा है। जैसे-जैसे AI रोज़मर्रा के एप्लिकेशन का हिस्सा बनता है, उस स्तर की कुशलता उतनी ही मायने रख सकती है जितनी स्वयं मॉडलों में होने वाले सुधार।
संदर्भ और आगे पढ़ने के लिए
दोनों स्रोत 14 अक्टूबर 2026 को खोलकर जाँचे गए। सभी आँकड़े Microsoft द्वारा बताए गए हैं और उन्हें स्वतंत्र रूप से दोहराया नहीं गया है।
- Microsoft: Microsoft to expand Azure Maia system to multi-gigawatt deployments. Scott Guthrie, Microsoft, 12 अक्टूबर 2026। रिलीज़ के पड़ाव और Microsoft द्वारा बताई गई प्रदर्शन अपेक्षाएँ।
- Microsoft Azure: Deep dive into Azure Maia 300 architecture. Rani Borkar and Saurabh Dighe, Microsoft Azure, 12 अक्टूबर 2026। मेमोरी, chiplet, नेटवर्किंग, रैक और कूलिंग डिज़ाइन के ब्योरे।