

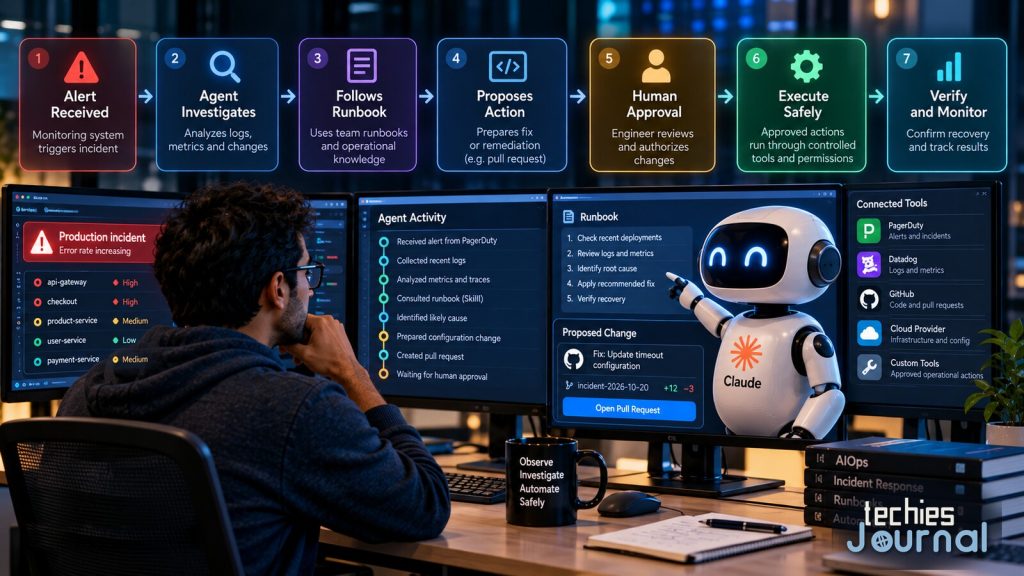
Illustration d’une réponse aux incidents assistée par l’IA. Les outils et éditeurs représentés sont des exemples, et non des intégrations natives vérifiées.
Claude Managed Agents peut enquêter sur des incidents, suivre des runbooks et interagir avec des outils d’exploitation. Pour les équipes DevOps, l’occasion est d’automatiser une plus grande partie de la réponse. La difficulté est de décider ce qu’un agent doit être autorisé à exécuter.
Une application commence à renvoyer des erreurs en production. La supervision détecte une hausse inhabituelle des échecs et envoie une alerte à l’ingénieur d’astreinte.
L’ingénieur commence une enquête familière. Il examine les journaux (logs), vérifie les déploiements récents, identifie le service touché et consulte le runbook. Si le problème exige une modification de l’infrastructure, il prépare le correctif et suit le processus d’approbation de l’organisation.
Les assistants d’IA aident déjà les ingénieurs à comprendre les journaux et proposent des pistes de dépannage. Mais si un agent d’IA pouvait commencer l’enquête dès l’arrivée de l’alerte, sans attendre que quelqu’un décrive le problème ? C’est l’une des possibilités qu’ouvre Claude Managed Agents, lancé par Anthropic en bêta publique le 8 avril 2026.
Le service fournit une infrastructure pour exécuter des agents d’IA capables de mener des tâches en plusieurs étapes, d’utiliser des outils et de conserver leur état de travail. Des mises à jour ultérieures ont ajouté des fonctions de coordination du travail et d’export de traces opérationnelles. Pour les équipes DevOps et d’ingénierie de la fiabilité des sites (SRE), l’évolution intéressante est la possibilité de connecter un agent d’IA aux processus de réponse aux incidents existants.
En quoi un agent géré diffère d’un chatbot
Un chatbot répond généralement à une demande. Un ingénieur transmet un message d’erreur, demande ce qui pourrait ne pas aller et reçoit une explication ou des commandes suggérées. Un agent géré peut jouer un rôle plus actif.
Une application peut créer une session lorsqu’un événement se produit. L’agent reçoit le contexte de l’incident, appelle les outils disponibles, examine leurs résultats et décide de ce qu’il doit examiner ensuite.
Claude Managed Agents fournit l’environnement d’exécution, la gestion des sessions et des outils intégrés pour des tâches comme la lecture de fichiers et l’exécution de commandes. Il prend aussi en charge des connexions à des systèmes externes au moyen d’outils et du Model Context Protocol (MCP).
Cela ne signifie pas qu’Anthropic fournit un produit complet de gestion des incidents. Les intégrations de supervision, les permissions opérationnelles et les procédures de remédiation restent de la responsabilité de l’organisation. La différence, c’est que les développeurs peuvent construire un processus fondé sur un agent sans avoir à construire eux-mêmes chaque élément de l’environnement d’exécution de l’agent sous-jacent.
Suivre un incident, de l’alerte à l’enquête
Anthropic en donne un exemple concret dans son tutoriel du 10 avril, Build an SRE Incident Response Agent with Claude Managed Agents. La démonstration commence par une alerte PagerDuty simulée. Un webhook transmet les détails de l’incident à une application, qui démarre une session d’agent.
L’agent examine ensuite les journaux et les fichiers d’infrastructure à l’aide des outils disponibles dans son bac à sable. Il consulte aussi un runbook fourni au moyen d’un Skill, un paquet réutilisable d’instructions et de fichiers d’accompagnement. Le Skill indique à l’agent comment l’équipe attend qu’un incident soit examiné, notamment en consultant le runbook avant de modifier l’infrastructure.
Une fois qu’il a identifié un problème de configuration potentiel, l’agent prépare un correctif. Des outils personnalisés permettent au processus d’ouvrir une pull request et de demander une approbation humaine avant la fusion. Cette séquence montre comment un agent peut enchaîner plusieurs étapes sans qu’un ingénieur ait à le solliciter manuellement à chacune d’elles.
Il existe une limite importante. PagerDuty, GitHub et Datadog sont simulés dans le tutoriel. L’exemple montre comment construire l’intégration, et non sa fiabilité lors de véritables incidents de production.
Quand l’enquête devient une action opérationnelle
Lire des journaux et identifier une cause possible, ce n’est pas la même chose que modifier une infrastructure de production. Un agent pourrait être connecté à des outils permettant de créer des tickets d’incident, d’ouvrir des pull requests ou d’invoquer des scripts approuvés. Avec un développement supplémentaire, il pourrait aussi aider à corréler des alertes liées ou à repérer des notifications répétées.
Il s’agit de processus que les clients pourraient construire eux-mêmes. Ils ne prouvent pas que Claude Managed Agents comprend un service prêt à l’emploi de déduplication des alertes ou de remédiation autonome.
Reprenons le problème de configuration de notre exemple d’incident. Préparer un correctif donne à un ingénieur quelque chose de concret à inspecter. Appliquer ce correctif modifie l’état opérationnel du système. Même lorsque la correction proposée semble juste, elle pourrait affecter d’autres services ou interférer avec un déploiement déjà en cours.
La capacité d’exécuter une commande ne démontre donc pas qu’il est sûr de l’exécuter. C’est là que la distinction entre capacité de l’agent et autorité opérationnelle prend toute son importance.
Comment les runbooks doivent soutenir l’exécution par un agent
Les runbooks traditionnels supposent souvent qu’un ingénieur expérimenté interprétera les instructions. Une procédure peut dire : « Redémarrer le service s’il reste en mauvaise santé. »
Avant de le faire, un ingénieur peut vérifier les déploiements récents, les services dépendants et les tentatives de rétablissement précédentes. Ces vérifications ne sont pas forcément écrites explicitement, car l’équipe les considère comme une pratique courante. Un agent ne peut pas s’appuyer sans risque sur des hypothèses non documentées.
Pour une exécution automatisée, la procédure a besoin de conditions plus claires.
- Quels éléments confirment le problème ?
- Quelles vérifications de diagnostic sont obligatoires ?
- L’action est-elle autorisée dans cet environnement ?
- Quand l’exécution doit-elle s’arrêter ?
- Comment vérifier le rétablissement ?
Ce n’est pas une discipline entièrement nouvelle. L’automatisation classique exige elle aussi des préconditions fiables, des actions prévisibles et une gestion des échecs. Les agents gérés ajoutent une autre considération, car l’agent peut choisir quels outils disponibles utiliser et dans quel ordre. Un runbook peut guider ces décisions, mais les instructions seules ne devraient pas déterminer les permissions en production.
Où se prend la décision d’agir
Claude Managed Agents propose des politiques de permissions configurables pour les outils intégrés et les outils MCP. Un outil peut s’exécuter automatiquement, exiger une approbation ou être évalué avant son exécution. Ces politiques ne régissent toutefois pas les outils personnalisés. Lorsqu’un agent demande un outil personnalisé, c’est l’application du client qui reçoit cette demande et qui doit décider de l’exécuter ou non.
Cette distinction compte particulièrement pour la réponse aux incidents. Une organisation pourrait permettre à un agent d’examiner des journaux, de lire des fichiers de configuration et de préparer une pull request, tout en exigeant une approbation explicite pour les actions qui redémarrent des services ou modifient l’infrastructure de production. L’application devrait faire respecter ces limites indépendamment des instructions données à l’agent.
Elle doit aussi prévoir ce qui se passe lorsqu’une action échoue, est demandée deux fois ou ne se termine que partiellement. Arrêter un agent n’annule pas nécessairement une modification déjà effectuée par l’intermédiaire d’un système externe.
Anthropic fournit des contrôles portant sur le bac à sable, le réseau, les identifiants et la surveillance des sessions. Ces contrôles sont utiles, mais ils ne remplacent ni une conception sécurisée de l’intégration ni les vérifications opérationnelles nécessaires pour confirmer que le rétablissement a réussi.
Le traitement des données demande lui aussi de l’attention. Managed Agents n’est pas actuellement éligible au dispositif Zero Data Retention d’Anthropic ni à la couverture HIPAA Business Associate Agreement. Les équipes qui manipulent des informations opérationnelles sensibles doivent examiner ces restrictions avant de connecter des données de production.
Jusqu’où les équipes DevOps devraient aller aujourd’hui
Managed Agents offre une occasion concrète d’expérimenter une enquête sur incident qui démarre automatiquement et progresse à travers plusieurs étapes opérationnelles. La démonstration SRE officielle montre comment assembler ce processus. Elle ne prouve pas que la remédiation autonome améliore systématiquement le temps de rétablissement ni qu’elle fonctionne de manière fiable face à des incidents inédits.
Pour une équipe qui évalue la plateforme, une expérience contrôlée est un point de départ plus utile qu’un large accès à la production. Une alerte de test pourrait lancer une session d’agent ayant accès à des journaux préparés, à un runbook et à un ensemble restreint d’outils de diagnostic en lecture seule. Les ingénieurs pourraient évaluer si l’agent repère les éléments pertinents, suit la procédure et explique correctement l’action qu’il propose.
L’expérience suivante pourrait permettre à l’agent de préparer une modification soumise à revue, sans l’autorisation de l’appliquer. Ces essais aideraient à établir si l’agent apporte une capacité opérationnelle utile et où ses décisions restent peu fiables.
Claude Managed Agents change ce que les développeurs peuvent construire autour des systèmes existants de gestion des opérations informatiques. Il ne supprime pas le besoin de supervision, d’automatisation fiable, de jugement humain ni de pratiques établies de gestion des incidents.
Pour les équipes DevOps et SRE, la décision importante n’est pas seulement de savoir si un agent d’IA peut répondre à un incident. C’est de savoir quelles parties de cette réponse peuvent être déléguées sans risque, et comment l’équipe saura que l’agent a atteint ses limites.
Pour aller plus loin
- Claude Platform Release Notes, Anthropic. Bêta du 8 avril 2026 et versions ultérieures.
- Claude Managed Agents Overview, Anthropic. Infrastructure des agents gérés et sessions.
- Build an SRE Incident Response Agent, Gagan Bhat, Anthropic, 10 avril 2026. Tutoriel de réponse aux incidents sur des services simulés.
- Permission Policies, Anthropic. Limites des outils intégrés, MCP et personnalisés.
- Secure Your Managed Agents Deployment, Anthropic. Considérations de sécurité liées à l’exécution.
- Session Operations, Anthropic. Comportement du cycle de vie des sessions.
À lire aussi sur TechiesJournal
- Quand l’IA rejoint l’équipe d’astreinte : qui contrôle les décisions en production ? (en anglais), pour la question de savoir à qui revient une décision de production une fois qu’un agent l’a proposée.
- La frontière des identifiants MCP : pourquoi un serveur MCP ne devrait pas décider où vont vos identifiants OAuth (en anglais), pour le volet outils et identifiants des permissions des agents.
- Une fois l’ordinateur portable refermé : ce dont les agents d’IA ont réellement besoin comme infrastructure (en anglais), pour l’environnement d’exécution et l’infrastructure dont un agent a besoin pour continuer à travailler.