

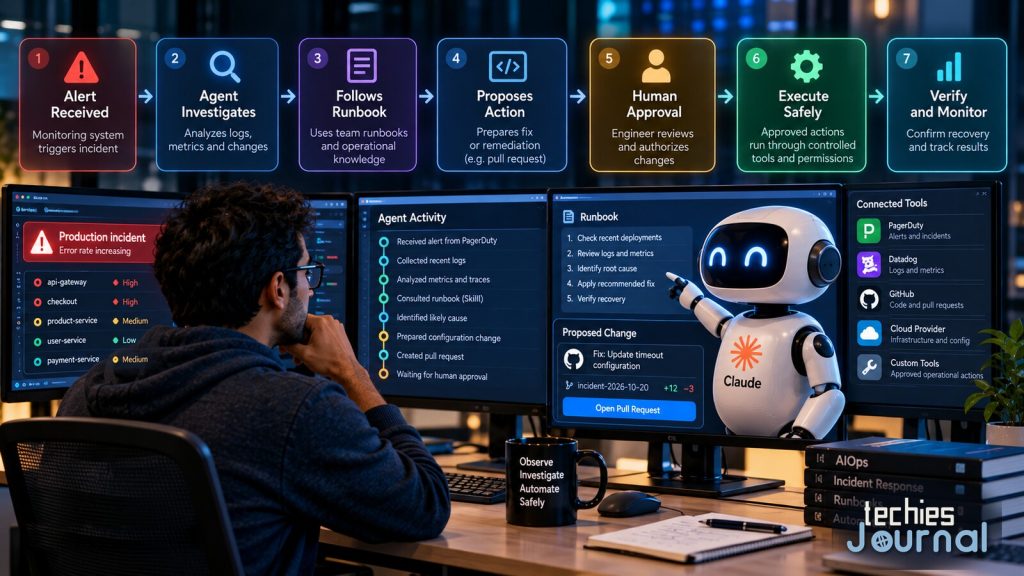
Ilustración de una respuesta a incidentes asistida por IA. Las herramientas y los proveedores que aparecen son ejemplos, no integraciones nativas verificadas.
Claude Managed Agents puede investigar incidentes, seguir runbooks e interactuar con herramientas operativas. Para los equipos de DevOps, la oportunidad es automatizar una parte mayor del proceso de respuesta. El reto es decidir qué se le debe permitir ejecutar a un agente.
Una aplicación empieza a devolver errores en producción. La monitorización detecta un aumento inusual de fallos y envía una alerta al ingeniero de guardia.
El ingeniero inicia una investigación conocida. Examina los registros (logs), revisa los despliegues recientes, identifica el servicio afectado y consulta el runbook, el manual de procedimientos operativos. Si el problema exige un cambio en la infraestructura, prepara la corrección y sigue el proceso de aprobación de la organización.
Los asistentes de IA ya pueden ayudar a los ingenieros a entender los registros y sugerir pasos para solucionar problemas. Pero ¿y si un agente de IA pudiera empezar a investigar en cuanto llega la alerta, sin esperar a que alguien le describa el problema? Esa es una de las posibilidades que abre Claude Managed Agents, que Anthropic lanzó en beta pública el 8 de abril de 2026.
El servicio ofrece infraestructura para ejecutar agentes de IA capaces de realizar tareas de varios pasos, usar herramientas y mantener su estado de trabajo. Actualizaciones posteriores han añadido funciones para coordinar el trabajo y exportar trazas operativas. Para los equipos de DevOps y de ingeniería de fiabilidad de sitios (SRE), lo interesante es la posibilidad de conectar un agente de IA a los flujos de trabajo de respuesta a incidentes que ya tienen.
En qué se diferencia un agente gestionado de un chatbot
Un chatbot suele responder a una solicitud. Un ingeniero comparte un mensaje de error, pregunta qué puede estar fallando y recibe una explicación o comandos sugeridos. Un agente gestionado puede asumir un papel más activo.
Una aplicación puede crear una sesión cuando ocurre un evento. El agente recibe el contexto del incidente, llama a las herramientas disponibles, examina sus resultados y decide qué investigar a continuación.
Claude Managed Agents aporta el entorno de ejecución, la gestión de sesiones y herramientas integradas para tareas como leer archivos y ejecutar comandos. También admite conexiones con sistemas externos mediante herramientas y Model Context Protocol (MCP).
Esto no significa que Anthropic ofrezca un producto completo de gestión de incidentes. Las integraciones de monitorización, los permisos operativos y los procedimientos de corrección siguen siendo responsabilidad de la organización. La diferencia es que los desarrolladores pueden crear un flujo de trabajo con agentes sin tener que construir ellos mismos cada parte del entorno de ejecución del agente.
Un incidente, de la alerta a la investigación
Anthropic ofrece un ejemplo concreto en su tutorial del 10 de abril, Build an SRE Incident Response Agent with Claude Managed Agents. La demostración empieza con una alerta simulada de PagerDuty. Un webhook pasa los detalles del incidente a una aplicación, que inicia una sesión del agente.
Después, el agente examina registros y archivos de infraestructura con las herramientas disponibles dentro de su entorno aislado (sandbox). También consulta un runbook proporcionado mediante una Skill, un paquete reutilizable de instrucciones y archivos de apoyo. La Skill indica al agente cómo espera el equipo que se investigue un incidente, incluida la consulta del runbook antes de modificar la infraestructura.
Cuando el agente identifica un posible problema de configuración, prepara un parche. Unas herramientas personalizadas permiten que el flujo de trabajo abra una pull request y solicite la aprobación de una persona antes de fusionarla. La secuencia muestra cómo un agente puede avanzar por varios pasos sin que un ingeniero tenga que indicarle cada uno manualmente.
Hay una limitación importante. En el tutorial, PagerDuty, GitHub y Datadog están simulados. El ejemplo muestra cómo construir la integración, no con qué fiabilidad funciona durante incidentes reales en producción.
Cuando la investigación se convierte en acción operativa
Leer registros e identificar una posible causa no es lo mismo que cambiar la infraestructura de producción. Un agente podría conectarse a herramientas para crear tickets de incidentes, abrir pull requests o invocar scripts aprobados. Con desarrollo adicional, también podría ayudar a correlacionar alertas relacionadas o a identificar notificaciones repetidas.
Se trata de posibles flujos de trabajo creados por el cliente. No demuestran que Claude Managed Agents incluya un servicio listo para usar de deduplicación de alertas ni de corrección autónoma.
Piensa en el problema de configuración de nuestro ejemplo de incidente. Preparar un parche le da a un ingeniero algo concreto que revisar. Aplicar ese parche cambia el estado operativo del sistema. Aunque la corrección propuesta parezca correcta, podría afectar a otros servicios o interferir con un despliegue que ya está en curso.
Por lo tanto, poder ejecutar un comando no demuestra que ejecutarlo sea seguro. Aquí es donde cobra importancia la distinción entre la capacidad del agente y la autoridad operativa.
Cómo deben adaptarse los runbooks a la ejecución por agentes
Los runbooks tradicionales suelen dar por hecho que un ingeniero con experiencia interpretará las instrucciones. Un procedimiento podría decir: «Reinicia el servicio si sigue en mal estado».
Antes de hacerlo, un ingeniero puede revisar los despliegues recientes, los servicios dependientes y los intentos de recuperación anteriores. Puede que esas comprobaciones no estén escritas de forma explícita porque el equipo las considera práctica habitual. Un agente no puede apoyarse con seguridad en supuestos no documentados.
Para la ejecución automatizada, el procedimiento necesita condiciones más claras.
- ¿Qué evidencia confirma el problema?
- ¿Qué comprobaciones de diagnóstico son obligatorias?
- ¿Está permitida la acción en este entorno?
- ¿Cuándo debe detenerse la ejecución?
- ¿Cómo debe verificarse la recuperación?
No es una disciplina completamente nueva. La automatización convencional también exige condiciones previas fiables, acciones predecibles y gestión de fallos. Los agentes gestionados añaden otra consideración, porque el agente puede elegir qué herramientas disponibles usar y en qué orden. Un runbook puede guiar esa toma de decisiones, pero las instrucciones por sí solas no deberían determinar los permisos en producción.
Dónde se toma la decisión de actuar
Claude Managed Agents ofrece políticas de permisos configurables para las herramientas integradas y las de MCP. Una herramienta puede ejecutarse automáticamente, requerir aprobación o evaluarse antes de la ejecución. Sin embargo, estas políticas no rigen las herramientas personalizadas. Cuando un agente solicita una herramienta personalizada, la aplicación del cliente recibe esa solicitud y es responsable de decidir si la ejecuta.
Esa distinción es especialmente importante en la respuesta a incidentes. Una organización podría permitir que un agente examine registros, lea archivos de configuración y prepare una pull request, y exigir en cambio una aprobación explícita para las acciones que reinician servicios o modifican la infraestructura de producción. La aplicación debería hacer cumplir esos límites con independencia de las instrucciones del agente.
También debe tener en cuenta qué ocurre cuando una acción falla, se solicita dos veces o solo se completa en parte. Detener un agente no deshace necesariamente un cambio ya realizado a través de un sistema externo.
Anthropic ofrece controles de sandbox, de red, de credenciales y de supervisión de sesiones. Esos controles son útiles, pero no sustituyen un diseño de integración seguro ni las comprobaciones operativas necesarias para confirmar que la recuperación ha tenido éxito.
El tratamiento de los datos también requiere atención. Actualmente, Managed Agents no puede acogerse al acuerdo Zero Data Retention de Anthropic ni a la cobertura de un HIPAA Business Associate Agreement. Los equipos que manejan información operativa sensible deben revisar esas restricciones antes de conectar datos de producción.
Hasta dónde deberían llegar hoy los equipos de DevOps
Managed Agents crea una oportunidad práctica para experimentar con una investigación de incidentes que se inicia automáticamente y avanza por varios pasos operativos. La demostración oficial de SRE muestra cómo puede montarse ese flujo de trabajo. No demuestra que la corrección autónoma mejore de forma constante el tiempo de recuperación ni que funcione con fiabilidad ante incidentes desconocidos.
Para un equipo que evalúa la plataforma, un experimento controlado es un punto de partida más útil que un acceso amplio a producción. Una alerta de prueba podría iniciar una sesión del agente con acceso a registros preparados, un runbook y un conjunto limitado de herramientas de diagnóstico de solo lectura. Los ingenieros podrían evaluar si el agente identifica la evidencia pertinente, sigue el procedimiento y explica correctamente la acción que propone.
El siguiente experimento podría permitir que el agente prepare un cambio para su revisión, sin permiso para aplicarlo. Estas pruebas ayudarían a establecer si el agente aporta una capacidad operativa útil y en qué puntos sus decisiones siguen sin ser fiables.
Claude Managed Agents cambia lo que los desarrolladores pueden construir en torno a los sistemas de operaciones de TI existentes. No elimina la necesidad de monitorización, de una automatización fiable, del criterio humano ni de prácticas consolidadas de gestión de incidentes.
Para los equipos de DevOps y SRE, la decisión importante no es simplemente si un agente de IA puede responder a un incidente. Es qué partes de esa respuesta pueden delegarse con seguridad y cómo sabrá el equipo cuándo el agente ha llegado a sus límites.
Para profundizar
- Claude Platform Release Notes, Anthropic. Beta del 8 de abril de 2026 y versiones posteriores.
- Claude Managed Agents Overview, Anthropic. Infraestructura y sesiones de los agentes gestionados.
- Build an SRE Incident Response Agent, Gagan Bhat, Anthropic, 10 de abril de 2026. Tutorial de respuesta a incidentes con servicios simulados.
- Permission Policies, Anthropic. Límites de las herramientas integradas, de MCP y personalizadas.
- Secure Your Managed Agents Deployment, Anthropic. Consideraciones de seguridad de la ejecución.
- Session Operations, Anthropic. Comportamiento del ciclo de vida de las sesiones.
Lecturas relacionadas en TechiesJournal
- Cuando la IA se une al equipo de guardia: ¿quién controla las decisiones en producción? (en inglés), sobre quién es responsable de una decisión en producción una vez que un agente la propone.
- El límite de credenciales de MCP: por qué un servidor MCP no debería decidir adónde van tus credenciales de OAuth (en inglés), sobre el lado de las herramientas y las credenciales en los permisos de los agentes.
- Después de cerrar la computadora portátil: qué infraestructura necesitan realmente los agentes de IA (en inglés), sobre el entorno de ejecución y la infraestructura que necesita un agente para seguir funcionando.