

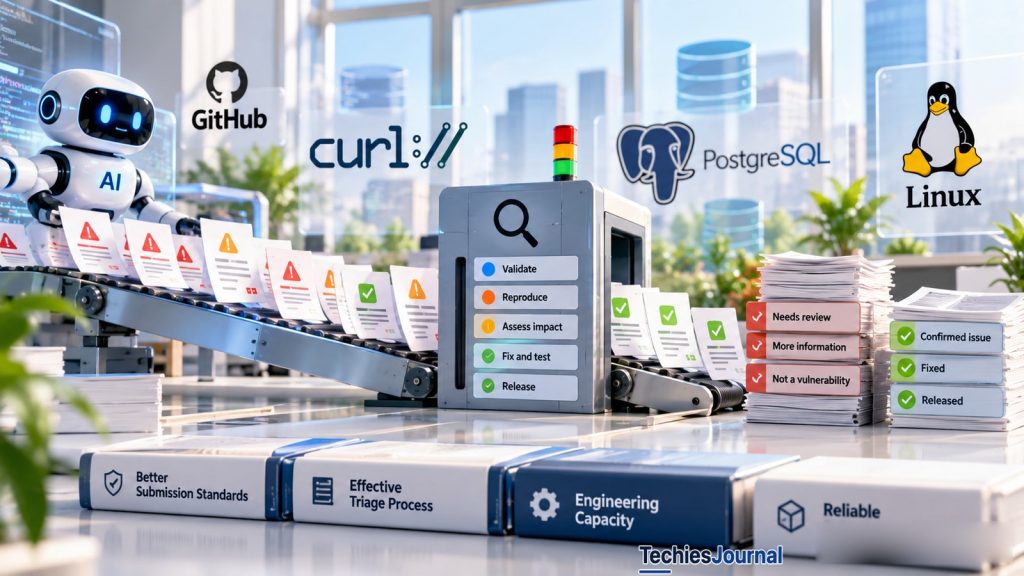
Les outils d’IA aident les développeurs à découvrir des problèmes logiciels plus vite qu’auparavant. Les expériences de curl et de PostgreSQL 19 montrent pourquoi le prochain défi consiste à décider quelles découvertes comptent, à les corriger sans risque et à trouver assez de temps pour une revue de code approfondie.
Quand trouver des bugs devient plus facile que les traiter
Pendant des années, curl a récompensé les chercheurs en sécurité qui découvraient de véritables faiblesses dans son logiciel. Le programme a permis de mettre au jour 87 vulnérabilités et a versé plus de 100 000 dollars de récompenses.
Puis la qualité des signalements reçus a changé.
Avant 2025, plus de 15 % des soumissions étaient confirmées comme de véritables vulnérabilités de sécurité. En 2025, ce chiffre est tombé sous les 5 %. De nombreux signalements semblaient convaincants, mais décrivaient des problèmes que les mainteneurs ne parvenaient ni à reproduire ni à confirmer.
Daniel Stenberg, le mainteneur de curl, a indiqué que le projet recevait un volume croissant de soumissions de mauvaise qualité, dont beaucoup avaient été produites avec l’aide de l’IA. Les examiner prenait un temps qui aurait pu servir à améliorer le logiciel.
Le 26 janvier 2026, Stenberg a annoncé la fermeture du programme de bug bounty rémunéré de curl. Le programme a officiellement pris fin le 31 janvier.
Cette décision était inhabituelle, car trouver davantage de problèmes de sécurité devrait, en principe, contribuer à rendre les logiciels plus sûrs. L’expérience a pourtant montré qu’une découverte plus facile pouvait aussi compliquer la maintenance.
Les outils d’IA peuvent examiner du code et suggérer où quelque chose pourrait ne pas aller. Ils ne peuvent pas rendre chaque suggestion correcte. Un développeur doit toujours déterminer si le problème signalé peut réellement se produire et s’il met les utilisateurs en danger.
Ce travail devient difficile lorsque les signalements arrivent plus vite qu’un projet ne peut les examiner.
L’expérience de curl est particulièrement révélatrice, car le problème n’a pas disparu lorsque la qualité des signalements s’est améliorée.
Le problème de curl a changé, mais la charge de travail est restée
En avril 2026, Stenberg décrivait une situation très différente.
La proportion de soumissions confirmées comme vulnérabilités était remontée à environ 15 à 16 %. Davantage de signalements mettaient au jour de véritables bugs, même lorsque ces problèmes ne relevaient pas des vulnérabilités de sécurité.
La qualité s’était améliorée, mais le nombre de signalements avait lui aussi augmenté. Ils arrivaient à un rythme environ deux fois supérieur à celui de 2025.
Pour curl, le problème n’était plus d’examiner trop d’affirmations peu fiables, mais de traiter un nombre croissant de découvertes utiles.
Une vulnérabilité confirmée exige plus que de reconnaître l’existence d’un problème. Les mainteneurs doivent en comprendre la cause, en évaluer la gravité, élaborer une correction et s’assurer que le correctif ne crée pas un autre problème.
Un petit projet open source ne dispose parfois que de quelques personnes expérimentées pour ce travail. Ces mêmes contributeurs maintiennent aussi les fonctionnalités existantes, relisent les modifications et préparent les nouvelles versions.
De meilleures découvertes apportent donc de réels bénéfices, mais elles peuvent aussi faire apparaître plus de travail que les mainteneurs ne peuvent en accomplir rapidement.
C’est pourquoi la qualité des signalements et la capacité de revue doivent être traitées séparément. Des exigences plus strictes pour les soumissions peuvent réduire les examens inutiles. Elles ne peuvent pas supprimer le travail d’ingénierie qu’engendrent de véritables défauts.
GitHub a pris une mesure voisine en mai 2026 en renforçant les exigences de son programme de bug bounty. Les chercheurs qui utilisent l’IA doivent vérifier leurs découvertes avant de les soumettre et fournir une démonstration fonctionnelle du problème signalé.
Cette politique ne décourage pas la recherche assistée par l’IA. Elle demande à l’auteur du signalement d’établir qu’une affirmation est crédible avant de la transmettre aux mainteneurs.
Cela réduit le travail évitable en début de processus. PostgreSQL 19 montre ce qui peut arriver lorsque des problèmes difficiles subsistent à l’approche d’une échéance de publication.
Ce qui a réellement retardé PostgreSQL 19
PostgreSQL est l’un des systèmes de bases de données open source les plus utilisés. Sa version 19 devait initialement sortir à l’automne 2026.
Le calendrier de publication a changé, et plusieurs fonctionnalités prévues ont été retirées de la version 19.
Peter Eisentraut, l’un des principaux développeurs de PostgreSQL, a écrit en octobre qu’environ huit à dix fonctionnalités importantes avaient été annulées (revert). Annuler une modification (revert) consiste à retirer un changement de code déjà accepté, généralement parce qu’il n’est pas prêt à rester dans la version.
Certains comptes rendus ont associé ces retraits à la revue de code assistée par l’IA. L’explication avancée était que les outils d’IA avaient découvert trop de bugs pour que les développeurs puissent les corriger avant la sortie.
L’IA a bien contribué à trouver des problèmes, mais ce n’était qu’une partie de la situation.
Eisentraut a décrit plusieurs facteurs. Certaines fonctionnalités présentaient de sérieux problèmes de conception qui auraient exigé des modifications importantes. D’autres contenaient des défauts plus mineurs, devenus plus faciles à trouver grâce à la revue de code assistée par LLM.
Dans le même temps, des contributeurs expérimentés de PostgreSQL avaient consacré une grande partie du cycle de publication à traiter des problèmes de sécurité. Le temps disponible pour relire les nouvelles fonctionnalités s’en est trouvé réduit. La revue est donc intervenue plus tard dans le cycle, et les développeurs ont découvert des problèmes alors qu’il restait peu de temps pour les résoudre.
La complexité de PostgreSQL a rendu certains correctifs particulièrement difficiles. Les fonctionnalités doivent se comporter correctement avec de nombreuses combinaisons de paramètres de base de données, de types de données et d’opérations. Une modification qui fonctionne dans un cas ordinaire peut échouer lorsque plusieurs fonctionnalités moins courantes sont utilisées ensemble.
Les tests assistés par l’IA peuvent aider à découvrir ces combinaisons inhabituelles. Mais un problème trouvé en fin de développement peut encore demander plus de temps que le calendrier de publication ne le permet.
Tomas Vondra, contributeur de PostgreSQL, a examiné les discussions à l’origine de douze modifications annulées. Il en a classé une comme liée à l’IA et une autre comme peut-être liée à l’IA. Il n’a pas trouvé d’éléments clairs permettant d’attribuer à l’IA la plupart des autres annulations.
Vondra a présenté ce travail comme son évaluation des discussions de développement disponibles, et non comme un décompte officiel de chaque bug découvert par l’IA.
Christophe Pettus a proposé une explication voisine. Selon lui, une part importante du problème tenait au moment où la revue avait lieu. Le travail de sécurité avait mobilisé les contributeurs expérimentés, si bien que certaines revues de fonctionnalités ont eu lieu plus tard que d’habitude.
Ces récits n’établissent pas une cause unique pour chaque fonctionnalité retirée. Ils montrent en revanche pourquoi l’affirmation répandue selon laquelle l’IA aurait trouvé plus de bugs que les développeurs ne pouvaient en corriger est incomplète.
Certains problèmes étaient difficiles en raison de leur conception. D’autres sont devenus visibles grâce à de meilleurs tests. D’autres encore ont été découverts tardivement parce que les personnes nécessaires à la revue étaient occupées ailleurs.
| Source | Ce qui a été examiné | Ce qui est affirmé | Ce que cela ne montre pas |
|---|---|---|---|
| Peter Eisentraut, 9 octobre 2026 | Pourquoi environ huit à dix fonctionnalités importantes ont été annulées | Plusieurs facteurs : de sérieux problèmes de conception, des défauts plus mineurs devenus plus faciles à trouver grâce à la revue de code assistée par LLM, et un travail de sécurité qui a mobilisé les contributeurs expérimentés. | Un décompte des bugs trouvés par l’IA, ou une cause unique pour chaque fonctionnalité retirée. |
| Tomas Vondra | Les discussions à l’origine de douze modifications annulées | Une classée comme liée à l’IA, une comme peut-être liée à l’IA, et pas d’éléments clairs permettant d’attribuer à l’IA la plupart des autres. | Un décompte officiel. Il s’agit de son évaluation des discussions disponibles. |
| Christophe Pettus | Le moment où la revue a eu lieu | Le travail de sécurité a mobilisé les contributeurs expérimentés, si bien que certaines revues de fonctionnalités ont eu lieu plus tard que d’habitude. | Que ce seul calendrier explique chaque fonctionnalité retirée. |
| Projet PostgreSQL, 15 octobre 2026 | Le calendrier de publication | Une deuxième version candidate (release candidate) le 12 novembre et la disponibilité générale le 19 novembre 2026, afin d’intégrer les correctifs de la mise à jour prévue en novembre. | Une date ferme. Le calendrier peut encore changer avant la disponibilité générale. |
| Snowflake Engineering, 16 septembre 2026 | Un récit complémentaire sur les tests assistés par l’IA et les décisions de publication | Cité comme lecture complémentaire. | Tout ce qui a été publié après le 16 septembre, y compris les récits d’octobre ci-dessus. |
L’annonce du projet PostgreSQL du 15 octobre a fixé une deuxième version candidate au 12 novembre et la disponibilité générale au 19 novembre 2026. Le projet a indiqué vouloir intégrer les correctifs de sa mise à jour prévue en novembre avant de passer la version 19 en disponibilité générale.
L’expérience de PostgreSQL ne prouve donc pas que l’IA a causé le retard de publication. Elle montre comment des tests plus efficaces, la complexité d’un logiciel et le moment de la revue de code peuvent peser sur les décisions de publication.
Ce qui se passe une fois qu’un outil a trouvé un problème
Un exemple simple permet de mieux voir le travail en jeu.
Supposons qu’un outil d’IA analyse une application web et avertisse qu’une entrée inattendue pourrait faire planter le service.
L’avertissement peut être utile, mais un développeur doit vérifier si cette entrée peut réellement atteindre le code concerné. L’application la rejette peut-être déjà, ou l’outil a peut-être mal interprété une vérification antérieure.
Si le problème est réel, l’équipe doit en évaluer la gravité. Une défaillance qui ne survient que dans un environnement de test n’a pas la même portée qu’une faiblesse qu’un attaquant peut exploiter à distance.
Ce n’est qu’ensuite que les développeurs peuvent choisir une correction appropriée.
Le correctif doit être testé, et le logiciel corrigé doit parvenir aux utilisateurs par une nouvelle version ou une mise à jour.
L’IA peut aider à plusieurs étapes. Elle peut suggérer des tests, expliquer du code et proposer des modifications. L’équipe reste néanmoins responsable de la vérification des résultats.
Cette distinction compte lorsque les équipes logicielles évaluent des outils d’IA.
Un rapport indiquant qu’un outil a découvert cent défauts possibles en dit peu sur l’amélioration réelle de la qualité du logiciel. L’équipe doit aussi savoir combien de découvertes étaient fondées, quelle était leur gravité et si elles ont été résolues.
C’est là le lien concret entre curl et PostgreSQL.
curl a subi la pression du nombre et de la qualité des signalements reçus. PostgreSQL a dû prendre des décisions difficiles sur l’état de préparation du logiciel lorsque les revues et les correctifs sont intervenus tardivement.
Les deux expériences rendent visible le travail qui entoure une découverte.
Ce que les équipes de développement devraient changer
Le même problème peut se poser dans une entreprise qui utilise des scanners de sécurité automatisés, des outils de revue de code par IA ou des plateformes de test logiciel.
Une équipe peut recevoir des centaines d’avertissements sans savoir lesquels méritent son attention. Si les développeurs passent l’essentiel de leur temps à rejeter des signalements erronés, c’est le processus de signalement qu’il faut améliorer.
L’approche de GitHub offre un point de départ utile. Exigez suffisamment d’éléments pour examiner une découverte, notamment une explication claire du comportement concerné et un exemple reproductible lorsque c’est possible.
Mais les équipes doivent aussi examiner ce qui se passe une fois un problème confirmé.
Si des découvertes valides restent ouvertes parce que les développeurs sont occupés à d’autres tâches, le problème ne tient plus à la qualité des signalements. L’organisation doit décider comment répartir le temps d’ingénierie.
Si les correctifs sont terminés mais attendent les tests ou l’approbation de publication, c’est plutôt cette étape qui demande de l’attention.
Un exercice utile consiste à suivre un petit échantillon de découvertes récentes, de la soumission à la résolution. Notez le temps qu’il a fallu pour valider, corriger, tester et publier chacune d’elles.
| Étape | Durée | Qui a fait le travail | Ce qui a fait attendre |
|---|---|---|---|
| Valider | à compléter | à compléter | à compléter |
| Corriger | à compléter | à compléter | à compléter |
| Tester | à compléter | à compléter | à compléter |
| Publier | à compléter | à compléter | à compléter |
Une fiche de travail TechiesJournal, pas des données. Copiez-la pour chaque découverte d’un petit échantillon de découvertes récentes.
Les résultats peuvent montrer que l’équipe a besoin de meilleurs contrôles automatisés avant d’accepter des signalements. Ils peuvent révéler que quelques ingénieurs expérimentés assument l’essentiel du travail de revue. Ou ils peuvent montrer que des correctifs importants attendent trop longtemps avant d’arriver en production.
Ce sont des décisions que l’équipe peut prendre à partir de ses propres données, plutôt que de supposer qu’un outil d’IA de plus résoudra le problème.
Le but n’est pas de ralentir la découverte de vulnérabilités. Il s’agit de garantir que l’organisation peut agir sur ce qu’elle découvre.
Découvrir plus vite n’est qu’une partie d’un meilleur logiciel
L’analyse assistée par l’IA permet d’examiner davantage de code et de mettre au jour des problèmes qui seraient peut-être restés cachés auparavant.
C’est un progrès utile.
L’expérience de curl montre pourquoi la qualité des découvertes reçues compte et ce qui se passe lorsque les signalements valides se multiplient. PostgreSQL 19 montre pourquoi le moment de la revue, la complexité d’une modification et la disponibilité de développeurs expérimentés restent importants.
Pour les équipes logicielles, la leçon est pratique. Mesurez ce que deviennent les découvertes après leur arrivée, et pas seulement combien les outils en trouvent.
La valeur de la détection de bugs assistée par l’IA tient à la transformation de découvertes crédibles en correctifs fiables qui parviennent aux utilisateurs.
Sources et lectures complémentaires
curl et le signalement de vulnérabilités
- Daniel Stenberg, The end of the curl bug-bounty, 26 janvier 2026. Le recul des signalements confirmés, l’historique du programme et sa fermeture le 31 janvier.
- Daniel Stenberg, High-Quality Chaos, 22 avril 2026. L’amélioration ultérieure de la qualité des signalements et la hausse de leur volume.
- GitHub, Raising the bar for its bug bounty programme, 15 mai 2026. Les attentes envers les signalements de sécurité assistés par l’IA et vérifiés.
PostgreSQL 19 et la revue de code
- Peter Eisentraut, The reverts will continue until morale improves, 9 octobre 2026. Le récit d’un développeur sur la pression de la publication, l’architecture, le travail de sécurité et la revue de code assistée par LLM.
- Tomas Vondra, Are we reverting patches because of bugs found by AI?. Examen au cas par cas de douze modifications annulées.
- Christophe Pettus, The patch is coming from inside the house. Analyse du moment où intervient la revue.
- PostgreSQL 19 Release Candidate 1 announcement, 15 octobre 2026. Le calendrier de publication révisé officiel.
- Snowflake Engineering, PostgreSQL 19 release delay and feature reverts, 16 septembre 2026. Un récit complémentaire sur les tests assistés par l’IA et les décisions de publication.
À lire aussi sur TechiesJournal
- Vulnérabilité Brotli de Node.js : comment les applications se retrouvent exposées et ce que les développeurs doivent vérifier (en anglais). Explique comment les équipes déterminent si une faiblesse de sécurité signalée affecte leurs applications.
Date de vérification des sources : 30 octobre 2026. Le calendrier de publication de PostgreSQL reste susceptible d’évoluer avant la disponibilité générale.