

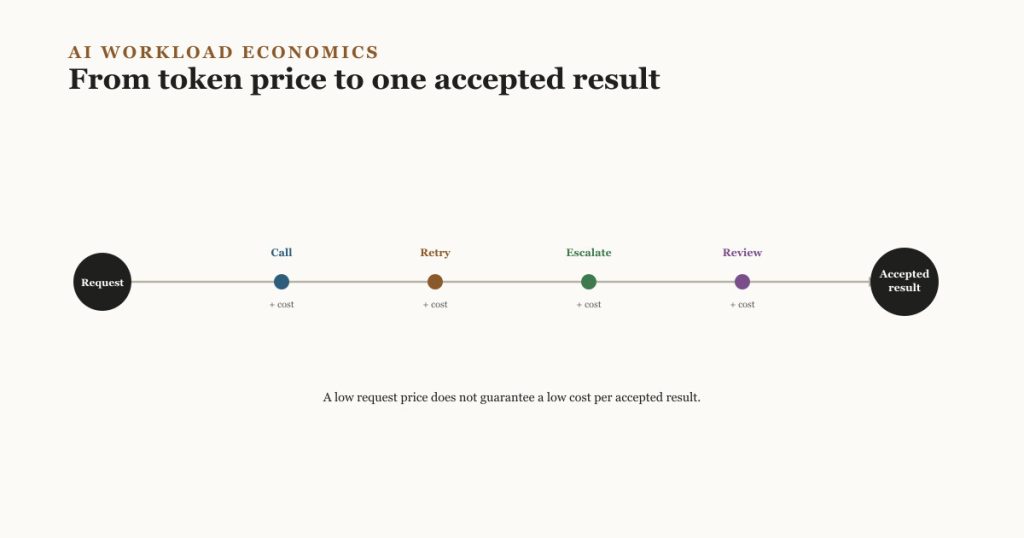
सस्ते टोकन मदद करते हैं, लेकिन वे यह नहीं बताते कि किसी AI वर्कफ़्लो की लागत क्या होगी। रीट्राई, कैश का इस्तेमाल, रीज़निंग एफर्ट और असफल नतीजे अक्सर ज़्यादा मायने रखते हैं।
एक इंजीनियरिंग टीम एक डॉक्यूमेंट-प्रोसेसिंग वर्कफ़्लो के लिए मॉडल चुन रही है। एक API प्रति मिलियन टोकन सस्ता है, इसलिए फ़ैसला आसान लगता है।
फिर ट्रायल शुरू होता है। सस्ता मॉडल ज़्यादा अमान्य आउटपुट देता है। कुछ दस्तावेज़ों को दूसरे प्रयास की ज़रूरत पड़ती है। मुश्किल मामले ज़्यादा सक्षम मॉडल को भेजे जाते हैं। लंबे निर्देश हर रिक्वेस्ट में बार-बार जोड़े जाते हैं। मानव समीक्षक नतीजे सुधारने में ज़्यादा समय बिताते हैं।
टोकन का बिल कम है, लेकिन वर्कफ़्लो का नहीं।
यही कई AI लागत तुलनाओं की कमज़ोरी है। वे टेक्स्ट प्रोसेस करने की क़ीमत की तुलना करती हैं, जबकि व्यवसाय पूरे हुए काम के लिए भुगतान करते हैं। ज़्यादा उपयोगी सवाल यह है:
एक ऐसा नतीजा बनाने में कितना ख़र्च आता है जिसे सिस्टम वाक़ई स्वीकार कर सके?
यही है प्रति सफल कार्य लागत (cost per successful task)। जैसे-जैसे AI छोटी बातचीत से आगे बढ़कर एजेंट और बहु-चरण वर्कफ़्लो में जा रहा है, यह और ज़्यादा महत्वपूर्ण होता जा रहा है।
हाल की क़ीमत कटौती क्यों मायने रखती है
22 सितंबर 2026 को, Anthropic ने Claude Opus 5.5 को $4 प्रति मिलियन इनपुट टोकन और $20 प्रति मिलियन आउटपुट टोकन पर जारी किया। Anthropic का कहना है कि यह Opus 5 की टोकन दरों से 20% कम है, और सामान्य वर्कलोड पर लगभग 40% सस्ता है क्योंकि नया मॉडल कम टोकन भी इस्तेमाल करता है। कैश रीड्स $0.50 से घटकर $0.20 प्रति मिलियन टोकन हो गईं।
OpenAI ने उसी दिन GPT-6 Sol और GPT-6 Luna जारी किए। Sol की क़ीमत $2 प्रति मिलियन इनपुट टोकन और $10 प्रति मिलियन आउटपुट टोकन है। Luna की क़ीमत क्रमशः $0.10 और $0.50 है। OpenAI दोनों को अपने GPT-5.6 पूर्ववर्तियों की प्रोमोशनल क़ीमतों से 50% सस्ता बताता है।
ये सार्थक कटौतियाँ हैं। ये किसी मौजूदा वर्कलोड को सस्ता बना सकती हैं और टीमों को उन इस्तेमालों पर विचार करने देती हैं जो पहले बहुत महंगे थे।
हालाँकि, ये यह साबित नहीं करतीं कि आपके एप्लिकेशन के लिए कौन-सा मॉडल सबसे सस्ता होगा। ये आँकड़े वेंडर से आए हैं, और उनकी घोषणाओं में दिए गए बेंचमार्क नतीजे ख़ास प्रॉम्प्ट, टूल, एफर्ट सेटिंग और मूल्यांकन नियमों के तहत बनाए गए थे। ये उपयोगी सबूत हैं, आपके अपने काम को परखने का विकल्प नहीं।
क़ीमत सूची सिर्फ़ एक परत दिखाती है
एक API इनवॉइस आमतौर पर तीन मात्राओं से शुरू होता है:
- पहली बार प्रोसेस किए गए इनपुट टोकन;
- प्रॉम्प्ट कैश से पढ़े गए इनपुट टोकन; और
- मॉडल द्वारा जनरेट किए गए आउटपुट टोकन।
एक मॉडल कॉल के लिए एक सरल गणना यह है:
मॉडल-कॉल लागत = नए इनपुट की लागत + कैश किए इनपुट की लागत + आउटपुट की लागत
कुछ एप्लिकेशनों को कैश राइट, टूल कॉल, वेब सर्च, कोड एग्ज़िक्यूशन, स्टोरेज या प्रीमियम प्रोसेसिंग मोड का हिसाब भी रखना पड़ता है। सटीक बिलिंग नियम प्रोवाइडर के हिसाब से अलग होते हैं।
यह फ़ॉर्मूला एक कॉल की लागत निकालता है। एक कार्य में कई कॉल हो सकती हैं।
एक कोडिंग एजेंट किसी रिपॉज़िटरी की जाँच कर सकता है, योजना बना सकता है, कई फ़ाइलें बदल सकता है, टेस्ट चला सकता है, विफलताओं की जाँच कर सकता है और फिर से कोशिश कर सकता है। एक सपोर्ट वर्कफ़्लो किसी रिक्वेस्ट को वर्गीकृत कर सकता है, ग्राहक जानकारी हासिल कर सकता है, जवाब का मसौदा बना सकता है, नीति जाँच सकता है और अनिश्चित मामलों को आगे बढ़ा सकता है। हर चरण कॉन्टेक्स्ट, आउटपुट और विफलता का एक और मौक़ा जोड़ सकता है।
यूनिट क़ीमत मायने रखती है, लेकिन स्वीकार्य नतीजे तक पहुँचने से पहले मॉडल जितना काम करता है, वह भी मायने रखता है।
एक सस्ता प्रयास ज़्यादा महंगा नतीजा दे सकता है
एक काल्पनिक उदाहरण लीजिए: 100 इनवॉइस-एक्सट्रैक्शन कार्यों का मूल्यांकन।
| माप | मॉडल A | मॉडल B |
|---|---|---|
| पहले प्रयास की लागत | $0.08 | $0.04 |
| बिना सुधार स्वीकृत कार्य | 80 | 30 |
| पहले-प्रयास का ख़र्च | $8.00 | $4.00 |
| स्वीकृत पहले-प्रयास नतीजे की लागत | $0.10 | $0.13 |
मॉडल B हर प्रयास पर आधा ख़र्च करता है। फिर भी हर स्वीकृत नतीजे के लिए उसकी लागत ज़्यादा है, क्योंकि कम नतीजे वैलिडेशन से गुज़रते हैं।
यह उदाहरण यह साबित नहीं करता कि बड़े या महंगे मॉडल हमेशा जीतते हैं। एक छोटा मॉडल किसी सीमित, अच्छी तरह डिज़ाइन किए गए काम पर बेहतरीन प्रदर्शन कर सकता है। यह दिखाता है कि हर (denominator) क्यों मायने रखता है। रिक्वेस्ट गिनना गतिविधि को इनाम देता है। स्वीकृत नतीजे गिनना उपयोगी काम को मापता है।
एक व्यावहारिक मूल्यांकन के लिए, इसका इस्तेमाल करें:
प्रति सफल कार्य लागत = कुल वर्कफ़्लो ख़र्च ÷ स्वीकृत नतीजों की संख्या
टेस्ट चलाने से पहले “स्वीकृत” को परिभाषित करें। संरचित एक्सट्रैक्शन के लिए, इसका मतलब हो सकता है ज़रूरी फ़ील्ड और सहनशील सीमा में मौजूद मान वाला वैध JSON। कोड के लिए, इसका मतलब हो सकता है कि टेस्ट पास हों, सुरक्षा जाँच साफ़ रहे और समीक्षक बदलाव को स्वीकार करे। गुणवत्ता की सीमा के बिना, कार्य की कम लागत का सीधा मतलब यह भी हो सकता है कि सिस्टम सस्ती ग़लतियाँ कर रहा है।
केवल उदाहरण मान — अपना ख़ुद का वर्कलोड डेटा डालें। यह कैलकुलेटर लागत का अनुमान लगाता है, यह असली इनवॉइस की भविष्यवाणी नहीं करता।
मॉडल A
- अनुमानित API लागत प्रति प्रयास
- $0.0594
- अनुमानित API लागत प्रति प्रयासित कार्य (रीट्राई और एस्केलेशन के बाद)
- $0.0678
- अनुमानित API लागत प्रति स्वीकृत कार्य
- $0.0848
- अनुमानित मानव-समीक्षा लागत प्रति स्वीकृत कार्य
- $0.00
- अनुमानित परिचालन लागत प्रति स्वीकृत कार्य
- $0.0848
मॉडल B
- अनुमानित API लागत प्रति प्रयास
- $0.0264
- अनुमानित API लागत प्रति प्रयासित कार्य (रीट्राई और एस्केलेशन के बाद)
- $0.0431
- अनुमानित API लागत प्रति स्वीकृत कार्य
- $0.0784
- अनुमानित मानव-समीक्षा लागत प्रति स्वीकृत कार्य
- $1.00
- अनुमानित परिचालन लागत प्रति स्वीकृत कार्य
- $1.08
इन मानों पर, मॉडल B की प्रति स्वीकृत कार्य अनुमानित API लागत कम है। मानव-समीक्षा समय शामिल करने के बाद, मॉडल A की प्रति स्वीकृत कार्य अनुमानित परिचालन लागत कम है।
यह एक शैक्षिक अनुमान उपकरण है, इनवॉइस की भविष्यवाणी करने वाला नहीं। यह लाइव वेंडर क़ीमतें नहीं लाता। अगर स्क्रिप्ट बंद हैं, तो ऊपर के आँकड़े पहले से भरे उदाहरण मानों का नतीजा दिखाते हैं — स्क्रिप्ट चालू होने के बाद अपने ख़ुद के नंबर आज़माने के लिए फ़ील्ड बदलें और रीसेट दबाएँ।
कैशिंग बार-बार आने वाले कॉन्टेक्स्ट की अर्थव्यवस्था बदल देती है
एजेंट अक्सर वही सामग्री दोबारा भेजते हैं: सिस्टम निर्देश, टूल परिभाषाएँ, रिपॉज़िटरी कॉन्टेक्स्ट, नीति दस्तावेज़ या लंबा बातचीत इतिहास। प्रॉम्प्ट कैशिंग प्रोवाइडर को हर बार पूरी इनपुट दर वसूलने के बजाय, पहले से प्रोसेस किए गए प्रीफ़िक्स को दोबारा इस्तेमाल करने देती है।
OpenAI का कहना है कि GPT-6 कैश किए इनपुट रीड पर 90% की छूट देता है और उसने कैश प्रदर्शन की निगरानी के लिए टूल जोड़े हैं। Anthropic अपनी $4 की बेस इनपुट दर की तुलना में Opus 5.5 के कैश रीड की क़ीमत $0.20 प्रति मिलियन टोकन रखता है। दोनों ही मामलों में, दोहराया गया कॉन्टेक्स्ट नए कॉन्टेक्स्ट से कहीं सस्ता हो सकता है।
विज्ञापित छूट वही नहीं है जो आपके एप्लिकेशन को वाक़ई मिलेगी। कैश तभी मदद करता है जब रिक्वेस्ट किसी योग्य, स्थिर प्रीफ़िक्स को दोबारा इस्तेमाल करती हैं। अगर कोई एप्लिकेशन हर बार निर्देश, टूल परिभाषाएँ या शुरुआती कॉन्टेक्स्ट बदलता है, तो कैश-हिट दर कम रह सकती है।
प्रोडक्शन-जैसे परीक्षणों में इन्हें मापें:
- कितने इनपुट टोकन कैशिंग के योग्य थे;
- वाक़ई कितने कैश से पढ़े गए;
- किन प्रॉम्प्ट बदलावों से मिस हुए; और
- क्या कैश राइट या लंबी रिटेंशन लागत जोड़ती है।
इसलिए प्रॉम्प्ट डिज़ाइन लागत इंजीनियरिंग का हिस्सा है। जहाँ प्रोवाइडर के कैशिंग नियम उस संरचना का समर्थन करते हों, वहाँ स्थिर सामग्री को आमतौर पर परिवर्तनशील सामग्री से पहले आना चाहिए। लेकिन सिर्फ़ कैश दर सुधारने के लिए ग़लत या फूले हुए निर्देशों को स्थिर मत करें। अगर कोई सस्ता, दोहराया गया प्रॉम्प्ट मॉडल को कम भरोसेमंद बना देता है, तो वह भी पैसा बर्बाद कर सकता है।
रीज़निंग एफर्ट एक और क़ीमत नियंत्रण है
कई मौजूदा मॉडल डेवलपर्स को यह समायोजित करने देते हैं कि वे कितना रीज़निंग एफर्ट इस्तेमाल करें। ज़्यादा एफर्ट मुश्किल कामों को बेहतर बना सकता है, लेकिन इसमें ज़्यादा टोकन लग सकते हैं और ज़्यादा समय लग सकता है। हर रिक्वेस्ट पर सबसे ऊँची सेटिंग लगाना हर सामान्य टिकट पर एक वरिष्ठ इंजीनियर लगाने जैसा है।
उल्टी ग़लती भी आम है। एक कम-लागत, कम-एफर्ट कॉन्फ़िगरेशन इतनी बार विफल हो सकता है कि रीट्राई और एस्केलेशन बचत को मिटा दें।
एक बेहतर डिज़ाइन काम को कठिनाई के हिसाब से रूट करता है। अच्छी तरह समझे गए, आसानी से वैलिडेट होने वाले कामों के लिए कम-लागत कॉन्फ़िगरेशन इस्तेमाल करें। अनिश्चित या ज़्यादा-असर वाले मामलों को ज़्यादा सक्षम मॉडल या ऊँचे एफर्ट स्तर तक बढ़ाएँ। रूटिंग का फ़ैसला मापी गई गुणवत्ता पर आधारित होना चाहिए, न कि इस सामान्य धारणा पर कि कोई मॉडल “काफ़ी समझदार” है।
इससे एक नई लागत आती है: राउटर ग़लतियाँ कर सकता है। अगर वह किसी मुश्किल मामले को कमज़ोर रास्ते पर भेजता है, तो वर्कफ़्लो को काम दोहराना पड़ सकता है। अगर वह सब कुछ सबसे सक्षम रास्ते पर भेजता है, तो सस्ते टियर का कोई मूल्य नहीं बचता। रूटिंग की गुणवत्ता मूल्यांकन का हिस्सा होनी चाहिए।
रीट्राई एक ख़राब ढंग से डिज़ाइन किए गए वर्कफ़्लो को छुपा सकते हैं
रीट्राई कभी-कभी ज़रूरी होते हैं। नेटवर्क विफल होते हैं, टूल टाइमआउट होते हैं, और मॉडल कभी-कभी बिगड़े हुए नतीजे लौटाते हैं। लेकिन एक एप्लिकेशन जो चुपचाप फिर से कोशिश करता है, वह अपनी खपत दोगुनी करते हुए एक कमज़ोर डिज़ाइन को भरोसेमंद दिखा सकता है।
हर रीट्राई क्यों हुआ, इसे ट्रैक करें:
- प्रोवाइडर या नेटवर्क विफलता;
- अमान्य फ़ॉर्मैट;
- विफल वैलिडेशन;
- गुम सबूत;
- टूल विफलता;
- मॉडल की ख़ुद सुधार करना; या
- मानव अस्वीकृति।
इन कारणों के लिए अलग-अलग समाधान चाहिए। स्कीमा की समस्या के लिए सीमित आउटपुट चाहिए हो सकता है। गुम जानकारी के लिए बेहतर रिट्रीवल चाहिए हो सकता है। टूल की विफलताओं का मॉडल से कोई लेना-देना नहीं हो सकता। ज़्यादा मुश्किल रीज़निंग समस्या एस्केलेशन को सही ठहरा सकती है।
रीट्राई को लागत रिपोर्ट में दिखना चाहिए, अंतिम सफल जवाब के पीछे ग़ायब नहीं होना चाहिए।
API बिल पूरी परिचालन लागत नहीं है
प्रति सफल कार्य लागत टोकन क़ीमत से बेहतर है, लेकिन अगर इसमें सिर्फ़ API शुल्क शामिल हों, तो यह भी बहुत सीमित हो सकता है।
असली सिस्टम रिट्रीवल, वेक्टर स्टोरेज, डेटाबेस, सैंडबॉक्स, ऑब्ज़र्वेबिलिटी, सुरक्षा नियंत्रण और मानव समीक्षा के लिए भी भुगतान कर सकते हैं। जब उपयोगकर्ता इंतज़ार करते हैं या इंफ्रास्ट्रक्चर व्यस्त रहता है, तो लेटेंसी की भी लागत होती है। ग़लत कार्रवाइयाँ इन्फ़रेंस से कहीं ज़्यादा महंगी हो सकती हैं, ख़ासकर वित्त, स्वास्थ्य सेवा, सुरक्षा या प्रोडक्शन संचालन में।
अलग-अलग तरह की लागतों को मिलाने के बजाय दो आँकड़े अलग रखें:
- प्रति स्वीकृत कार्य API लागत — सीधे मॉडल और टूल शुल्क।
- प्रति स्वीकृत कार्य परिचालन लागत — API लागत, साथ ही इंफ्रास्ट्रक्चर और मापा गया मानव संचालन।
यह विभाजन गणना को समझने लायक रखते हुए, दिखने में सस्ते API को महंगे सुधार कार्य को छुपाने से रोकता है।
एक उपयोगी लागत मूल्यांकन कैसे चलाएँ
जहाँ ज़रूरी हो वहाँ संवेदनशील जानकारी हटाकर, वास्तविक कार्यों के एक प्रतिनिधि नमूने से शुरुआत करें। सामान्य मामले, मुश्किल मामले और जानी-पहचानी विफलताएँ शामिल करें।
हर मॉडल और कॉन्फ़िगरेशन के लिए, इन्हें दर्ज करें:
- नए, कैश किए और आउटपुट टोकन;
- मॉडल और टूल कॉल की संख्या;
- रीज़निंग या एफर्ट सेटिंग;
- लेटेंसी;
- रीट्राई और एस्केलेशन;
- वैलिडेशन नतीजा;
- मानव-समीक्षा समय; और
- अंतिम स्वीकृति।
विविधता उजागर करने के लिए पर्याप्त मामले चलाएँ। एजेंट वर्कफ़्लो पूरी तरह निश्चित नहीं होते, इसलिए एक प्रभावशाली प्रदर्शन कमज़ोर सबूत है। महत्वपूर्ण मामलों को दोहराएँ और सिर्फ़ औसत स्कोर नहीं, बल्कि विफलताओं की भी जाँच करें।
अंत में, एक बजट और गुणवत्ता की सीमा तय करें। सबसे ऊँचे बेंचमार्क स्कोर या सबसे कम इनवॉइस वाला मॉडल ज़रूरी नहीं कि जीतने वाला विकल्प हो। यह वह कॉन्फ़िगरेशन है जो आपकी ज़रूरी गुणवत्ता, लेटेंसी और जोखिम स्तर को सबसे कम टिकाऊ परिचालन लागत पर पूरा करता है।
टीमों को अभी क्या करना चाहिए
अगर आप पहले से AI वर्कलोड चला रहे हैं, तो सितंबर की क़ीमत में बदलाव एक ताज़ा मूल्यांकन की माँग करते हैं। पिछली तिमाही की स्प्रेडशीट में बस दर मत बदलें।
मौजूदा टोकन दरों, देखे गए कैश हिट, रीट्राई गिनती और स्वीकृति दरों का इस्तेमाल करके असली वर्कफ़्लो की दोबारा गणना करें। जाँचें कि क्या एक सस्ता टियर सुधार बढ़ाए बिना सामान्य काम संभाल सकता है। जाँचें कि क्या महंगे कॉन्टेक्स्ट को स्थिर और दोबारा इस्तेमाल लायक बनाया जा सकता है। प्रति स्वीकृत कार्य लागत के आसपास अलर्ट लगाएँ ताकि कोई प्रॉम्प्ट या एजेंट बदलाव चुपचाप अर्थव्यवस्था को नुक़सान न पहुँचाए।
अभी प्रयोग कर रही टीमों के लिए, अभी से ये माप इकट्ठा करना शुरू करें। एक बार एजेंट प्रोडक्शन में पहुँच जाए, तो गुम टेलीमेट्री को दोबारा बनाना महंगा हो जाता है।
टोकन की क़ीमतें गिरती रहेंगी। यह अच्छी ख़बर है, लेकिन इससे लागत इंजीनियरिंग की ज़रूरत ख़त्म नहीं होगी। जैसे-जैसे AI सिस्टम काम की लंबी शृंखलाएँ पूरी करते हैं, अहम सवाल अब यह नहीं है कि मॉडल कितनी सस्ती टेक्स्ट जनरेट कर सकता है। सवाल यह है कि पूरा सिस्टम किसी काम को कितनी भरोसेमंद तरीक़े से पूरा कर सकता है।
संदर्भ और आगे पढ़ने के लिए
- Claude Opus 5.5 — Anthropic, 22 सितंबर 2026. Opus 5.5 के लिए क़ीमत, कैश दरें, प्रदर्शन के दावे और डिप्लॉयमेंट विवरण।
- Introducing GPT-6 Sol and Luna — OpenAI, 22 सितंबर 2026. API क़ीमत, कार्य-लागत मूल्यांकन और प्रॉम्प्ट-कैशिंग बदलाव।
- OpenAI API pricing — OpenAI. मौजूदा API रेट कार्ड और प्रोसेसिंग विकल्प; लागू करने से पहले दोबारा जाँचें।
- Claude pricing — Anthropic. मौजूदा मॉडल, प्रॉम्प्ट-कैशिंग और बैच-प्रोसेसिंग क़ीमतें; लागू करने से पहले दोबारा जाँचें।
- AutomationBench — Zapier. बहु-एप्लिकेशन व्यावसायिक वर्कफ़्लो में एजेंटों के मूल्यांकन पर पृष्ठभूमि।
स्रोत समीक्षा तिथि: 25 सितंबर 2026.
संबंधित पठन: जब AI मॉडल दूसरे AI मॉडलों से सीखते हैं: डिस्टिलेशन, API दुरुपयोग और निर्यात नियंत्रणों की सीमाएँ.