

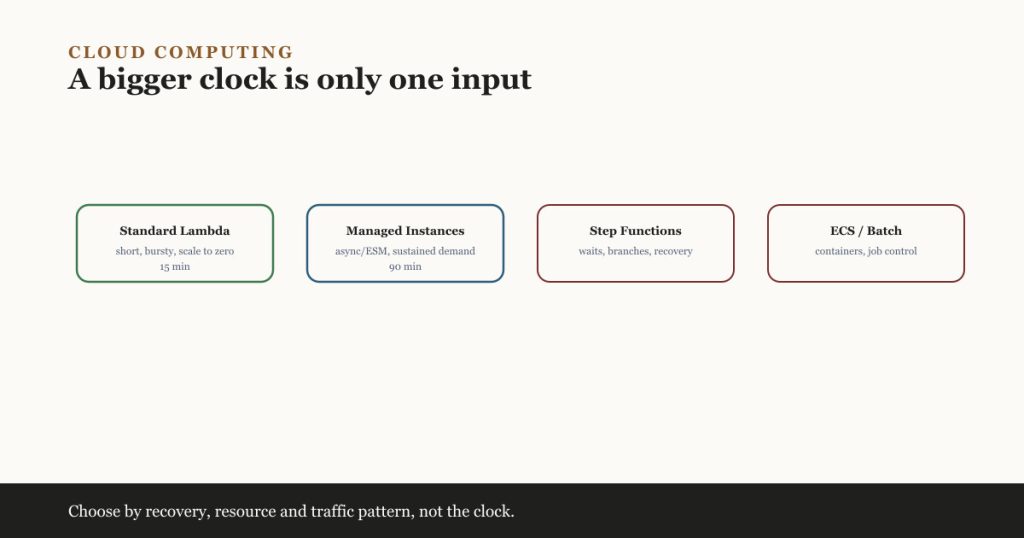
नई सीमा केवल कुछ Lambda Managed Instances इनवोकेशन पर लागू होती है। लंबा टाइमआउट अपने आप Lambda को हर बैच जॉब के लिए सही जगह नहीं बना देता।
बड़ा टाइमआउट एक बड़े आर्किटेक्चर फ़ैसले को छुपा सकता है
AWS Lambda ने अपनी पहचान छोटे, इवेंट-ड्रिवन काम पर बनाई। एक फ़ाइल आती है, एक मैसेज क्यू में दाख़िल होता है, एक API अनुरोध किसी फ़ंक्शन को कॉल करता है, और फ़ंक्शन जल्दी ख़त्म हो जाता है।
सितंबर 2026 में, AWS ने Lambda Managed Instances पर चलने वाले कुछ वर्कलोड के लिए अधिकतम टाइमआउट बढ़ाकर 90 मिनट कर दिया। यह एक सीधा विस्तार लगता है: जो जॉब पहले Lambda की 15-मिनट सीमा से आगे निकल जाते थे, वे अब Lambda में ही रह सकते हैं।
लेकिन यह सामान्य Lambda के लिए कोई सार्वभौमिक बदलाव नहीं है। यह Lambda Managed Instances पर असिंक्रोनस और इवेंट-सोर्स-मैपिंग इनवोकेशन पर लागू होता है। सिंक्रोनस कॉल अभी भी 15 मिनट तक सीमित रहते हैं। Amazon MQ और Amazon DocumentDB इवेंट-सोर्स मैपिंग भी 15-मिनट सीमा बनाए रखती हैं।
इससे भी अहम बात यह है कि Lambda Managed Instances कंप्यूट, कंकरेंसी, स्केलिंग और प्राइसिंग मॉडल को बदल देता है। फ़ैसला सिर्फ़ यह नहीं है कि किसी फ़ंक्शन को अतिरिक्त 75 मिनट चाहिए या नहीं। फ़ैसला यह है कि क्या वर्कलोड Lambda के इस अलग रूप में फ़िट बैठता है।
क्या बदला—और क्या नहीं बदला
| इनवोकेशन या कंप्यूट मोड | अधिकतम निरंतर इनवोकेशन |
|---|---|
| स्टैंडर्ड Lambda सिंक्रोनस इनवोकेशन | 15 मिनट |
| स्टैंडर्ड Lambda असिंक्रोनस इनवोकेशन | 15 मिनट |
| Lambda Managed Instances सिंक्रोनस इनवोकेशन | 15 मिनट |
| Lambda Managed Instances असिंक्रोनस इनवोकेशन | 90 मिनट |
| Managed Instances पर अधिकांश इवेंट-सोर्स मैपिंग | 90 मिनट |
| Amazon MQ या DocumentDB इवेंट-सोर्स मैपिंग | 15 मिनट |
AWS मीडिया प्रोसेसिंग, AI इनफ़रेंस, वैज्ञानिक काम, वित्तीय गणनाएँ, धीमे फ़ाइल ट्रांसफ़र और बड़े डेटा-प्रोसेसिंग जॉब जैसे इस्तेमाल के मामलों का वर्णन करता है। ये तकनीकी रूप से संभावित उम्मीदवार हैं। तकनीकी योग्यता सिर्फ़ पहला फ़िल्टर है।
Managed Instances सिर्फ़ बड़ी घड़ी वाला सामान्य Lambda नहीं है
स्टैंडर्ड Lambda AWS-प्रबंधित, मल्टी-टेनेंट इन्फ़्रास्ट्रक्चर पर एग्ज़ीक्यूशन वातावरण चलाता है और मुख्यतः अनुरोधों और एग्ज़ीक्यूशन अवधि के आधार पर शुल्क लेता है। निष्क्रिय होने पर यह ज़ीरो तक स्केल हो जाता है।
Lambda Managed Instances आपके अकाउंट में EC2 क्षमता पर फ़ंक्शन चलाता है, जबकि AWS इंस्टेंस लाइफ़साइकल, रनटाइम पैचिंग, रूटिंग और स्केलिंग का प्रबंधन करता है। यह इंस्टेंस-आधारित प्राइसिंग इस्तेमाल करता है, जिसमें एक मैनेजमेंट फ़ीस शामिल है, और स्केल-टू-ज़ीरो स्टैंडर्ड Lambda की तरह व्यवहार करने के बजाय कॉन्फ़िगर की गई न्यूनतम क्षमता बनाए रखता है।
यह एक ही एग्ज़ीक्यूशन वातावरण के भीतर कई समवर्ती (concurrent) इनवोकेशन का भी समर्थन करता है। इससे I/O-भारी वर्कलोड के लिए उपयोग बेहतर हो सकता है, लेकिन यह शेयर्ड मेमोरी, ग्लोबल वैरिएबल, थ्रेड सेफ़्टी और कॉन्टेक्स्ट आइसोलेशन को लेकर मान्यताएँ बदल देता है। सामान्य Lambda के सिंगल-कंकरेंसी व्यवहार के लिए लिखा गया फ़ंक्शन Managed Instances पर सुरक्षित होने से पहले इंजीनियरिंग काम माँग सकता है।
इससे 90-मिनट की सीमा एक व्यापक फ़ैसले का हिस्सा बन जाती है:
- क्या आपके पास इंस्टेंस क्षमता को उचित ठहराने लायक़ स्थिर माँग है?
- क्या कोड एक ही वातावरण में समवर्ती इनवोकेशन को सुरक्षित रूप से संभाल सकता है?
- क्या वर्कलोड के लिए CPU-आधारित असिंक्रोनस स्केलिंग उपयुक्त है?
- अगर जॉब मिनट 89 पर विफल हो जाए, तो क्या यह रिकवर हो सकता है?
- क्या Lambda अब भी किसी कंटेनर या बैच सेवा पर कोई फ़ायदा देता है?
लंबे समय तक चलना टिकाऊपन की गारंटी नहीं
टाइमआउट आपको बताता है कि कोड कितनी देर तक चलता रह सकता है। यह गारंटी नहीं देता कि काम पूरा हो ही जाएगा।
इंस्टेंस विफल होते हैं। डिपेंडेंसी टाइमआउट होती हैं। डिप्लॉयमेंट वातावरण बदल देते हैं। कोई मैसेज दोबारा डिलीवर हो सकता है। अगर कोई 70-मिनट का जॉब विफल होने के बाद शुरुआत से फिर से चलता है, तो बड़े टाइमआउट ने उस काम की मात्रा बढ़ा दी है जो खोया जा सकता है।
इसलिए लंबे जॉब को इनकी ज़रूरत होती है:
- इडमपोटेंट प्रोसेसिंग ताकि रिट्राई से बिज़नेस प्रभाव दोहरे न हों;
- चेकपॉइंट या पार्टिशन ताकि रिकवरी में सब कुछ दोबारा शुरू न करना पड़े;
- एक स्पष्ट रिट्राई और डेड-लेटर नीति;
- प्रगति और विफलता की टेलीमेट्री;
- सीमित इनपुट आकार और एग्ज़ीक्यूशन समय;
- सुरक्षित कैंसिलेशन और क्लीनअप।
AWS ड्यूरेबल फ़ंक्शन कई चरणों में एप्लिकेशन स्थिति सुरक्षित रख सकते हैं और चेकपॉइंट से फिर से शुरू हो सकते हैं। Step Functions कई कार्यों, प्रतीक्षाओं और शाखाओं का समन्वय कर सकता है। AWS Batch और ECS अलग-अलग संसाधन और जॉब-नियंत्रण मॉडल के साथ कंटेनराइज़्ड कंप्यूट चला सकते हैं। एक 90-मिनट का इनवोकेशन इन क्षमताओं की जगह नहीं लेता।
90-मिनट Lambda कहाँ फ़िट बैठता है
Lambda Managed Instances एक अच्छा विकल्प हो सकता है जब वर्कलोड:
- असिंक्रोनस रूप से या किसी समर्थित इवेंट सोर्स से ट्रिगर होता है;
- सामान्यतः 90 मिनट के भीतर आराम से पूरा हो जाता है;
- पूर्वानुमेय या लगातार माँग रखता है जो प्रोविज़न की गई इंस्टेंस क्षमता का इस्तेमाल कर सके;
- EC2 इंस्टेंस विकल्पों से फ़ायदा उठाता है लेकिन कंटेनर प्लेटफ़ॉर्म प्रबंधित करने को उचित नहीं ठहराता;
- Managed Instances के कंकरेंसी मॉडल को सहन कर सकता है;
- इडमपोटेंट है और काम को सुरक्षित रूप से चेकपॉइंट या विभाजित कर सकता है;
- पहले से ही Lambda के इवेंट, डिप्लॉयमेंट और ऑब्ज़र्वेबिलिटी मॉडल में फ़िट बैठता है।
उदाहरण के लिए, SQS से बड़े दस्तावेज़ों की स्थिर धारा प्रोसेस करने वाली एक टीम, लंबी प्रोसेसिंग और विशेष कंप्यूट के लिए Managed Instances का इस्तेमाल करते हुए Lambda इंटीग्रेशन को महत्व दे सकती है।
जहाँ कोई और सेवा शायद बेहतर हो
| वर्कलोड की विशेषता | बेहतर शुरुआती बिंदु | क्यों |
|---|---|---|
| छोटी, फटाफट इवेंट प्रोसेसिंग | स्टैंडर्ड Lambda | स्केल-टू-ज़ीरो और प्रति-इनवोकेशन सीधी इकोनॉमिक्स |
| प्रतीक्षाओं या मंज़ूरियों वाली मल्टी-स्टेप प्रक्रिया | Step Functions या ड्यूरेबल फ़ंक्शन | स्पष्ट स्थिति, चेकपॉइंट और रिकवरी |
| बड़ी कंटेनर इमेज या कस्टम ऑपरेटिंग वातावरण | ECS/Fargate | रनटाइम और टास्क लाइफ़साइकल पर अधिक नियंत्रण |
| अलग-अलग CPU/GPU आवश्यकताओं वाला क्यूड कंप्यूट | AWS Batch | जॉब क्यू, शेड्यूलिंग और कंप्यूट वातावरण |
| काम नियमित रूप से 90 मिनट के क़रीब पहुँचता है | ECS या Batch | ज़्यादा हेडरूम और स्पष्ट जॉब नियंत्रण |
| निरंतर सेवा या लंबे समय तक चलने वाला वर्कर | ECS/EKS/EC2 | यह स्वाभाविक रूप से कोई इनवोकेशन नहीं है |
ये शुरुआती बिंदु हैं, सार्वभौमिक नियम नहीं। डेटा मूवमेंट, टीम का कौशल, क्षेत्रीय उपलब्धता, अनुपालन, स्टार्टअप लेटेंसी और लागत जवाब बदल सकते हैं।
लागत का सवाल भी अलग है
60-मिनट के स्टैंडर्ड-शैली इनवोकेशन की क़ीमत की तुलना किसी कंटेनर टास्क से करना लुभावना है। लेकिन यह अधूरा है क्योंकि Managed Instances स्टैंडर्ड Lambda के स्केल-टू-ज़ीरो अवधि मॉडल के बजाय EC2-आधारित क्षमता इस्तेमाल करता है।
पूरे परिचालन पैटर्न का मॉडल बनाएँ:
- न्यूनतम इंस्टेंस जो उपलब्ध रहते हैं।
- औसत और चरम उपयोग।
- प्रति एग्ज़ीक्यूशन वातावरण प्राप्त कंकरेंसी।
- इंस्टेंस, स्टोरेज, डेटा-ट्रांसफ़र और मैनेजमेंट शुल्क।
- रिट्राई और दोहराए गए काम की लागत।
- कंटेनर की तुलना में बचाई गई परिचालन मेहनत।
अगर क्षमता निष्क्रिय पड़ी रहे या लंबी रिट्राई बड़े जॉब को बार-बार दोहराए, तो सस्ता कंप्यूट मिनट भी एक महँगा सिस्टम बना सकता है।
आर्किटेक्ट अब आगे क्या करें?
किसी Step Functions, ECS या Batch वर्कलोड को सिर्फ़ डायग्राम से एक सेवा हटाने के लिए माइग्रेट न करें।
एक उम्मीदवार जॉब चुनें और इन्हें मापें:
- वास्तविक अवधि का वितरण, न कि सिर्फ़ औसत;
- CPU, मेमोरी, स्टोरेज और नेटवर्क का उपयोग;
- आगमन पैटर्न और प्राप्त की जा सकने वाली कंकरेंसी;
- विफलता की आवृत्ति और रीस्टार्ट लागत;
- रुकावट के बाद रिकवरी पॉइंट;
- मौजूदा कुल लागत, जिसमें ऑर्केस्ट्रेशन और संचालन शामिल है।
फिर एक छोटे Managed Instances ट्रायल की तुलना मौजूदा आर्किटेक्चर से करें। अगर नया डिज़ाइन सरल, रिकवर करने योग्य और आर्थिक रूप से सही है, तो लंबा टाइमआउट उपयोगी है। अगर सिर्फ़ यही तर्क है कि “अब यह 90 मिनट के भीतर फ़िट हो जाता है,” तो आर्किटेक्चर की समीक्षा अभी पूरी नहीं हुई है।
जानें, इस्तेमाल करें या महारत हासिल करें?
जानें: क्लाउड प्रैक्टिशनरों को समझना चाहिए कि 90-मिनट की सीमा हर Lambda फ़ंक्शन के लिए उपलब्ध नहीं है और Managed Instances एक अलग क्षमता मॉडल इस्तेमाल करता है।
इस्तेमाल करें: डेवलपर्स और DevOps इंजीनियरों को लंबे जॉब के लिए इडमपोटेंसी, चेकपॉइंटिंग, कंकरेंसी सेफ़्टी, रिट्राई और टेलीमेट्री डिज़ाइन करने में सक्षम होना चाहिए।
महारत: क्लाउड आर्किटेक्ट को वर्कलोड व्यवहार, रिकवरी आवश्यकताओं और कुल लागत के आधार पर Managed Instances, ड्यूरेबल फ़ंक्शन, Step Functions, ECS और Batch की तुलना करनी चाहिए।
उपयोगी सवाल यह नहीं है कि “क्या Lambda इसे 90 मिनट तक चला सकता है?” सवाल यह है कि “जब यह 90-मिनट का जॉब धीमा हो जाए, दोहरा जाए, बाधित हो जाए या निष्क्रिय पड़ जाए, तो क्या होता है?” यही जवाब आर्किटेक्चर तय करना चाहिए।
संदर्भ और आगे पढ़ने के लिए
- Announcing 90-minute function timeout on AWS Lambda Managed Instances — AWS, 9 September 2026. योग्य इनवोकेशन प्रकार और इच्छित उपयोग-मामलों को परिभाषित करता है। समीक्षित: September 2026.
- Configure Lambda function timeout — AWS Lambda डॉक्यूमेंटेशन। टाइमआउट सीमाओं और अपवादों की पुष्टि करता है। समीक्षित: September 2026.
- Lambda Managed Instances — AWS Lambda डॉक्यूमेंटेशन। कंप्यूट, कंकरेंसी, स्केलिंग, आइसोलेशन और प्राइसिंग के अंतर बताता है। समीक्षित: September 2026.
- Best practices for Lambda Managed Instances — AWS Lambda डॉक्यूमेंटेशन। उपलब्धता, कंकरेंसी और लंबे-इनवोकेशन से जुड़े विचारों को कवर करता है। समीक्षित: September 2026.