

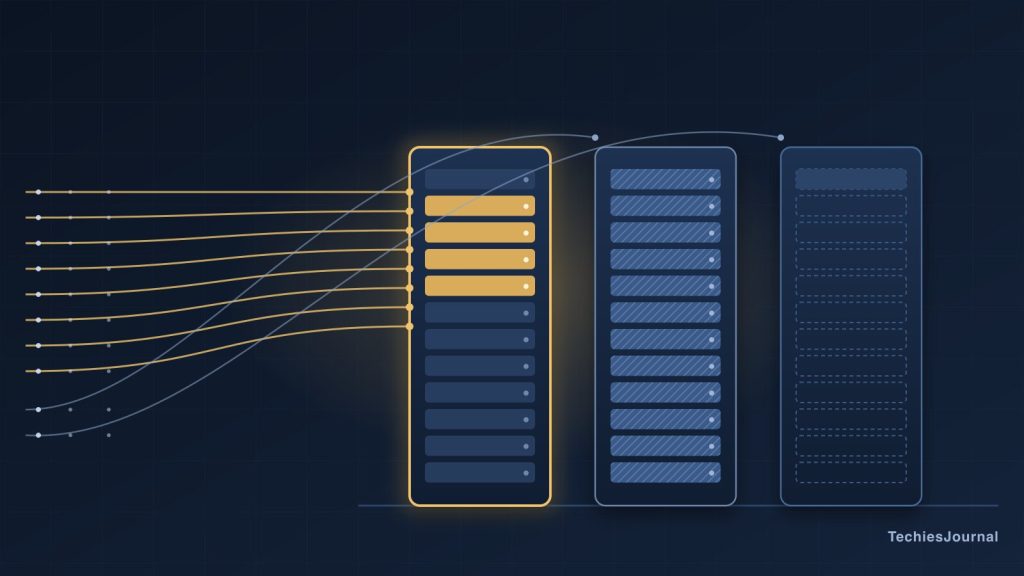
ఏళ్ల తరబడి load balancing ఒక సరళమైన ఆలోచనను అనుసరిస్తూ వచ్చింది.
ఒక request వస్తుంది. సిస్టమ్ అందుబాటులో ఉన్న ఒక server ను వెతికి, request ను అక్కడికి పంపుతుంది.
చాలా applications కు ఇది ఇప్పటికీ సరిపోతుంది.
AI ఇందులో ఒక ఆసక్తికరమైన సంక్లిష్టతను తెస్తుంది.
large language model విషయంలో, అత్యుత్తమ server ఎప్పుడూ తక్కువ పని ఉన్నదే కాకపోవచ్చు.
కొన్నిసార్లు కొత్త request కు కావలసిన సమాచారంలో చాలా భాగాన్ని మరో server ఇప్పటికే ప్రాసెస్ చేసి ఉంటుంది.
అంటే AI infrastructure ఇప్పుడు వేరే ప్రశ్న అడగడం మొదలుపెడుతోంది.
కేవలం ఇది అడగడానికి బదులు:
ఏ server ఖాళీగా ఉంది?
ఇది ఇలా కూడా అడగవచ్చు:
ఈ నిర్దిష్ట request ను నిర్వహించడానికి ఏ server అత్యుత్తమంగా సిద్ధంగా ఉంది?
ఈ చిన్న మార్పు, పెద్ద AI systems traffic ను ఎలా route చేస్తాయో అన్నదాన్ని మార్చడం ప్రారంభించింది.
ఒక సరళమైన ఉదాహరణ
ఒక కంపెనీకి 1,000 మంది ఉద్యోగులు వాడే internal AI assistant ఉందని ఊహించండి.
ఏ ఉద్యోగికి సమాధానం ఇచ్చే ముందు అయినా, AI కి అదే కంపెనీ సమాచారం అందుతుంది:
- భద్రతా నియమాలు
- అంతర్గత సూచనలు
- అందుబాటులో ఉన్న tools
- product documentation.
ఆ తర్వాత ప్రతి ఉద్యోగి వేరే ప్రశ్న అడుగుతారు.
ఒకరు invoice గురించి అడుగుతారు.
మరొకరు contract గురించి అడుగుతారు.
ఇంకొకరు ఒక application సమస్య గురించి అడుగుతారు.
ప్రశ్నలు వేరు, కానీ ప్రతి ప్రశ్నకు ముందు AI కి అందే దానిలో పెద్ద భాగం ఒకటే.
సాధారణ load balancer ఆ requests ను అందుబాటులో ఉన్న servers మధ్య కేవలం పంచిపెట్టవచ్చు.
AI infrastructure మరింత తెలివైన పని చేయగలిగే అవకాశం ఉంది.
ఒక AI server ఆ ఉమ్మడి కంపెనీ సమాచారాన్ని ఇప్పటికే ప్రాసెస్ చేసి ఉంటే, ఇలాంటి మరో request ను అదే చోటికి పంపడం వల్ల ఆ ముందటి పనిలో కొంత భాగాన్ని మళ్లీ ఉపయోగించుకునే వీలు కలగవచ్చు.
మరో server ఆ పనిని మళ్లీ మొదటి నుంచి చేయవలసి రావచ్చు.
కాబట్టి సమానంగా అందుబాటులో ఉన్నట్లు కనిపించే రెండు servers వాస్తవానికి సమానంగా సమర్థవంతంగా ఉండకపోవచ్చు.
AI ప్రాసెసింగ్లో కొంత భాగాన్ని గుర్తుంచుకోగలదు
Large language models, సమాధానంలో మొదటి పదం కనిపించే ముందే గణనీయమైన పని చేస్తాయి.
ఒక prompt ను ప్రాసెస్ చేస్తున్నప్పుడు, model తాత్కాలిక సమాచారాన్ని సృష్టిస్తుంది. దీన్ని memory లో ఉంచుకోవచ్చు.
దీన్ని సాధారణంగా KV cache అంటారు.
ఇది ఎందుకు ముఖ్యమో అర్థం చేసుకోవడానికి దాని వెనుక ఉన్న గణితం తెలుసుకోవాల్సిన అవసరం లేదు.
దీన్ని తాత్కాలిక పని నోట్స్గా భావించండి.
model ఇప్పటికే కంపెనీ సూచనల పెద్ద సమూహాన్ని ప్రాసెస్ చేసి ఉంటే, ఆ పని నోట్స్ను ఉంచుకోవడం వల్ల అదే సమాచారంతో మరో request మొదలైనప్పుడు అదే లెక్కను మళ్లీ చేయడాన్ని కొన్నిసార్లు నివారించవచ్చు.
దీన్ని prefix caching అంటారు.
ఆ cache చేసిన పనికి విలువ వచ్చిన తర్వాత, request ను ఎక్కడికి పంపుతున్నాం అన్నది ముఖ్యం కావడం మొదలవుతుంది.
తక్కువ busy గా ఉన్న server ఎప్పుడూ అత్యుత్తమ server కాకపోవచ్చు
రెండు AI servers ను పరిగణించండి.
Server A దగ్గర ఇంతకు ముందు ఇలాంటి request నుంచి వచ్చిన ఉపయోగకరమైన సమాచారం ఇప్పటికే ఉంది.
Server B దగ్గర లేదు.
రెండూ సమానంగా busy గా ఉంటే, Server A బహుశా మెరుగైన గమ్యం, ఎందుకంటే అది ముందటి పనిలో కొంత భాగాన్ని మళ్లీ ఉపయోగించుకోగలిగే అవకాశం ఉంది.
కానీ ఇప్పుడు Server A దగ్గర పొడవైన requests queue ఉండి, Server B దాదాపు ఖాళీగా ఉందని ఊహించండి.
అయినా సిస్టమ్ request ను Server A కే పంపాలా?
బహుశా కాదు.
ఇప్పుడు routing system రెండు విషయాల మధ్య సమతుల్యం పాటించాలి:
ముందటి పనిని మళ్లీ ఉపయోగించుకోవడం
మరియు
ఓవర్లోడ్ అయిన server ను నివారించడం.
అందుకే AI load balancing మరింత ఆసక్తికరంగా మారుతోంది.
ఇకపై ఇలాంటి ఒకే సరళమైన నియమం ఉండకపోవచ్చు:
request ను ఎప్పుడూ అత్యంత తక్కువ busy గా ఉన్న machine కే పంపండి.
ఈ చిత్రానికి అందుబాటులో ఉండే టెక్స్ట్ ప్రత్యామ్నాయం
పక్కపక్కనే రెండు మార్గాలు. సంప్రదాయ routing: request అందుబాటులో ఉన్న, healthy server కు వెళ్తుంది. Inference-aware routing: request ను నడుస్తున్న model, cache చేసిన పని, ప్రస్తుత load, compute సిద్ధంగా ఉందా లేదా అన్నదానితో పరిశీలించి, ఆ తర్వాత అత్యుత్తమ inference target కు పంపుతుంది.
ఇది ఇప్పటికే జరుగుతోంది
ఇది కేవలం సిద్ధాంతపరమైన ఆలోచన మాత్రమే కాదు.
AWS ఇటీవల SageMaker HyperPod Inference Gateway ను ప్రవేశపెట్టింది.
దీని routing system, AI inference కు ప్రత్యేకమైన సమాచారాన్ని పరిగణనలోకి తీసుకోగలదు. ఒక AI server ఎంత busy గా ఉంది, ఇంతకు ముందే ప్రాసెస్ చేసిన ఉపయోగకరమైన prompt సమాచారం అక్కడ అందుబాటులో ఉందా అన్నవి అందులో ఉన్నాయి.
తన benchmark workloads లో కొన్నింటిలో, users మొదటి generated token ను చూసే ముందు వేచి ఉండే సమయం గణనీయంగా తగ్గిందని AWS తెలిపింది.
అవి AWS సొంత benchmark ఫలితాలు, కాబట్టి ప్రతి application కు హామీ ఇచ్చిన మెరుగుదలలుగా వాటిని పరిగణించకూడదు.
కానీ ముఖ్యమైన పరిణామం ఆ architecture యే.
routing layer కు ఇప్పుడు AI workload గురించి కొంత అర్థం అవుతోంది.
Open-source systems కూడా ఇలాంటివే చేస్తున్నాయి.
విస్తృతంగా వాడే LLM serving platform అయిన vLLM, ఒక inference server లో ఉపయోగకరమైన cache చేసిన prompt సమాచారం ఇప్పటికే ఉందో లేదో పరిగణించే routing కు మద్దతు ఇస్తుంది.
Google కూడా GKE కోసం inference-routing సాంకేతికతను అభివృద్ధి చేస్తోంది. దీని ద్వారా GPU, TPU వనరుల పెద్ద సమూహాల్లో AI requests ను మరింత సమర్థవంతంగా పంపిణీ చేయవచ్చు.
వేర్వేరు products ఈ సమస్యను వేర్వేరు విధాలుగా సమీపిస్తున్నాయి.
ఉమ్మడి ఆలోచన మరింత ముఖ్యమైనది:
AI requests ఇప్పుడు infrastructure కేవలం ముందుకు పంపేవి కాకుండా, అర్థం చేసుకోగలిగేవిగా మారుతున్నాయి.
cache చేసిన సమాచారం కంటే పరిగణించాల్సినవి ఇంకా ఉన్నాయి
రెండు AI servers సమానంగా ఉండకపోవడానికి caching ఒక్కటే కారణం కాదు.
ఒక server లో కావలసిన model ఇప్పటికే నడుస్తూ ఉండవచ్చు.
మరొక దానిలో ఎక్కువ GPU సామర్థ్యం అందుబాటులో ఉండవచ్చు.
ఒకదానిలో అనేక requests వేచి ఉండవచ్చు.
మరొకటి దాదాపు ఖాళీగా ఉండవచ్చు.
పెద్ద environments లో models యొక్క వేర్వేరు versions లేదా ప్రత్యేక రూపాంతరాలు కూడా నడుస్తూ ఉండవచ్చు.
కాబట్టి AI routing నిర్ణయం క్రమంగా ఇలా మారవచ్చు:
ఈ నిర్దిష్ట request ను ఏ machine అత్యంత సమర్థవంతంగా నిర్వహించగలదు?
ఈ ప్రశ్నకు బదులుగా:
తదుపరి request ను ఏ machine అందుకోవాలి?
ఇది సంప్రదాయ traffic పంపిణీలా కాకుండా, workload scheduling లా కనిపించడం మొదలవుతుంది.
ప్రతి AI application కు ఇది అవసరమా?
కాదు.
చిన్న AI application నడిపే ఒక చిన్న కంపెనీకి అధునాతన inference routing ఆటోమేటిక్గా అవసరం ఉండదు.
ఒక application ఒకే model ను వాడుతూ, తక్కువ traffic ఉండి, చిన్న infrastructure పై నడుస్తుంటే, సాధారణ load-balancing ఏర్పాటు పూర్తిగా సరిపోవచ్చు.
సంస్థలు ఇవి నడిపేటప్పుడు ఇది మరింత ముఖ్యం అవుతుంది:
- పెద్ద models
- అనేక GPUs
- అధిక request పరిమాణాలు
- పొడవైన prompts
- పునరావృతమయ్యే సూచనలు లేదా ఉమ్మడి documents
- అనేక models
- కఠినమైన response-time అవసరాలు.
ఆ స్థాయిలో, అనవసరమైన AI computation ను మళ్లీ మళ్లీ చేయడం ఖరీదైనదిగా మారవచ్చు.
మెరుగైన routing, సంస్థ తన ప్రస్తుత AI infrastructure ను మరింత సమర్థవంతంగా వాడుకోవడానికి సహాయపడవచ్చు.
కానీ సంక్లిష్టత సమస్యను అనుసరించి ఉండాలి.
అవసరం లేని workload కోసం అధునాతన AI routing నిర్మించడంలో విలువ తక్కువ.
infrastructure teams ఎందుకు పట్టించుకోవాలి
ఇటీవలి వరకు model caching, inference optimization వంటి అంశాలు ప్రధానంగా machine-learning engineering teams కు చెందినవి.
ఆ సరిహద్దు ఇప్పుడు మారడం మొదలైంది.
Platform engineers, SREs, cloud architects కు ఇలాంటి ప్రశ్నలు ఎదురయ్యే అవకాశం పెరుగుతూ ఉండవచ్చు:
model ఎక్కడ నడుస్తోంది?
GPUs ఎంత busy గా ఉన్నాయి?
ఈ request లో కొంత భాగం ఎక్కడైనా ఇప్పటికే ప్రాసెస్ అయిందా?
ఈ request ముందటి computation ను మళ్లీ ఉపయోగించుకోగలదా?
ఏ గమ్యం వేగంగా స్పందించే అవకాశం ఉంది?
ఇవి infrastructure ప్రశ్నలు.
AI platforms ను నడిపేవారు transformers ఎలా పనిచేస్తాయో తెలిసిన నిపుణులు కావాల్సిన అవసరం లేదు.
కానీ మంచి infrastructure నిర్ణయాలు తీసుకోవడానికి inference ప్రవర్తన గురించి తగినంత అర్థం చేసుకోవాల్సి రావచ్చు.
ఇది సంప్రదాయ load balancing ను భర్తీ చేయదు
సంప్రదాయ load balancers అదృశ్యం కావడం లేదు.
AI applications ఇప్పటికీ gateways, proxies, load balancers వంటి పరిచితమైన networking భాగాలను వాడతాయి.
తేడా model కు దగ్గరగా కనిపిస్తుంది.
సాధారణ load balancer, request ను AI platform లోకి చేర్చవచ్చు.
ఆ platform లోపల, మరో routing layer, ఏ model server లేదా GPU అసలు ఆ పని చేయాలో నిర్ణయించగలదు.
దీన్ని రెండు నిర్ణయాలుగా భావించండి:
మొదట: application request ఎక్కడికి వెళ్లాలి?
ఆ తర్వాత:
AI computation ఎక్కడ జరగాలి?
సరళమైన systems లో ఆ రెండు నిర్ణయాలు ఆచరణలో ఒకటే కావచ్చు.
పెద్ద AI platforms లో అవి ఒకటి కాకపోయే అవకాశం పెరుగుతోంది.
దృక్కోణం
ఆసక్తికరమైన మార్పు ఏమిటంటే, AI కి ఒక ప్రత్యేకమైన కొత్త రకం load balancer అవసరం అని కాదు.
AI వల్ల routing నిర్ణయంలో workload యే మరింత ముఖ్యమవుతోంది.
సంప్రదాయ applications లో, రెండు healthy servers ను తరచుగా సమానమైనవిగా పరిగణించవచ్చు.
AI inference లో, ఒక server memory లో ఉపయోగకరమైన పనిని ఇప్పటికే కలిగి ఉండవచ్చు, మరొకటి సరైన model ను సిద్ధంగా ఉంచుకుని ఉండవచ్చు, ఇంకొకదానిలో కేవలం ఎక్కువ GPU సామర్థ్యం అందుబాటులో ఉండవచ్చు.
కాబట్టి infrastructure ఇప్పుడు ఈ విధానం నుంచి:
అందుబాటులో ఉన్న server ను కనుక్కోండి.
ఈ విధానం వైపు మారడం మొదలుపెట్టింది:
ఈ నిర్దిష్ట AI పనిని చేయడానికి అత్యుత్తమ చోటును కనుక్కోండి.
చిన్న AI applications కు ఈ తేడా ముఖ్యం కాకపోవచ్చు.
పెద్ద inference environments కు మాత్రం ఇది ఎక్కువగా ముఖ్యం అవుతోంది.
AI inference, load balancing ను ఎందుకు మారుస్తోందో అర్థం చేసుకోవడానికి ఇదే సులభమైన మార్గం కావచ్చు: సిస్టమ్ ఇకపై కేవలం traffic ను route చేయడం లేదు. అది computation ను route చేయడం మొదలుపెడుతోంది.
మరింత చదవండి: Cloud Capacity Is Not Cloud Availability లో, server అందుబాటులో ఉండటం అంటే పనికి సిద్ధంగా ఉండటం కాదు అనే మరో సందర్భాన్ని చూడవచ్చు, AI Cost per Task లో AI పనికి వాస్తవంగా ఎంత ఖర్చవుతుందో చూడవచ్చు.
మూలాలు మరియు మరింత చదవడానికి
మూలాల సమీక్ష: 5 అక్టోబర్ 2026.
- AWS — Amazon SageMaker HyperPod Inference Gateway for scalable LLM inference. gateway గురించి AWS ప్రకటన, దాని routing signals, మొదటి token latency పై AWS తెలిపిన ఫలితాలు.
- AWS Documentation — SageMaker HyperPod managed tiered KV cache and routing. prefix-aware routing, సంబంధిత cache చేసిన పని ఇప్పటికే ఉన్న replicas కు requests ను ఎలా పంపుతుందో వివరిస్తుంది.
- AWS Machine Learning Blog — Introducing Amazon SageMaker HyperPod Inference Gateway. AWS సొంత benchmark workloads, పరిస్థితులు. ఫలితాలు vendor స్వయంగా తెలిపినవి. ఒకేలా ఉన్న fleets లో స్థిరమైన traffic ఉన్నప్పుడు పోల్చదగిన పనితీరు ఉంటుందని AWS పేర్కొంది.
- Google Cloud — About GKE Inference Gateway. GPU, TPU accelerators అంతటా GKE పై generative AI కోసం prefix-cache aware, load-aware routing.
- vLLM Documentation — Prefix-aware routing. ఒకే prompt prefix పంచుకునే requests ను అదే instance కు పంపి, cache చేసిన పనిని మళ్లీ వాడుకోవడం.
- vLLM Documentation — Load-aware routing. cache చేసిన పని వల్ల కలిగే ప్రయోజనాన్ని, ప్రతి instance పై ఎంత load ఉందో దానితో తూకం వేయడం.
- vLLM Documentation — Automatic prefix caching. ఉమ్మడి prompt prefix కోసం cache చేసిన పనిని ఎలా మళ్లీ వాడతారు, అది ఎక్కడ ఎక్కువగా ఉపయోగపడుతుంది.