

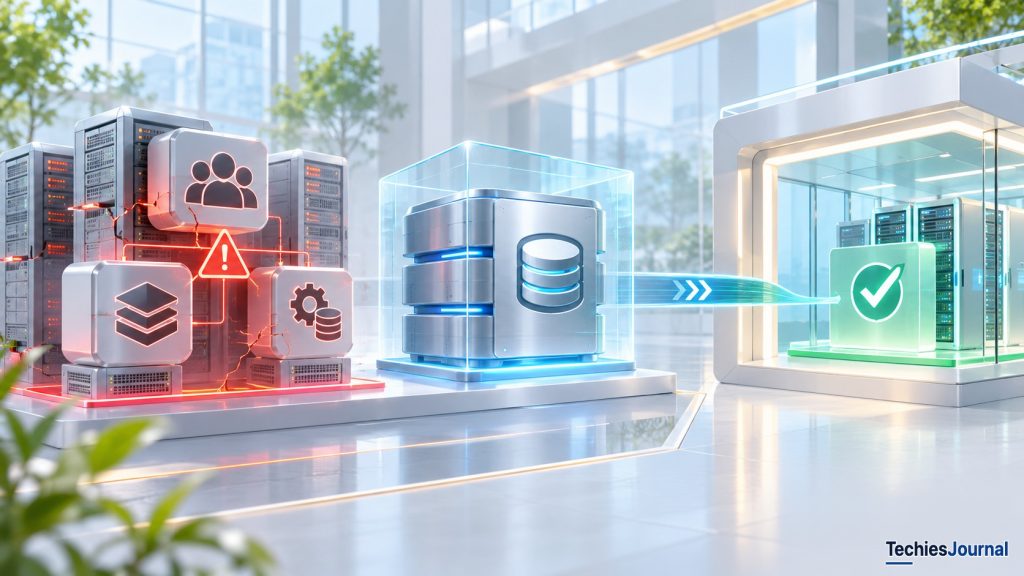
Des attaquants peuvent désactiver les systèmes nécessaires pour restaurer les données, même lorsque les copies de sauvegarde survivent. Comprendre ces dépendances devient un volet important de la préparation aux rançongiciels.
Northbridge Services a un problème de sauvegarde que son tableau de bord de supervision n’arrive pas à expliquer.
L’équipe informatique de l’entreprise réalise des sauvegardes quotidiennes de ses applications critiques. Les tâches de sauvegarde se sont terminées avec succès, et les derniers rapports indiquent que des points de restauration sont disponibles.
Puis un incident de rançongiciel perturbe plusieurs serveurs de production.
L’équipe d’infrastructure engage le processus de reprise, en comptant restaurer les machines virtuelles touchées. Mais les administrateurs découvrent que la plateforme d’administration des sauvegardes a peut-être été compromise. L’environnement de virtualisation fait lui aussi l’objet d’une enquête, et les comptes privilégiés normalement utilisés pour la restauration ne sont pas encore dignes de confiance.
Les données de sauvegarde existent peut-être encore. Le problème est d’y accéder, de les restaurer et de remettre les applications en service sans offrir à l’attaquant une nouvelle occasion d’interférer.
Northbridge est une organisation fictive, mais le problème reflète des schémas d’attaque documentés par l’équipe de sécurité Mandiant de Google.
Dans son rapport M-Trends 2026, Mandiant décrit des opérateurs de rançongiciel qui visent les services d’identité, l’infrastructure de virtualisation et les systèmes de sauvegarde pour affaiblir la capacité d’une organisation à se rétablir.
Ces attaques font apparaître une distinction importante. Protéger les copies de sauvegarde et maintenir un processus de reprise utilisable sont deux responsabilités liées, mais ce n’est pas la même chose.
Comment une compromission d’identité peut atteindre les systèmes de reprise
Pour comprendre le problème de Northbridge, voyons comment son infrastructure fonctionne en temps normal.
Les employés et les administrateurs s’authentifient auprès d’un service d’identité central. La plateforme de virtualisation fait tourner les serveurs d’applications de l’entreprise. Une application de sauvegarde se connecte à cette plateforme, gère les tâches de sauvegarde et tient un catalogue des points de restauration disponibles.
Cette organisation est pratique. Les administrateurs peuvent gérer l’infrastructure avec des comptes établis, et le système de sauvegarde peut communiquer avec les plateformes qu’il protège.
Elle crée aussi entre les systèmes des relations qui ne sont pas forcément évidentes lors des vérifications de routine des sauvegardes.
Supposons qu’un attaquant prenne le contrôle d’un compte privilégié ayant accès à l’environnement d’administration de l’infrastructure. Selon ses permissions, ce compte pourrait offrir une voie d’accès à l’application de sauvegarde, à la plateforme de virtualisation ou aux services qui les soutiennent.
L’attaquant n’a pas nécessairement besoin de compromettre chaque serveur d’applications individuellement.
Mandiant indique avoir observé des acteurs malveillants manipuler des environnements d’identité, exploiter des erreurs de configuration dans des services d’identité et viser des systèmes d’administration de la virtualisation. Ses constats de 2026 décrivent aussi des attaquants qui suppriment des objets de sauvegarde dans le stockage cloud.
Ces constats n’établissent pas que tout compte privilégié offre ces capacités. Le résultat dépend de la configuration de l’identité, des permissions et des réseaux d’administration.
Pour Northbridge, cependant, cette possibilité change l’enquête. L’équipe ne peut plus supposer que les comptes et les outils normalement utilisés pour la restauration sont sûrs, simplement parce qu’ils fonctionnaient avant l’incident.
Le processus de reprise est lui-même devenu une partie de l’enquête de sécurité.
Les sauvegardes ont survécu, mais pas le chemin de reprise
Les enquêteurs de Northbridge établissent que certaines copies de sauvegarde protégées restent disponibles. C’est encourageant, mais l’entreprise ne peut toujours pas lancer une restauration normale.
Une plateforme de sauvegarde a besoin de plus que des données stockées pour restaurer une application.
Il lui faut peut-être un service d’administration fonctionnel pour localiser le bon point de restauration, des identifiants pour accéder au stockage, des clés de chiffrement pour lire les données protégées et une infrastructure de calcul sur laquelle restaurer la charge de travail.
Northbridge a aussi besoin que ses applications reviennent dans le bon ordre. Son application métier dépend d’une base de données, et toutes deux dépendent de services de réseau, de stockage et d’administration qui fonctionnent.
L’entreprise fait donc face à une chaîne de dépendances, et non à un seul fichier manquant.
C’est là que les attaques contre l’infrastructure de virtualisation deviennent particulièrement lourdes de conséquences.
Un hyperviseur permet à plusieurs machines virtuelles de se partager des ressources de calcul physiques. Ses systèmes d’administration peuvent contrôler les machines virtuelles, leur configuration et, selon la plateforme, certains aspects de leur stockage sous-jacent.
Un attaquant disposant d’un accès suffisamment privilégié à cette couche pourrait être en mesure de perturber plusieurs systèmes sans avoir d’abord compromis chaque système d’exploitation invité.
Dans son analyse de 2026, Mandiant décrit des attaques contre des datastores d’hyperviseurs et contre l’infrastructure d’administration. Ces techniques peuvent toucher plusieurs charges de travail et compliquer la restauration.
Pour Northbridge, restaurer une application dans un environnement qui pourrait encore être contrôlé par un attaquant ajouterait un autre risque. La charge de travail restaurée pourrait être modifiée, perturbée ou compromise à nouveau.
Les sauvegardes protégées aident à réduire ce risque, mais elles ne résolvent qu’une partie du problème.
Une sauvegarde immuable est conçue pour résister à la modification ou à la suppression pendant sa période de conservation configurée. Les copies hors ligne offrent une autre protection, car elles sont déconnectées des systèmes qu’un attaquant peut atteindre.
Aucune de ces deux mesures ne fournit automatiquement les identifiants, les clés de chiffrement, l’environnement de calcul de confiance ou la configuration applicative nécessaires à la restauration.
Par exemple, une sauvegarde immuable de base de données peut rester intacte alors que la clé de chiffrement nécessaire pour la lire est inaccessible. Une sauvegarde complète de machine virtuelle peut aussi rester inutilisable tant que les administrateurs n’ont pas établi un lieu de confiance où la restaurer.
La leçon technique n’est pas que les sauvegardes immuables sont inefficaces. Ce sont des garde-fous précieux contre une catégorie importante d’attaques.
La limite est que protéger les copies stockées ne protège pas automatiquement tous les systèmes nécessaires pour les utiliser.
Reconstruire à partir d’un environnement de confiance
Northbridge doit maintenant prendre une décision difficile.
Elle pourrait tenter de restaurer ses applications avec l’infrastructure d’administration existante, mais les enquêteurs n’ont pas établi si cet environnement est digne de confiance.
L’approche la plus sûre dans cet incident fictif consiste à établir un chemin de reprise sain avant de reconnecter les charges de travail restaurées à la production.
L’équipe commence par repérer les copies de sauvegarde qui seraient antérieures à la compromission, et par confirmer que ces copies sont accessibles avec des identifiants protégés.
Elle vérifie aussi la disponibilité des clés de chiffrement, des configurations système et de la documentation de reprise nécessaires.
Ensuite, l’équipe d’infrastructure prépare un environnement de confiance pour la restauration. Selon l’architecture de Northbridge, cela peut passer par des ressources de virtualisation distinctes, une infrastructure cloud isolée ou un environnement de reprise dont l’accès d’administration est restreint.
L’isolation a pour but d’empêcher l’environnement de production compromis de contrôler le processus de reprise.
Alternative textuelle accessible de cette figure
La figure montre comment une reprise peut se dérouler lorsque les systèmes d’administration de production ne sont pas dignes de confiance. Elle comporte trois zones, de haut en bas, et cinq étapes numérotées qui suivent l’article.
Production, confiance non établie : un service d’identité, l’administration de la virtualisation et l’administration des sauvegardes. Des lignes ambrées en pointillés marquent des accès qu’un attaquant disposant d’un compte privilégié pourrait être en mesure d’utiliser. La voie normale de restauration, de l’administration des sauvegardes vers les copies protégées, est signalée comme n’étant pas encore digne de confiance.
Copies de sauvegarde protégées : copies stockées qui résistent aux modifications pendant la conservation, mais qui ne suffisent pas seules. Étape 1 : choisir une copie antérieure à la compromission. Étape 2 : confirmer les clés et les identifiants protégés. La reprise exige aussi des clés, des identifiants et un lieu de confiance où restaurer.
Un seul chemin contrôlé mène des copies protégées à l’environnement de reprise isolé. Aucun accès d’administration ne mène de la production vers cet environnement.
Environnement de reprise isolé, avec un accès d’administration séparé et restreint. Étape 3 : préparer l’environnement de confiance. Étape 4 : restaurer les services de support, puis la base de données, puis l’application. Étape 5 : vérifier la persistance avant de reconnecter au réseau de production.
Le scénario est fictif. La figure est une illustration, et non une architecture d’éditeur ni un déploiement réel.
Une fois l’accès d’administration de confiance établi, l’équipe restaure les services de support nécessaires avant de remettre en service l’application métier. Les dépendances de la base de données et de l’application sont vérifiées, et les systèmes restaurés sont examinés à la recherche de signes de persistance ou de réinfection.
Ce n’est qu’après ces vérifications que Northbridge envisage de reconnecter les services au réseau de production normal.
Il s’agit d’un scénario simplifié. Un incident réel exigerait des décisions fondées sur les conclusions de l’analyse forensique, les exigences des applications, l’infrastructure disponible et les procédures de réponse aux incidents approuvées par l’organisation.
Il montre aussi pourquoi l’architecture de reprise implique des compromis.
Un environnement d’infrastructure entièrement séparé peut offrir une isolation plus forte, mais il peut coûter cher à entretenir. Exploiter un second environnement complet d’identité et de virtualisation crée aussi ses propres responsabilités opérationnelles.
Toutes les entreprises n’ont pas besoin d’un tel dispositif.
Une petite organisation qui s’appuie sur des services gérés peut parvenir à une séparation appropriée grâce à des capacités de reprise prises en charge par le fournisseur, à un accès d’administration protégé et à des sauvegardes accessibles de façon indépendante.
Une grande organisation dont les applications sont critiques, la virtualisation étendue ou les dépendances de restauration longues peut avoir besoin d’une infrastructure plus dédiée.
La bonne conception dépend de ce qui doit rester opérationnel ou récupérable après une défaillance donnée. L’objectif est de supprimer les dépendances partagées dangereuses sans créer de complexité inutile.
Qu’est-ce qui prouverait que la reprise fonctionne vraiment ?
Northbridge finit par restaurer son application métier fictive. L’équipe vérifie que les utilisateurs peuvent s’authentifier, que l’application peut joindre sa base de données et que les fonctions métier attendues fonctionnent correctement.
Ce résultat est plus significatif que les tâches de sauvegarde réussies observées avant l’incident.
Mais une entreprise ne devrait pas avoir à subir un rançongiciel pour savoir si son plan de reprise fonctionne.
De nombreux tests de sauvegarde restaurent un fichier, une base de données ou une machine virtuelle isolée, pendant que le reste de l’infrastructure demeure en bon état. Ces tests sont utiles, car ils vérifient des éléments importants du processus de sauvegarde.
Ils ne démontrent pas nécessairement que la reprise est possible lorsque le service d’identité, la plateforme d’administration des sauvegardes ou l’environnement de virtualisation sont indisponibles.
Un exercice plus exigeant simulerait ces conditions.
Northbridge pourrait commencer par supposer que ses comptes privilégiés habituels ne peuvent pas être utilisés. L’équipe tenterait ensuite de récupérer un point de restauration protégé, d’accéder aux clés nécessaires, de préparer un environnement de restauration de confiance et de restaurer une application complète avec ses dépendances.
L’exercice devrait aussi établir combien de temps dure la restauration, quelles étapes exigent une intervention manuelle et si le service restauré répond aux exigences de reprise de l’entreprise.
Cette approche est cohérente avec le Guide for Cybersecurity Event Recovery du NIST, qui met l’accent sur des exercices de reprise réalistes, des responsabilités claires et l’apprentissage tiré des résultats des tests.
Le StopRansomware Guide de la CISA recommande de même une protection hors ligne des sauvegardes critiques et des tests réguliers de leur disponibilité et de leur intégrité.
Pour Northbridge, l’exercice révèle si le plan de reprise dépend de systèmes qui pourraient être indisponibles pendant l’incident qu’il est censé couvrir.
Pour une autre organisation, les dépendances critiques peuvent être différentes. La question de fond reste pratique : quel service métier faut-il restaurer, que demande cette restauration, et ces exigences peuvent-elles encore être satisfaites après la compromission supposée ?
Une organisation peut commencer à répondre à cette question sans lancer un tout nouveau programme d’infrastructure. Elle peut choisir une application importante, cartographier ses dépendances de reprise et tester la restauration dans une situation de défaillance réaliste.
Les résultats montreront si les protections existantes suffisent ou à quel endroit une amélioration ciblée est nécessaire.
La préparation moderne aux rançongiciels exige toujours des sauvegardes fiables. Les constats de Mandiant ne changent pas ce fondement.
Ils montrent pourquoi les systèmes de reprise qui les entourent méritent une attention égale.
Un plan de reprise devient crédible lorsqu’une organisation peut démontrer qu’elle est capable de restaurer les services métier dont elle dépend, même lorsque certaines parties de son environnement d’exploitation normal ne sont plus dignes de confiance.
Références et lectures complémentaires
- M-Trends 2026 Executive Edition, Google Cloud / Mandiant. Constats issus des enquêtes sur des incidents de 2025, dont les tactiques de déni de reprise visant l’identité, les sauvegardes et l’infrastructure de virtualisation.
- M-Trends 2026: Data, Insights, and Strategies From the Frontlines, Google Cloud. Précisions supplémentaires sur les attaquants qui visent l’infrastructure critique d’administration et de reprise.
- StopRansomware Guide, CISA et agences partenaires, octobre 2023. Recommandations pour protéger les données de sauvegarde et tester la reprise.
- Guide for Cybersecurity Event Recovery, SP 800-184, NIST, décembre 2016. Recommandations sur la planification de la reprise, la cartographie des dépendances et les exercices réalistes.
Date de vérification des sources : 16 novembre 2026.