

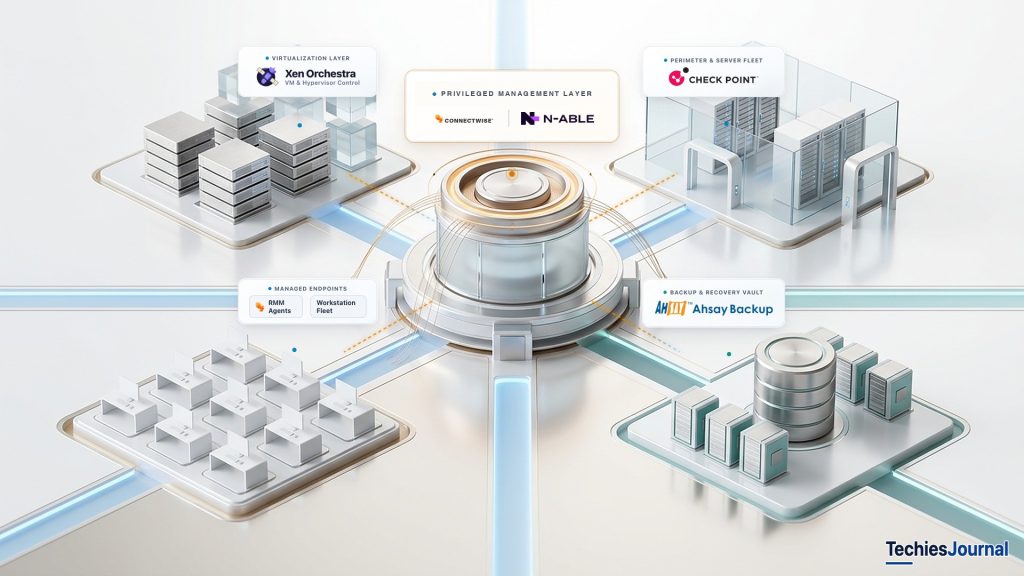
Remote-management, virtualization और backup सिस्टम पर हाल के हमले एक ऐसी सुरक्षा समस्या दिखाते हैं जो अलग-अलग vulnerabilities से आगे जाती है: इन प्लेटफ़ॉर्म के पास दूसरे सिस्टम पर जो अधिकार है।
एक प्रशासनिक टूल। सैकड़ों सिस्टम।
कल्पना कीजिए कि एक IT टीम 200 सर्वर और कर्मचारियों के डिवाइस मैनेज करती है।
हर मशीन से अलग-अलग जुड़ने के बजाय एडमिनिस्ट्रेटर एक केंद्रीय प्लेटफ़ॉर्म का उपयोग करते हैं, जिससे वे अपडेट इंस्टॉल करते हैं, रखरखाव के काम चलाते हैं, सिस्टम की सेहत पर नज़र रखते हैं और समस्याएँ सुलझाते हैं। इससे समय बचता है और सिस्टम एक जैसे कॉन्फ़िगर रखने में मदद मिलती है।
लेकिन अगर कोई हमलावर उस प्लेटफ़ॉर्म पर नियंत्रण पा ले, तो क्या होगा?
अपनी permissions के आधार पर हमलावर हर सिस्टम को अलग-अलग compromise किए बिना कई सिस्टम पर सॉफ़्टवेयर deploy कर सकता है, कमांड चला सकता है या कॉन्फ़िगरेशन बदल सकता है।
इसीलिए management प्लेटफ़ॉर्म पर सुरक्षा का विशेष ध्यान देना ज़रूरी है। उनका काम ही दूसरे सिस्टम को नियंत्रित करना है, और वही अधिकार गलत हाथों में पड़ने पर ख़तरनाक बन सकता है।
अक्टूबर और नवंबर 2026 की सुरक्षा जाँचें दिखाती हैं कि हमलावरों ने इस प्रशासनिक भरोसे के अलग-अलग हिस्सों का कैसे फ़ायदा उठाया।
Management प्लेटफ़ॉर्म को अपनी ताकत कहाँ से मिलती है?
आधुनिक इंफ्रास्ट्रक्चर कई तरह के management सॉफ़्टवेयर पर निर्भर करता है।
Remote monitoring and management (RMM) प्लेटफ़ॉर्म तकनीशियनों को endpoints और सर्वर administer करने देते हैं। Virtualization managers hosts और virtual machines को नियंत्रित करते हैं। Backup consoles डेटा सुरक्षा और recovery का समन्वय करते हैं। Cloud administration और सुरक्षा सिस्टम संसाधनों, identities और नेटवर्क एक्सेस को मैनेज करते हैं।
इन टूल्स को अपना काम करने के लिए विशेषाधिकार वाली क्षमताएँ चाहिए।
एक RMM प्लेटफ़ॉर्म इंस्टॉल किए गए agents से संवाद कर सकता है, जो ऊँचे ऑपरेटिंग-सिस्टम permissions के साथ कमांड चलाते हैं। एक virtualization manager किसी host को virtual machines बनाने, रोकने या बदलने का निर्देश दे सकता है। एक backup सिस्टम के पास ऐसे credentials हो सकते हैं जिनसे वह सुरक्षित workloads और storage तक पहुँच सके।
यहाँ अहम फ़र्क़ किसी सिस्टम तक पहुँच और दूसरे सिस्टम को administer करने का अधिकार के बीच है।
एक सामान्य एप्लिकेशन अपना ही डेटा पढ़ या बदल सकता है। एक management प्लेटफ़ॉर्म संभावित रूप से उस पूरे माहौल को बदल सकता है जिसमें कई एप्लिकेशन चलते हैं।
इस अधिकार का दायरा उसके कॉन्फ़िगरेशन, credentials, permissions और जुड़े हुए सिस्टम पर निर्भर करता है। यह ज़रूरी नहीं कि असीमित हो।
हाल की जाँचों के तीन तंत्र दिखाते हैं कि ये सीमाएँ क्यों मायने रखती हैं।
तालिका इन घटनाओं को साथ-साथ रखती है और अलग करती है कि हर स्रोत क्या पुष्ट करता है और क्या केवल रिपोर्ट करता है।
| घटना | हमलावरों ने क्या किया या क्या कर सकते थे | स्रोत द्वारा पुष्ट | रिपोर्ट किया गया, स्थापित नहीं | समाधान या प्रतिक्रिया |
|---|---|---|---|---|
| ScreenConnect और RMM+ (Huntress, 11 और 13 नवंबर) | Management panels से कमांड चलाकर managed devices पर remote-access सॉफ़्टवेयर इंस्टॉल किया | लगभग 90 मिनट में 48 संगठनों के कम से कम 288 endpoints, फिर 41 संगठनों के 205 hosts | गतिविधि RMM+ के versions 1.0.31 और 1.0.32 से जुड़ी लगी, जो खाली access key स्वीकार करते थे। ConnectWise को कोई शुरुआती पहुँच का रास्ता नहीं मिला था। Technician sessions के ज़रिए फैलाव सफल होते नहीं देखा गया | ConnectWise ने अपने hosted environments पर RMM+ और संबंधित extensions बंद कर दिए |
| Xen Orchestra (Vates advisory VSA-2026-062, 10 नवंबर) | खाली-object token से authentication को बायपास किया और administrator एक्सेस पाया | एक threat actor इसका सक्रिय रूप से exploit कर रहा था। बिना authentication की सफल पहुँच एप्लिकेशन log में कुछ नहीं छोड़ती | Managed pools पर कोड execution और XCP-ng hosts पर root का पूरा नियंत्रण एक संभावित नतीजा है, वर्णित नतीजा नहीं | Versions 6.9.2 और 6.10.1 में ठीक किया गया |
| Check Point gateway से ESXi तक (Check Point Research, एक intrusion) | Gateway की खामियों का exploit किया, root तक privileges बढ़ाए, persistence बनाई, फिर SSH से एक ESXi host पर गए और wiper चलाया | उस एक जाँचे गए intrusion में ESXi तक जाना और wiper | हमलावरों को ESXi service account के credentials कैसे मिले। ऑपरेशन की असली प्रकृति का उच्च भरोसे के साथ आकलन नहीं किया गया है | पहली गतिविधि से लगभग एक हफ़्ते पहले सुरक्षा fix उपलब्ध था (advisory SK1000362) |
| AhsayCBS backup servers (Huntress, 8 से 11 अक्टूबर) | उजागर servers पर authentication bypass और remote code execution की खामी को जोड़ा, फिर webshells, cryptocurrency miner और remote-access tools लगाए | एक ही environment के तीन servers से बरामद tooling, जिसमें PNG image डेटा में encrypted payloads छिपाने वाला एक webshell शामिल है | एक संबंधित Veeam server पर credential-चोरी वाले module से मेल खाती एक कमांड। कितने credentials निकाले गए, यह अज्ञात है | Version 10 के लिए Hotfix 10.3.4.45 और versions 7 से 9 के लिए 9.15.2.70। Patching उसे नहीं हटाती जो पहले ही लगाया जा चुका है |
| N-able N-central (N-able, 10 से 13 नवंबर) | Authentication, permissions, पुराने API एक्सेस और agent impersonation में कमज़ोरियाँ रिपोर्ट हुईं | 10 नवंबर को Hotfix 2 ने सात documented CVEs को संबोधित किया। N-able केंद्रीय एप्लिकेशन को अपने agents, probes और appliances से अलग मानता है | Authenticated डेटा leakage के मुद्दे खुले हैं और उन्हें कम जोखिम वाला बताया गया है | Hotfix 2 जारी, Hotfix 3 की योजना |
16 नवंबर 2026 तक की स्थिति, लेख के अंत में ‘और गहराई में’ खंड की रिपोर्टों के आधार पर। पंक्तियाँ अलग-अलग तरह के प्रमाण दर्ज करती हैं, इसलिए वे गंभीरता की रैंकिंग नहीं हैं।
1. जब वैध प्रशासन ही हमले का तंत्र बन जाता है
11 नवंबर 2026 को Huntress ने देखा कि हमलावर ScreenConnect के management panels से कमांड चलाकर managed devices पर अनधिकृत remote-access सॉफ़्टवेयर पहुँचा रहे थे।
पहली लहर ने लगभग 90 मिनट में 48 संगठनों के कम से कम 288 endpoints को प्रभावित किया। Huntress ने 13 नवंबर को 41 संगठनों के 205 hosts से जुड़ी अतिरिक्त गतिविधि की रिपोर्ट दी।
ScreenConnect की remote-command क्षमता एक वैध प्रशासनिक सुविधा है। इस घटना में हमलावरों ने management panels तक अपनी पहुँच का उपयोग करके उसी सुविधा के ज़रिए दुर्भावनापूर्ण कमांड चलाए।
Huntress ने कहा कि गतिविधि RMM+ नाम के एक third-party extension की authentication कमज़ोरी से जुड़ी लगती है, जिसके versions 1.0.31 और 1.0.32 खाली access key स्वीकार करते थे। ConnectWise ने कहा कि उसे कोई शुरुआती पहुँच का रास्ता नहीं मिला था, और उसने अपने hosted environments पर RMM+ और संबंधित extensions बंद कर दिए। Huntress ने जिस कमज़ोरी का वर्णन किया, वह extension में है, ScreenConnect के मूल उत्पाद में किसी सिद्ध खामी में नहीं। हालाँकि SCKit malware में technicians के remote sessions के ज़रिए फैलने के लिए बनी कार्यक्षमता थी, शोधकर्ताओं ने उस अतिरिक्त तरीके को सफल होते नहीं देखा।
Huntress की SCKit जाँच देखी गई कमांड गतिविधि, malware विश्लेषण और प्रमाण की सीमाएँ बताती है।
यह संचालन संबंधी समस्या केवल ScreenConnect तक सीमित नहीं है।
कई सिस्टम पर कमांड चला सकने वाले किसी भी management टूल को अधिकृत प्रशासन और उस अधिकार के दुरुपयोग के बीच फ़र्क़ करने का तरीका चाहिए।
20 मशीनों पर स्वीकृत सॉफ़्टवेयर इंस्टॉल करता तकनीशियन और चुराए गए management session से अनधिकृत सॉफ़्टवेयर deploy करता हमलावर, दोनों एक ही बुनियादी कार्यक्षमता का उपयोग कर सकते हैं।
इससे पहचान की चुनौती पैदा होती है। सुरक्षा टीमों को केवल यह नहीं देखना होता कि कमांड किस सॉफ़्टवेयर ने चलाया, बल्कि यह भी कि उसे किसने शुरू किया, किन devices को निशाना बनाया गया, क्या यह कार्रवाई अपेक्षित थी और क्या उसका दायरा असामान्य था।
2. जब एक component का compromise ज़्यादा विशेषाधिकार वाले सिस्टम तक रास्ता खोल देता है
दूसरा तंत्र उस management इंफ्रास्ट्रक्चर से जुड़ा है जो सामान्य workloads के ऊपर बैठता है।
नवंबर 2026 में Vates ने Xen Orchestra में एक authentication bypass का खुलासा किया। Xen Orchestra XCP-ng virtualization इंफ्रास्ट्रक्चर मैनेज करने वाला प्लेटफ़ॉर्म है।
खामी इस बात से जुड़ी थी कि खाली-object authentication token की व्याख्या कैसे होती थी। प्रभावित स्थितियों में हमलावर authentication को बायपास करके प्रशासनिक एक्सेस पा सकता था। Vates ने चेतावनी दी कि Xen Orchestra के compromise से managed pools पर कोड execution हो सकता है और संभावित रूप से XCP-ng hosts पर root के रूप में पूरा नियंत्रण भी मिल सकता है।
एक virtual machine की ऑपरेटिंग-सिस्टम सुरक्षा मज़बूत हो सकती है, लेकिन उसका virtualization host उसके नीचे काम करता है। उस स्तर का प्रशासनिक नियंत्रण उन सुरक्षा उपायों को कमज़ोर कर सकता है जो केवल guest ऑपरेटिंग सिस्टम के भीतर लगाए गए हैं।
Vates ने पहचान की एक अहम सीमा भी दर्ज की: बिना authentication के सफल exploitation से कोई संबंधित एप्लिकेशन log नहीं बनता। उसके प्रकाशित indicators ज्ञात हमलावर गतिविधि को कवर करते हैं, इस vulnerability के हर संभव उपयोग को नहीं।
देखें Vates Security Advisory VSA-2026-062।
Check Point Research की एक अलग जाँच एक संबंधित, पर तकनीकी रूप से अलग समस्या दिखाती है।
हमलावरों ने Check Point Security Gateways की vulnerabilities का exploit किया, privileges बढ़ाए और persistence बनाई। एक जाँचे गए intrusion में वे gateway से SSH के ज़रिए एक VMware ESXi host पर गए और विनाशकारी malware चलाया।
Gateway के compromise से ESXi का नियंत्रण अपने-आप नहीं मिल गया। हमलावर को उस environment में पहुँचने का रास्ता और काम लायक authentication फिर भी चाहिए था। अहम बात यह है कि एक compromised इंफ्रास्ट्रक्चर component दूसरे संवेदनशील सिस्टम तक पहुँचने का ठिकाना बन गया।
Check Point Research की PHP2Shell जाँच पूरे क्रम और उसकी attribution की सीमाओं को दर्ज करती है।
दोनों मामले एक व्यावहारिक आर्किटेक्चर प्रश्न उठाते हैं:
क्या कोई compromised प्रशासनिक component उन सिस्टम या privileges तक पहुँच सकता है जो उसके निर्धारित काम के लिए ज़रूरी नहीं हैं?
नेटवर्क segmentation, सीमित किए गए management interfaces और संकीर्ण दायरे वाले service credentials इस पहुँच को सीमित करने में मदद कर सकते हैं। वे यह गारंटी नहीं दे सकते कि भरोसेमंद प्लेटफ़ॉर्म कभी compromise नहीं होगा, लेकिन वे इस पर असर डाल सकते हैं कि उसके बाद हमलावर क्या कर पाता है।
3. जब recovery के लिए ज़रूरी सिस्टम ही compromise हो जाते हैं
तीसरा तंत्र incident response के दौरान ख़ास तौर पर गंभीर हो जाता है।
अक्टूबर 2026 में Huntress ने compromised AhsayCBS backup-management servers की जाँच की। शोधकर्ताओं ने webshells, cryptocurrency-mining सॉफ़्टवेयर, persistence के तरीके और remote-access tools बरामद किए।
एक webshell ने encrypted payloads को PNG image डेटा में छिपा रखा था। उसी environment के एक संबंधित Veeam server पर जाँचकर्ताओं को Veeam के लिए credential-चोरी वाले module से मेल खाती एक कमांड भी मिली, हालाँकि वे यह नहीं बता सके कि कोई credentials निकाले गए या नहीं।
Huntress की AhsayCBS जाँच एक प्रभावित environment के तीन servers से बरामद tooling का वर्णन करती है।
Backup administration संवेदनशील इसलिए है कि वह उन सिस्टम के क़रीब बैठता है जिन पर संगठन तब निर्भर करते हैं जब कुछ गड़बड़ हो जाए। अगर हमलावर उस environment को compromise कर लें, तो responders को यह तय करना पड़ सकता है कि backup credentials, प्रशासनिक सेटिंग या recovery संसाधन भी प्रभावित हुए हैं या नहीं।
इससे निर्भरता की समस्या पैदा होती है।
किसी संगठन के पास भरोसेमंद backups हो सकते हैं, फिर भी उन्हें restore करना मुश्किल हो सकता है, अगर recovery इंफ्रास्ट्रक्चर तक पहुँच किसी ऐसे management सिस्टम पर निर्भर है जिस पर भरोसा नहीं किया जा सकता।
यही समस्या दूसरी प्रशासनिक सेवाओं के साथ भी आ सकती है। अगर सामान्य management console compromise हो जाए या उपलब्ध न हो, तो संगठन को महत्वपूर्ण सिस्टम की जाँच और restore के लिए एक स्वतंत्र रूप से सुरक्षित तरीका चाहिए।
सुरक्षा अपडेट ज़रूरी हैं, लेकिन deployment मायने रखता है
हर management-प्लेटफ़ॉर्म सुरक्षा घटना में सफल compromise शामिल नहीं होता।
नवंबर 2026 में N-able की N-central प्रतिक्रिया कई जुड़े components से बने management सिस्टम की vulnerabilities दूर करने की अलग चुनौती दिखाती है।
10 नवंबर को N-able ने Hotfix 2 जारी किया, जिसने सात documented CVEs को संबोधित किया। उसके 13 नवंबर के अपडेट में authentication, permissions, पुराने API एक्सेस और agent impersonation से जुड़ी अतिरिक्त रिपोर्ट की गई कमज़ोरियों का वर्णन था, और आगे के समाधान की योजना बताई गई।
N-able की प्रतिक्रिया ने केंद्रीय एप्लिकेशन को उसके Agents, Probes और appliances से अलग माना, जो management के काम करते हैं और केंद्रीय सर्वर से संवाद करते हैं।
देखें N-able का 13 नवंबर का remediation अपडेट।
Patching के दौरान यह फ़र्क़ मायने रखता है। एडमिनिस्ट्रेटरों को समझना होता है कि कौन-से components प्रभावित हैं, कौन-से fixes उपलब्ध हैं, क्या अपडेट किसी ख़ास क्रम में करने होंगे और क्या अस्थायी पाबंदियाँ ज़रूरी हैं।
यह तब भी मायने रखता है जब compromise पहले ही हो चुका हो।
एक patch कमज़ोर प्रवेश-बिंदु को बंद कर सकता है, पर ज़रूरी नहीं कि पहले लगाए गए दुर्भावनापूर्ण सॉफ़्टवेयर को हटाए, चुराए गए credentials रद्द करे या अनधिकृत कॉन्फ़िगरेशन बदलावों को पलटे।
इसीलिए vulnerability का समाधान और incident से recovery, दोनों में अलग-अलग फ़ैसले चाहिए।
संगठनों को क्या बदलना चाहिए?
इन जाँचों का मतलब यह नहीं कि केंद्रीकृत प्रशासन एक बुरा डिज़ाइन विकल्प है।
केंद्रीय management के बिना संगठन असंगत कॉन्फ़िगरेशन, देर से होने वाले अपडेट और सीमित संचालन-दृश्यता से जूझ सकते हैं। लक्ष्य यह है कि ये फ़ायदे बने रहें और अनधिकृत एक्सेस के नतीजे कम हों।
सबसे उपयोगी शुरुआती बिंदु यह समझना है कि हर management प्लेटफ़ॉर्म के पास कौन-सा अधिकार है।
प्रशासनिक पहुँच सीमित करें
उन management interfaces, service accounts, APIs, इंस्टॉल किए गए agents और integrations की पहचान करें जो दूसरे सिस्टम पर कार्रवाई कर सकते हैं।
एक्सेस केवल उन लोगों और सेवाओं तक सीमित रखें जिन्हें उसकी ज़रूरत है। जहाँ उचित हो, management नेटवर्क को सामान्य उपयोगकर्ता और एप्लिकेशन ट्रैफ़िक से अलग रखें, और प्रशासनिक एक्सेस को मज़बूत authentication से सुरक्षित करें।
सिस्टम की सेहत जाँचने वाली automation सेवा को कॉन्फ़िगरेशन बदलने वाली permissions नहीं मिलनी चाहिए, जब तक उसके काम को उनकी ज़रूरत न हो।
कई सिस्टम को प्रभावित करने वाली कार्रवाइयों पर नियंत्रण रखें
Mass scripting, सॉफ़्टवेयर deployment और bulk कॉन्फ़िगरेशन बदलावों का संभावित असर सामान्य single-device प्रशासन से ज़्यादा व्यापक होता है।
जहाँ समर्थित हो, इन कार्रवाइयों को role पाबंदियों, अतिरिक्त अनुमोदन या असामान्य गतिविधि पर alerts से सुरक्षित किया जा सकता है।
उद्देश्य यह नहीं कि एडमिनिस्ट्रेटर हर नियमित काम को हाथ से मंज़ूर करें। उद्देश्य उन कार्रवाइयों के लिए मज़बूत नियंत्रण देना है जो environment के बड़े हिस्से को प्रभावित कर सकती हैं।
स्वतंत्र प्रमाण सुरक्षित रखें
महत्वपूर्ण प्रशासनिक कार्रवाइयाँ ऐसी monitoring से देखी जा सकनी चाहिए जो पूरी तरह उसी सिस्टम पर निर्भर न हो जिसकी जाँच हो रही है।
इसमें अलग से सुरक्षित audit logs, endpoint telemetry और नेटवर्क monitoring शामिल हो सकते हैं।
उदाहरण के लिए, अगर कोई management सर्वर compromise हो जाए, तो स्वतंत्र रूप से इकट्ठा किए गए endpoint events यह तय करने में मदद कर सकते हैं कि किन मशीनों को कमांड मिले और उसके बाद क्या हुआ।
Compromised console के बिना recovery की तैयारी रखें
संगठन को पता होना चाहिए कि अगर उसका सामान्य administration प्लेटफ़ॉर्म भरोसे लायक न रहे, तो वह महत्वपूर्ण सिस्टम पर नियंत्रण कैसे वापस पाएगा।
इसके लिए स्वतंत्र रूप से सुरक्षित recovery accounts, भरोसेमंद installation स्रोत, अलग backup credentials और परखे हुए वैकल्पिक एक्सेस रास्ते चाहिए हो सकते हैं।
ये उपाय environment के अनुपात में होने चाहिए। Hosted support टूल इस्तेमाल करने वाले छोटे संगठन को वैसे डिज़ाइन की ज़रूरत नहीं, जैसा कई virtualization clusters चलाने वाले enterprise को चाहिए।
साझा ज़रूरत यह है कि recovery पूरी तरह उसी component पर निर्भर न हो जिसे recover किया जा रहा है।
आपकी अगली सुरक्षा समीक्षा के लिए एक उपयोगी अभ्यास
अपने environment में सबसे व्यापक अधिकार वाला management प्लेटफ़ॉर्म चुनें।
किसी product checklist से शुरू करने के बजाय सिस्टम के भीतर एक प्रशासनिक कार्रवाई का पूरा रास्ता ट्रेस करें।
मान लीजिए एक एडमिनिस्ट्रेटर 100 endpoints पर अपडेट deploy करता है।
एडमिनिस्ट्रेटर कहाँ authenticate करता है? कौन-सी सेवा निर्देश प्राप्त करती है? वह कौन-से credentials या privileges इस्तेमाल करती है? कौन-से agents कमांड चलाते हैं? गतिविधि कहाँ दर्ज होती है?
इस चित्र का सुलभ टेक्स्ट विकल्प
यह चित्र एक प्रशासनिक कार्रवाई, जैसे 100 endpoints पर अपडेट deploy करना, को पाँच क्रमांकित चरणों में ट्रेस करता है। हर चरण अभ्यास के एक प्रश्न से मेल खाता है।
चरण 1: एडमिनिस्ट्रेटर साइन इन करता है। प्रश्न यह है कि एडमिनिस्ट्रेटर कहाँ authenticate करता है।
चरण 2: management प्लेटफ़ॉर्म को निर्देश मिलता है। प्रश्न यह है कि कौन-सी सेवा उसे प्राप्त करती है। एक एम्बर झंडा इस चरण को चिह्नित करता है: अगर प्लेटफ़ॉर्म compromise हो जाए, तो हमलावर के हाथ में वह अधिकार आ जाता है जो प्लेटफ़ॉर्म के पास उसके मैनेज किए गए सिस्टम पर है।
चरण 3: प्लेटफ़ॉर्म अपने ही credentials और privileges से काम करता है। प्रश्न यह है कि वह कौन-से credentials या privileges इस्तेमाल करता है।
चरण 4: endpoints पर मौजूद agents कमांड चलाते हैं। प्रश्न यह है कि कौन-से agents उसे चलाते हैं। कमांड सभी 100 endpoints तक पहुँचती है, जिसे 100 छोटे वर्गों की ग्रिड के रूप में दिखाया गया है।
चरण 5: कार्रवाई का स्वतंत्र रिकॉर्ड, जो प्लेटफ़ॉर्म के बाहर और उसके अपने log से अलग रखा जाता है। प्रश्न यह है कि गतिविधि कहाँ दर्ज होती है, और क्या टीम compromised प्लेटफ़ॉर्म पर निर्भर हुए बिना जाँच कर सकती है और नियंत्रण वापस पा सकती है।
अब सोचिए कि अगर प्रशासनिक session या केंद्रीय प्लेटफ़ॉर्म compromise हो जाए, तो क्या होगा।
क्या हमलावर सभी 100 endpoints तक पहुँच सकता है? क्या कोई अप्रत्याशित deployment पकड़ पाएगा? क्या टीम गतिविधि की जाँच कर सकती है और compromised प्लेटफ़ॉर्म पर निर्भर हुए बिना नियंत्रण वापस पा सकती है?
यह अभ्यास एक सामान्य सुरक्षा चिंता को एक ठोस आर्किटेक्चर आकलन में बदल देता है।
यह भी पहचानने में मदद करता है कि अतिरिक्त एक्सेस पाबंदियाँ, monitoring या recovery इंतज़ाम कहाँ सबसे ज़्यादा मूल्य देंगे।
अधिकार की रक्षा कीजिए, केवल एप्लिकेशन की नहीं
Management प्लेटफ़ॉर्म लंबे समय से निशाने पर रहे हैं, क्योंकि उनके पास मूल्यवान प्रशासनिक क्षमताएँ हैं। अक्टूबर और नवंबर 2026 की घटनाएँ इस जोखिम को पुष्ट करती हैं, किसी नई श्रेणी के हमले को स्थापित नहीं करतीं।
उनके तकनीकी ब्योरे अलग हैं, पर वे दिखाते हैं कि management अधिकार का दुरुपयोग कैसे हो सकता है, compromise दूसरे इंफ्रास्ट्रक्चर तक कैसे फैल सकता है और भरोसेमंद प्रशासनिक सिस्टम प्रभावित होने पर recovery मुश्किल क्यों हो सकती है।
इंफ्रास्ट्रक्चर टीमों के लिए प्रश्न यह नहीं है कि केंद्रीकृत management होना चाहिए या नहीं।
प्रश्न यह है कि उसके पास जो अधिकार है, वह उचित रूप से सीमित, देखने योग्य और recover करने योग्य है या नहीं।
किसी management प्लेटफ़ॉर्म की सुरक्षा को आंशिक रूप से इस आधार पर भी आँका जाना चाहिए कि उसका अधिकार compromise होने पर क्या होता है।
और गहराई में
Huntress: SCKit Worm Investigation: ScreenConnect के ज़रिए पहुँचाई गई दुर्भावनापूर्ण कमांड की मूल जाँच, जिसमें देखी गई गतिविधि और अपुष्ट प्रसार मार्ग शामिल हैं।
Vates: Xen Orchestra Security Advisory: Authentication-bypass का तंत्र, प्रभावित versions, पहचान की सीमाएँ और समाधान संबंधी मार्गदर्शन।
Check Point Research: PHP2Shell Exploitation: Gateway compromise, privilege escalation, persistence और virtualization इंफ्रास्ट्रक्चर में आवाजाही का विश्लेषण।
Huntress: Inside an AhsayCBS Intrusion: Compromised backup-management servers पर मिली हमलावर persistence और tooling का तकनीकी विश्लेषण।
N-able: Vulnerability Remediation Update: 13 नवंबर 2026 का vendor मार्गदर्शन, जो पुष्ट fixes और authentication व agent संचार पर आगे के काम को समझाता है।
CISA and Partners: Guide to Securing Remote Access Software: CISA और साझेदार एजेंसियों का संयुक्त मार्गदर्शन (जून 2023), जो प्रशासनिक एक्सेस सीमित करने, remote-access tools मैनेज करने और उच्च-प्रभाव वाले ऑपरेशनों की monitoring पर है।
संबंधित TechiesJournal लेख
जब कोई भरोसेमंद क्लाउड एप्लिकेशन हमले का रास्ता बन जाता है: भरोसेमंद एप्लिकेशन identities ग्राहकों के environments में अनधिकृत एक्सेस को कैसे फैला सकती हैं।
क्लाउड कंट्रोल प्लेन आउटेज: सर्वर चल रहे हों तो भी सर्विस चालू क्यों नहीं होती: इंफ्रास्ट्रक्चर की उपलब्धता और recovery चल रहे workloads के बाहर के सिस्टम पर क्यों निर्भर करती है।
तकनीकी स्रोत 16 नवंबर 2026 को देखे गए।