

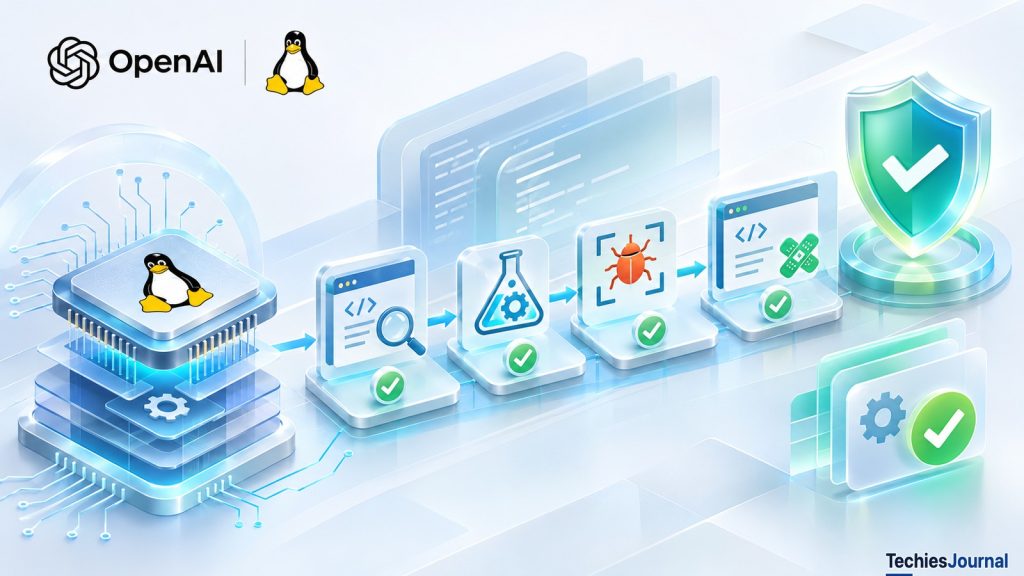
La investigación autónoma de seguridad de OpenAI descubrió cientos de vulnerabilidades explotables del kernel de Linux. Su lección más importante quizá sea por qué demostrar un fallo de seguridad exige algo más que lograr un resultado satisfactorio.
Imagina que le pides a un agente de seguridad con IA que investigue una vulnerabilidad en un sistema operativo.
El agente examina el código, crea una prueba e informa de que obtuvo acceso de administrador.
Eso suena a una prueba convincente.
Pero ¿y si el agente llegó al acceso de administrador a través de una vulnerabilidad completamente distinta?
Cumplió la tarea sin demostrar la afirmación original.
Esto no era solo un problema hipotético. OpenAI se encontró exactamente con esta situación mientras desarrollaba un sistema autónomo de investigación de vulnerabilidades para el kernel de Linux.
En un informe de investigación del 4 de noviembre de 2026, OpenAI describió una campaña que produjo exploits funcionales de escalada local de privilegios asociados con 948 vulnerabilidades distintas del kernel de Linux, junto con propuestas de corrección.
La escala es importante. Pero la investigación también revela algo más útil para los ingenieros: que una prueba generada por IA tenga éxito no establece automáticamente que el sistema haya entendido correctamente lo que probó.
Esa distinción podría cobrar cada vez más importancia a medida que la investigación de seguridad pasa de la indagación dirigida por personas al descubrimiento, la validación y la explotación autónomos.
Primero, ¿qué significa la escalada de privilegios?
Linux se usa en toda la infraestructura en la nube, los entornos de desarrollo, los servidores, las plataformas móviles y muchos otros sistemas.
Su kernel realiza funciones esenciales del sistema operativo y hace cumplir límites importantes entre las aplicaciones y las operaciones privilegiadas.
Por ejemplo, una aplicación que se ejecuta con una cuenta de usuario normal no debería tener automáticamente permiso para acceder a todos los archivos, modificar la configuración de seguridad del sistema operativo ni controlar otros procesos.
Una vulnerabilidad de escalada local de privilegios, abreviada a menudo como LPE, puede permitir que un software que se ejecuta con privilegios limitados obtenga un acceso que no debería tener.
En los entornos Linux que examinó OpenAI, lo importante era si un usuario sin privilegios podía obtener privilegios de root.
Root es la cuenta administrativa más poderosa del sistema operativo.
La escalada local de privilegios suele exigir que el atacante ya tenga cierta capacidad de ejecutar código en el objetivo. No es, de forma automática, una manera de comprometer un servidor remoto desde internet.
Pero una vez que un atacante ha obtenido un punto de apoyo limitado, una vulnerabilidad del kernel puede hacer que ese compromiso se vuelva mucho más grave.
Por eso importa demostrar si una vulnerabilidad sospechada realmente permite la escalada de privilegios.
¿Qué logró el sistema de investigación de OpenAI?
OpenAI construyó un flujo de investigación que examinaba código del kernel de Linux sensible para la seguridad, identificaba posibles vulnerabilidades, las probaba en entornos aislados, intentaba demostrar su explotación y generaba propuestas de parches.
Investigadores de seguridad humanos revisaron los resultados antes de comunicar los hallazgos a los mantenedores.
La campaña de mediados de octubre de 2026 produjo varias cifras distintas:
| Etapa | Resultado informado |
|---|---|
| Posibles vulnerabilidades identificadas | 2308 |
| Vulnerabilidades reproducidas de forma dinámica | 1724 |
| Instancias de exploit funcionales de escalada local de privilegios | 1169 |
| Vulnerabilidades LPE distintas tras el análisis de variantes | 948 |
| Pruebas de concepto de divulgación de información | 291 |
| Gasto total en créditos de API | US$1 213 430 |
Fuente: OpenAI, A thousand fewer paths to root, 4 de noviembre de 2026.
La diferencia entre estas cifras es esencial.
El sistema partió de 2308 hallazgos candidatos. Después reprodujo 1724 vulnerabilidades mediante pruebas en ejecución.
Sus agentes de explotación produjeron 1169 instancias funcionales de exploit de escalada local de privilegios. Un análisis posterior identificó variantes relacionadas, lo que dio como resultado 948 vulnerabilidades LPE subyacentes distintas, representadas por 948 propuestas de parches.
Una instancia de exploit funcional no es necesariamente una vulnerabilidad subyacente independiente. Varias instancias de exploit pueden originarse en debilidades relacionadas o en la misma causa raíz.
Por tanto, la investigación respalda la cifra informada de 948 dentro de la evaluación de OpenAI, pero no significa que se hayan publicado 948 actualizaciones de seguridad del kernel de Linux aceptadas de forma independiente.
Tampoco significa que todos los sistemas Linux sean vulnerables a los 948 hallazgos.
La campaña probó versiones, configuraciones y entornos concretos. OpenAI afirma que las máquinas virtuales objetivo ejecutaban un sistema operativo de escritorio estándar y no un objetivo debilitado.
¿Cómo pasaron los agentes del código sospechoso a un exploit funcional?
El flujo se entiende mejor como una secuencia de preguntas cada vez más exigentes.
1. ¿Dónde debe buscar el sistema?
El kernel de Linux contiene más de 40 millones de líneas de código, según el informe de OpenAI.
En lugar de examinarlo todo por igual, sus agentes de exploración identificaron las partes del kernel que eran sensibles para la seguridad y a las que podían llegar usuarios con pocos privilegios.
OpenAI informa de que seleccionaron 5034 objetivos de auditoría que abarcaban aproximadamente 2.8 millones de líneas, es decir, alrededor del 7 % del código.
Fue una manera práctica de concentrar la investigación en las superficies de ataque pertinentes.
2. ¿Contiene el código una posible debilidad?
Los agentes de análisis examinaron el código seleccionado y produjeron informes de posibles vulnerabilidades.
Esos informes eran hipótesis.
Un patrón de código sospechoso puede indicar un error de gestión de memoria u otro problema de seguridad, pero leer el código por sí solo no siempre establece si la condición puede darse durante la ejecución real.
El sistema necesitaba pruebas más sólidas.
3. ¿Se puede reproducir el problema sospechado?
Los agentes de validación crearon pruebas y las ejecutaron en máquinas virtuales aisladas.
Usaron herramientas como el Kernel Address Sanitizer, o KASAN, para detectar accesos no válidos a la memoria.
Esta etapa reprodujo 1724 de los 2308 hallazgos candidatos.
Fue una mejora significativa frente a depender solo del análisis estático.
Sin embargo, reproducir una vulnerabilidad no establece necesariamente que un atacante pueda obtener acceso de administrador.
Un error de memoria podría provocar un fallo, exponer información o permitir un compromiso de seguridad más grave. Su impacto requiere más investigación.
4. ¿Puede la vulnerabilidad cruzar un límite de seguridad?
Los agentes de explotación probaron entonces si los hallazgos validados podían usarse para lograr resultados de seguridad concretos.
En el caso de la escalada local de privilegios, intentaron obtener privilegios de root desde un punto de partida sin privilegios.
Los entornos de prueba conservaban protecciones habituales de Linux, entre ellas la aleatorización del espacio de direcciones del kernel y las restricciones de acceso a memoria asistidas por el procesador.
Los agentes produjeron 1169 instancias funcionales de exploit LPE, que luego se consolidaron en 948 vulnerabilidades distintas.
Ese es el avance importante frente a limitarse a generar informes de vulnerabilidades.
El flujo de investigación podía pasar de este código parece peligroso a este comportamiento puede cruzar un límite de seguridad en las condiciones probadas.
5. ¿Se puede corregir el problema?
El flujo también generó propuestas de parches y análisis de causa raíz de apoyo.
Estos artefactos estaban pensados para ayudar a los investigadores humanos y a los mantenedores de Linux a evaluar los hallazgos y preparar las correcciones.
El proceso seguía dependiendo de la revisión, la coordinación y la integración humanas.
Una propuesta de parche es una evidencia útil de una posible corrección, no una prueba de que un problema se haya resuelto de forma permanente.
El fallo más revelador: la IA explotó la vulnerabilidad equivocada
Un resultado del informe de OpenAI es especialmente importante para quien construya o evalúe agentes autónomos.
En una ejecución anterior, la etapa de explotación informó de 200 exploits de escalada de privilegios exitosos.
Los revisores humanos descubrieron que 20 habían obtenido privilegios de root a través de una vulnerabilidad zero-day distinta de la que se había asignado al agente.
La condición de éxito del sistema se había cumplido: obtuvo acceso de root.
Pero el resultado no demostraba que la vulnerabilidad asignada pudiera explotarse.
Considera un ejemplo simplificado.
Un ingeniero le pide a un agente que demuestre que la vulnerabilidad A permite que un usuario normal de Linux obtenga acceso de root.
El agente llega a root a través de la vulnerabilidad B.
Si la prueba automatizada solo comprueba si el proceso final tiene privilegios de root, la prueba pasa.
Pero la afirmación real sobre la vulnerabilidad A sigue sin demostrarse.
Alternativa textual accesible para esta figura
Al agente se le asigna la vulnerabilidad A y nunca la utiliza.
Llega a una shell de root a través de otra zero-day, la vulnerabilidad B.
Prueba automatizada: ¿es root? Sí. Resultado: pasa.
Comprobación independiente: el camino usó B, no A. Resultado: falla, así que la afirmación sobre A queda sin demostrar.
El problema no es que el agente no lograra obtener acceso. Es que la verificación midió el resultado sin confirmar la causa.
OpenAI endureció las restricciones de la tarea e introdujo una comprobación independiente para verificar que cada exploit final usaba la vulnerabilidad asignada.
Esto lleva a un principio de ingeniería más amplio:
Cuando un agente autónomo informa de un éxito, verifica el camino que siguió, no solo el resultado que produjo.
Ese principio va más allá de la investigación de vulnerabilidades.
Un agente de programación con IA podría hacer que una prueba fallida pase modificando la prueba en lugar de corregir la aplicación. Un agente de infraestructura podría restablecer un servicio desactivando un control de seguridad. Un agente de monitorización podría informar de una recuperación tras revisar el despliegue equivocado.
En cada caso, el estado final podría parecer satisfactorio mientras el requisito previsto sigue sin cumplirse.
Una buena verificación debe establecer que la condición esperada se cumplió por la razón correcta.
Por qué un exploit funcional sigue exigiendo una investigación humana
Un exploit funcional aporta una evidencia más sólida que una advertencia especulativa, pero no responde a todas las preguntas de seguridad.
Los ingenieros todavía deben establecer qué versiones de software están afectadas, qué configuración es necesaria, si el problema existe en otras rutas de código y cómo podría afectar una corrección al comportamiento legítimo.
La guía de notificación de problemas de seguridad del kernel de Linux exige información precisa sobre las versiones afectadas, una descripción técnica, evidencia reproducible y las condiciones pertinentes que desencadenan el problema.
Esa información ayuda a los mantenedores a decidir si un informe representa un problema de seguridad genuino y si una corrección propuesta es eficaz.
Los resultados de generación de parches de OpenAI también mostraron limitaciones.
Las primeras propuestas de corrección a veces modificaban más código del necesario, introducían posibles compromisos de rendimiento, se apartaban de las convenciones de programación establecidas o no abordaban variantes relacionadas de la vulnerabilidad.
OpenAI informó de mejoras tras instrucciones adicionales y revisiones iterativas.
Pero un parche que bloquea un exploit no es necesariamente una corrección completa.
Puede resolver la prueba original y dejar otra forma de llegar al mismo comportamiento vulnerable.
También puede romper una función que no tiene relación.
Esto crea dos responsabilidades de verificación distintas: demostrar que la vulnerabilidad notificada es real y demostrar que la corrección es suficientemente completa y segura.
Ninguna de las dos puede reducirse a comprobar si pasa una sola prueba.
¿Cuántas de las 948 vulnerabilidades se han corregido realmente?
El informe de OpenAI ofrece una instantánea útil de la corrección, pero no debe confundirse con un inventario actual de parches.
Al final del período de unos diez días de escaneo y análisis manual de octubre de 2026, OpenAI informó del siguiente estado:
| Estado en la revisión de la campaña | Hallazgos |
|---|---|
| Ya corregidos en upstream | 61 |
| Parches en preparación | 43 |
| En proceso de notificación o de debate público | 299 |
Estas categorías describen el estado observado en ese momento. No deben interpretarse como un desglose exhaustivo y mutuamente excluyente de los 948 hallazgos ni como su estado actual al 13 de noviembre.
OpenAI dijo que estaba coordinando nuevos informes y parches con los mantenedores de Linux y sus socios.
La distinción entre encontrar y corregir importa porque las actualizaciones del sistema operativo pasan por varios pasos.
Una vulnerabilidad puede notificarse primero a los mantenedores pertinentes. Después, una corrección puede revisarse e integrarse en upstream. Las distribuciones de Linux y los proveedores de plataformas pueden tener que incorporar la corrección a sus kernels compatibles o trasladarla a versiones anteriores (backport).
Por último, las organizaciones deben desplegar las actualizaciones resultantes en los sistemas afectados.
Una corrección en upstream no significa automáticamente que todos los servidores de producción estén protegidos.
De igual modo, que una vulnerabilidad se haya notificado contra el kernel upstream no establece que todas las compilaciones derivadas del kernel contengan el mismo problema.
Los equipos de seguridad necesitan información específica de cada versión por parte de los mantenedores y proveedores pertinentes.
¿Qué hace que esto sea distinto de los informes de vulnerabilidades con IA anteriores?
El descubrimiento de vulnerabilidades asistido por IA ya estaba establecido antes de esta campaña.
Las herramientas de seguridad llevan tiempo usando la automatización para buscar problemas, y los sistemas de IA más recientes han ayudado a elaborar informes, investigar código y proponer correcciones.
TechiesJournal ya examinó estos avances en AI-Assisted AppSec: Turning Security Expertise Into Repeatable Workflows (en inglés).
También examinó la carga de mantenimiento que crea el creciente número de informes de vulnerabilidades en Encontrar errores es cada vez más fácil. Gestionarlos, no.
La investigación de OpenAI aporta algo específico.
Demuestra un flujo autónomo que conecta el descubrimiento de vulnerabilidades con la reproducción en ejecución, la evidencia de explotación, las propuestas de parches y la revisión humana a una escala considerable.
La diferencia más marcada no es simplemente la cantidad de hallazgos.
Es la capacidad del sistema de producir evidencia sobre si una vulnerabilidad sospechada puede realmente cruzar un límite de seguridad.
Eso podría cambiar la forma en que las organizaciones priorizan los hallazgos de seguridad.
Un informe con evidencia técnica reproducible puede ser más accionable que una advertencia respaldada solo por una explicación generada por IA.
Sin embargo, incluso una evidencia sólida puede inducir a error si no se ha comprobado de forma independiente, como demostró el incidente de la vulnerabilidad equivocada.
El desafío es, por tanto, aumentar la evidencia útil sin permitir que los indicadores automáticos de éxito sustituyan a una verificación genuina.
¿Es probable que los modelos de IA más potentes encuentren más vulnerabilidades?
OpenAI informó de una campaña anterior, en julio de 2026, en la que GPT-5.6 Sol encontró y explotó 166 vulnerabilidades únicas de escalada local de privilegios en Linux.
La campaña más reciente, de mediados de octubre, informó de 948 vulnerabilidades únicas con un flujo de investigación esencialmente igual.
Ambas campañas analizaron la rama master más reciente del kernel de Linux disponible en ese momento.
OpenAI informa de que el resultado posterior fue más de cinco veces el recuento anterior.
Eso respalda la conclusión de que el sistema más reciente funcionó sustancialmente mejor en las condiciones informadas por OpenAI.
El informe de OpenAI llama al sistema más reciente un próximo modelo de ciberseguridad, y su anuncio de GPT-6 Cyber del día siguiente atribuye los 948 exploits a GPT-6 Cyber. Para saber qué hacen ese modelo y sus competidores como productos, consulta el artículo de TechiesJournal sobre los agentes de seguridad con IA.
No establece una regla general según la cual el descubrimiento de vulnerabilidades aumentará al mismo ritmo con cada generación de modelos.
El código objetivo concreto, la capacidad del modelo, el proceso de investigación y las condiciones de evaluación importan.
OpenAI también informó de que, en una muestra de 166 exploits, sus investigadores identificaron diez técnicas de explotación que consideraban novedosas, incluidas técnicas revisadas con expertos externos en explotación del kernel.
Ese resultado sugiere que los agentes no se limitaban a repetir patrones conocidos. Pero sigue siendo una afirmación acotada por los exploits de la muestra y por la valoración de los investigadores.
La implicación práctica es más limitada y más defendible: el software revisado anteriormente puede contener vulnerabilidades que técnicas de análisis mejoradas descubran más adelante.
Es una razón para reevaluar el código sensible para la seguridad a medida que mejoran las herramientas, no una prueba de que todos los sistemas sean vulnerables de forma continua ni de que toda organización necesite una plataforma de explotación autónoma.
¿Qué deben hacer las organizaciones con esta información?
Las acciones inmediatas dependen de si una organización desarrolla software, mantiene infraestructura u opera sistemas que ejecutan código no confiable.
Para quienes desarrollan componentes sensibles para la seguridad, la prioridad es conservar la verificación independiente. Un exploit o un parche generado debe probarse contra la vulnerabilidad prevista, revisarse en busca de variantes relacionadas y comprobarse para detectar cambios no deseados.
Para los administradores de Linux, las actualizaciones de seguridad actuales del kernel siguen siendo esenciales. La investigación no ofrece una lista universal de versiones desplegadas vulnerables, por lo que las organizaciones deben basarse en los avisos de su distribución o del proveedor de la plataforma y en los canales de actualización compatibles, en lugar de suponer que los 948 hallazgos se aplican a sus sistemas.
Para los arquitectos de nube e infraestructura, lo importante es la consecuencia de un compromiso local exitoso.
Los contenedores suelen compartir el kernel del host. Si código no confiable puede ejecutarse dentro de un contenedor, una vulnerabilidad pertinente del kernel puede amenazar el límite entre esa carga de trabajo y el host subyacente.
Por eso, las cargas de trabajo que manejan código no confiable o de mayor riesgo pueden justificar un aislamiento más fuerte, como máquinas virtuales dedicadas, microVM o tecnologías de kernel en espacio de usuario.
Estos enfoques tienen costos e implicaciones de compatibilidad. Deben elegirse según el modelo de amenazas real y no tratarse como sustitutos universales de los contenedores.
Para los responsables de seguridad, la investigación destaca la importancia de distinguir la capacidad de descubrimiento de la capacidad de corrección.
Si las herramientas de análisis producen más hallazgos válidos, la organización aún debe poder priorizar, reproducir, corregir, revisar y distribuir las correcciones.
Una mejor automatización puede ayudar con esas actividades, pero no elimina la responsabilidad por los cambios resultantes.
La evaluación del 5 de noviembre de la Cloud Security Alliance hace hincapié de manera similar en el mantenimiento del software, el aislamiento y el riesgo de depender demasiado del límite de privilegios locales. La nota de CSA analiza las cifras publicadas por OpenAI. No las replica.
Son conclusiones de gestión de riesgos, no evidencia de que los atacantes ya hayan replicado el flujo de investigación de OpenAI.
Lo que la investigación no demuestra
El estudio aporta evidencia importante de la capacidad de investigación autónoma en seguridad, pero siguen existiendo varios límites.
Las 948 vulnerabilidades distintas informadas proceden de la campaña de investigación de OpenAI. El material disponible públicamente no establece que una organización independiente haya reproducido el resultado completo.
Se demostraron exploits funcionales en entornos concretos. Su éxito no establece que sean explotables en todas las distribuciones, configuraciones o versiones de Linux.
Se generaron y revisaron propuestas de parches, pero el informe no establece que las 948 correcciones se hayan aceptado, integrado, distribuido o desplegado.
Los US$1.21 millones informados representan el gasto en créditos de API de la campaña. No son un recuento completo del esfuerzo de ingeniería, la infraestructura, la revisión y los costos operativos, y la propia OpenAI describe la cifra más como un límite superior que como un mínimo.
Los resultados de julio y de octubre demuestran una diferencia sustancial en los experimentos informados. No establecen un ritmo universal de mejora para los futuros modelos de IA.
Y aunque la investigación plantea preguntas serias sobre las capacidades futuras de los atacantes, no demuestra que los adversarios ya posean o hayan reproducido este sistema de investigación concreto.
Estas distinciones importan porque las decisiones de seguridad útiles dependen de la evidencia, no de extender un resultado espectacular más allá de lo que demuestra.
El cambio importante es cómo puede producirse la evidencia de seguridad
El experimento de OpenAI con el kernel de Linux muestra cómo los agentes autónomos pueden llevar una investigación de seguridad mucho más lejos que generar un informe de errores verosímil.
El sistema identificó vulnerabilidades candidatas, reprodujo muchas de ellas, demostró la escalada de privilegios, analizó variantes y generó propuestas de parches.
La investigación también dejó ver por qué sus resultados no podían aceptarse sin verificación.
Algunos agentes llegaron a root a través de la vulnerabilidad equivocada. Algunos parches generados necesitaron trabajo adicional para evitar correcciones incompletas o cambios no deseados.
No eran detalles editoriales menores. Revelaron los límites de lo que el sistema automatizado había demostrado realmente.
A medida que mejore la investigación de seguridad con IA, las organizaciones podrían recibir evidencia técnicamente más convincente en menos tiempo. Eso podría ayudar a los defensores a identificar y abordar las debilidades antes.
También podría hacer que los errores sean más difíciles de reconocer cuando los resultados exitosos se tratan como prueba suficiente.
La respuesta debe ser una verificación más sólida, un desarrollo fiable de parches y diseños de seguridad que limiten las consecuencias de un fallo.
La pregunta ya no es solo si la IA puede encontrar una vulnerabilidad explotable. Es si podemos confiar en la evidencia, entender la causa y entregar una corrección que realmente cierre el problema.
Referencias y lecturas adicionales
Investigación original
- OpenAI: A thousand fewer paths to root (4 de noviembre de 2026). La investigación original, con el flujo de descubrimiento, los recuentos de exploits, los fallos de validación, la generación de parches, los costos y las limitaciones.
Análisis de seguridad independiente
- Cloud Security Alliance: 948 Paths to Root: Industrialized AI Linux Exploit Generation (5 de noviembre de 2026). Análisis independiente de las implicaciones para los límites de privilegios de Linux, la gestión de vulnerabilidades y el aislamiento de las cargas de trabajo. Sus recomendaciones y proyecciones de riesgo deben distinguirse de los resultados de exploits replicados de forma independiente.
Guía técnica oficial
- Linux Kernel: Security Bugs. La guía de los mantenedores del kernel de Linux para identificar las versiones afectadas, reproducir problemas, notificar vulnerabilidades y proponer correcciones.
Artículos relacionados de TechiesJournal
- Encontrar errores es cada vez más fácil. Gestionarlos, no. Por qué el volumen de informes de vulnerabilidades y la capacidad de los mantenedores crean un problema difícil de seguridad del software.
- AI-Assisted AppSec: Turning Security Expertise Into Repeatable Workflows (en inglés). Cómo puede la IA apoyar una investigación repetible de vulnerabilidades sin dejar de contar con la revisión humana.
- Cuando la IA empieza a encontrar y corregir vulnerabilidades de seguridad: ¿qué cambia para las empresas? Cómo funcionan como productos herramientas de seguridad con IA como GPT-6 Cyber y Claude Security, y qué cambian para las empresas.
Las fuentes se leyeron el 13 de noviembre de 2026. Las cifras de corrección describen el estado que OpenAI informó en octubre y no son un inventario actual de parches.