

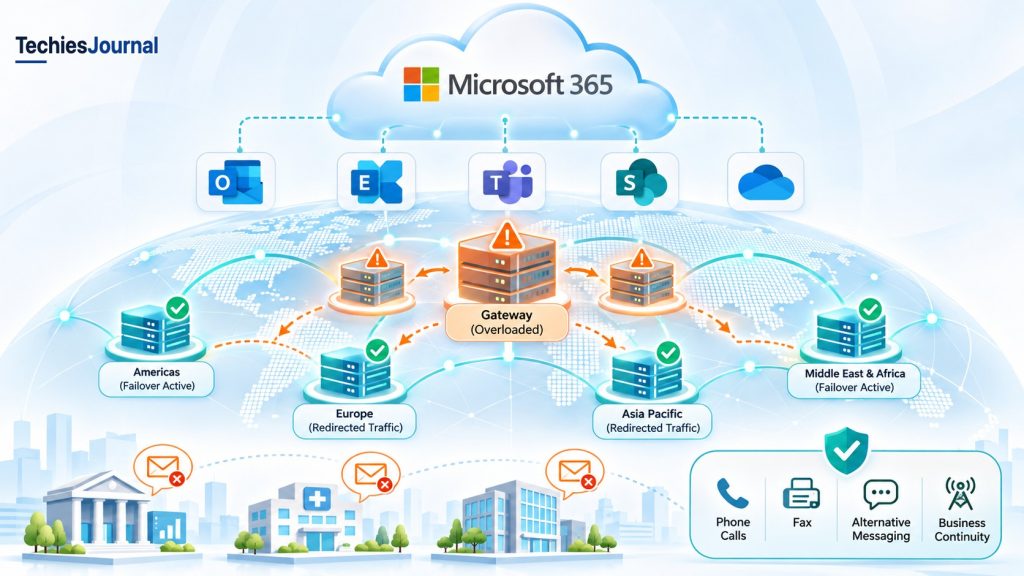
La interrupción de Microsoft 365 de noviembre de 2026 afectó el correo electrónico en todo el mundo durante casi 24 horas. La investigación preliminar de Microsoft explica cómo un defecto de software antiguo, un cambio en el tráfico y una capacidad de servidores reducida se combinaron para provocar fallas generalizadas.
El jueves 12 de noviembre, empleados de empresas de todo el mundo empezaron a tener problemas para usar Microsoft Outlook. Muchos no podían acceder al correo y algunos mensajes se retrasaron. El problema también afectó funciones de otros servicios de Microsoft 365 que dependen de Exchange Online, la plataforma de correo en la nube de Microsoft.
Para algunas organizaciones, esto fue más que un inconveniente. Las firmas financieras usaron el teléfono y el fax para confirmar transacciones. Las empresas que preparaban anuncios financieros recurrieron a otras formas de intercambiar información. La investigación preliminar de Microsoft atribuyó después el incidente a un problema de software que llevaba meses presente, pero que no se había manifestado en condiciones de operación anteriores.
Esto es lo que establecen los registros y lo que Microsoft todavía no había explicado por completo al 21 de noviembre.
1. ¿Qué ocurrió?
La falla se produjo en la infraestructura en la nube de Microsoft y no en las instalaciones individuales de Outlook. Outlook y otras aplicaciones de correo se conectan a Exchange Online mediante sistemas que reciben y dirigen sus solicitudes. Durante la interrupción, los servidores que gestionaban esas conexiones se sobrecargaron y dejaron de responder.
Microsoft indicó que la mayoría de las personas que intentaban usar las funciones que dependen de Exchange Online resultaron afectadas, aunque la experiencia varió según la región, el método de acceso y el momento. Algunos usuarios no podían abrir sus buzones. Otros tenían acceso intermitente o retrasos al enviar y recibir mensajes.
Microsoft también incluyó a Teams, Copilot, SharePoint, OneDrive, Defender y varios otros servicios entre los afectados. Esto no significa que todas las aplicaciones enumeradas dejaran de funcionar. Microsoft indicó que muchos de estos servicios siguieron disponibles en su mayor parte, pero tuvieron problemas con las funciones conectadas a Exchange Online. Los chats y las reuniones de Teams, por ejemplo, siguieron funcionando durante la mayor parte de la interrupción, después de trasladarlos fuera del gateway afectado.
Fuente: informe preliminar posterior al incidente (PIR) de Microsoft, pp. 2 a 4. El enlace es una copia del informe alojada por un tercero.
2. ¿Cuánto duró la interrupción?
Microsoft registró el período principal de afectación a los clientes desde las 16:20 UTC del 12 de noviembre hasta las 16:10 UTC del 13 de noviembre de 2026: 23 horas y 50 minutos. En hora estándar del Este, fue desde las 11:20 a. m. del jueves hasta las 11:10 a. m. del viernes.
Esa duración describe el período principal de afectación activa. No significa que todos los servicios estuvieran no disponibles durante todas esas horas. Algunas aplicaciones se recuperaron antes, y Microsoft siguió verificando el estado del servicio y procesando el correo retrasado después de que terminara la afectación principal. Sus últimas actualizaciones para los clientes se emitieron el 14 de noviembre.
| Hora (UTC) | Hito documentado |
|---|---|
| 12 nov, 01:07 | El tráfico de Teams se trasladó automáticamente al gateway que también atendía a Exchange Online. |
| 12 nov, 16:03 | La supervisión de Microsoft detectó problemas de conexión crecientes. |
| 12 nov, 16:20 | Microsoft registró el inicio de la afectación importante a los clientes. |
| 13 nov, 07:20 | Los ingenieros comenzaron a aplicar un cambio para deshacer el comportamiento defectuoso. |
| 13 nov, 14:17 | La disponibilidad global del correo web volvió a los niveles esperados. |
| 13 nov, 16:10 | Microsoft registró el fin de la afectación activa a los clientes. |
| 14 nov, 04:15 | Microsoft emitió las últimas actualizaciones para los clientes tras una supervisión prolongada. |
Fuente: informe preliminar posterior al incidente (PIR) de Microsoft, pp. 2 y 4 a 6.
3. ¿Quiénes resultaron afectados?
Microsoft describió esto como un incidente global. El mayor impacto fue en el acceso a los buzones de Exchange Online y en la entrega del correo. Algunas funciones de otros servicios de Microsoft 365 se vieron afectadas porque dependían de la misma infraestructura de correo.
La gravedad fue desigual. Es posible que una empresa no pudiera usar Outlook de forma confiable mientras sus reuniones de Teams seguían funcionando. Otra pudo haber sufrido la interrupción de un flujo de trabajo que enviaba notificaciones por correo. Estas distinciones importan: hablar de una interrupción de Microsoft 365 no significa que todos los clientes perdieran el acceso a todos los servicios de Microsoft 365.
El informe preliminar de Microsoft no proporcionó una cifra global verificada de usuarios u organizaciones afectados. Los sitios web públicos que registran interrupciones recopilaron quejas, pero esas cifras no deben tomarse como el número de clientes únicos afectados.
Fuente: informe preliminar posterior al incidente (PIR) de Microsoft, p. 2.
4. ¿Cuál fue el impacto empresarial?
Reuters documentó empresas que usaron métodos de comunicación alternativos mientras el correo estaba interrumpido. En Taiwán, algunas firmas financieras tuvieron problemas con actividades de administración de fondos, y una de ellas usó el fax para confirmar transacciones. Los bancos británicos HSBC y Barclays activaron sus mecanismos de respuesta a incidentes, aunque indicaron que muchos servicios de atención al cliente seguían funcionando con normalidad.
La interrupción también afectó la comunicación en torno a los resultados financieros. Reuters informó que la aseguradora Aviva compartió números de teléfono alternativos y transfirió grabaciones por Bluetooth. El operador bursátil Euronext indicó a las empresas cotizadas que usaran el contacto telefónico para las comunicaciones urgentes. Otras organizaciones también recurrieron a las llamadas telefónicas mientras el correo no era confiable.
Estos ejemplos muestran una interrupción operativa, pero no establecen un costo financiero total. No hay una cifra verificada de pérdidas a nivel mundial en las fuentes revisadas para este artículo. No debemos calcular una a partir de quejas de usuarios, relatos anecdóticos o estimaciones no verificadas.
Fuente: Reuters, 13 de noviembre de 2026.
5. ¿Qué causó la interrupción?
La investigación preliminar de Microsoft identificó tres condiciones que se combinaron para derribar el gateway que gestionaba las conexiones con varios servicios de Microsoft 365.
La primera fue un defecto de software antiguo. En julio, Microsoft había comenzado a implementar un cambio específico para los servidores del gateway de Microsoft 365. El cambio superó el proceso normal de implementación de la empresa y funcionó durante más de tres meses sin problemas visibles. Sin embargo, bajo ciertas condiciones de tráfico, el cambio hacía que las operaciones internas del servidor interfirieran entre sí. La capacidad de procesamiento y la memoria podían agotarse hasta que un servidor dejaba de responder. Microsoft llamó a esto un problema de contención de bloqueos (lock contention).
Microsoft indicó que sus pruebas no detectaron el defecto porque las computadoras y los patrones de tráfico usados en las pruebas diferían de los de producción. El problema empeoraba en computadoras más nuevas con más núcleos de procesador, mientras que sus pruebas de carga solían usar máquinas menos potentes. La empresa destacó que se trataba de un cambio específico del gateway, no de un defecto que afecte a las instalaciones habituales de Windows.
La segunda condición fue un cambio en el tráfico. Unas 15 horas antes del incidente, Teams trasladó automáticamente el tráfico de un gateway alternativo al gateway principal, que también atendía a Exchange Online. Este tipo de cambio forma normalmente parte de mantener los servicios disponibles, pero añadió carga de trabajo a la infraestructura afectada y modificó la mezcla de solicitudes que recibía.
La tercera condición fue la capacidad reducida. Casi el 14 % de la capacidad de servidores de ese gateway no estaba disponible por un problema distinto ocurrido el día anterior. Microsoft indicó que la capacidad restante debería haber sido suficiente en condiciones normales. Pero, junto con el cambio de tráfico, la capacidad reducida ayudó a dejar al descubierto el defecto antiguo durante un período de mucha actividad en Estados Unidos.
Cuando los servidores fallaron, el sistema de Microsoft redirigió su tráfico a los servidores que seguían pareciendo sanos. Esos servidores tenían el mismo defecto oculto. A medida que les llegó más trabajo, también fallaron. Microsoft informó que más del 80 % de los servidores del gateway no respondían en el peor momento.
Microsoft había diseñado límites destinados a evitar que una falla en una parte de la infraestructura se propagara entre regiones. Indicó que un problema distinto impidió que estos límites, llamados mamparos (bulkheads), contuvieran la falla. El informe preliminar no explicó por completo ese problema adicional.
Fuente: informe preliminar posterior al incidente (PIR) de Microsoft, pp. 3 a 4.
6. ¿Por qué la recuperación tardó tanto?
Microsoft intentó primero reparar y reiniciar los servidores afectados y trasladar las conexiones a otra infraestructura. Algunos servidores parecían sanos al reiniciarse, pero volvían a dejar de responder cuando regresaba el tráfico en espera. La magnitud de la falla superaba la condición para la que estaban diseñados sus sistemas normales de recuperación automatizada.
Deshacer el cambio de software también fue difícil. El defecto estaba presente desde julio, por lo que las herramientas habituales para revertir rápidamente una implementación reciente no podían simplemente deshacerlo. Los ingenieros desarrollaron una nueva actualización que devolvió el código afectado de gestión de conexiones a un estado anterior que funcionaba.
Luego la empresa aplicó ese cambio a grupos de servidores y los devolvió al servicio con cuidado. La recuperación se mantuvo de forma sostenida el 13 de noviembre, y el correo web se recuperó antes que los demás métodos de acceso. Microsoft siguió supervisando y procesando el correo retrasado después de que terminara la afectación activa.
Fuente: informe preliminar posterior al incidente (PIR) de Microsoft, pp. 4 a 6.
7. ¿Qué reconoció Microsoft?
El informe de Microsoft reconoció que sus pruebas no reprodujeron la combinación de condiciones de hardware y de tráfico que dejó al descubierto el defecto de software. También reconoció que sus protecciones regionales normales no lograron impedir que el incidente se propagara y que su proceso de recuperación automatizada no estaba diseñado para una falla tan amplia.
La Associated Press informó que la actualización pública anterior de Microsoft describía el incidente como introducido por un problema durante una ampliación anterior de la capacidad de la red, que apareció tras un cambio reciente en la red. El informe preliminar ofrece la explicación más completa descrita arriba, y las fuentes revisadas no explican cómo se relacionan ambas descripciones.
El director ejecutivo de Microsoft, Satya Nadella, comentó posteriormente la interrupción y la necesidad de detectar estos defectos durante las pruebas. También habló del desafío más amplio de la estabilidad del software cuando la IA ayuda a los desarrolladores a encontrar errores y a producir parches con mayor rapidez. Esas declaraciones no establecen que la IA causara este incidente. Microsoft afirmó que la interrupción fue un problema técnico no relacionado con ciberataques ni con agentes de IA, y el informe preliminar de causa raíz no identifica el código generado por IA como una causa.
Fuentes: informe preliminar posterior al incidente (PIR) de Microsoft, reportaje de Mint sobre Nadella, 19 de noviembre de 2026 y Associated Press sobre la declaración de Microsoft.
8. ¿Qué corrigió Microsoft y qué sigue sin saberse?
Microsoft informó que completó varias medidas inmediatas. Entre ellas figuran restablecer el comportamiento anterior que funcionaba en la gestión de conexiones, añadir capacidad, ampliar el plazo de entrega del correo retrasado, mejorar la supervisión y añadir controles para reducir el riesgo de que el tráfico se redirija de una manera que provoque otra cascada.
Estas son acciones informadas por Microsoft, no una prueba independiente de que se haya eliminado cada debilidad a más largo plazo. Al corte de evidencia de este artículo, el 21 de noviembre, el informe preliminar no había explicado por completo por qué falló la contención regional, qué causó la reducción distinta de capacidad del 14 % ni cómo se verificarían todas las mejoras permanentes. El informe final posterior al incidente de Microsoft no estaba disponible públicamente cuando se revisó este artículo.
La interrupción también ilustra por qué las empresas necesitan saber qué actividades esenciales dependen de las herramientas de comunicación en la nube y cómo se comunicarán cuando no puedan acceder a ellas. TechiesJournal explora esa cuestión más amplia de la continuidad del negocio en La paradoja de la dependencia de la nube: cuando la tecnología fiable no garantiza la continuidad del negocio. El presente informe se centra en el incidente documentado de Outlook y no repite ese análisis.
El incidente se ha resuelto. La investigación preliminar de Microsoft explica cómo se desarrollaron las fallas principales, mientras que el informe final sigue siendo la próxima fuente para evaluar sus acciones correctivas a más largo plazo.
Referencias y lecturas adicionales
- Preliminary Post-Incident Report for Microsoft 365 (Microsoft, November 15, 2026): causa, cronología y medidas inmediatas redactadas por Microsoft. Preliminar y sujeto a cambios. El enlace es una copia del informe alojada por un tercero.
- Faxes, phones and Bluetooth: Microsoft outage forces businesses to find fixes (Reuters, November 13, 2026): ejemplos de empresas y comunicaciones alternativas informados de forma independiente.
- Microsoft says services fully restored after global outage (Associated Press, November 14, 2026): cobertura independiente de la restauración y de la exclusión por parte de Microsoft de causas como un ciberataque o agentes de IA.
- Nadella discusses Outlook outage and software stability (Mint, November 19, 2026): reportaje de una entrevista. Distinga los comentarios sobre la rapidez general de los parches con IA de la causa documentada de este incidente.
Revisión de fuentes: 21 de noviembre de 2026. Este artículo se basa en el informe preliminar de Microsoft. Un informe final no estaba disponible públicamente al momento de la revisión.