

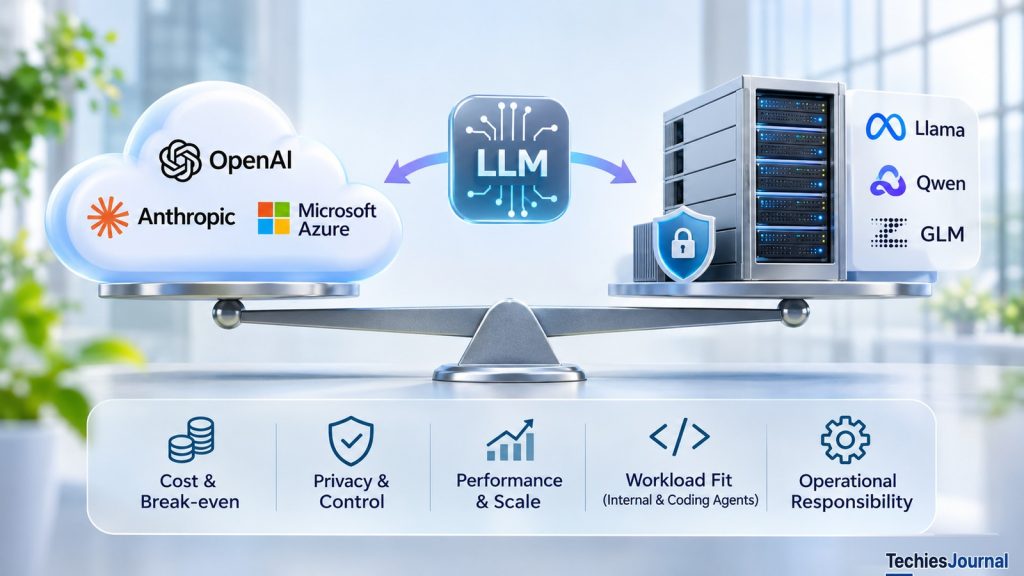
ఓపెన్-వెయిట్ లాంగ్వేజ్ మోడల్ను ప్రైవేట్ ఇన్ఫ్రాస్ట్రక్చర్పై నడపడం డేటాపై, మోడల్ ప్రవర్తనపై, ఆపరేటింగ్ ఖర్చులపై ఎక్కువ నియంత్రణను వాగ్దానం చేస్తుంది. కానీ ఒక కంపెనీ వాస్తవంగా ఎంత లాభపడుతుంది? రెండు ఆచరణాత్మక వర్క్లోడ్లు, ఒక అంతర్గత నాలెడ్జ్ ఏజెంట్, ఒక AI కోడింగ్ ఏజెంట్, మోడల్ ఎక్కడ నడుస్తుందనే దానికంటే మోడల్ సామర్థ్యం, ఇన్ఫ్రాస్ట్రక్చర్ ఖర్చులు, చేస్తున్న పని ఎందుకు ఎక్కువ ముఖ్యమో చూపిస్తాయి.
ఒక కంపెనీ తన ఉద్యోగుల కోసం ఒక AI అసిస్టెంట్ను ప్రవేశపెట్టాలనుకుంటోంది. ఆ అసిస్టెంట్ అంతర్గత డాక్యుమెంటేషన్ను వెతకాలి, ట్రబుల్షూటింగ్ విధానాలను వివరించాలి, ఇన్సిడెంట్లను సంక్షిప్తంగా చెప్పాలి, రోజువారీ సమస్యలను పరిష్కరించడంలో సిబ్బందికి సహాయం చేయాలి.
ఇంజనీరింగ్ టీమ్ ముందు ఒక ఎంపిక ఉంది. ఉద్యోగులు వాడుతున్న కొద్దీ ఇన్ఫరెన్స్కు చెల్లిస్తూ, API ద్వారా ఒక హోస్టెడ్ మోడల్ను వాడవచ్చు. లేదా కంపెనీ నియంత్రణలో ఉన్న ఇన్ఫ్రాస్ట్రక్చర్పై ఒక ఓపెన్-వెయిట్ మోడల్ను డిప్లాయ్ చేయవచ్చు.
రెండో ఎంపిక ఆకర్షణీయంగా అనిపిస్తుంది. సున్నితమైన సమాచారం ఆమోదించిన ప్రైవేట్ వాతావరణంలోనే ఉండిపోవచ్చు. టీమ్ నిర్దిష్ట మోడల్ వెర్షన్లను అలాగే ఉంచుకోవచ్చు, ఇన్ఫరెన్స్ సెట్టింగ్లను సర్దుబాటు చేయవచ్చు, ఒక వాణిజ్య మోడల్ API పై పూర్తిగా ఆధారపడకుండా ఉండవచ్చు.
ఆర్థిక వాదన కూడా ఉంది. కంపెనీ సొంత GPUలను నడపగలిగినప్పుడు టోకెన్ల కోసం ఎందుకు చెల్లిస్తూనే ఉండాలి?
ఇన్ఫ్రాస్ట్రక్చర్ ఇంజనీరింగ్ దృష్టికోణం నుంచి, ఏ హార్డ్వేర్ ఖర్చునైనా ఆమోదించే ముందు నేను ఆ ప్రశ్నను సవాలు చేస్తాను.
ఒక GPU, ఒక API సబ్స్క్రిప్షన్ సమానమైన మేధస్సును అందిస్తాయని ఆ ప్రశ్న ఊహిస్తుంది. అవి అందించవు. GPU కంప్యూటేషన్ను, మెమరీని అందిస్తుంది. కంపెనీకి ఇంకా తన పనిని పూర్తి చేయగల మోడల్, అభ్యర్థనలను సమర్థంగా సర్వ్ చేసే రన్టైమ్, సిస్టమ్ను నడపగల ఇంజనీర్లు అవసరం.
ఈ నిర్ణయం కంపెనీ ఒక GPUను ఎంత చౌకగా అద్దెకు తీసుకోగలదనే దానితో కాకుండా, అప్లికేషన్ ఏమి సాధించాలనే దానితో మొదలవ్వాలి.
చాలా భిన్నమైన అవసరాలు ఉన్న రెండు అప్లికేషన్లను పరిశీలించినప్పుడు ఈ తేడా మరింత స్పష్టమవుతుంది.
అంతర్గత నాలెడ్జ్ ఏజెంట్ ఖర్చు ఊహించిన దానికంటే తక్కువగా ఉండవచ్చు
100 మంది ఉద్యోగులున్న ఒక కంపెనీని పరిగణించండి. ప్రతి ఉద్యోగి 22 పని దినాల పాటు, ప్రతి పని దినం ఒక అంతర్గత AI ఏజెంట్ను పది ప్రశ్నలు అడుగుతారు.
దీనివల్ల నెలకు 22,000 ఇంటరాక్షన్లు వస్తాయి.
అసిస్టెంట్ కంపెనీ డాక్యుమెంటేషన్ నుంచి సమాచారాన్ని తీసుకుని, సంబంధిత విషయాన్ని సంక్షిప్తీకరించి, ఒక సమాధానాన్ని తయారుచేస్తుంది. కొన్ని ప్రశ్నలకు చిన్న వివరణ సరిపోవచ్చు, మరికొన్నింటికి అనేక డాక్యుమెంట్లు, అదనపు మోడల్ కాల్స్ అవసరం కావచ్చు.
పునరావృతమయ్యే మోడల్ అభ్యర్థనలతో సహా, పూర్తయిన ప్రతి ఇంటరాక్షన్ సగటున 6,000 ఇన్పుట్ టోకెన్లను, 1,000 అవుట్పుట్ టోకెన్లను వినియోగిస్తుందని అనుకుందాం.
ఆ అంచనాల ఆధారంగా TechiesJournal చేసిన లెక్క ప్రకారం, నెలవారీ వర్క్లోడ్ 132 మిలియన్ ఇన్పుట్ టోకెన్లు, 22 మిలియన్ అవుట్పుట్ టోకెన్లు అవుతుంది.
ప్రచురించిన స్టాండర్డ్ API రేట్లను ఉపయోగిస్తే, మోడల్ ఇన్ఫరెన్స్ ఖర్చులు ఇలా ఉంటాయి:
| హోస్టెడ్ మోడల్ | అంచనా నెలవారీ ఖర్చు (USD) |
|---|---|
| GPT-6 Luna | $24.20 |
| GPT-6.1 Sol | $484 |
| Claude Sonnet 5.5 | $484 |
| Claude Fable 5.2 | $1,936 |
ఒకే టోకెన్ సంఖ్యలతో చేసిన ఉదాహరణాత్మక లెక్క. రిట్రీవల్ ఇన్ఫ్రాస్ట్రక్చర్, చెల్లింపు టూల్స్, ప్రీమియం ప్రాసెసింగ్, కాషింగ్ డిస్కౌంట్లు, మానవ సమీక్ష ఇందులో లేవు. ఇది ప్రొవైడర్ల మధ్య సమానమైన మోడల్ నాణ్యతను గానీ, వాస్తవ టోకెన్ వినియోగాన్ని గానీ నిర్ధారించదు. రేట్లు నవంబర్ 11, 2026న చదివిన స్టాండర్డ్-టియర్ రేట్లు. ప్రతి ఇంటరాక్షన్ 272,000 ఇన్పుట్ టోకెన్ల పరిమితి కంటే చాలా తక్కువగానే ఉంటుందని భావించాం, ఆ పరిమితి దాటితే OpenAI ప్రాంప్ట్లకు ఎక్కువ ధర వసూలు చేస్తుంది. Anthropic, Claude Sonnet 5.5, Claude Fable 5.2 లకు వాటి పూర్తి 1M-టోకెన్ కాంటెక్స్ట్ విండో అంతటా స్టాండర్డ్ రేట్లకే బిల్ చేస్తుంది.
మూలాలు: OpenAI API ధరలు, Anthropic API ధరలు.
మొదటి పరిశీలన ముఖ్యమైనది. మోడల్ను బట్టి, అదే ఊహించిన వర్క్లోడ్ చాలా భిన్నమైన బిల్లును తీసుకురాగలదు.
కానీ ఈ పట్టిక అంతర్గత ఏజెంట్ కోసం ఉత్తమ మోడళ్ల ర్యాంకింగ్ కాదు.
తక్కువ ఖర్చు మోడల్ సూటిగా ఉండే పాలసీ ప్రశ్నలకు తగినంతగా సమాధానం ఇవ్వగలిగినా, సంక్లిష్టమైన ఇన్సిడెంట్ దర్యాప్తులలో ఇబ్బంది పడవచ్చు. బలమైన మోడల్ మరింత నమ్మదగిన ఫలితాలను ఇవ్వవచ్చు, కానీ ఎక్కువ ధరకు. వేర్వేరు టోకెనైజర్లు, రీజనింగ్ ప్రవర్తన, టూల్ వినియోగ పద్ధతులు కూడా వాస్తవ టోకెన్ వినియోగాన్ని మార్చగలవు.
అసలు ప్రశ్న ఏమిటంటే, మోడల్ అప్లికేషన్ ఆమోద అవసరాలను (acceptance requirements) తీరుస్తుందా లేదా అనేది.
ఈ అంతర్గత అసిస్టెంట్ కోసం, ఆ అవసరాలలో ఉద్యోగి చూడటానికి అనుమతి ఉన్న సమాచారాన్ని తీసుకురావడం, తీసుకువచ్చిన డాక్యుమెంట్ల ఆధారంగా ఉన్న సమాధానాలను ఇవ్వడం, లేని సమాచారాన్ని అంగీకరించడం, ఆమోదయోగ్యమైన సమయంలో స్పందించడం ఉండవచ్చు.
యాక్సెస్ అమలు అప్లికేషన్లోనూ, రిట్రీవల్ సిస్టమ్లలోనూ ఉండాలి. డాక్యుమెంట్ అనుమతులను గౌరవించమని సూచనలు చెబుతున్నాయన్న కారణంతోనే లాంగ్వేజ్ మోడల్ వాటిని అమలు చేస్తుందని ఆశించకూడదు.
తక్కువ ఖర్చు హోస్టెడ్ మోడల్ నిలకడగా అవసరాలను తీరుస్తుంటే, సొంత ఇన్ఫరెన్స్ ఇన్ఫ్రాస్ట్రక్చర్ను నడపడానికి కంపెనీకి ఆర్థిక కారణం పెద్దగా ఉండకపోవచ్చు.
మరింత కష్టమైన ప్రశ్నలను ఒక బలమైన హోస్టెడ్ మోడల్కు రూట్ చేయవచ్చు కూడా, అయితే రూటింగ్ దానికంటూ సొంత ఖర్చు, నాణ్యత పరిగణనలను తెస్తుంది.
సంస్థ తన హోస్టింగ్ ఏర్పాటును మార్చకముందే, మోడల్ ఎంపిక ఆర్థిక లెక్కలను గణనీయంగా మార్చగలదు.
మోడల్ను ప్రైవేట్గా నడపడానికి అయ్యే ఖర్చు
అద్దెకు తీసుకున్న GPU పై ఒక ఓపెన్-వెయిట్ మోడల్ను నడపాలని కంపెనీ ఆలోచిస్తోందని అనుకుందాం.
ప్రధానంగా టోకెన్ వినియోగం ప్రకారం చెల్లించే బదులు, అది అందుబాటులో ఉంచుకునే GPU కెపాసిటీకి చెల్లిస్తుంది.
Runpod ప్రచురించిన Secure Cloud ఆన్-డిమాండ్ Pod రేట్లు ఉపయోగకరమైన ప్రామాణిక సూచికగా పనిచేస్తాయి:
| GPU (VRAM) | Secure Cloud రేటు, 720 గంటలకు నెలవారీ ఖర్చు |
|---|---|
| NVIDIA L4 (24 GB) | గంటకు $0.59, నెలకు $425 |
| NVIDIA L40S (48 GB) | గంటకు $1.09, నెలకు $785 |
| NVIDIA A100 (80 GB) | గంటకు $1.79, నెలకు $1,289 |
| NVIDIA H100 PCIe (80 GB) | గంటకు $2.89, నెలకు $2,081 |
USD, రౌండ్ చేసిన విలువలు. ఉదాహరణాత్మక నిరంతర అద్దె ఖర్చులు, పూర్తి ప్రొడక్షన్ ఇన్ఫరెన్స్ ఖర్చులు కావు. స్టోరేజ్, నెట్వర్కింగ్, లభ్యత కోసం అదనపు కెపాసిటీ, ఆపరేషన్స్ ఇందులో లేవు. ప్రొవైడర్ ధరలు, లభ్యత మారవచ్చు. Runpod వీటిలో కొన్ని GPUలకు తక్కువ Community Cloud రేట్లను కూడా చూపిస్తుంది, ఉదాహరణకు ఒక L40S కు గంటకు $0.79, అంటే నెలకు సుమారు $569.
మూలం: Runpod GPU ధరలు.
నిరంతరం నడిచే ఒక L40S కు Secure Cloud రేటులో, సహాయక ఖర్చులకు ముందే, నెలకు సుమారు $785 ఖర్చవుతుంది. ఇది Claude Sonnet 5.5 కోసం ఉదాహరణాత్మకంగా లెక్కించిన నెలకు $484 API బిల్లు కంటే ఎక్కువ.
హోస్టెడ్ ఇన్ఫరెన్స్ చౌకైనదని నిర్ధారించాలనిపించవచ్చు. కానీ ఆ నిర్ధారణలో ఒక సమస్య ఉంది.
$484 అనేది ఒక నిర్దిష్ట హోస్టెడ్ మోడల్కు పంపిన నిర్ణీత పరిమాణం టోకెన్లకు లెక్కించిన చార్జీ. $785 అనేది హార్డ్వేర్ అద్దె. ఆ GPU పై ఏ ఓపెన్-వెయిట్ మోడల్ నడవగలదో, అది ఎన్ని అభ్యర్థనలను ప్రాసెస్ చేయగలదో, దాని సమాధానాలు Sonnet నాణ్యతకు సరిపోతాయో లేదో ఈ సంఖ్య స్వయంగా ఏమీ చెప్పదు.
ఇవి సమానమైన సర్వీస్ కొటేషన్లు కావు.
వాటిని న్యాయంగా పోల్చడానికి, కంపెనీ ఒక ప్రైవేట్ మోడల్ను ఎంచుకోవాలి, అదే వర్క్లోడ్పై దాని సమాధానాలను మూల్యాంకనం చేయాలి, అవసరమైన స్పందన సమయంలోపు GPU ఎంత ఆమోదిత పనిని పూర్తి చేస్తుందో కొలవాలి.
అప్పుడు మాత్రమే అది విజయవంతమైన ఒక్కో ఇంటరాక్షన్కు అయ్యే వాస్తవ ఖర్చును లెక్కించగలదు.
అంతర్గత అసిస్టెంట్ పని గంటల్లో బిజీగా ఉండి, రాత్రివేళ దాదాపు ఖాళీగా ఉండవచ్చు. నిరంతరం నడిచే GPU ఆ ఖాళీ గంటల్లోనూ ఖర్చు పెంచుతుంది. వర్కర్లను ఆపేస్తే స్టార్టప్, లభ్యత పరమైన రాజీలు (trade-offs) వస్తాయి.
బ్యాచ్ ప్రాసెసింగ్ సిస్టమ్ ఆ పరిస్థితులకు సర్దుకుపోవచ్చు. వెంటనే సమాధానం ఇవ్వాలని ఆశించే ఇంటరాక్టివ్ అసిస్టెంట్ సర్దుకుపోలేకపోవచ్చు.
ప్రైవేట్ ఇన్ఫరెన్స్ ఆర్థిక ప్రయోజనం, కంపెనీ తాను చెల్లించే కెపాసిటీని ఎంత సమర్థంగా వాడుకుంటుందనే దానిపై ఆధారపడి ఉంటుంది.
ఇన్ఫరెన్స్ను సొంతం చేసుకోవడం ద్వారా కంపెనీ పొందేది
ఖర్చుల పోలిక, మోడల్ను ప్రైవేట్గా నడపడానికి ఉన్న బలమైన కారణాలలో కొన్నింటిని విస్మరిస్తుంది.
సెల్ఫ్-మేనేజ్డ్ ఇన్ఫరెన్స్తో, మోడల్ను ఎప్పుడు అప్గ్రేడ్ చేయాలో కంపెనీ నియంత్రించగలదు, ఎంచుకున్న వెర్షన్ను అలాగే ఉంచుకోగలదు, నిర్దిష్ట ఆపరేషనల్ అవసరాల కోసం సర్వింగ్ వాతావరణాన్ని కాన్ఫిగర్ చేయగలదు.
నియంత్రిత రిలీజ్ ప్రక్రియ అంతటా అప్లికేషన్కు పునరావృతమయ్యే ఒకే రకమైన ప్రవర్తన అవసరమైనప్పుడు అది ముఖ్యం కావచ్చు.
సున్నితమైన ప్రాంప్ట్లను, డాక్యుమెంట్లను బయటి మోడల్ సర్వీస్కు పంపాల్సిన అవసరాన్ని కూడా ప్రైవేట్ ఇన్ఫరెన్స్ తగ్గించగలదు.
కానీ మోడల్ను లోకల్గా నడపడం వల్ల మొత్తం అప్లికేషన్ ఆటోమేటిక్గా ప్రైవేట్ అయిపోదు.
అంతర్గత అసిస్టెంట్ ఇప్పటికీ డాక్యుమెంట్లను తీసుకువస్తుంది, ప్రాంప్ట్లను నిర్మిస్తుంది, లాగ్లు రాస్తుంది, మానిటరింగ్ సిస్టమ్లను వాడుతుంది. వీటిలో ఏ భాగమైనా గోప్యమైన సమాచారాన్ని వేరే చోటికి పంపితే, లోకల్గా నడిచే మోడల్ పూర్తి డేటా సరిహద్దును మూసివేయదు.
మేనేజ్డ్ మోడల్ సర్వీస్లు కూడా ఎంటర్ప్రైజ్ డేటా రక్షణలను అందించగలవు. Microsoft Foundry డాక్యుమెంటేషన్ మోడల్ ప్రొవైడర్ యాక్సెస్ను, ట్రైనింగ్ కోసం వినియోగాన్ని, ప్రాసెసింగ్ స్థానం, స్టోరేజ్ నుంచి వేరు చేసి చూపిస్తుంది. ఈ రెండోవి డిప్లాయ్మెంట్ రకాన్ని, ఫీచర్లను బట్టి మారవచ్చు. అదే పేజీ దుర్వినియోగ పర్యవేక్షణ (abuse monitoring) గురించి వివరిస్తుంది: కస్టమర్కు సవరించిన దుర్వినియోగ పర్యవేక్షణ (modified abuse monitoring) కోసం ఆమోదం లభించి ఉంటే తప్ప, ఒక ఆటోమేటెడ్ సిస్టమ్ ఫ్లాగ్ చేసిన ప్రాంప్ట్లు, కంప్లీషన్ల నమూనాలను తీసి అధికారం ఉన్న Microsoft సిబ్బంది సమీక్షించవచ్చు, ఆ డేటా కస్టమర్ భౌగోళిక ప్రాంతంలోనే నిల్వ అవుతుంది. Global, DataZone డిప్లాయ్మెంట్లు రిసోర్స్ భౌగోళిక ప్రాంతం వెలుపల కూడా డేటాను ప్రాసెస్ చేయవచ్చు. ఇతర ప్రొవైడర్ల నిబంధనలు వేరుగా ఉంటాయి, కాబట్టి నిర్దిష్ట డిప్లాయ్మెంట్ నిబంధనలను సంస్థ సరిహద్దు అవసరంతో పోల్చి చదవాలి.
అంతర్గత డాక్యుమెంట్లను నిర్వచించిన, కంపెనీ నియంత్రణలోని వాతావరణంలో మాత్రమే ప్రాసెస్ చేయాల్సి ఉంటే, ప్రైవేట్ ఇన్ఫరెన్స్ అవసరం కావచ్చు. ఆమోదించిన మేనేజ్డ్ సర్వీస్ ఆ అవసరాన్ని తీరిస్తే, సెల్ఫ్-హోస్టింగ్ దాని ఆపరేటింగ్ భారంతో పోలిస్తే అదనంగా ఇచ్చే సెక్యూరిటీ విలువ తక్కువే కావచ్చు.
ప్రైవసీ అనేది మొత్తం అప్లికేషన్, డేటా ప్రవాహానికి సంబంధించిన లక్షణం, మోడల్ ఎండ్పాయింట్కు అతికించే లేబుల్ కాదు.
కోడింగ్ ఏజెంట్ ఆర్థిక చిత్రాన్ని మారుస్తుంది
ఇప్పుడు AI కోడింగ్ ఏజెంట్లను వాడుతున్న ఒక సాఫ్ట్వేర్ టీమ్ను పరిగణించండి. ఏజెంట్లు రిపోజిటరీ ఫైళ్లను చదువుతాయి, ఇష్యూలను దర్యాప్తు చేస్తాయి, కోడ్ను మారుస్తాయి, టెస్ట్లను నడుపుతాయి, సమీక్ష కోసం మార్పులను సిద్ధం చేస్తాయి.
ఇది అంతర్గత డాక్యుమెంటేషన్ను తీసుకురావడం కంటే భిన్నమైనది. ఒక కోడింగ్ ఏజెంట్ సమస్యను గుర్తించే ముందు అనేక ఫైళ్లను పరిశీలించవచ్చు. దాని మొదటి ప్యాచ్ టెస్ట్లలో విఫలం కావచ్చు. ఆ తర్వాత అది లాగ్లను విశ్లేషించి, ఇంప్లిమెంటేషన్ను సవరించి, మరిన్ని టూల్స్ను పిలవవచ్చు.
పది మంది డెవలపర్లు 22 పని దినాల పాటు, ప్రతి పని దినం నాలుగు కోడింగ్ టాస్క్లను అప్పగిస్తారని అనుకుందాం, దీనివల్ల నెలకు 880 టాస్క్లు వస్తాయి.
ఒక మధ్యస్థ టాస్క్ కోసం, మొత్తం వర్క్ఫ్లో 100,000 ఇన్పుట్ టోకెన్లు, 20,000 అవుట్పుట్ టోకెన్లు వినియోగిస్తుందని భావిద్దాం. భారీ టాస్క్ కోసం, 500,000 ఇన్పుట్ టోకెన్లు, 50,000 అవుట్పుట్ టోకెన్లు అని భావిద్దాం.
| హోస్టెడ్ మోడల్ | మధ్యస్థ టాస్క్లు/నెల | భారీ టాస్క్లు/నెల |
|---|---|---|
| Claude Sonnet 5.5 | $352 | $1,320 |
| Claude Fable 5.2 | $1,408 | $5,280 |
| GPT-6.1 Sol | $352 | $1,320 |
880 టాస్క్లకు USD, స్టాండర్డ్ రేట్ల అంకగణితం. ఇంటరాక్షన్ టోకెన్లన్నీ జాబితాలోని స్టాండర్డ్ టియర్లలోనే బిల్ అవుతాయని భావించాం. భారీ కేసు అనేక కాల్స్ అంతటా ఉన్న మొత్తం, ఒకే 500K-టోకెన్ ప్రాంప్ట్ కాదు. కాషింగ్, చెల్లింపు టూల్స్, ఎగ్జిక్యూషన్ వాతావరణాలు, సమీక్ష ఖర్చులు ఇందులో లేవు. మోడల్ నాణ్యత, వాస్తవ వినియోగం వేరుగా ఉండవచ్చు. రేట్లు నవంబర్ 11, 2026న చదివిన స్టాండర్డ్-టియర్ రేట్లు.
మూలాలు: Anthropic API ధరలు, OpenAI API ధరలు.
కాషింగ్ ఈ మొత్తాలను గణనీయంగా మార్చగలదు. Claude Sonnet 5.5 కోసం బేస్ ఇన్పుట్కు మిలియన్ టోకెన్లకు $2 కాగా, కాష్ హిట్లకు Anthropic $0.10 బిల్ చేస్తుంది. OpenAI కూడా GPT-6.1 Sol కోసం కాష్ చేసిన ఇన్పుట్ ధరను $2 కు బదులు $0.10 గా చూపిస్తుంది. కోడింగ్ ఏజెంట్లు తమ కాంటెక్స్ట్లో చాలా భాగాన్ని కాల్స్ మధ్య మళ్లీ పంపుతాయి, కాబట్టి హోస్టెడ్ బిల్లు పై గణాంకాల కంటే చాలా తక్కువగా ఉండవచ్చు. ఒక ఊహాజనిత సున్నితత్వ విశ్లేషణగా (sensitivity), భారీ కేసులోని 440 మిలియన్ ఇన్పుట్ టోకెన్లలో 80% కాష్ హిట్లు అయితే, Claude Sonnet 5.5 మొత్తం, కాష్-రైట్ చార్జీలకు ముందు, $1,320 నుంచి సుమారు $651 కు తగ్గుతుంది. అది TechiesJournal చేసిన లెక్క, గమనించిన ఫలితం కాదు.
భారీ స్థాయి వద్ద, పునరావృత మోడల్ చార్జీలు గణనీయమైనవిగా మారతాయి. అది ప్రైవేట్ ఇన్ఫరెన్స్ను పరిశీలించదగినదిగా చేస్తుంది, కానీ ఆటోమేటిక్గా డిప్లాయ్ చేయదగినదిగా కాదు.
కోడ్ను జనరేట్ చేసే ఖర్చు, ఆమోదించిన సాఫ్ట్వేర్ మార్పును తయారుచేసే ఖర్చు ఒకటి కాదు.
ఒక చౌక మోడల్ పదేపదే టెస్ట్లలో విఫలమై డెవలపర్ సరిదిద్దాల్సిన ప్యాచ్లను ఇస్తుంటే అది ఖరీదైనదిగా మారవచ్చు. మరింత ఖరీదైన మోడల్ తక్కువ రీట్రైలతో కష్టమైన పనిని పూర్తి చేయవచ్చు, అయితే ఆ ప్రయోజనాన్ని ఊహించడం కాకుండా కొలవాలి.
కోడింగ్ ఏజెంట్ల కోసం, నేను మోడల్ చార్జీలతో పాటు విజయవంతమైన టాస్క్ పూర్తి, పట్టిన సమయం, మానవ సవరణను కొలుస్తాను.
అదే కోడింగ్ పనికి ఓపెన్-వెయిట్ మోడల్ సామర్థ్యం
ఓపెన్-వెయిట్ మోడళ్లు కోడింగ్, ఏజెంటిక్ టాస్క్లకు నమ్మదగిన అభ్యర్థులు, కానీ ఒక నిర్దిష్ట కంపెనీలో వాటిలో ఒకటి హోస్టెడ్ మోడల్ స్థానాన్ని భర్తీ చేయగలదని పబ్లిక్ లీడర్బోర్డ్ నిర్ధారించదు.
పబ్లిక్ కోడ్ రిపోజిటరీలలోని ఇష్యూలపై ఏజెంట్లను మూల్యాంకనం చేసే SWE-bench Verified ఒక సాధారణ ప్రామాణిక సూచికగా మారింది. అయితే సెప్టెంబర్ 2026లో, కంటామినేషన్, స్కోరింగ్ సమస్యలను పేర్కొంటూ Epoch AI ఆ బెంచ్మార్క్ను లోపభూయిష్టమైనదిగా వర్గీకరించింది.
ఒక మోడల్ స్కోర్ ఏజెంట్ హార్నెస్, ప్రాంప్ట్లు, టూల్స్, ఎగ్జిక్యూషన్ కాన్ఫిగరేషన్పై కూడా ఆధారపడవచ్చు. ఒక పబ్లిక్ బెంచ్మార్క్ ఒక కంపెనీ ప్రైవేట్ రిపోజిటరీలను, డిపెండెన్సీలను, టెస్ట్లను, ఆమోద ప్రమాణాలను పునరుత్పత్తి చేయదు.
మెరుగైన పోలికలో హోస్టెడ్, ప్రైవేట్ అభ్యర్థులు రెండింటికీ సమానమైన అంతర్గత టాస్క్ల ప్రాతినిధ్య సమితిని ఇస్తారు. టీమ్ బగ్ ఫిక్స్లు, టెస్ట్ జనరేషన్, డిపెండెన్సీ అప్గ్రేడ్లు, అనేక ఫైళ్లకు విస్తరించే మార్పులను పరిశీలిస్తుంది.
ప్రతి టాస్క్ కోసం, టెస్ట్లు పాస్ అయ్యాయా, మార్పు అభ్యర్థనను తీర్చిందా, ఎన్ని ప్రయత్నాలు అవసరమయ్యాయి, ఎంత సమయం పట్టింది, ఇంకా ఎంత డెవలపర్ సవరణ మిగిలింది అనేవి టీమ్ నమోదు చేయాలి.
ప్రత్యేక ఇన్ఫరెన్స్ హార్డ్వేర్ను నడపడానికి డబ్బు ఖర్చు చేయాలా అనేది నిర్ణయం అయినప్పుడు, హెడ్లైన్ బెంచ్మార్క్ శాతం కంటే ఆ ఆధారాలు ఎక్కువ ముఖ్యం.
ఎంచుకున్న మోడలే హార్డ్వేర్ బిల్లును నిర్ణయిస్తుంది
ముందుగా సామర్థ్యాన్ని మూల్యాంకనం చేయడానికి ఒక కారణం, వేర్వేరు ఓపెన్-వెయిట్ మోడళ్లు చాలా వేర్వేరు సర్వింగ్ అవసరాలను విధిస్తాయి.
Qwen3.5-27B తన మోడల్ కార్డ్లో 27 బిలియన్ పారామీటర్ల లాంగ్వేజ్ మోడల్గా వర్ణించబడింది. ఒక్కో పారామీటర్కు నాలుగు బిట్ల వద్ద, సైద్ధాంతిక వెయిట్ పేలోడ్ మెటాడేటా, రన్టైమ్ ఓవర్హెడ్కు ముందు సుమారు 13.5 GB ఉంటుంది. 48 GB GPU పై తగిన క్వాంటైజ్డ్ డిప్లాయ్మెంట్ మూల్యాంకనం చేయదగినదే, కానీ దాని కాంటెక్స్ట్ పొడవు, కాంకరెన్సీ, వాస్తవ థ్రూపుట్ ఇంకా పరీక్షించాల్సి ఉంది. కార్డ్ సొంత సర్వింగ్ ఉదాహరణలు ఎనిమిది GPUల టెన్సర్ పారలలిజమ్ను వాడతాయి, వీలైనచోట కనీసం 128K టోకెన్ల కాంటెక్స్ట్ను ఉంచమని సలహా ఇస్తాయి. మెమరీ ప్లానింగ్ కేవలం వెయిట్లను దాటి ఎంత త్వరగా విస్తరిస్తుందో ఇది చూపిస్తుంది.
GLM-5.3-Flash సుమారు 321 బిలియన్ మొత్తం పారామీటర్లు, ఒక్కో టోకెన్కు 18 బిలియన్ యాక్టివ్ పారామీటర్లతో mixture-of-experts ఆర్కిటెక్చర్ను వాడుతుంది. చిన్న యాక్టివ్ సంఖ్య కొంత కంప్యూటేషన్ను తగ్గిస్తుంది, కానీ మోడల్ వెయిట్లను నిల్వ చేసి యాక్సెస్ చేయాల్సిన అవసరాన్ని తొలగించదు. ఓపెన్-వెయిట్ మోడళ్ల గురించి, mixture of experts కంప్యూట్కు సహాయపడినా స్టోరేజ్కు ఎందుకు సహాయపడదనే దాని గురించి TechiesJournal ఇంతకుముందు ఇచ్చిన వివరణ, మరో మూడు మోడళ్ల విషయంలో ఇదే తేడాను వివరిస్తుంది.
దాని డాక్యుమెంట్ చేసిన డిఫాల్ట్ FP8 చెక్పాయింట్కు రన్టైమ్, KV-cache ఓవర్హెడ్కు ముందు సుమారు 306 GiB వెయిట్ స్టోరేజ్ అవసరం, ప్రచురించిన రెసిపీ డిఫాల్ట్ కాన్ఫిగరేషన్ ఎనిమిది H200 GPUలను వాడుతుంది, ఈ కాన్ఫిగరేషన్ ధరను పై Runpod పట్టిక చూపించదు. అదే రెసిపీ, FP8 వెయిట్ మెమరీకి సుమారు రెట్టింపు అవసరమయ్యే BF16 చెక్పాయింట్ను, NVIDIA Blackwell GPUలు అవసరమయ్యే 4-బిట్ NVFP4 చెక్పాయింట్ను కూడా జాబితా చేస్తుంది.
ఆ డిఫాల్ట్ చెక్పాయింట్ ఒక్క L40S పై సరిపోదు. శక్తిమంతమైన ఓపెన్-వెయిట్ కోడింగ్ మోడల్ పట్ల ఆకర్షితమైన కంపెనీ, తన మొదటి స్ప్రెడ్షీట్లో వాడిన GPU కంటే అవసరమైన ప్రైవేట్ ఇన్ఫ్రాస్ట్రక్చర్ చాలా ఖరీదైనదని తెలుసుకోవచ్చు.
ఓపెన్ వెయిట్లు డిప్లాయ్మెంట్ స్వేచ్ఛను ఇస్తాయి, కానీ అందుబాటు ధరలో డిప్లాయ్మెంట్కు హామీ ఇవ్వవు.
అనేక ఏజెంట్లతో ఇన్ఫరెన్స్పై పెరిగే భారం
కోడింగ్ ఏజెంట్ దృశ్యం కాంకరెన్సీని కూడా పరీక్షిస్తుంది.
మోడల్ సర్వింగ్ రన్టైమ్ వేర్వేరు కాంటెక్స్ట్ పొడవులు, అవుట్పుట్ పరిమాణాలు ఉన్న అభ్యర్థనలను నిర్వహించాలి. సాంప్రదాయ ఆటోరిగ్రెసివ్ ట్రాన్స్ఫార్మర్లలో, ఇన్పుట్ను ప్రాసెస్ చేయడాన్ని తరచుగా prefill అని, ఆ తర్వాత జరిగే టోకెన్ జనరేషన్ను decoding అని వర్ణిస్తారు.
రన్టైమ్ మళ్లీ వాడదగిన అటెన్షన్ స్థితిని నిర్వహిస్తుంది, దీనిని key-value cache లేదా KV cache అంటారు. పొడవైన కాంటెక్స్ట్లు, అనేక యాక్టివ్ ఏజెంట్లు ఆ స్థితి కోసం అవసరమైన మెమరీని పెంచుతాయి.
vLLM వంటి సర్వింగ్ సిస్టమ్లు GPU వినియోగాన్ని మెరుగుపరచడానికి షెడ్యూలింగ్, బ్యాచింగ్ పద్ధతులను వాడతాయి. కానీ అందుబాటులో ఉన్న మెమరీ, కంప్యూటేషన్ పరిమితంగానే ఉంటాయి. ప్రొడక్షన్ కోసం AI ఇన్ఫరెన్స్ ఇంజిన్ను ఎంచుకోవడంపై TechiesJournal గైడ్ సర్వింగ్ ఇంజిన్లను మరింత వివరంగా పోలుస్తుంది. డిమాండ్ కెపాసిటీని మించినప్పుడు క్యూలు, నెమ్మదైన స్పందనలు ఏర్పడతాయి.
ఇది ముఖ్యంగా బహుళ దశల కోడింగ్ ఏజెంట్లకు ముఖ్యం. ఆలస్యమైన ప్రతి స్పందన తదుపరి టూల్ కాల్ను, టెస్ట్ను లేదా సవరణను వాయిదా వేయగలదు.
కాబట్టి కంపెనీ కేవలం ఒకే అభ్యర్థన టోకెన్ జనరేషన్ వేగాన్ని కాకుండా, వాస్తవిక ఏకకాల డిమాండ్ కింద టాస్క్ మొదటి నుంచి చివరి వరకు పూర్తి కావడానికి పట్టే సమయాన్ని కొలవాలి.
హోస్టెడ్ సర్వీస్లు కస్టమర్ల కోసం సర్వింగ్ ఇన్ఫ్రాస్ట్రక్చర్లో చాలా భాగాన్ని నడుపుతాయి, అదే సమయంలో పరిమితులను విధిస్తాయి, ప్రొవైడర్పై ఆధారపడటాన్ని తెస్తాయి. సెల్ఫ్-మేనేజ్డ్ ఇన్ఫరెన్స్ కెపాసిటీపై ప్రత్యక్ష నియంత్రణను ఇస్తుంది, కానీ ఆ కెపాసిటీని రూపొందించడం, పర్యవేక్షించడం, పునరుద్ధరించడం కంపెనీయే చేయాలి.
ఆ ఆపరేషనల్ తేడా ఖర్చుల పోలికలో భాగం కావాలి.
బ్రేక్-ఈవెన్ పాయింట్ స్థానం
భారీ కోడింగ్ ఉదాహరణలో, Claude Sonnet 5.5 నెలకు $1,320 ఉదాహరణాత్మక మోడల్ బిల్లును ఇస్తుంది. నిరంతరం అద్దెకు తీసుకున్న ఒక L40S ఖర్చు సుమారు $785.
ఈ అంతరం ఆశాజనకంగా కనిపిస్తుంది, కానీ అది పొదుపుకు రుజువు కాదు, అది ఎంత వరకు తగ్గవచ్చో పైన చూపిన కాషింగ్ సున్నితత్వ విశ్లేషణ చూపిస్తుంది. అవే ఆమోదిత ఫలితాలను సాధించడానికి ప్రైవేట్ డిప్లాయ్మెంట్కు పెద్ద మోడల్, మరిన్ని GPUలు, మరింత ఆపరేషన్స్ సపోర్ట్ లేదా మరిన్ని రీట్రైలు అవసరం కావచ్చు.
పోలిక ఒక ఉమ్మడి కొలమానాన్ని వాడాలి:
ఆమోదించిన ఒక్కో టాస్క్కు ఖర్చు = మొత్తం సంబంధిత ఆపరేటింగ్ ఖర్చు ÷ పూర్తయిన ఆమోదిత టాస్క్లు
హోస్టెడ్ ఇన్ఫరెన్స్ కోసం, మొత్తం ఖర్చులో మోడల్ వినియోగం, సంబంధిత టూల్ చార్జీలు, చుట్టూ ఉన్న అప్లికేషన్, సమీక్ష పని ఉంటాయి. సెల్ఫ్-మేనేజ్డ్ ఇన్ఫరెన్స్ కోసం, ఇందులో GPUలు లేదా హార్డ్వేర్, స్టోరేజ్, నెట్వర్కింగ్, రిడండెన్సీ, ఆపరేషనల్ సపోర్ట్, పోల్చదగిన మానవ సవరణ ఉంటాయి.
AI ధరలు టోకెన్ ధరల నుంచి ఒక్కో టాస్క్కు అయ్యే ఖర్చు వైపు ఎలా మారుతున్నాయి అనే TechiesJournal మునుపటి కథనం, ఈ కొలమానంలో చేర్చాల్సిన రీట్రైలు, కాషింగ్, సమీక్ష ఖర్చులను వివరిస్తుంది.
రెండు విధానాలనూ ఒకే విజయ ప్రమాణాలు, ప్రైవసీ అవసరాలు, స్పందన సమయ అంచనాల ఆధారంగా మూల్యాంకనం చేయాలి.
ఊహించదగిన టాస్క్లను అధిక వినియోగంతో నిర్వహించే ప్రైవేట్ మోడల్ పొదుపుగా ఉండవచ్చు. ఖరీదైన హార్డ్వేర్ అవసరమై, అనిశ్చిత ఫలితాలను ఇచ్చే మరొకటి అలా ఉండకపోవచ్చు.
వేర్వేరు వర్క్లోడ్లకు వేర్వేరు మోడల్ సామర్థ్యాలు అవసరమైనప్పుడు, రూటింగ్ కంపెనీ డేటా పాలసీకి లోబడి ఉంటే, హైబ్రిడ్ విధానం అర్థవంతంగా ఉంటుంది. ఆమోదించిన ప్రైవేట్ మోడల్ బిజీగా ఉందన్న కారణంతో ఒక గోప్యమైన అభ్యర్థనను అనధికార క్లౌడ్ ఎండ్పాయింట్కు పంపకూడదు.
ఉపయోగకరమైన ప్రశ్న ఏమిటంటే, అప్లికేషన్ పరిమితులను పాటిస్తూనే, అతి తక్కువ నిలకడైన ఖర్చుతో ఆమోదిత ఫలితాన్ని ఏ ఏర్పాటు అందిస్తుంది అనేది.
ఈ వర్క్లోడ్ల కోసం నా ఎంపిక
అంతర్గత నాలెడ్జ్ అసిస్టెంట్ కోసం, నేను కంపెనీ ఖచ్చితత్వం, ప్రైవసీ, లేటెన్సీ అవసరాలతో పోల్చి తగిన మేనేజ్డ్ మోడల్ను మూల్యాంకనం చేయడంతో మొదలుపెడతాను. ఉదాహరణాత్మక API చార్జీలు మాత్రమే ప్రత్యేక GPU కెపాసిటీని నిర్వహించడాన్ని సమర్థించవు.
ప్రైవేట్ ఇన్ఫరెన్స్ ఒక ప్రాసెసింగ్ సరిహద్దు అవసరాన్ని తీర్చినప్పుడు, లేదా నిరంతర ట్రాఫిక్లో స్పష్టమైన ఆపరేటింగ్ ప్రయోజనాన్ని చూపినప్పుడు ఆకర్షణీయంగా మారుతుంది.
కోడింగ్ ఏజెంట్ కోసం, మోడల్ ఖర్చులు, వినియోగం గణనీయంగా పెరిగిన తర్వాత నేను ప్రైవేట్ ఇన్ఫరెన్స్ను మరింత తీవ్రంగా పరిశీలిస్తాను. కానీ తక్కువ GPU రేటును పొదుపుగా పరిగణించే ముందు, కోడింగ్ టాస్క్ విజయాన్ని, మానవ సవరణను నేను పరీక్షిస్తాను.
ఆధారాలు హోస్టెడ్ మోడల్కు, సెల్ఫ్-మేనేజ్డ్ మోడల్కు లేదా రెండింటి కలయికకు మద్దతు ఇవ్వవచ్చు. అది నిర్ణయించలేకపోవడం కాదు. ఈ వర్క్లోడ్లకు వేర్వేరు సామర్థ్య, ఇన్ఫ్రాస్ట్రక్చర్, సెక్యూరిటీ అవసరాలు ఉన్నాయన్న వాస్తవం నుంచే అది వస్తుంది.
ప్రయోజనం నియంత్రణే, కానీ నియంత్రణ విలువను సృష్టించాలి
ఓపెన్-వెయిట్ మోడళ్లు సంస్థలకు మోడల్ వెర్షన్లను అలాగే ఉంచుకోవడానికి, నిర్వచించిన ప్రాసెసింగ్ వాతావరణాల్లో పనిచేయడానికి, తగిన అధిక పరిమాణ పనికి ఆర్థిక లెక్కలను మెరుగుపరచుకునే అవకాశానికి వీలు కల్పిస్తాయి.
ఆ ప్రయోజనాలు నిజమైనవి. కెపాసిటీ, మెమరీ, కాంకరెన్సీ, విశ్వసనీయత, అప్గ్రేడ్లు, సెక్యూరిటీ కోసం పెరిగే అదనపు బాధ్యతలు కూడా అంతే నిజం.
నిరాడంబరమైన హోస్టెడ్ మోడల్ చార్జీలు ప్రైవేట్ GPU కోసం వ్యాపార కారణాన్ని ఎందుకు బలహీనపరచగలవో అంతర్గత నాలెడ్జ్ ఏజెంట్ వివరిస్తుంది. నిరంతర, ఖరీదైన ఇంటరాక్షన్లు ప్రైవేట్ ఇన్ఫరెన్స్ను ఎందుకు మూల్యాంకనం చేయదగినదిగా చేస్తాయో కోడింగ్ ఏజెంట్ చూపిస్తుంది, అదే సమయంలో మోడల్ సామర్థ్య, హార్డ్వేర్ పరిమితులను కూడా బయటపెడుతుంది.
ఒక సంస్థ AI ఇన్ఫరెన్స్ను సొంతం చేసుకోవాలి, ఆ యాజమాన్యం తన వర్క్లోడ్కు నిజంగా అవసరమైన, తాను నిలకడగా నడపగల ఒక సామర్థ్యాన్ని, ప్రైవసీ సరిహద్దును లేదా ఆర్థిక ప్రయోజనాన్ని అందించినప్పుడు.
లక్ష్యం మరింత ఇన్ఫ్రాస్ట్రక్చర్ను సొంతం చేసుకోవడం కాదు. సరైన స్థాయి నియంత్రణతో మెరుగైన ఫలితాలను అందించడమే.
మూలాలు, మరింత చదవడానికి
- OpenAI API ధరలు
- Anthropic API ధరలు
- Runpod GPU క్లౌడ్ ధరలు
- Microsoft Foundry డేటా ప్రైవసీ
- Qwen3.5-27B మోడల్ కార్డ్
- GLM-5.3-Flash vLLM డిప్లాయ్మెంట్ రెసిపీ
- vLLM డాక్యుమెంటేషన్
- SWE-bench Verified పై Epoch AI సమీక్ష
పరిశోధన తేదీ: నవంబర్ 11, 2026. అన్ని వర్క్లోడ్ పరిమాణాలు, నెలవారీ ఖర్చులు, ఉదాహరణలు ఉదాహరణాత్మక లెక్కలు మాత్రమే, గమనించిన ప్రొడక్షన్ ఫలితాలు కావు. ధరలు, మోడల్ అవసరాలు మారుతుంటాయి, కాబట్టి వాటిపై ఆధారపడే ముందు ప్రస్తుత గణాంకాలను సరిచూసుకోండి. ప్రత్యక్ష డిప్లాయ్మెంట్ అనుభవం గానీ, హోస్టెడ్, ప్రైవేట్ మధ్య సరిపోల్చిన బెంచ్మార్క్ గానీ ఉన్నట్టు ఇక్కడ పేర్కొనడం లేదు.