

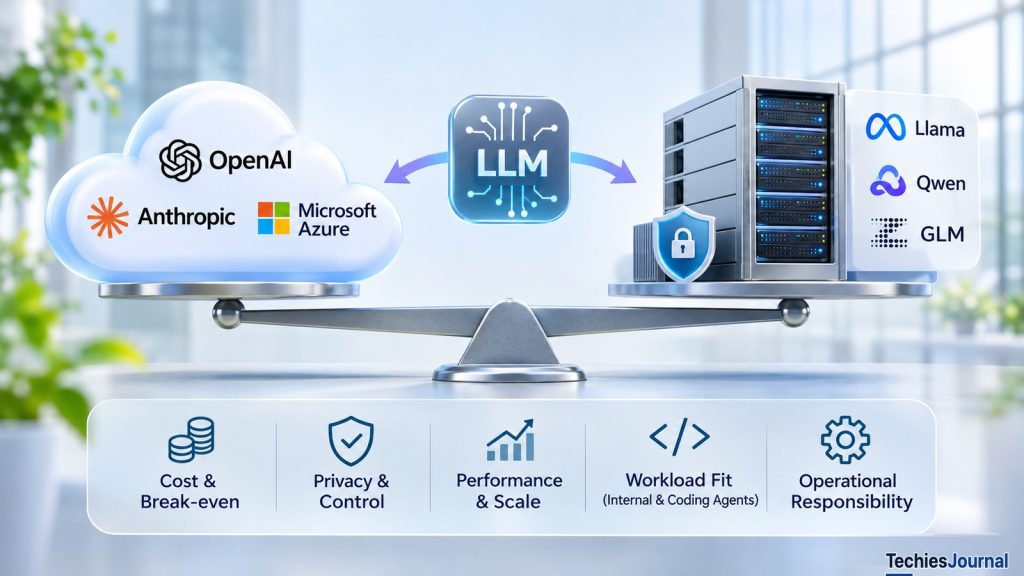
ओपन-वेट लैंग्वेज मॉडल को निजी इन्फ्रास्ट्रक्चर पर चलाना डेटा, मॉडल के व्यवहार और संचालन लागत पर ज़्यादा नियंत्रण का वादा करता है। लेकिन किसी कंपनी को असल में कितना फ़ायदा होता है? दो व्यावहारिक वर्कलोड, एक आंतरिक नॉलेज एजेंट और एक AI कोडिंग एजेंट, दिखाते हैं कि मॉडल कहाँ चलता है, इससे ज़्यादा अहम हैं मॉडल की क्षमता, इन्फ्रास्ट्रक्चर की लागत और वह काम जो किया जा रहा है।
एक कंपनी अपने कर्मचारियों के लिए एक AI असिस्टेंट लाना चाहती है। असिस्टेंट को आंतरिक दस्तावेज़ खोजने, ट्रबलशूटिंग प्रक्रियाएँ समझाने, इंसिडेंट का सार देने और रोज़मर्रा की समस्याएँ सुलझाने में कर्मचारियों की मदद करनी है।
इंजीनियरिंग टीम के सामने एक विकल्प है। वह API के ज़रिए एक होस्टेड मॉडल इस्तेमाल कर सकती है और कर्मचारी जितना इस्तेमाल करें, उसके हिसाब से इन्फरेंस का भुगतान कर सकती है। या वह कंपनी के नियंत्रण वाले इन्फ्रास्ट्रक्चर पर एक ओपन-वेट मॉडल डिप्लॉय कर सकती है।
दूसरा विकल्प आकर्षक लगता है। संवेदनशील जानकारी एक स्वीकृत निजी वातावरण के भीतर रह सकती है। टीम मॉडल के खास संस्करण बनाए रख सकती है, इन्फरेंस सेटिंग्स बदल सकती है और किसी व्यावसायिक मॉडल API पर पूरी तरह निर्भर रहने से बच सकती है।
इसके साथ एक वित्तीय तर्क भी है। जब कंपनी अपने GPU खुद चला सकती है, तो टोकन के लिए भुगतान क्यों करते रहें?
इन्फ्रास्ट्रक्चर इंजीनियरिंग के नज़रिए से, किसी भी हार्डवेयर खर्च को मंज़ूरी देने से पहले मैं इस सवाल को चुनौती दूँगा।
यह सवाल मान लेता है कि एक GPU और एक API सब्सक्रिप्शन बराबर इंटेलिजेंस देते हैं। ऐसा नहीं है। GPU कंप्यूटेशन और मेमोरी देता है। कंपनी को फिर भी ऐसा मॉडल चाहिए जो उसका काम पूरा कर सके, ऐसा रनटाइम चाहिए जो अनुरोधों को कुशलता से सर्व करे और ऐसे इंजीनियर चाहिए जो सिस्टम को चला सकें।
फ़ैसले की शुरुआत इस बात से होनी चाहिए कि एप्लिकेशन को क्या हासिल करना है, इससे नहीं कि कंपनी कितने सस्ते में GPU किराए पर ले सकती है।
यह फ़र्क़ तब और साफ़ होता है जब हम बहुत अलग ज़रूरतों वाले दो एप्लिकेशन देखते हैं।
एक आंतरिक नॉलेज एजेंट उम्मीद से कम खर्चीला हो सकता है
मान लीजिए एक कंपनी में 100 कर्मचारी हैं। हर कर्मचारी 22 कार्यदिवसों तक हर कार्यदिवस एक आंतरिक AI एजेंट से दस सवाल पूछता है।
इससे हर महीने 22,000 इंटरैक्शन बनते हैं।
असिस्टेंट कंपनी के दस्तावेज़ों से जानकारी निकालता है, प्रासंगिक सामग्री का सार बनाता है और जवाब तैयार करता है। कुछ सवालों के लिए छोटी व्याख्या काफ़ी हो सकती है, जबकि कुछ में कई दस्तावेज़ और अतिरिक्त मॉडल कॉल शामिल होते हैं।
मान लीजिए हर पूरा हुआ इंटरैक्शन औसतन 6,000 इनपुट टोकन और 1,000 आउटपुट टोकन इस्तेमाल करता है, जिसमें दोहराए गए मॉडल अनुरोध भी शामिल हैं।
इन मान्यताओं पर TechiesJournal की गणना में मासिक वर्कलोड 132 मिलियन इनपुट टोकन और 22 मिलियन आउटपुट टोकन बनता है।
प्रकाशित मानक API दरों के हिसाब से मॉडल इन्फरेंस की लागत यह होगी:
| होस्टेड मॉडल | अनुमानित मासिक लागत (USD) |
|---|---|
| GPT-6 Luna | $24.20 |
| GPT-6.1 Sol | $484 |
| Claude Sonnet 5.5 | $484 |
| Claude Fable 5.2 | $1,936 |
एक जैसी टोकन संख्या पर आधारित उदाहरणात्मक गणना। इसमें रिट्रीवल इन्फ्रास्ट्रक्चर, सशुल्क टूल, प्रीमियम प्रोसेसिंग, कैशिंग छूट और मानवीय समीक्षा शामिल नहीं हैं। यह न तो बराबर मॉडल गुणवत्ता स्थापित करती है, न ही प्रोवाइडरों के बीच वास्तविक टोकन उपयोग। दरें 11 नवंबर 2026 को पढ़ी गई स्टैंडर्ड-टियर दरें हैं। माना गया है कि हर इंटरैक्शन 272,000 इनपुट टोकन की उस सीमा से बहुत नीचे रहता है जिसके ऊपर OpenAI प्रॉम्प्ट की ऊँची कीमत लेता है, और Anthropic, Claude Sonnet 5.5 और Claude Fable 5.2 का बिल उनकी पूरी 1M-टोकन कॉन्टेक्स्ट विंडो पर स्टैंडर्ड दरों से बनाता है।
स्रोत: OpenAI API की कीमतें और Anthropic API की कीमतें।
पहला अवलोकन अहम है। मॉडल के हिसाब से, एक ही मान लिया गया वर्कलोड बहुत अलग बिल बना सकता है।
लेकिन यह तालिका आंतरिक एजेंट के लिए सबसे अच्छे मॉडलों की रैंकिंग नहीं है।
कम लागत वाला मॉडल सीधे-सादे नीति संबंधी सवालों का ठीक-ठाक जवाब दे सकता है, फिर भी जटिल इंसिडेंट जाँच में जूझ सकता है। ज़्यादा सक्षम मॉडल ज़्यादा भरोसेमंद नतीजे दे सकता है, लेकिन ऊँची कीमत पर। अलग-अलग टोकनाइज़र, रीज़निंग का व्यवहार और टूल इस्तेमाल करने के पैटर्न भी वास्तविक टोकन खपत बदल सकते हैं।
असली सवाल यह है कि क्या मॉडल एप्लिकेशन की स्वीकृति शर्तें पूरी करता है।
इस आंतरिक असिस्टेंट के लिए इन शर्तों में ये बातें शामिल हो सकती हैं: केवल वही जानकारी निकालना जिसे देखने का कर्मचारी को अधिकार है, निकाले गए दस्तावेज़ों से समर्थित जवाब देना, जानकारी न होने पर उसे स्वीकार करना और स्वीकार्य समय में जवाब देना।
एक्सेस नियंत्रण लागू करने का काम एप्लिकेशन और रिट्रीवल सिस्टम में ही रहना चाहिए। किसी लैंग्वेज मॉडल से यह उम्मीद नहीं करनी चाहिए कि वह दस्तावेज़ अनुमतियाँ सिर्फ़ इसलिए लागू करेगा कि उसके निर्देश उनका सम्मान करने को कहते हैं।
अगर कम लागत वाला होस्टेड मॉडल लगातार इन शर्तों को पूरा करता है, तो कंपनी के पास अपना इन्फरेंस इन्फ्रास्ट्रक्चर चलाने का वित्तीय कारण शायद ही बचे।
वह ज़्यादा कठिन सवालों को किसी ज़्यादा सक्षम होस्टेड मॉडल की ओर रूट भी कर सकती है, हालाँकि रूटिंग के साथ लागत और गुणवत्ता से जुड़े अपने सवाल आते हैं।
संगठन अपनी होस्टिंग व्यवस्था बदले, उससे पहले ही मॉडल का चुनाव अर्थशास्त्र को काफ़ी बदल सकता है।
मॉडल को निजी तौर पर चलाने की लागत
मान लीजिए कंपनी किराए के GPU पर एक ओपन-वेट मॉडल चलाने पर विचार करती है।
मुख्य रूप से टोकन उपयोग के हिसाब से भुगतान करने के बजाय, वह उस GPU क्षमता के लिए भुगतान करती है जिसे वह उपलब्ध रखती है।
Runpod की प्रकाशित Secure Cloud ऑन-डिमांड Pod दरें एक उपयोगी संदर्भ देती हैं:
| GPU (VRAM) | Secure Cloud दर और 720 घंटे पर मासिक लागत |
|---|---|
| NVIDIA L4 (24 GB) | $0.59 प्रति घंटा, $425 प्रति माह |
| NVIDIA L40S (48 GB) | $1.09 प्रति घंटा, $785 प्रति माह |
| NVIDIA A100 (80 GB) | $1.79 प्रति घंटा, $1,289 प्रति माह |
| NVIDIA H100 PCIe (80 GB) | $2.89 प्रति घंटा, $2,081 प्रति माह |
USD, राउंड किए गए आँकड़े। लगातार किराए की उदाहरणात्मक लागत, प्रोडक्शन इन्फरेंस की पूरी लागत नहीं। स्टोरेज, नेटवर्किंग, उपलब्धता के लिए अतिरिक्त क्षमता और संचालन शामिल नहीं हैं। प्रोवाइडर की कीमतें और उपलब्धता बदल सकती हैं। Runpod इनमें से कुछ GPU के लिए कम Community Cloud दरें भी सूचीबद्ध करता है, उदाहरण के लिए L40S के लिए $0.79 प्रति घंटा, यानी लगभग $569 प्रति माह।
स्रोत: Runpod GPU की कीमतें।
लगातार चलने वाले एक L40S की लागत Secure Cloud दर पर, सहायक खर्चों से पहले, लगभग $785 प्रति माह है। यह Claude Sonnet 5.5 के उदाहरणात्मक $484 मासिक API बिल से ज़्यादा है।
यह निष्कर्ष निकालना लुभावना होगा कि होस्टेड इन्फरेंस सस्ता है। लेकिन इस निष्कर्ष में एक समस्या है।
$484 किसी खास होस्टेड मॉडल को भेजे गए टोकनों की तय मात्रा के लिए गणना किया गया शुल्क है। $785 हार्डवेयर का किराया है। यह अपने आप में हमें कुछ नहीं बताता कि उस GPU पर कौन-सा ओपन-वेट मॉडल चल सकता है, वह कितने अनुरोध प्रोसेस कर सकता है या उसके जवाब Sonnet की गुणवत्ता के बराबर हैं या नहीं।
ये बराबर सेवा कोटेशन नहीं हैं।
इनकी निष्पक्ष तुलना करने के लिए कंपनी को एक निजी मॉडल चुनना होगा, उसी वर्कलोड पर उसके जवाबों का मूल्यांकन करना होगा और मापना होगा कि ज़रूरी रिस्पॉन्स टाइम के भीतर GPU कितना स्वीकृत काम पूरा करता है।
तभी वह हर सफल इंटरैक्शन की प्रभावी लागत निकाल सकती है।
आंतरिक असिस्टेंट कामकाजी घंटों में व्यस्त और रात में लगभग खाली रह सकता है। लगातार चलने वाला GPU उन खाली घंटों में भी पैसा खर्च करता है। वर्करों को बंद करने से स्टार्टअप और उपलब्धता से जुड़े समझौते करने पड़ते हैं।
बैच-प्रोसेसिंग सिस्टम इन स्थितियों के साथ तालमेल बिठा सकता है। तुरंत जवाब देने की अपेक्षा वाला इंटरैक्टिव असिस्टेंट शायद नहीं।
निजी इन्फरेंस का आर्थिक फ़ायदा इस पर निर्भर करता है कि कंपनी जिस क्षमता के लिए भुगतान करती है, उसका कितना प्रभावी इस्तेमाल करती है।
इन्फरेंस का स्वामित्व रखने से कंपनी को क्या मिलता है
लागत की तुलना मॉडल को निजी तौर पर चलाने के कुछ सबसे मज़बूत कारणों को नज़रअंदाज़ कर देती है।
सेल्फ़-मैनेज्ड इन्फरेंस के साथ कंपनी तय कर सकती है कि मॉडल कब अपग्रेड हो, किसी चुने हुए संस्करण को बनाए रख सकती है और खास संचालन ज़रूरतों के लिए सर्विंग वातावरण कॉन्फ़िगर कर सकती है।
यह तब मायने रख सकता है जब एप्लिकेशन को नियंत्रित रिलीज़ प्रक्रिया में दोहराया जा सकने वाला व्यवहार चाहिए।
निजी इन्फरेंस संवेदनशील प्रॉम्प्ट और दस्तावेज़ों को किसी बाहरी मॉडल सेवा पर भेजने की ज़रूरत भी कम कर सकता है।
लेकिन मॉडल को लोकल रूप से चलाने से पूरा एप्लिकेशन अपने आप निजी नहीं हो जाता।
आंतरिक असिस्टेंट फिर भी दस्तावेज़ निकालता है, प्रॉम्प्ट बनाता है, लॉग लिखता है और मॉनिटरिंग सिस्टम इस्तेमाल करता है। अगर इनमें से कोई भी घटक गोपनीय जानकारी कहीं और भेजता है, तो लोकल रूप से चलने वाला मॉडल पूरी डेटा सीमा को बंद नहीं करता।
मैनेज्ड मॉडल सेवाएँ भी एंटरप्राइज़ डेटा सुरक्षा दे सकती हैं। Microsoft का Foundry दस्तावेज़ीकरण मॉडल प्रोवाइडर के एक्सेस और ट्रेनिंग में उपयोग को प्रोसेसिंग के स्थान और स्टोरेज से अलग करता है, जो डिप्लॉयमेंट के प्रकार और फ़ीचर के हिसाब से बदल सकते हैं। वही पेज दुरुपयोग निगरानी (abuse monitoring) का वर्णन करता है: जिन प्रॉम्प्ट और कंप्लीशन को कोई स्वचालित सिस्टम फ़्लैग करता है, उनके नमूने लेकर अधिकृत Microsoft कर्मचारी उनकी समीक्षा कर सकते हैं, और डेटा ग्राहक के भौगोलिक क्षेत्र में संग्रहीत रहता है, जब तक ग्राहक को संशोधित दुरुपयोग निगरानी की मंज़ूरी न मिली हो। Global और DataZone डिप्लॉयमेंट रिसोर्स के भौगोलिक क्षेत्र से बाहर भी डेटा प्रोसेस कर सकते हैं। दूसरे प्रोवाइडरों की शर्तें अलग होती हैं, इसलिए संबंधित डिप्लॉयमेंट की शर्तों को संगठन की सीमा संबंधी ज़रूरत के साथ मिलाकर पढ़ना होगा।
अगर आंतरिक दस्तावेज़ों को केवल कंपनी के नियंत्रण वाले एक परिभाषित वातावरण के भीतर ही प्रोसेस किया जाना है, तो निजी इन्फरेंस ज़रूरी हो सकता है। अगर कोई स्वीकृत मैनेज्ड सेवा यह ज़रूरत पूरी करती है, तो सेल्फ़-होस्टिंग अपने संचालन बोझ की तुलना में सुरक्षा में बहुत कम मूल्य जोड़ सकती है।
गोपनीयता पूरे एप्लिकेशन और डेटा प्रवाह का गुण है, मॉडल एंडपॉइंट पर लगाया गया लेबल नहीं।
कोडिंग एजेंट आर्थिक तस्वीर बदल देता है
अब एक सॉफ़्टवेयर टीम पर विचार करें जो AI कोडिंग एजेंट इस्तेमाल करती है। एजेंट रिपॉज़िटरी की फ़ाइलें पढ़ते हैं, समस्याओं की जाँच करते हैं, कोड बदलते हैं, टेस्ट चलाते हैं और समीक्षा के लिए बदलाव तैयार करते हैं।
यह आंतरिक दस्तावेज़ निकालने से अलग है। कोई कोडिंग एजेंट समस्या पहचानने से पहले कई फ़ाइलें देख सकता है। उसका पहला पैच टेस्ट में फ़ेल हो सकता है। फिर वह लॉग का विश्लेषण कर सकता है, इम्प्लीमेंटेशन में संशोधन कर सकता है और अतिरिक्त टूल चला सकता है।
मान लीजिए दस डेवलपर 22 दिनों तक हर कार्यदिवस चार कोडिंग टास्क सौंपते हैं, जिससे हर महीने 880 टास्क बनते हैं।
मध्यम टास्क के लिए मान लीजिए कि पूरा वर्कफ़्लो 100,000 इनपुट टोकन और 20,000 आउटपुट टोकन इस्तेमाल करता है। भारी टास्क के लिए 500,000 इनपुट टोकन और 50,000 आउटपुट टोकन मान लीजिए।
| होस्टेड मॉडल | मध्यम टास्क/माह | भारी टास्क/माह |
|---|---|---|
| Claude Sonnet 5.5 | $352 | $1,320 |
| Claude Fable 5.2 | $1,408 | $5,280 |
| GPT-6.1 Sol | $352 | $1,320 |
880 टास्क के लिए USD, स्टैंडर्ड दरों पर अंकगणित। माना गया है कि इंटरैक्शन के सभी टोकन सूचीबद्ध स्टैंडर्ड टियर पर बिल होते हैं। भारी मामला कई कॉल का कुल योग है, कोई अकेला 500K-टोकन प्रॉम्प्ट नहीं। कैशिंग, सशुल्क टूल, एक्ज़ीक्यूशन वातावरण और समीक्षा की लागत शामिल नहीं हैं। मॉडल की गुणवत्ता और वास्तविक उपयोग अलग हो सकते हैं। दरें 11 नवंबर 2026 को पढ़ी गई स्टैंडर्ड-टियर दरें हैं।
स्रोत: Anthropic API की कीमतें और OpenAI API की कीमतें।
कैशिंग इन कुल राशियों को काफ़ी बदल सकती है। Anthropic, Claude Sonnet 5.5 के कैश हिट के लिए बेस इनपुट के $2 के मुकाबले $0.10 प्रति मिलियन टोकन बिल करता है, और OpenAI, GPT-6.1 Sol के कैश्ड इनपुट के लिए $2 के मुकाबले $0.10 सूचीबद्ध करता है। कोडिंग एजेंट कॉल के बीच अपने कॉन्टेक्स्ट का बड़ा हिस्सा दोबारा भेजते हैं, इसलिए होस्टेड बिल ऊपर दिए आँकड़ों से काफ़ी नीचे रह सकता है। एक काल्पनिक संवेदनशीलता के रूप में, अगर भारी मामले के 440 मिलियन इनपुट टोकन में से 80% कैश हिट हों, तो किसी भी कैश-राइट शुल्क से पहले Claude Sonnet 5.5 का कुल बिल $1,320 से घटकर लगभग $651 रह जाएगा। यह TechiesJournal की गणना है, कोई देखा गया नतीजा नहीं।
भारी छोर पर बार-बार लगने वाले मॉडल शुल्क अहम हो जाते हैं। इससे निजी इन्फरेंस जाँचने लायक बनता है, लेकिन अपने आप डिप्लॉय करने लायक नहीं।
कोड जनरेट करने की लागत, स्वीकृत सॉफ़्टवेयर बदलाव तैयार करने की लागत नहीं है।
एक सस्ता मॉडल तब महँगा पड़ सकता है जब वह बार-बार ऐसे पैच बनाता है जो टेस्ट में फ़ेल होते हैं और जिन्हें डेवलपर को सुधारना पड़ता है। एक महँगा मॉडल कम रीट्राई के साथ कठिन काम पूरा कर सकता है, हालाँकि इस बढ़त को मानकर नहीं चलना चाहिए, बल्कि मापना चाहिए।
कोडिंग एजेंट के लिए मैं मॉडल शुल्क के साथ-साथ टास्क की सफल पूर्णता, लगा हुआ समय और मानवीय सुधार को मापूँगा।
ओपन-वेट मॉडल वही कोडिंग काम संभाल सकता है या नहीं
ओपन-वेट मॉडल कोडिंग और एजेंटिक कामों के लिए विश्वसनीय उम्मीदवार हैं, लेकिन कोई सार्वजनिक लीडरबोर्ड यह स्थापित नहीं करता कि कोई मॉडल किसी खास कंपनी में होस्टेड मॉडल की जगह ले सकता है।
SWE-bench Verified, जो सार्वजनिक कोड रिपॉज़िटरी की समस्याओं पर एजेंटों का मूल्यांकन करता है, एक आम संदर्भ बिंदु बन गया। लेकिन सितंबर 2026 में Epoch AI ने इस बेंचमार्क को त्रुटिपूर्ण (flawed) की श्रेणी में रखा, और इसकी वजह कंटैमिनेशन और स्कोरिंग से जुड़ी समस्याएँ बताईं।
किसी मॉडल का स्कोर एजेंट हार्नेस, प्रॉम्प्ट, टूल और एक्ज़ीक्यूशन कॉन्फ़िगरेशन पर भी निर्भर कर सकता है। कोई सार्वजनिक बेंचमार्क किसी कंपनी की निजी रिपॉज़िटरी, डिपेंडेंसी, टेस्ट या स्वीकृति मानकों को दोहराता नहीं है।
बेहतर तुलना यह होगी कि होस्टेड और निजी दोनों उम्मीदवारों को बराबर आंतरिक टास्क का एक प्रतिनिधि सेट दिया जाए। टीम बग फ़िक्स, टेस्ट जनरेशन, डिपेंडेंसी अपग्रेड और कई फ़ाइलों में फैले बदलावों की जाँच करेगी।
हर टास्क के लिए टीम को दर्ज करना चाहिए कि टेस्ट पास हुए या नहीं, बदलाव ने अनुरोध पूरा किया या नहीं, कितने प्रयास लगे, कितना समय लगा और डेवलपर को कितना सुधार करना बाकी रहा।
जब फ़ैसला यह हो कि समर्पित इन्फरेंस हार्डवेयर चलाने पर पैसा खर्च किया जाए या नहीं, तब यह सबूत किसी सुर्ख़ियों वाले बेंचमार्क प्रतिशत से ज़्यादा मायने रखता है।
चुना गया मॉडल हार्डवेयर का बिल तय करता है
क्षमता का मूल्यांकन पहले करने का एक कारण यह है कि अलग-अलग ओपन-वेट मॉडल सर्विंग की बहुत अलग ज़रूरतें लेकर आते हैं।
Qwen3.5-27B को उसके मॉडल कार्ड में 27 बिलियन पैरामीटर वाले लैंग्वेज मॉडल के रूप में बताया गया है। प्रति पैरामीटर चार बिट पर, मेटाडेटा और रनटाइम ओवरहेड से पहले, वेट का सैद्धांतिक आकार लगभग 13.5 GB होता है। 48 GB GPU पर एक उपयुक्त क्वांटाइज़्ड डिप्लॉयमेंट मूल्यांकन लायक है, लेकिन उसकी कॉन्टेक्स्ट लंबाई, कॉनकरेंसी और वास्तविक थ्रूपुट की जाँच अभी बाकी है। कार्ड के अपने सर्विंग उदाहरण आठ GPU पर टेंसर पैरेललिज़्म इस्तेमाल करते हैं और जहाँ संभव हो कम से कम 128K टोकन का कॉन्टेक्स्ट रखने की सलाह देते हैं, जिससे पता चलता है कि मेमोरी प्लानिंग कितनी जल्दी सिर्फ़ वेट से आगे निकल जाती है।
GLM-5.3-Flash मिक्सचर-ऑफ़-एक्सपर्ट्स आर्किटेक्चर इस्तेमाल करता है, जिसमें लगभग 321 बिलियन कुल पैरामीटर हैं और प्रति टोकन 18 बिलियन सक्रिय रहते हैं। छोटी सक्रिय संख्या कुछ कंप्यूटेशन घटाती है, लेकिन मॉडल वेट को स्टोर करने और एक्सेस करने की ज़रूरत खत्म नहीं करती। TechiesJournal का पहले का लेख, ओपन-वेट मॉडल और मिक्सचर ऑफ़ एक्सपर्ट्स कंप्यूट में क्यों मदद करता है पर स्टोरेज में नहीं, यही फ़र्क़ तीन दूसरे मॉडलों के लिए समझाता है।
इसके दस्तावेज़ित डिफ़ॉल्ट FP8 चेकपॉइंट को रनटाइम और KV-cache ओवरहेड से पहले लगभग 306 GiB वेट स्टोरेज चाहिए, और प्रकाशित रेसिपी का डिफ़ॉल्ट कॉन्फ़िगरेशन आठ H200 GPU इस्तेमाल करता है, एक ऐसा कॉन्फ़िगरेशन जिसकी कीमत ऊपर की Runpod तालिका में नहीं दी गई है। वही रेसिपी एक BF16 चेकपॉइंट सूचीबद्ध करती है जिसे FP8 वेट मेमोरी से लगभग दोगुनी मेमोरी चाहिए, और एक 4-बिट NVFP4 चेकपॉइंट भी, जिसके लिए NVIDIA Blackwell GPU ज़रूरी हैं।
वह डिफ़ॉल्ट चेकपॉइंट एक L40S पर फ़िट नहीं हो सकता। किसी शक्तिशाली ओपन-वेट कोडिंग मॉडल से आकर्षित कंपनी यह पा सकती है कि ज़रूरी निजी इन्फ्रास्ट्रक्चर उसकी पहली स्प्रेडशीट में इस्तेमाल किए गए GPU से कहीं ज़्यादा महँगा है।
ओपन-वेट मॉडल डिप्लॉयमेंट की आज़ादी देते हैं, लेकिन किफ़ायती डिप्लॉयमेंट की गारंटी नहीं देते।
कई एजेंट इन्फरेंस को और कठिन क्यों बना देते हैं
कोडिंग-एजेंट परिदृश्य कॉनकरेंसी की भी परीक्षा लेता है।
मॉडल-सर्विंग रनटाइम को अलग-अलग कॉन्टेक्स्ट लंबाई और आउटपुट आकार वाले अनुरोध संभालने होते हैं। पारंपरिक ऑटोरिग्रेसिव ट्रांसफ़ॉर्मर में इनपुट को प्रोसेस करने के चरण को अक्सर prefill कहा जाता है, जिसके बाद decode चरण में टोकन जनरेट होते हैं।
रनटाइम दोबारा इस्तेमाल होने वाली अटेंशन स्थिति (state) बनाए रखता है, जिसे की-वैल्यू कैश (key-value cache), या KV cache कहा जाता है। लंबे कॉन्टेक्स्ट और कई सक्रिय एजेंट उस स्थिति के लिए ज़रूरी मेमोरी बढ़ा देते हैं।
vLLM जैसे सर्विंग सिस्टम GPU उपयोग सुधारने के लिए शेड्यूलिंग और बैचिंग तकनीकें इस्तेमाल करते हैं। लेकिन उपलब्ध मेमोरी और कंप्यूटेशन सीमित ही रहते हैं। TechiesJournal की गाइड प्रोडक्शन के लिए AI इन्फरेंस इंजन चुनना सर्विंग इंजनों की ज़्यादा विस्तार से तुलना करती है। जब माँग क्षमता से ज़्यादा हो जाती है, तो कतारें लगती हैं और जवाब धीमे हो जाते हैं।
यह बहु-चरणीय कोडिंग एजेंटों के लिए खास तौर पर मायने रखता है। हर देर से आया जवाब अगली टूल कॉल, टेस्ट या सुधार को टाल सकता है।
इसलिए कंपनी को सिर्फ़ एक अनुरोध की टोकन जनरेशन गति नहीं, बल्कि वास्तविक समवर्ती माँग के तहत टास्क पूरा होने का शुरू से अंत तक का समय मापना चाहिए।
होस्टेड सेवाएँ ग्राहकों के लिए सर्विंग इन्फ्रास्ट्रक्चर का बड़ा हिस्सा चलाती हैं, हालाँकि वे सीमाएँ भी लगाती हैं और प्रोवाइडर पर निर्भरता भी लाती हैं। सेल्फ़-मैनेज्ड इन्फरेंस क्षमता पर सीधा नियंत्रण देता है, लेकिन कंपनी को उस क्षमता को खुद डिज़ाइन करना, मॉनिटर करना और बहाल करना पड़ता है।
संचालन का यह फ़र्क़ लागत की तुलना में शामिल होना चाहिए।
ब्रेक-ईवन बिंदु कहाँ है
भारी कोडिंग उदाहरण में Claude Sonnet 5.5 का उदाहरणात्मक मॉडल बिल $1,320 प्रति माह बनता है। लगातार किराए पर लिया गया एक L40S लगभग $785 का पड़ता है।
यह अंतर आशाजनक लगता है, लेकिन यह बचत का सबूत नहीं है, और ऊपर की कैशिंग संवेदनशीलता दिखाती है कि यह कितना घट सकता है। निजी डिप्लॉयमेंट को वही स्वीकृत नतीजे पाने के लिए बड़े मॉडल, ज़्यादा GPU, ज़्यादा संचालन सहायता या ज़्यादा रीट्राई की ज़रूरत पड़ सकती है।
तुलना में एक साझा माप इस्तेमाल होना चाहिए:
प्रति स्वीकृत टास्क लागत = कुल प्रासंगिक संचालन लागत ÷ पूरे किए गए स्वीकृत टास्क
होस्टेड इन्फरेंस के लिए कुल लागत में मॉडल उपयोग, प्रासंगिक टूल शुल्क और आसपास का एप्लिकेशन व समीक्षा का काम शामिल है। सेल्फ़-मैनेज्ड इन्फरेंस के लिए इसमें GPU या हार्डवेयर, स्टोरेज, नेटवर्किंग, रिडंडेंसी, संचालन सहायता और तुलनीय मानवीय सुधार शामिल हैं।
TechiesJournal का पहले का लेख, AI की कीमतें टोकन दरों से प्रति टास्क लागत की ओर कैसे बढ़ रही हैं, उन रीट्राई, कैशिंग और समीक्षा लागतों को समझाता है जिन्हें इस माप में शामिल करना ज़रूरी है।
दोनों तरीकों का मूल्यांकन एक जैसे सफलता मानदंडों, गोपनीयता ज़रूरतों और रिस्पॉन्स टाइम की अपेक्षाओं पर होना चाहिए।
ऊँचे उपयोग पर पूर्वानुमेय टास्क संभालने वाला निजी मॉडल किफ़ायती हो सकता है। महँगे हार्डवेयर की ज़रूरत वाला और अनिश्चित नतीजे देने वाला कोई दूसरा मॉडल शायद नहीं।
जब अलग-अलग वर्कलोड को अलग-अलग मॉडल क्षमताएँ चाहिए, तब हाइब्रिड तरीका समझदारी भरा हो सकता है, बशर्ते रूटिंग कंपनी की डेटा नीति से बंधी हो। किसी गोपनीय अनुरोध को सिर्फ़ इसलिए किसी अनधिकृत क्लाउड एंडपॉइंट पर नहीं भेजा जा सकता कि स्वीकृत निजी मॉडल व्यस्त है।
उपयोगी सवाल यह है कि कौन-सी व्यवस्था एप्लिकेशन की बाधाओं को पूरा करते हुए सबसे कम टिकाऊ लागत पर स्वीकृत नतीजा देती है।
इन वर्कलोड के लिए मैं क्या चुनूँगा
आंतरिक नॉलेज असिस्टेंट के लिए मैं शुरुआत किसी उपयुक्त मैनेज्ड मॉडल को कंपनी की सटीकता, गोपनीयता और लेटेंसी ज़रूरतों पर परखकर करूँगा। उदाहरणात्मक API शुल्क अपने आप में समर्पित GPU क्षमता बनाए रखने को उचित नहीं ठहराते।
निजी इन्फरेंस तब आकर्षक बनता है जब वह प्रोसेसिंग-सीमा की किसी ज़रूरत को पूरा करता है या लगातार ट्रैफ़िक में संचालन का स्पष्ट फ़ायदा दिखाता है।
कोडिंग एजेंट के लिए, जब मॉडल खर्च और उपयोग काफ़ी बढ़ जाएँ, तब मैं निजी इन्फरेंस की ज़्यादा गंभीरता से जाँच करूँगा। लेकिन कम GPU दर को बचत मानने से पहले मैं कोडिंग टास्क की सफलता और मानवीय सुधार को परखूँगा।
सबूत किसी होस्टेड मॉडल, किसी सेल्फ़-मैनेज्ड मॉडल या दोनों के मेल का समर्थन कर सकते हैं। यह अनिर्णय नहीं है। यह इस तथ्य से निकलता है कि इन वर्कलोड की क्षमता, इन्फ्रास्ट्रक्चर और सुरक्षा ज़रूरतें अलग-अलग हैं।
फ़ायदा नियंत्रण है, लेकिन नियंत्रण से मूल्य बनना चाहिए
ओपन-वेट मॉडल संगठनों को मॉडल संस्करण बनाए रखने, परिभाषित प्रोसेसिंग वातावरण के भीतर काम करने और उपयुक्त बड़े पैमाने के काम के लिए अर्थशास्त्र को संभवतः बेहतर बनाने की सुविधा देते हैं।
ये फ़ायदे असली हैं। उतनी ही असली हैं क्षमता, मेमोरी, कॉनकरेंसी, विश्वसनीयता, अपग्रेड और सुरक्षा की अतिरिक्त ज़िम्मेदारियाँ।
आंतरिक नॉलेज एजेंट दिखाता है कि मामूली होस्टेड-मॉडल शुल्क निजी GPU के बिज़नेस केस को क्यों कमज़ोर कर सकते हैं। कोडिंग एजेंट दिखाता है कि लगातार, महँगे इंटरैक्शन निजी इन्फरेंस को मूल्यांकन लायक क्यों बना सकते हैं, और साथ ही मॉडल की क्षमता और हार्डवेयर की सीमाएँ भी उजागर करता है।
किसी संगठन को AI इन्फरेंस का स्वामित्व तब रखना चाहिए जब वह स्वामित्व ऐसी क्षमता, गोपनीयता सीमा या आर्थिक फ़ायदा दे जिसकी उसके वर्कलोड को सचमुच ज़रूरत है और जिसे वह टिकाऊ ढंग से चला सकता है।
लक्ष्य ज़्यादा इन्फ्रास्ट्रक्चर का मालिक बनना नहीं है। लक्ष्य सही स्तर के नियंत्रण के साथ बेहतर नतीजे देना है।
स्रोत और आगे पढ़ने के लिए
- OpenAI API की कीमतें
- Anthropic API की कीमतें
- Runpod GPU क्लाउड की कीमतें
- Microsoft Foundry डेटा गोपनीयता
- Qwen3.5-27B मॉडल कार्ड
- GLM-5.3-Flash vLLM डिप्लॉयमेंट रेसिपी
- vLLM दस्तावेज़ीकरण
- SWE-bench Verified की Epoch AI समीक्षा
शोध की तारीख: 11 नवंबर 2026। सभी वर्कलोड मात्राएँ, मासिक लागत और उदाहरण उदाहरणात्मक गणनाएँ हैं, प्रोडक्शन में देखे गए नतीजे नहीं। कीमतें और मॉडल की ज़रूरतें बदलती रहती हैं, इसलिए इन पर भरोसा करने से पहले मौजूदा आँकड़े जाँच लें। किसी प्रत्यक्ष डिप्लॉयमेंट या मिलान किए गए होस्टेड-बनाम-निजी बेंचमार्क का दावा नहीं किया गया है।