

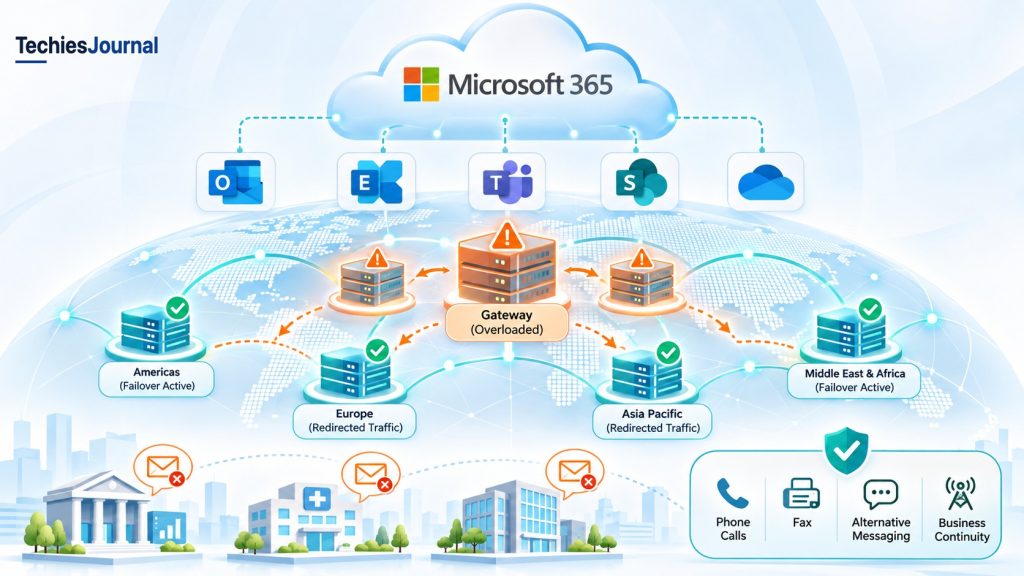
La panne de Microsoft 365 de novembre 2026 a perturbé la messagerie dans le monde entier pendant près de 24 heures. L’enquête préliminaire de Microsoft explique comment un ancien défaut logiciel, un changement de trafic et une capacité de serveurs réduite se sont combinés pour provoquer des défaillances généralisées.
Le jeudi 12 novembre, des employés d’entreprises du monde entier ont commencé à rencontrer des difficultés avec Microsoft Outlook. Beaucoup ne pouvaient pas accéder à leur messagerie, et certains messages étaient retardés. Le problème touchait aussi des fonctions d’autres services Microsoft 365 qui dépendent d’Exchange Online, la plateforme de messagerie cloud de Microsoft.
Pour certaines organisations, ce fut bien plus qu’un désagrément. Des sociétés financières ont utilisé le téléphone et le fax pour confirmer des transactions. Des entreprises qui préparaient des annonces financières se sont tournées vers d’autres moyens d’échanger des informations. L’enquête préliminaire de Microsoft a ensuite fait remonter l’incident à un problème logiciel présent depuis des mois, mais qui ne s’était pas manifesté dans les conditions d’exploitation précédentes.
Voici ce que les documents établissent et ce que Microsoft n’avait pas encore pleinement expliqué au 21 novembre.
1. Que s’est-il passé ?
La défaillance s’est produite dans l’infrastructure cloud de Microsoft, et non dans les installations individuelles d’Outlook. Outlook et les autres applications de messagerie se connectent à Exchange Online par des systèmes qui reçoivent et orientent leurs requêtes. Pendant la panne, les serveurs qui traitaient ces connexions ont été surchargés et ont cessé de répondre.
Microsoft a indiqué que la plupart des personnes qui tentaient d’utiliser des fonctions dépendantes d’Exchange Online ont été touchées, même si l’expérience variait selon la région, le mode d’accès et le moment. Certains utilisateurs n’ont pas pu ouvrir leur boîte aux lettres. D’autres ont eu un accès intermittent ou des retards à l’envoi et à la réception des messages.
Microsoft a aussi cité Teams, Copilot, SharePoint, OneDrive, Defender et plusieurs autres services parmi ceux qui ont été touchés. Cela ne signifie pas que chaque application citée a cessé de fonctionner. Microsoft a indiqué que bon nombre de ces services sont restés en grande partie disponibles, mais ont connu des problèmes sur les fonctions liées à Exchange Online. Les conversations et les réunions Teams, par exemple, ont continué de fonctionner pour la plupart des utilisateurs pendant l’essentiel de la perturbation, après avoir été déplacées hors de la passerelle touchée.
Source : rapport préliminaire PIR de Microsoft, p. 2 à 4. Le lien est une copie du rapport hébergée par un tiers.
2. Combien de temps la panne a-t-elle duré ?
Microsoft a enregistré la principale période d’impact sur les clients de 16:20 UTC le 12 novembre à 16:10 UTC le 13 novembre 2026 : 23 heures et 50 minutes. En heure normale de l’Est des États-Unis (EST), cela correspond à 11 h 20 le jeudi jusqu’à 11 h 10 le vendredi.
Cette durée décrit la période principale d’impact actif. Elle ne signifie pas que tous les services ont été indisponibles pendant toutes ces heures. Certaines applications se sont rétablies plus tôt, et Microsoft a continué de vérifier l’état des services et de traiter les messages retardés après la fin de l’impact principal. Ses dernières mises à jour destinées aux clients ont été publiées le 14 novembre.
| Heure (UTC) | Jalon documenté |
|---|---|
| 12 nov., 01:07 | Le trafic de Teams a été automatiquement basculé vers la passerelle qui desservait aussi Exchange Online. |
| 12 nov., 16:03 | La surveillance de Microsoft a détecté des problèmes de connexion croissants. |
| 12 nov., 16:20 | Microsoft a enregistré le début de l’impact majeur sur les clients. |
| 13 nov., 07:20 | Les ingénieurs ont commencé à appliquer un changement pour annuler le comportement défectueux. |
| 13 nov., 14:17 | La disponibilité mondiale du webmail est revenue aux niveaux attendus. |
| 13 nov., 16:10 | Microsoft a enregistré la fin de l’impact actif sur les clients. |
| 14 nov., 04:15 | Microsoft a publié les dernières mises à jour destinées aux clients après une surveillance prolongée. |
Source : rapport préliminaire PIR de Microsoft, p. 2 et 4 à 6.
3. Qui a été touché ?
Microsoft a décrit l’incident comme mondial. L’impact le plus important concernait l’accès aux boîtes aux lettres Exchange Online et la remise des e-mails. Certaines fonctions d’autres services Microsoft 365 ont été touchées parce qu’elles reposaient sur la même infrastructure de messagerie.
La gravité a été inégale. Une entreprise pouvait être incapable d’utiliser Outlook de manière fiable alors que ses réunions Teams fonctionnaient encore. Une autre pouvait avoir subi la perturbation d’un flux de travail qui envoyait des notifications par e-mail. Ces distinctions comptent : « panne de Microsoft 365 » ne signifie pas que chaque client a perdu l’accès à chaque service Microsoft 365.
Le rapport préliminaire de Microsoft n’a pas fourni de chiffre mondial vérifié du nombre d’utilisateurs ou d’organisations touchés. Des sites publics de signalement de pannes ont enregistré des plaintes, mais ces totaux ne doivent pas être considérés comme le nombre de clients uniques touchés.
Source : rapport préliminaire PIR de Microsoft, p. 2.
4. Quel a été l’impact sur les entreprises ?
Reuters a documenté des entreprises qui ont eu recours à d’autres moyens de communication pendant la perturbation de la messagerie. À Taïwan, certaines sociétés financières ont eu des difficultés dans leurs activités de gestion de fonds, et l’une d’elles a utilisé le fax pour confirmer des transactions. Les banques britanniques HSBC et Barclays ont activé leurs dispositifs de gestion d’incident, tout en indiquant que de nombreux services destinés aux clients continuaient de fonctionner normalement.
L’interruption a aussi touché la communication autour des résultats financiers. Reuters a rapporté que l’assureur Aviva a communiqué d’autres numéros de téléphone et transféré des enregistrements par Bluetooth. L’opérateur boursier Euronext a orienté les sociétés cotées vers le contact téléphonique pour les communications urgentes. D’autres organisations se sont aussi appuyées sur des appels téléphoniques tant que la messagerie était peu fiable.
Ces exemples montrent une perturbation opérationnelle, mais ils n’établissent pas un coût financier total. Les sources examinées pour cet article ne contiennent aucun chiffre vérifié de perte mondiale. Il ne faut pas en calculer un à partir de plaintes d’utilisateurs, de témoignages anecdotiques ou d’estimations non vérifiées.
Source : Reuters, 13 novembre 2026.
5. Quelle est la cause de la panne ?
L’enquête préliminaire de Microsoft a identifié trois conditions qui se sont combinées pour mettre hors service la passerelle qui traitait les connexions à plusieurs services Microsoft 365.
La première était un ancien défaut logiciel. En juillet, Microsoft avait commencé à déployer un changement destiné spécifiquement à ses serveurs de passerelle Microsoft 365. Il avait franchi le processus de déploiement normal de l’entreprise et avait fonctionné pendant plus de trois mois sans problème visible. Dans certaines conditions de trafic, toutefois, ce changement faisait en sorte que des opérations internes du serveur se gênent mutuellement. La puissance de calcul et la mémoire pouvaient s’épuiser jusqu’à ce qu’un serveur cesse de répondre. Microsoft a qualifié cela de problème de contention de verrou (lock contention).
Microsoft a indiqué que ses tests avaient manqué le défaut parce que les ordinateurs et les profils de trafic utilisés lors des tests différaient de ceux de la production. Le problème s’aggravait sur des ordinateurs plus récents dotés de davantage de cœurs de processeur, alors que ses tests de charge utilisaient souvent des machines moins puissantes. L’entreprise a souligné qu’il s’agissait d’un changement propre à la passerelle, et non d’un défaut touchant les installations Windows ordinaires.
La deuxième condition était un changement de trafic. Environ 15 heures avant l’incident, Teams a automatiquement basculé du trafic d’une passerelle alternative vers la passerelle principale qui desservait aussi Exchange Online. Un tel basculement fait normalement partie du maintien de la disponibilité des services, mais il a placé une charge supplémentaire sur l’infrastructure touchée et modifié la répartition des requêtes qu’elle recevait.
La troisième condition était une capacité réduite. Près de 14 % de la capacité de serveurs de cette passerelle étaient indisponibles en raison d’un problème distinct survenu la veille. Microsoft a indiqué que la capacité restante aurait dû être suffisante dans des conditions normales. Mais, conjuguée au changement de trafic, la capacité réduite a contribué à révéler l’ancien défaut pendant une période chargée aux États-Unis.
Lorsque des serveurs sont tombés en panne, le système de Microsoft a redirigé leur trafic vers des serveurs qui semblaient encore sains. Ces serveurs présentaient le même défaut caché. À mesure que la charge de travail leur parvenait, ils sont eux aussi tombés en panne. Microsoft a indiqué que plus de 80 % des serveurs de la passerelle ne répondaient plus au pire moment.
Microsoft avait conçu des frontières destinées à empêcher une défaillance dans une partie de l’infrastructure de se propager entre les régions. L’entreprise a déclaré qu’un problème distinct avait empêché ces frontières, appelées cloisons étanches (bulkheads), de contenir la défaillance. Le rapport préliminaire n’a pas pleinement expliqué ce problème supplémentaire.
Source : rapport préliminaire PIR de Microsoft, p. 3 à 4.
6. Pourquoi le rétablissement a-t-il pris autant de temps ?
Microsoft a d’abord tenté de réparer et de redémarrer les serveurs touchés et de déplacer les connexions vers d’autres infrastructures. Certains serveurs semblaient sains au redémarrage, mais ont cessé de répondre de nouveau lorsque le trafic en attente est revenu. L’ampleur de la défaillance dépassait la situation que ses systèmes de récupération automatisés normaux étaient conçus pour gérer.
Annuler le changement logiciel était également difficile. Le défaut était présent depuis juillet, de sorte que les outils habituels de retour arrière rapide d’un déploiement récent ne pouvaient pas simplement l’inverser. Les ingénieurs ont mis au point une nouvelle mise à jour qui a ramené le code de gestion des connexions touché à un état de fonctionnement antérieur.
L’entreprise a ensuite appliqué ce changement à des groupes de serveurs et les a remis en service avec précaution. Le rétablissement s’est stabilisé le 13 novembre, le webmail se rétablissant avant les autres modes d’accès. Microsoft a continué de surveiller et de traiter le courrier retardé après la fin de l’impact actif.
Source : rapport préliminaire PIR de Microsoft, p. 4 à 6.
7. Qu’est-ce que Microsoft a reconnu ?
Le rapport de Microsoft a reconnu que ses tests n’avaient pas recréé la combinaison de conditions matérielles et de trafic qui a révélé le défaut logiciel. Il a aussi reconnu que ses protections régionales normales n’avaient pas empêché la propagation de l’incident et que son processus de récupération automatisé n’était pas conçu pour une défaillance d’une telle ampleur.
L’Associated Press a rapporté que la précédente mise à jour publique de Microsoft décrivait l’incident comme introduit par un problème survenu lors d’une précédente mise à niveau de la capacité du réseau, qui est apparu après un récent changement de réseau. Le rapport préliminaire donne le récit plus complet décrit ci-dessus, et les sources examinées n’expliquent pas comment les deux descriptions sont liées.
Le PDG de Microsoft, Satya Nadella, a ensuite commenté la panne et la nécessité de détecter de tels défauts lors des tests. Il a aussi évoqué le défi plus large de la stabilité des logiciels lorsque l’IA aide les développeurs à trouver des bogues et à produire des correctifs plus rapidement. Ces propos n’établissent pas que l’IA a causé cet incident. Microsoft a déclaré que la panne était un problème technique sans lien avec des cyberattaques ou des agents d’IA, et le rapport préliminaire sur la cause racine n’identifie pas du code généré par l’IA comme une cause.
Sources : rapport préliminaire PIR de Microsoft, reportage de Mint sur Nadella, 19 novembre 2026 et Associated Press sur la déclaration de Microsoft.
8. Qu’est-ce que Microsoft a corrigé, et que reste-t-il d’inconnu ?
Microsoft a déclaré avoir mené à bien plusieurs mesures immédiates. Elles comprenaient le rétablissement du comportement antérieur de gestion des connexions qui fonctionnait, l’ajout de capacité, l’allongement du délai de remise des e-mails pour les messages retardés, l’amélioration de la surveillance et l’ajout de contrôles pour réduire le risque qu’un trafic soit redirigé d’une manière qui provoque une nouvelle cascade.
Ce sont des actions déclarées par Microsoft, et non une preuve indépendante que chaque faiblesse à plus long terme a été supprimée. À la date limite des éléments de preuve de cet article, le 21 novembre, le rapport préliminaire n’avait pas pleinement expliqué pourquoi le confinement régional avait échoué, ce qui avait causé la réduction distincte de 14 % de la capacité, ni comment toutes les améliorations permanentes seraient vérifiées. Le rapport final d’après incident de Microsoft n’était pas publiquement disponible lors de la revue de cet article.
La panne illustre aussi pourquoi les entreprises doivent savoir quelles activités essentielles dépendent des outils de communication cloud et comment elles communiqueront lorsque ces outils sont inaccessibles. TechiesJournal explore cette question plus large de la continuité d’activité dans Le paradoxe de la dépendance au cloud : quand une technologie fiable ne garantit pas la continuité d’activité. Le présent rapport se concentre sur l’incident Outlook documenté plutôt que de répéter cette analyse.
L’incident est résolu. L’enquête préliminaire de Microsoft explique comment les principales défaillances se sont développées, tandis que le rapport final reste la prochaine source pour évaluer ses actions correctives à plus long terme.
Références et lectures complémentaires
- Preliminary Post-Incident Report for Microsoft 365 (Microsoft, November 15, 2026) : cause, chronologie et mesures immédiates rédigées par Microsoft. Préliminaire et susceptible d’évoluer. Le lien est une copie du rapport hébergée par un tiers.
- Faxes, phones and Bluetooth: Microsoft outage forces businesses to find fixes (Reuters, November 13, 2026) : exemples d’entreprises et communications alternatives rapportés de manière indépendante.
- Microsoft says services fully restored after global outage (Associated Press, November 14, 2026) : couverture indépendante du rétablissement et de l’exclusion par Microsoft des causes de type cyberattaque et agent d’IA.
- Nadella discusses Outlook outage and software stability (Mint, November 19, 2026) : reportage d’entretien. Distinguez les commentaires sur la rapidité des correctifs par l’IA en général de la cause documentée de cet incident.
Revue des sources : 21 novembre 2026. Cet article repose sur le rapport préliminaire de Microsoft. Un rapport final n’était pas publiquement disponible au moment de la revue.