

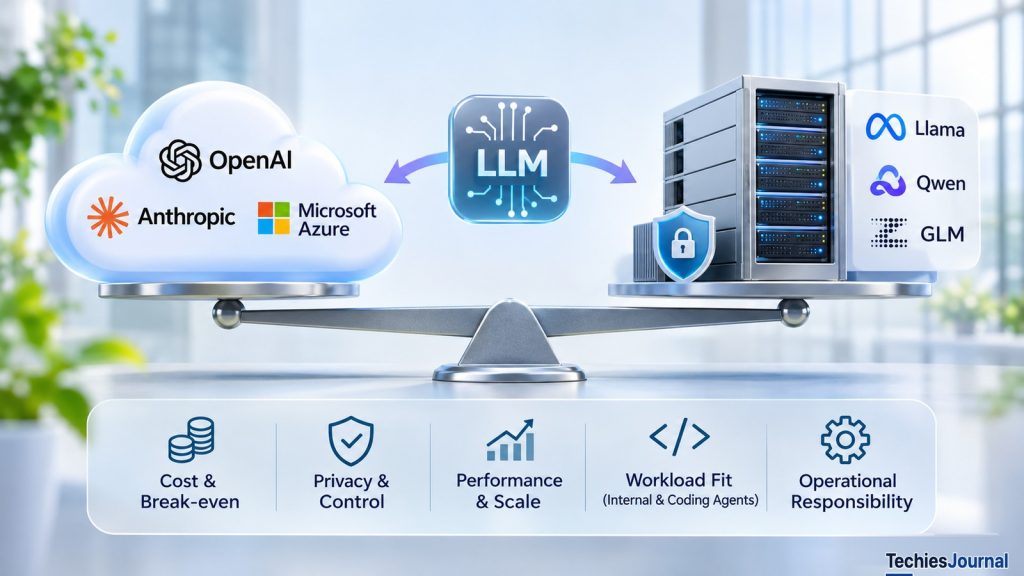
Exécuter un modèle de langage à poids ouverts sur une infrastructure privée promet un meilleur contrôle des données, du comportement du modèle et des coûts d’exploitation. Mais que gagne réellement une entreprise ? Deux charges de travail concrètes, un agent de connaissances interne et un agent de codage d’IA, montrent pourquoi les capacités du modèle, les coûts d’infrastructure et le travail effectué comptent davantage que l’endroit où le modèle s’exécute.
Une entreprise souhaite mettre un assistant d’IA à la disposition de ses employés. Cet assistant doit rechercher dans la documentation interne, expliquer les procédures de dépannage, résumer les incidents et aider le personnel à résoudre les problèmes courants.
L’équipe d’ingénierie doit faire un choix. Elle peut utiliser un modèle hébergé via une API et payer l’inférence au fil de l’utilisation par les employés. Ou bien elle peut déployer un modèle à poids ouverts sur une infrastructure contrôlée par l’entreprise.
La seconde option semble séduisante. Les informations sensibles pourraient rester dans un environnement privé approuvé. L’équipe pourrait conserver certaines versions du modèle, ajuster les paramètres d’inférence et éviter de dépendre entièrement d’une API de modèle commerciale.
Il y a aussi l’argument financier. Pourquoi continuer à payer des jetons alors que l’entreprise pourrait exploiter ses propres GPU ?
Du point de vue de l’ingénierie d’infrastructure, je remettrais en cause cette question avant d’approuver la moindre dépense matérielle.
Elle suppose qu’un GPU et un abonnement à une API offrent une intelligence équivalente. Ce n’est pas le cas. Un GPU fournit du calcul et de la mémoire. L’entreprise a toujours besoin d’un modèle capable d’accomplir son travail, d’un environnement d’exécution (runtime) qui traite les requêtes efficacement et d’ingénieurs capables d’exploiter le système.
La décision doit partir de ce que l’application doit accomplir, et non du prix auquel l’entreprise peut louer un GPU.
La différence apparaît plus nettement lorsque l’on examine deux applications aux exigences très différentes.
Un agent de connaissances interne peut coûter moins cher que prévu
Prenons une entreprise de 100 employés. Chaque employé pose dix questions par jour ouvré à un agent d’IA interne, sur 22 jours ouvrés.
Cela représente 22 000 interactions par mois.
L’assistant récupère des informations dans la documentation de l’entreprise, résume les éléments pertinents et génère une réponse. Certaines questions peuvent demander une courte explication, tandis que d’autres mobilisent plusieurs documents et des appels supplémentaires au modèle.
Supposons que chaque interaction menée à terme consomme en moyenne 6 000 jetons d’entrée et 1 000 jetons de sortie, y compris les éventuelles requêtes répétées au modèle.
Selon le calcul de TechiesJournal à partir de ces hypothèses, la charge de travail mensuelle atteint 132 millions de jetons d’entrée et 22 millions de jetons de sortie.
Avec les tarifs API standard publiés, les coûts d’inférence du modèle seraient les suivants :
| Modèle hébergé | Coût mensuel estimé (USD) |
|---|---|
| GPT-6 Luna | 24,20 $ |
| GPT-6.1 Sol | 484 $ |
| Claude Sonnet 5.5 | 484 $ |
| Claude Fable 5.2 | 1 936 $ |
Calcul illustratif fondé sur des nombres de jetons identiques. Exclut l’infrastructure de récupération, les outils payants, le traitement premium, les remises liées à la mise en cache et la relecture humaine. Il n’établit ni une qualité de modèle équivalente ni la consommation réelle de jetons d’un fournisseur à l’autre. Les tarifs sont ceux du niveau standard, relevés le 11 novembre 2026. On suppose que chaque interaction reste très en dessous du seuil de 272 000 jetons d’entrée au-delà duquel OpenAI facture les prompts plus cher, et Anthropic facture Claude Sonnet 5.5 et Claude Fable 5.2 aux tarifs standard sur toute leur fenêtre de contexte de 1M jetons.
Sources : tarifs de l’API OpenAI et tarifs de l’API Anthropic.
Le premier constat est important. Selon le modèle, une même charge de travail supposée peut aboutir à une facture radicalement différente.
Mais ce tableau n’est pas un classement des meilleurs modèles pour un agent interne.
Un modèle peu coûteux peut répondre correctement à des questions simples sur les politiques internes, mais peiner sur des investigations d’incidents complexes. Un modèle plus puissant peut produire des résultats plus fiables, mais à un prix plus élevé. Des tokeniseurs, des comportements de raisonnement et des modes d’utilisation des outils différents peuvent aussi modifier la consommation réelle de jetons.
La question pertinente est de savoir si le modèle satisfait aux critères d’acceptation de l’application.
Pour cet assistant interne, ces critères pourraient inclure de récupérer les informations que l’employé est autorisé à consulter, de produire des réponses étayées par les documents récupérés, de signaler les informations manquantes et de répondre dans un délai acceptable.
Le contrôle des accès doit rester dans l’application et dans les systèmes de récupération. On ne doit pas attendre d’un modèle de langage qu’il applique les permissions sur les documents simplement parce que ses instructions lui demandent de les respecter.
Si un modèle hébergé moins coûteux satisfait systématiquement aux critères, l’entreprise pourrait avoir peu de raisons financières d’exploiter sa propre infrastructure d’inférence.
Elle pourrait aussi acheminer les questions les plus exigeantes vers un modèle hébergé plus puissant, même si cet acheminement entraîne ses propres considérations de coût et de qualité.
Le choix du modèle peut modifier considérablement l’économie du projet avant même que l’organisation ne change son mode d’hébergement.
Ce que coûte l’exécution du modèle en privé
Supposons que l’entreprise envisage un modèle à poids ouverts sur un GPU loué.
Au lieu de payer principalement selon la consommation de jetons, elle paie la capacité GPU qu’elle garde disponible.
Les tarifs publiés par Runpod pour les Pods à la demande Secure Cloud fournissent une référence utile :
| GPU (VRAM) | Tarif Secure Cloud et coût mensuel pour 720 heures |
|---|---|
| NVIDIA L4 (24 GB) | 0,59 $ de l’heure, 425 $ par mois |
| NVIDIA L40S (48 GB) | 1,09 $ de l’heure, 785 $ par mois |
| NVIDIA A100 (80 GB) | 1,79 $ de l’heure, 1 289 $ par mois |
| NVIDIA H100 PCIe (80 GB) | 2,89 $ de l’heure, 2 081 $ par mois |
En USD, arrondis. Coûts illustratifs de location continue, et non coûts complets d’une inférence en production. Le stockage, le réseau, la capacité de disponibilité et l’exploitation sont exclus. Les prix et la disponibilité chez le fournisseur peuvent changer. Runpod affiche aussi des tarifs Community Cloud plus bas pour certains de ces GPU, par exemple 0,79 dollar de l’heure pour un L40S, soit environ 569 dollars par mois.
Source : tarifs GPU de Runpod.
Un L40S fonctionnant en continu coûte environ 785 dollars par mois au tarif Secure Cloud, avant les dépenses annexes. C’est plus que la facture API mensuelle illustrative de 484 dollars pour Claude Sonnet 5.5.
On pourrait être tenté d’en conclure que l’inférence hébergée revient moins cher. Mais cette conclusion pose un problème.
Les 484 dollars représentent un montant calculé pour une quantité définie de jetons envoyés à un modèle hébergé particulier. Les 785 dollars représentent la location de matériel. Ce montant ne dit rien, à lui seul, du modèle à poids ouverts capable de tourner sur ce GPU, du nombre de requêtes qu’il peut traiter, ni de la qualité de ses réponses par rapport à celles de Sonnet.
Ce ne sont pas des devis de service équivalents.
Pour les comparer équitablement, l’entreprise doit choisir un modèle privé, évaluer ses réponses sur la même charge de travail et mesurer la quantité de travail accepté que le GPU accomplit dans le temps de réponse requis.
Ce n’est qu’alors qu’elle peut calculer le coût effectif par interaction réussie.
L’assistant interne peut aussi être très sollicité pendant les heures de travail et presque inactif la nuit. Un GPU qui tourne en continu coûte de l’argent pendant ces heures creuses. Arrêter les instances de traitement (workers) entraîne des compromis en matière de démarrage et de disponibilité.
Un système de traitement par lots peut s’accommoder de ces conditions. Ce n’est pas forcément le cas d’un assistant interactif censé répondre immédiatement.
Le bénéfice économique de l’inférence privée dépend de l’efficacité avec laquelle l’entreprise utilise la capacité qu’elle paie.
Ce que l’entreprise gagne à posséder son inférence
Une comparaison des coûts passe à côté de certaines des meilleures raisons d’exécuter un modèle en privé.
Avec une inférence autogérée, l’entreprise peut décider du moment où un modèle est mis à niveau, conserver une version choisie et configurer l’environnement de service pour des exigences opérationnelles particulières.
Cela peut compter lorsque l’application a besoin d’un comportement reproductible dans un processus de mise en production contrôlé.
L’inférence privée peut aussi réduire la nécessité de transmettre des prompts et des documents sensibles à un service de modèles externe.
Mais exécuter un modèle en local ne rend pas automatiquement privée l’application dans son ensemble.
L’assistant interne continue de récupérer des documents, de construire des prompts, d’écrire des journaux et d’utiliser des systèmes de supervision. Si l’un de ces composants transmet des informations confidentielles ailleurs, un modèle exécuté en local ne ferme pas l’ensemble du périmètre des données.
Les services de modèles gérés peuvent eux aussi offrir des protections des données adaptées aux entreprises. La documentation de Microsoft Foundry distingue l’accès du fournisseur du modèle et l’utilisation pour l’entraînement, d’une part, du lieu de traitement et du stockage, d’autre part, qui peuvent varier selon le type de déploiement et les fonctionnalités. La même page décrit la surveillance des abus : les prompts et les réponses signalés par un système automatisé peuvent être échantillonnés et examinés par du personnel Microsoft autorisé, les données étant stockées dans la zone géographique du client, sauf si le client est autorisé à bénéficier d’une surveillance des abus modifiée. Les déploiements Global et DataZone peuvent aussi traiter des données en dehors de la zone géographique de la ressource. Les conditions des autres fournisseurs diffèrent, si bien que les conditions propres au déploiement concerné doivent être lues au regard de l’exigence de périmètre de l’organisation.
Si les documents internes ne doivent être traités que dans un environnement défini et contrôlé par l’entreprise, l’inférence privée peut être nécessaire. Si un service géré approuvé satisfait à l’exigence, l’auto-hébergement peut n’apporter que peu de valeur en matière de sécurité au regard de sa charge d’exploitation.
La confidentialité est une propriété de l’application complète et du flux de données, pas une étiquette apposée sur le point de terminaison du modèle.
Un agent de codage change la donne économique
Prenons maintenant une équipe logicielle qui utilise des agents de codage d’IA. Les agents lisent les fichiers du dépôt, examinent les tickets, modifient le code, exécutent les tests et préparent des modifications pour la revue.
C’est différent de la recherche dans la documentation interne. Un agent de codage peut inspecter de nombreux fichiers avant d’identifier un problème. Son premier correctif peut échouer aux tests. Il peut alors analyser les journaux, réviser l’implémentation et faire appel à davantage d’outils.
Supposons que dix développeurs délèguent quatre tâches de codage par jour ouvré sur 22 jours, soit 880 tâches par mois.
Pour une tâche modérée, supposons que le flux de travail complet consomme 100 000 jetons d’entrée et 20 000 jetons de sortie. Pour une tâche plus lourde, supposons 500 000 jetons d’entrée et 50 000 jetons de sortie.
| Modèle hébergé | Tâches modérées/mois | Tâches lourdes/mois |
|---|---|---|
| Claude Sonnet 5.5 | 352 $ | 1 320 $ |
| Claude Fable 5.2 | 1 408 $ | 5 280 $ |
| GPT-6.1 Sol | 352 $ | 1 320 $ |
En USD pour 880 tâches, calcul aux tarifs standard. On suppose que tous les jetons d’interaction sont facturés aux niveaux standard indiqués. Le cas lourd est un cumul sur plusieurs appels, et non un prompt unique de 500K jetons. La mise en cache, les outils payants, les environnements d’exécution et les coûts de revue sont exclus. La qualité des modèles et l’usage réel peuvent différer. Les tarifs sont ceux du niveau standard, relevés le 11 novembre 2026.
Sources : tarifs de l’API Anthropic et tarifs de l’API OpenAI.
La mise en cache peut modifier sensiblement ces totaux. Anthropic facture les lectures en cache (cache hits) de Claude Sonnet 5.5 à 0,10 dollar par million de jetons, contre 2 dollars pour l’entrée de base, et OpenAI affiche l’entrée en cache de GPT-6.1 Sol à 0,10 dollar contre 2 dollars. Les agents de codage renvoient une grande partie de leur contexte d’un appel à l’autre, si bien qu’une facture hébergée peut se situer bien en dessous des chiffres ci-dessus. À titre d’analyse de sensibilité hypothétique, si 80 % des 440 millions de jetons d’entrée du cas lourd étaient des lectures en cache, le total de Claude Sonnet 5.5 passerait de 1 320 dollars à environ 651 dollars, avant tout coût d’écriture en cache. Il s’agit d’un calcul de TechiesJournal, et non d’un résultat observé.
Dans le cas le plus lourd, les frais de modèle récurrents deviennent importants. Cela justifie d’étudier l’inférence privée, mais pas automatiquement de la déployer.
Le coût de génération du code n’est pas le coût de production d’une modification logicielle acceptée.
Un modèle bon marché peut devenir coûteux s’il produit à répétition des correctifs qui échouent aux tests et doivent être corrigés par les développeurs. Un modèle plus cher peut mener à bien un travail difficile avec moins de nouvelles tentatives, même si cet avantage doit être mesuré plutôt que supposé.
Pour les agents de codage, je mesurerais la réussite des tâches, le temps écoulé et la correction humaine, en plus des frais de modèle.
La capacité d’un modèle à poids ouverts à accomplir le même travail de codage
Les modèles à poids ouverts sont des candidats crédibles pour le codage et les tâches agentiques, mais un classement public ne démontre pas que l’un d’eux peut remplacer un modèle hébergé dans une entreprise donnée.
SWE-bench Verified, qui évalue des agents sur des tickets issus de dépôts de code publics, est devenu un point de référence courant. En septembre 2026 toutefois, Epoch AI a jugé ce benchmark défaillant, en invoquant des problèmes de contamination et de notation.
Le score d’un modèle peut aussi dépendre du harnais de l’agent, des prompts, des outils et de la configuration d’exécution. Un benchmark public ne reproduit pas les dépôts privés, les dépendances, les tests ni les critères d’acceptation d’une entreprise.
Une meilleure comparaison consisterait à confier aux candidats hébergé et privé un ensemble représentatif de tâches internes équivalentes. L’équipe examinerait des corrections de bugs, de la génération de tests, des mises à niveau de dépendances et des modifications touchant plusieurs fichiers.
Pour chaque tâche, l’équipe devrait noter si les tests ont réussi, si la modification répondait à la demande, combien de tentatives ont été nécessaires, combien de temps cela a pris et quelle part de correction restait à la charge des développeurs.
Ces éléments comptent davantage qu’un pourcentage de benchmark mis en avant lorsque la décision consiste à dépenser de l’argent pour exploiter du matériel d’inférence dédié.
Le modèle choisi détermine la facture matérielle
L’une des raisons d’évaluer d’abord les capacités est que les différents modèles à poids ouverts imposent des exigences de service très différentes.
Qwen3.5-27B est décrit sur sa fiche de modèle comme un modèle de langage de 27 milliards de paramètres. À quatre bits par paramètre, la charge théorique des poids est d’environ 13,5 Go avant les métadonnées et le surcoût d’exécution. Un déploiement quantifié adapté sur un GPU de 48 Go mérite d’être évalué, mais sa longueur de contexte, sa capacité de requêtes simultanées et son débit réel restent à tester. Les exemples de service de la fiche elle-même utilisent un parallélisme de tenseurs sur huit GPU et recommandent de conserver si possible au moins 128K jetons de contexte, ce qui montre à quelle vitesse la planification de la mémoire dépasse les seuls poids.
GLM-5.3-Flash utilise une architecture à mélange d’experts (mixture of experts) comptant environ 321 milliards de paramètres au total, dont 18 milliards actifs par jeton. Le nombre plus faible de paramètres actifs réduit une partie du calcul, mais ne supprime pas la nécessité de stocker les poids du modèle et d’y accéder. L’explication publiée précédemment par TechiesJournal sur les modèles à poids ouverts et la raison pour laquelle le mélange d’experts allège le calcul mais pas le stockage (en anglais) traite de la même distinction pour trois autres modèles.
Son checkpoint FP8 par défaut, tel que documenté, nécessite environ 306 GiB de stockage des poids avant le surcoût d’exécution et du KV cache, et la configuration par défaut de la recette publiée utilise huit GPU H200, une configuration dont le tableau Runpod ci-dessus ne donne pas le prix. La même recette mentionne un checkpoint BF16 qui nécessite environ deux fois la mémoire des poids FP8, et un checkpoint NVFP4 sur 4 bits qui requiert des GPU NVIDIA Blackwell.
Ce checkpoint par défaut ne peut pas tenir sur un seul L40S. Une entreprise attirée par un puissant modèle de codage à poids ouverts peut découvrir que l’infrastructure privée nécessaire coûte bien plus cher que le GPU retenu dans son premier tableur.
Les poids ouverts offrent une liberté de déploiement, mais ne garantissent pas un déploiement abordable.
Pourquoi plusieurs agents rendent l’inférence plus exigeante
Le scénario de l’agent de codage met aussi à l’épreuve la gestion des requêtes simultanées.
Un environnement d’exécution de modèles doit traiter des requêtes aux longueurs de contexte et aux tailles de sortie différentes. Pour les transformers autorégressifs classiques, le traitement de l’entrée est souvent appelé prefill, suivi de la génération des jetons pendant le décodage (decode).
L’environnement d’exécution conserve un état d’attention réutilisable, appelé cache clé-valeur, ou KV cache. Les contextes longs et la présence de plusieurs agents actifs augmentent la mémoire nécessaire à cet état.
Les systèmes de service tels que vLLM emploient des techniques d’ordonnancement et de regroupement par lots (batching) pour améliorer l’utilisation des GPU. Mais la mémoire et la capacité de calcul disponibles restent limitées. Le guide de TechiesJournal pour choisir un moteur d’inférence d’IA en production compare plus en détail les moteurs de service. Des files d’attente et des réponses plus lentes apparaissent lorsque la demande dépasse la capacité.
Cela compte particulièrement pour les agents de codage à plusieurs étapes. Chaque réponse retardée peut repousser l’appel d’outil, le test ou la correction qui suit.
L’entreprise doit donc mesurer le temps d’achèvement des tâches de bout en bout sous une demande simultanée réaliste, et pas seulement la vitesse de génération des jetons pour une requête isolée.
Les services hébergés exploitent une grande partie de l’infrastructure de service pour leurs clients, tout en imposant des limites et en créant des dépendances envers le fournisseur. L’inférence autogérée donne un contrôle direct sur la capacité, mais exige que l’entreprise conçoive, surveille et rétablisse elle-même cette capacité.
Cette différence opérationnelle a sa place dans la comparaison des coûts.
Où se situe le seuil de rentabilité
Dans l’exemple de codage lourd, Claude Sonnet 5.5 génère une facture de modèle illustrative de 1 320 dollars par mois. Un L40S loué en continu coûte environ 785 dollars.
L’écart semble prometteur, mais il ne prouve pas une économie, et l’analyse de sensibilité sur la mise en cache présentée plus haut montre à quel point il peut se réduire. Le déploiement privé pourrait nécessiter un modèle plus grand, davantage de GPU, plus de support opérationnel ou davantage de nouvelles tentatives pour obtenir les mêmes résultats acceptés.
La comparaison doit s’appuyer sur une mesure commune :
Coût par tâche acceptée = coût d’exploitation pertinent total ÷ tâches acceptées menées à terme
Pour l’inférence hébergée, le coût total comprend l’utilisation du modèle, les frais d’outils pertinents ainsi que le travail applicatif et de revue qui l’entoure. Pour l’inférence autogérée, il comprend les GPU ou le matériel, le stockage, le réseau, la redondance, le support opérationnel et une correction humaine comparable.
L’article précédent de TechiesJournal expliquant comment la tarification de l’IA passe du prix des jetons au coût par tâche (en anglais) traite des nouvelles tentatives, de la mise en cache et des coûts de revue que cette mesure doit inclure.
Les deux approches doivent être évaluées selon les mêmes critères de réussite, les mêmes exigences de confidentialité et les mêmes attentes en matière de temps de réponse.
Un modèle privé qui traite des tâches prévisibles avec un taux d’utilisation élevé peut être rentable. Un autre, qui exige du matériel coûteux mais produit des résultats incertains, peut ne pas l’être.
Une approche hybride peut avoir du sens lorsque différentes charges de travail requièrent des capacités de modèle différentes, à condition que l’acheminement soit encadré par la politique de données de l’entreprise. Une requête confidentielle ne peut pas être envoyée vers un point de terminaison cloud non autorisé simplement parce que le modèle privé approuvé est occupé.
La question utile est de savoir quel dispositif produit un résultat accepté au coût durable le plus bas tout en respectant les contraintes de l’application.
Ce que je choisirais pour ces charges de travail
Pour l’assistant de connaissances interne, je commencerais par évaluer un modèle géré adapté au regard des exigences de l’entreprise en matière d’exactitude, de confidentialité et de latence. Les frais d’API illustratifs ne justifient pas, à eux seuls, de maintenir une capacité GPU dédiée.
L’inférence privée devient intéressante lorsqu’elle répond à une exigence de périmètre de traitement ou démontre un net avantage d’exploitation sous un trafic soutenu.
Pour l’agent de codage, j’étudierais plus sérieusement l’inférence privée dès lors que les dépenses de modèle et l’usage deviennent importants. Mais je testerais la réussite des tâches de codage et la correction humaine avant de considérer un tarif GPU bas comme une économie.
Les éléments recueillis pourraient plaider pour un modèle hébergé, un modèle autogéré ou une combinaison des deux. Ce n’est pas de l’indécision. Cela découle du fait que ces charges de travail ont des exigences différentes en matière de capacités, d’infrastructure et de sécurité.
L’avantage, c’est le contrôle, mais ce contrôle doit créer de la valeur
Les modèles à poids ouverts permettent aux organisations de conserver des versions de modèles, d’opérer dans des environnements de traitement définis et, potentiellement, d’améliorer l’économie de travaux à fort volume qui s’y prêtent.
Ces avantages sont réels. Les responsabilités supplémentaires le sont tout autant : capacité, mémoire, requêtes simultanées, fiabilité, mises à niveau et sécurité.
L’agent de connaissances interne illustre pourquoi des frais modestes de modèle hébergé peuvent affaiblir l’argumentaire économique en faveur d’un GPU privé. L’agent de codage montre pourquoi des interactions soutenues et coûteuses peuvent justifier d’évaluer l’inférence privée, tout en révélant les limites des capacités du modèle et du matériel.
Une organisation devrait posséder son inférence d’IA lorsque cette possession lui apporte une capacité, un périmètre de confidentialité ou un avantage économique dont sa charge de travail a réellement besoin, et qu’elle peut exploiter de façon durable.
L’objectif n’est pas de posséder davantage d’infrastructure. Il est d’obtenir de meilleurs résultats avec le bon niveau de contrôle.
Sources et lectures complémentaires
- OpenAI API pricing
- Anthropic API pricing
- Runpod GPU cloud pricing
- Microsoft Foundry data privacy
- Qwen3.5-27B model card
- GLM-5.3-Flash vLLM deployment recipe
- vLLM documentation
- Epoch AI review of SWE-bench Verified
Date de recherche : 11 novembre 2026. Tous les volumes de charge de travail, coûts mensuels et exemples sont des calculs illustratifs, et non des résultats de production observés. Les prix et les exigences des modèles évoluent, vérifiez donc les chiffres actuels avant de vous y fier. Aucun déploiement de première main ni benchmark apparié entre modèle hébergé et modèle privé n’est revendiqué.