

Google के Gemini 4 Argon में एक नए frontier AI model के सामान्य संकेत दिखते हैं: मजबूत benchmark results, बेहतर reasoning और complex tasks पर बेहतर performance।
लेकिन इस announcement का एक हिस्सा किसी और model leaderboard से कहीं अधिक दिलचस्प है।
Google, Argon को काम करने के लिए काफी अधिक गुंजाइश दे रहा है।
कंपनी का कहना है कि Argon की output limit 64,000 tokens से बढ़ाकर एक million tokens तक की जा रही है। Google internally large software migrations, infrastructure optimization और scientific research जैसे काम के लिए Argon agents का भी उपयोग कर रहा है।
यह इस ओर इशारा करता है कि AI को किस तरह उपयोग किया जा सकता है, इसमें एक बड़ा बदलाव आ रहा है।
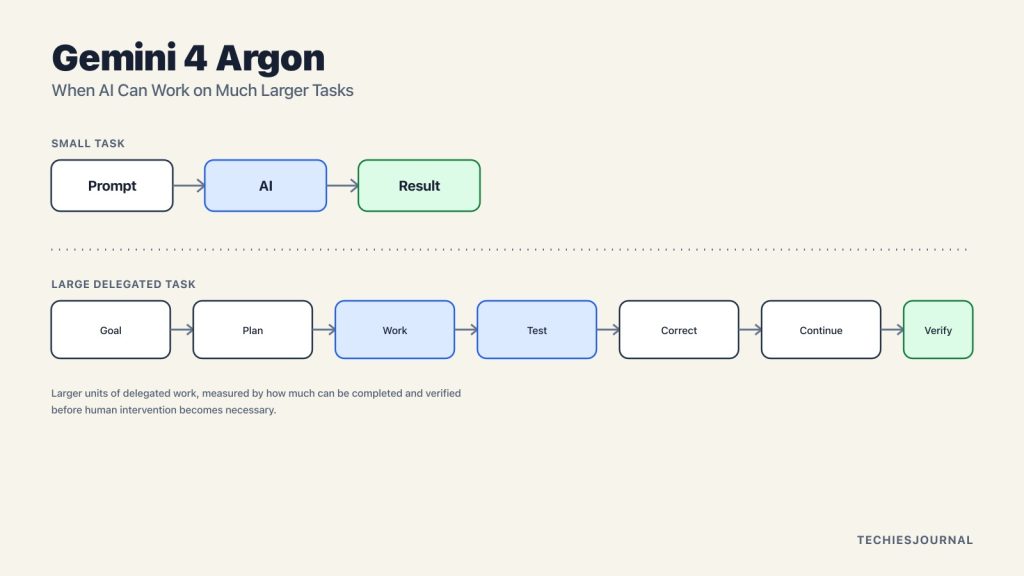
किसी model से एक छोटा task पूरा कराने के बजाय, developers अब उसे एक कहीं बड़ा objective दे सकते हैं और उसे अधिक intermediate steps खुद पूरे करने दे सकते हैं।
अब महत्वपूर्ण सवाल केवल यह नहीं है कि model कितना capable है। यह भी है कि हम कितना काम सुरक्षित रूप से delegate कर सकते हैं, इससे पहले कि हमें यह जाँचना पड़े कि उसने क्या किया है।
Gemini 4 Argon हमें इस समस्या की एक शुरुआती झलक देता है।
Gemini 4 Argon में क्या अलग है?
Argon, Google का नवीनतम frontier Gemini model है, जिसे खासतौर पर complex professional और agentic work के लिए डिज़ाइन किया गया है।
एक बड़ा context window इसे काफी बड़ी मात्रा में जानकारी के साथ काम करने देता है।
Google अपनी output-token limit को भी बढ़ाकर एक million tokens तक कर रहा है, जिससे model को complicated tasks के लिए कहीं बड़ा execution budget मिलता है।
ये दोनों आँकड़े अलग-अलग चीज़ों का वर्णन करते हैं।
Context हमें बताता है कि model कितनी जानकारी एक साथ ध्यान में रख सकता है। Output budget हमें बताता है कि वह कितना काम produce कर सकता है।
कोई भी आँकड़ा यह नहीं बताता कि model एक लंबे task के दौरान सही बना रहेगा या नहीं।
तीसरा सवाल, यानी कई जुड़े हुए steps में reliability, वहीं है जहाँ Argon खासतौर पर दिलचस्प बन जाता है।
चित्र 1 के लिए सुलभ टेक्स्ट विवरण
तीन अलग-अलग सवाल साथ-साथ दिखाए गए हैं, context, यानी AI कितनी जानकारी एक साथ ध्यान में रख सकता है, जैसे documents, code, history और पिछली actions, execution, यानी planning, acting, observing, revising और continuing के ज़रिए वह कितना काम लगातार produce कर सकता है, और reliability, यानी क्या वह decisions जमा होने के साथ सही बना रहता है, जिसके लिए mistakes पहचानना, recover करना, verify करना और सही तरीके से काम पूरा करना ज़रूरी है। बीच में लिखा गया कथन कहता है कि अधिक context और अधिक execution मिलकर guaranteed reliability नहीं बनाते। बड़े context windows और output budgets AI को काम करने के लिए अधिक गुंजाइश देते हैं, लेकिन वे अपने आप यह गारंटी नहीं देते कि decisions का एक लंबा क्रम सही बना रहेगा।
Google पहले से Argon को कहीं बड़े jobs पर test कर रहा है
Google के कुछ सबसे दिलचस्प Argon examples software engineering से आते हैं।
Google के अनुसार, वह C और C++ software को Rust में migrate करने में मदद के लिए Argon agents का उपयोग कर रहा है।[1]
ये projects दसियों हज़ार lines of code वाली libraries से लेकर Fuchsia Zircon kernel में 800,000 से अधिक lines से जुड़े काम तक फैले हैं।
एक और उदाहरण libgav1 से जुड़ा है, जो Google का open-source video decoder है।
Google के अनुसार, Argon agents ने बार-बार एक मौजूदा Rust implementation को profile किया, compiler behaviour की जाँच की और लगभग 32,000 lines के SIMD-related code को बदला।
Google का कहना है कि परिणामी implementation पिछले Rust port से 2.7 गुना तेज़ चलता है, जबकि वह बिल्कुल वही video output produce करता है।
Google यह भी बताता है कि Argon का उपयोग infrastructure optimization, scientific research और अन्य complex internal काम के लिए किया जा रहा है।
ये examples महत्वपूर्ण हैं क्योंकि ये उस तरह के काम को दिखाते हैं जिसे Google के अनुसार frontier agents अब संभालना शुरू कर रहे हैं।
लेकिन इन्हें एक महत्वपूर्ण label की ज़रूरत है। ये Google द्वारा रिपोर्ट किए गए internal results हैं। इस review के समय तक, हमें सबसे बड़े projects का तुलनीय पैमाने पर independent reproduction नहीं मिला है।
चित्र 2 के लिए सुलभ टेक्स्ट विवरण
Gemini 4 Argon को चार reported use areas से जुड़ा हुआ दिखाया गया है, software migration, यानी Fuchsia Zircon kernel सहित C और C++ code को Rust में ले जाना, code optimization, यानी Rust libgav1 implementation को profile, analyze, rewrite और benchmark करना, infrastructure, यानी optimization के मौके पहचानने के लिए operational data का विश्लेषण, और scientific work, यानी लंबी multi-stage reasoning और experimentation। एक स्पष्ट रूप से चिह्नित note बताता है कि ये Google द्वारा रिपोर्ट किए गए internal examples हैं, पूरे projects का independent reproduction नहीं।
Independent testing Argon की ताकत का समर्थन करता है, लेकिन हर दावे का नहीं
Independent evaluations Argon को आज के leading frontier models में शामिल करते हैं।
Vals AI फ़िलहाल अपने overall model index पर Argon को पहले स्थान पर रखता है।[2]
लेकिन individual results कहीं अधिक असमान हैं।
Argon code migration और professional tasks जैसे क्षेत्रों में मज़बूती से रैंक करता है, जबकि कुछ terminal और computer-use evaluations में उसका performance कम रहता है।
यह मायने रखता है क्योंकि ‘agentic work में अच्छा’ नाम की कोई एक capability नहीं होती। कोई model code migrate करने में शानदार हो सकता है, फिर भी terminal चलाने या software में visually navigate करने में उतना reliable न हो।
एक खासतौर पर उपयोगी result Zapier के AutomationBench से आता है।[3]
यह benchmark sales, marketing, finance, support और operations जैसे क्षेत्रों के tools से जुड़े realistic business workflows की जाँच करता है।
Argon फ़िलहाल लगभग 51% के score के साथ इस benchmark में सबसे आगे है।
Ranking प्रभावशाली है। Percentage कहीं अधिक जानकारी देता है।
एक leading frontier model भी इन realistic end-to-end tasks के एक बड़े हिस्से में असफल होता है।
Autonomous AI से जुड़े दावों की व्याख्या करते समय यह एक महत्वपूर्ण reminder है।
आगे होना यह नहीं बताता कि reliable है
Zapier का AutomationBench फ़िलहाल Gemini 4 Argon को लगभग 51% पर रखता है। इसकी उपयोगी व्याख्या केवल यह नहीं है कि Argon benchmark में सबसे आगे है। यह है कि एक leading frontier model भी realistic end-to-end automation tasks के एक बड़े हिस्से में असफल रहता है।
स्रोत: Zapier AutomationBench, October 1, 2026 को review किया गया।
One-million-token दावे का वास्तव में क्या अर्थ है?
Google का कहना है कि Argon की output-token limit बढ़ाकर एक million tokens तक की जा रही है, जबकि पहले यह 64,000 थी।
यह सुनने में सीधा लगता है, लेकिन इसे context की ज़रूरत है।
एक बड़ा output budget संभावित रूप से model को कहीं लंबे tasks पर काम जारी रखने देता है। इसका यह अर्थ नहीं है कि हर अतिरिक्त token result को बेहतर बनाता है।
एक बड़े software migration पर विचार करें। कोई AI code की जाँच कर सकता है, एक plan बना सकता है, components बदल सकता है, compile और test कर सकता है, failures की जाँच कर सकता है, revise कर सकता है और आगे बढ़ सकता है।
अगर वह उस क्रम की शुरुआत में ही कोई कमज़ोर architectural decision ले लेता है, तो बाद का काम उसी गलती पर बन सकता है।
Model को शायद मूल objective अब भी याद हो। उसके पास शायद अब भी काफी tokens उपलब्ध हों। फिर भी task भटक सकता है।
एक availability से जुड़ी detail भी ध्यान देने लायक है।
Google ने भले ही एक million tokens तक के output की घोषणा की हो, Vals के अनुसार उसने जिस Argon configuration का independently test किया, उसमें maximum output setting इससे कम थी।[2]
यह किसी विरोधाभास के बजाय rollout, product या API के अंतर को दर्शा सकता है।
पाठकों के लिए practical अंतर सीधा है। किसी घोषित model capability का मतलब यह ज़रूरी नहीं कि वह हर product या evaluation environment में उपलब्ध limit के बिल्कुल बराबर हो।
Google का अपना workflow हमें एक महत्वपूर्ण बात बताता है
Google के software-migration examples में एक और उपयोगी detail है।
कंपनी critical AI-generated migrations को automatically production के लिए तैयार नहीं बताती।
Google का कहना है कि महत्वपूर्ण migrations deployment से पहले automated testing, emulation, manual auditing और review से गुज़रते हैं।
इसलिए वास्तविक workflow ‘AI सीधे production तक’ जैसा कम और ‘AI का काम, फिर tests, evidence, review और उसके बाद production’ जैसा अधिक दिखता है।
शायद यही Argon से मिलने वाला ज़्यादा महत्वपूर्ण सबक है।
जैसे-जैसे models बड़ी इकाइयों में काम करने में सक्षम होते जाते हैं, verification को भी उनके साथ आगे बढ़ना ज़रूरी है।
लक्ष्य यह ज़रूरी नहीं कि हर individual AI action को कोई इंसान approve करे। ऐसा करने से automation का अधिकांश फ़ायदा ही खत्म हो जाएगा।
इसके बजाय, complex tasks में meaningful checkpoints हो सकते हैं, जहाँ system को यह evidence देना ज़रूरी हो कि उसका काम सही बना हुआ है।
किसी software migration के लिए इसका मतलब हो सकता है हर major component के बाद tests। Infrastructure optimization के लिए इसका मतलब हो सकता है किसी change के आगे बढ़ने से पहले performance measurements। Research के लिए इसका मतलब हो सकता है model को evidence पर conclusions बनाने देने से पहले उस evidence को validate करना।
delegated job जितना बड़ा होता है, ये checkpoints उतने ही महत्वपूर्ण हो जाते हैं। यही सबक किसी भी स्तर की autonomy के साथ काम करने वाले AI agents पर भी लागू होता है।
चित्र 3 के लिए सुलभ टेक्स्ट विवरण
एक लंबे समय तक चलने वाला task goal से शुरू होकर AI plan, एक work stage और evidence या tests से गुज़रता हुआ एक checkpoint तक पहुँचता है। इस checkpoint से रास्ता correct होकर वापस लूप कर सकता है, अगले stage तक जारी रह सकता है, या रुक सकता है। जारी रहने पर अगला stage, और evidence या tests, final validation, और अंत में delivery आती है। एक समापन कथन कहता है कि लक्ष्य हर action के लिए मानवीय approval नहीं है, लक्ष्य meaningful boundaries पर verification है।
Argon मज़बूत है, लेकिन leaderboard से ज़्यादा मायने काम रखता है
किसी model launch को एक ही सवाल तक सीमित करना आकर्षक लगता है: क्या Argon, GPT या Claude से बेहतर है?
उपलब्ध evidence इतने सरल निष्कर्ष का समर्थन नहीं करता।
Argon कुछ evaluations में आगे है और बाकी में दूसरे frontier models से पीछे रह जाता है। यह उपयोगी जानकारी है।
गंभीर काम के लिए models पर विचार कर रहे organizations को अब यह सवाल पूछने चाहिए: क्या यह हमारा खास task पूरा कर सकता है? इसे कितनी बार human intervention की ज़रूरत पड़ती है? कुछ गलत होने पर क्या यह recover कर सकता है? क्या हम result को verify कर सकते हैं? सफल completion की कीमत कितनी है?
ये सवाल इससे कहीं ज़्यादा मायने रखते हैं कि कोई model overall benchmark में कुछ points से आगे है या नहीं।
लंबे समय तक चलने वाले काम के लिए, मापने की उपयोगी इकाई धीरे-धीरे ‘यह model कितना intelligent है’ से हटकर ‘यह system काम कितनी reliably पूरा कर सकता है’ की ओर जा रही है।
क्या Gemini 4 Argon आपके लिए मायने रखना चाहिए?
हर किसी को Argon या long-horizon AI का गहराई से अध्ययन करने की ज़रूरत नहीं है।
| पाठक | गहराई | क्या मायने रखता है |
|---|---|---|
| सामान्य AI उपयोगकर्ता | जानें | अधिक context और अधिक execution time का मतलब automatically अधिक reliable results नहीं है। |
| Developer / knowledge worker | उपयोग करें | Argon जैसे models बड़े jobs संभाल सकते हैं, लेकिन महत्वपूर्ण काम को अब भी evidence और checkpoints की ज़रूरत है। |
| AI application builder | निपुण बनें | Long-running agents को model के इर्द-गिर्द state management, verification, recovery, observability और cost controls की ज़रूरत होती है। |
| Technology leader | जानें | AI का मूल्यांकन सिर्फ demonstrations से नहीं, बल्कि completed outcomes, intervention, verification और cost से करें। |
अगर आप Argon के साथ experiment कर रहे हैं, तो practical शुरुआत सबसे लंबा संभव task खोजना नहीं है।
- एक बड़ा task चुनें जिसका result आप independently verify कर सकें।
- यह तय करें कि success का मतलब क्या है।
- तय करें कि evidence कहाँ produce होना चाहिए।
- फिर यह मापें कि human intervention ज़रूरी होने से पहले model वास्तव में कितना काम पूरा कर सकता है।
यह आपको किसी benchmark score से कहीं अधिक बताता है।
Argon की असली परीक्षा यह नहीं कि वह कितनी देर काम कर सकता है
Gemini 4 Argon महत्वपूर्ण है क्योंकि Google frontier AI को काम की बड़ी इकाइयों की ओर आगे बढ़ा रहा है।
इसका बड़ा execution budget, मज़बूत independent results और Google के internal engineering examples यह संकेत देते हैं कि हम AI को जितना काम delegate कर सकते हैं, वह बढ़ रहा है।
लेकिन लंबा execution, भरोसेमंद execution के बराबर नहीं है।
Google का खुद testing, auditing और human review का उपयोग इस अंतर को और पुख्ता करता है।
इसलिए हो सकता है कि Argon की announcement में सबसे दिलचस्प आँकड़ा आख़िरकार एक million tokens न हो।
ज़्यादा महत्वपूर्ण माप यह होगी कि किसी के intervene करने की ज़रूरत पड़ने से पहले model कितना उपयोगी, verifiable काम पूरा कर सकता है।
यही वह आँकड़ा है जो तय करेगा कि long-running AI एक प्रभावशाली demonstration बनकर रह जाएगा या रोज़मर्रा के काम का एक भरोसेमंद हिस्सा बन जाएगा।
References and further reading
- Google — Gemini 4 Argon. Argon की घोषित capabilities, output-token expansion और software migration, optimization तथा scientific work से जुड़े Google के internal examples का प्राथमिक स्रोत। इस article में internal results को Google द्वारा रिपोर्ट किए गए evidence के रूप में पहचाना गया है। ↩
- Vals AI — Gemini 4 Argon. coding, professional और agentic benchmarks में Argon का independent evaluation। यह देखने के लिए उपयोगी कि task के अनुसार performance कैसे बदलता है, और Google की घोषित capabilities की तुलना independently tested configuration से करने के लिए। ↩
- Zapier — AutomationBench. वास्तविक tool workflows का उपयोग करते हुए realistic end-to-end business automation का मूल्यांकन करता है। यह समझने के लिए खासतौर पर उपयोगी कि benchmark में आगे रहने और हर task को reliably पूरा करने में क्या अंतर है। ↩
- Artificial Analysis — Gemini 4 Argon. Argon की सामान्य capability, long-context performance और अन्य frontier models के बीच उसकी स्थिति का एक अतिरिक्त independent आकलन प्रस्तुत करता है।