

Google యొక్క Gemini 4 Argon ఒక కొత్త frontier AI model లో కనిపించే సాధారణ సంకేతాలతో వచ్చింది. బలమైన benchmark ఫలితాలు, మెరుగైన reasoning, మరియు complex tasks లో మెరుగైన performance.
కానీ ఈ announcement లో ఒక భాగం మరో model leaderboard కంటే ఎక్కువ ఆసక్తికరంగా ఉంది.
Google Argon కు పనిచేయడానికి గణనీయంగా ఎక్కువ స్థలం ఇస్తోంది.
కంపెనీ ప్రకారం, Argon యొక్క output limit 64,000 tokens నుండి one million tokens వరకు పెంచబడుతోంది. పెద్ద software migrations, infrastructure optimization, scientific research వంటి పనులకు కూడా Google అంతర్గతంగా Argon agents ను ఉపయోగిస్తోంది.
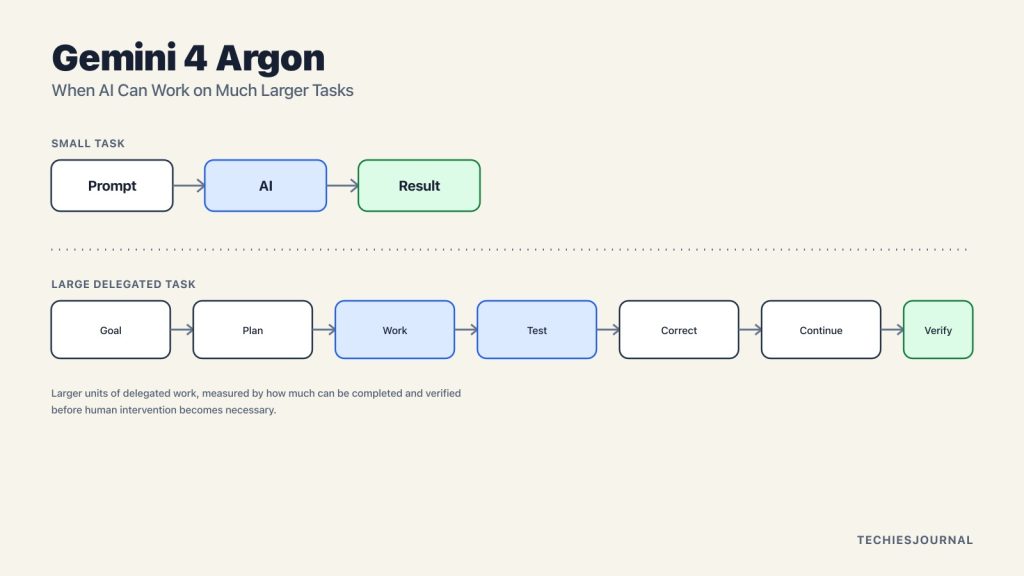
ఇది AI ను ఎలా ఉపయోగించవచ్చో అనే దానిలో ఒక పెద్ద మార్పును సూచిస్తుంది.
ఒక model ను ఒక చిన్న task పూర్తి చేయమని అడగడం బదులు, developers దానికి చాలా పెద్ద objective ఇచ్చి, మధ్యలో ఉండే steps ను ఎక్కువగా అదే పూర్తి చేయనివ్వడం పెరగవచ్చు.
ముఖ్యమైన ప్రశ్న ఇక కేవలం model ఎంత capable అనేది మాత్రమే కాదు. అది దాని పని తనిఖీ చేయడానికి ముందు ఎంత పనిని సురక్షితంగా delegate చేయవచ్చు అనేది కూడా.
Gemini 4 Argon ఆ సమస్య గురించి మనకు ఒక ప్రారంభ చూపును ఇస్తుంది.
Gemini 4 Argon లో వేరుగా ఏముంది?
Argon Google యొక్క తాజా frontier Gemini model, ముఖ్యంగా complex professional మరియు agentic work కోసం design చేయబడింది.
ఒక పెద్ద context window దీనిని గణనీయమైన మొత్తంలో information తో పనిచేయడానికి అనుమతిస్తుంది.
Google దీని output-token limit ను one million tokens వరకు కూడా విస్తరిస్తోంది, దీనివల్ల complicated tasks కోసం model కు చాలా పెద్ద execution budget లభిస్తుంది.
ఈ రెండు సంఖ్యలు వేర్వేరు విషయాలను వివరిస్తాయి.
Context model ఎంత information ను దృష్టిలో ఉంచుకోగలదో తెలియజేస్తుంది. Output budget అది ఎంత పనిని generate చేయగలదో తెలియజేస్తుంది.
ఈ రెండు సంఖ్యల్లో ఏదీ model ఒక పొడవైన task పొడవునా correct గా ఉంటుందా లేదా అని చెప్పదు.
ఆ మూడవ ప్రశ్న, అంటే చాలా connected steps లో reliability, Argon ను ముఖ్యంగా ఆసక్తికరంగా చేసే చోటు.
చిత్రం 1 కోసం టెక్స్ట్ వివరణ
మూడు వేర్వేరు ప్రశ్నలు పక్కపక్కనే ఉంటాయి. మొదటిది context, అంటే documents, code, history, గత actions వంటి వాటిని AI ఎంత దృష్టిలో ఉంచుకోగలదో అనేది. రెండోది execution, అంటే plan చేయడం, act చేయడం, observe చేయడం, revise చేయడం, కొనసాగించడం ద్వారా అది ఎంత పనిని ఉత్పత్తి చేస్తూ ఉండగలదో అనేది. మూడోది reliability, అంటే decisions పెరుగుతున్న కొద్దీ అది correct గా ఉంటుందా లేదా అనేది, దీనికి తప్పులు గుర్తించడం, కోలుకోవడం, verify చేయడం, సరిగ్గా పూర్తి చేయడం అవసరం. మధ్యలో ఉన్న ఒక statement ఇలా చెబుతుంది, ఎక్కువ context మరియు ఎక్కువ execution కలిపితే guaranteed reliability రాదు. పెద్ద context windows మరియు output budgets AI కు పనిచేయడానికి ఎక్కువ స్థలం ఇస్తాయి, కానీ అవి తమంతట తాముగా ఒక పొడవైన decisions క్రమం correct గా ఉంటుందని guarantee చేయవు.
Google ఇప్పటికే Argon ను చాలా పెద్ద jobs పై test చేస్తోంది
Google యొక్క అత్యంత ఆసక్తికరమైన Argon examples లో కొన్ని software engineering నుండి వచ్చాయి.
C మరియు C++ software ను Rust కు migrate చేయడంలో సహాయం కోసం Argon agents ను ఉపయోగించినట్లు Google నివేదిస్తోంది.[1]
ఈ projects పదివేల లైన్ల code ఉన్న libraries నుండి మొదలుకొని, Fuchsia Zircon kernel లో 800,000 లైన్ల కంటే ఎక్కువ involve అయ్యే పని వరకు విస్తరించి ఉన్నాయి.
మరో example Google యొక్క open-source video decoder అయిన libgav1 కు సంబంధించింది.
Google ప్రకారం, Argon agents ఇప్పటికే ఉన్న Rust implementation ను పదేపదే profile చేసి, compiler behaviour ను పరిశీలించి, దాదాపు 32,000 లైన్ల SIMD-సంబంధిత code ను replace చేశాయి.
ఫలితంగా వచ్చిన implementation మునుపటి Rust port కంటే 2.7 రెట్లు వేగంగా run అవుతుందని, అదే సమయంలో identical video output ఇస్తుందని Google నివేదిస్తోంది.
Infrastructure optimization, scientific research, ఇతర complex internal పనుల కోసం కూడా Argon ను ఉపయోగిస్తున్నట్లు Google వివరిస్తోంది.
ఈ examples ముఖ్యమైనవి ఎందుకంటే frontier agents ఎలాంటి పనిని నిర్వహించడం ప్రారంభిస్తున్నాయని Google నమ్ముతుందో ఇవి చూపిస్తాయి.
కానీ వీటికి ఒక ముఖ్యమైన label అవసరం. ఇవి Google నివేదించిన అంతర్గత ఫలితాలు. ఈ review సమయంలో, అతిపెద్ద projects కు సమానమైన scale లో independent reproductions మాకు కనిపించలేదు.
చిత్రం 2 కోసం టెక్స్ట్ వివరణ
Gemini 4 Argon నాలుగు నివేదించిన use areas తో connect అయి చూపబడింది. మొదటిది software migration, అంటే Fuchsia Zircon kernel తో సహా C మరియు C++ code ను Rust కు మార్చడం. రెండోది code optimization, అంటే Rust libgav1 implementation ను profile చేయడం, analyze చేయడం, రాయడం, benchmark చేయడం. మూడోది infrastructure, అంటే optimization అవకాశాలను గుర్తించడానికి operational data ను analyze చేయడం. నాలుగోది scientific work, అంటే పొడవైన multi-stage reasoning మరియు experimentation. ఇవి Google నివేదించిన అంతర్గత examples మాత్రమేనని, పూర్తి projects కు independent reproduction కాదని స్పష్టంగా గుర్తించబడిన ఒక note పేర్కొంటుంది.
Independent testing Argon యొక్క బలాన్ని సమర్థిస్తుంది, కానీ ప్రతి claim ను కాదు
Independent evaluations నేటి leading frontier models లో Argon ను చేర్చుతున్నాయి.
Vals AI ప్రస్తుతం తన overall model index లో Argon ను మొదటి స్థానంలో ranks చేస్తుంది.[2]
కానీ individual ఫలితాలు అంత uniform గా లేవు.
Code migration, professional tasks వంటి areas లో Argon బలంగా ranks అవుతుంది, కానీ కొన్ని terminal మరియు computer-use evaluations లో తక్కువ performance చూపుతుంది.
ఇది ముఖ్యం ఎందుకంటే agentic work లో మంచిది అని పిలవదగ్గ ఒకే ఒక్క capability ఏదీ లేదు. ఒక model code migrate చేయడంలో excellent గా ఉంటూనే, terminal operate చేయడంలో లేదా software ను visually navigate చేయడంలో తక్కువ reliable గా ఉండవచ్చు.
ఒక ప్రత్యేకంగా ఉపయోగకరమైన ఫలితం Zapier యొక్క AutomationBench నుండి వస్తుంది.[3]
ఈ benchmark sales, marketing, finance, support, operations వంటి areas లోని tools ను involve చేసే realistic business workflows ను test చేస్తుంది.
Argon ప్రస్తుతం దాదాపు 51% score తో ఈ benchmark ను lead చేస్తోంది.
ఈ ranking ఆకట్టుకునేది. కానీ percentage ఎక్కువ informative గా ఉంది.
ఒక leading frontier model కూడా ఈ realistic end-to-end tasks లో గణనీయమైన భాగంలో విఫలమవుతుంది.
Autonomous AI గురించి claims ను అర్థం చేసుకునేటప్పుడు ఇది ఒక ముఖ్యమైన గుర్తు చేయడం.
Lead చేయడం అంటే reliable అని కాదు
Zapier యొక్క AutomationBench ప్రస్తుతం Gemini 4 Argon ను సుమారు 51% వద్ద ఉంచుతుంది. ఉపయోగకరమైన అర్థం కేవలం Argon benchmark ను lead చేస్తోంది అని మాత్రమే కాదు. ఒక leading frontier model కూడా realistic end-to-end automation tasks లో గణనీయమైన భాగంలో విఫలమవుతుంది అని.
మూలం: Zapier AutomationBench, October 1, 2026 నాటికి review చేయబడింది.
One-million-token claim నిజానికి అంటే ఏమిటి?
గతంలో 64,000 తో పోలిస్తే, Argon యొక్క output-token limit ను one million tokens వరకు విస్తరిస్తున్నట్లు Google చెబుతోంది.
ఇది సూటిగా వినిపిస్తుంది, కానీ దీనికి context అవసరం.
ఒక పెద్ద output budget model ను చాలా పొడవైన tasks ద్వారా కొనసాగించి పనిచేయడానికి అవకాశం ఇవ్వవచ్చు. ప్రతి extra token ఫలితాన్ని మెరుగుపరుస్తుందని దీని అర్థం కాదు.
ఒక పెద్ద software migration ను పరిగణించండి. ఒక AI code ను inspect చేసి, ఒక plan రూపొందించి, components ను మార్చి, compile చేసి, test చేసి, failures ను పరిశీలించి, revise చేసి కొనసాగించవచ్చు.
ఆ sequence లో ప్రారంభంలోనే ఒక poor architectural decision తీసుకుంటే, తర్వాతి పని ఆ తప్పుపైనే నిర్మించబడవచ్చు.
Model ఇప్పటికీ original objective ను గుర్తుంచుకోవచ్చు. దాని దగ్గర ఇంకా plenty tokens అందుబాటులో ఉండవచ్చు. కానీ అయినప్పటికీ task drift కావచ్చు.
గమనించదగ్గ ఒక availability వివరం కూడా ఉంది.
Google one million tokens వరకు output ను announce చేసినప్పటికీ, తాను independent గా test చేసిన Argon configuration లో చిన్న maximum output setting ఉన్నట్లు Vals నివేదిస్తోంది.[2]
ఇది ఒక contradiction కాకుండా rollout, product లేదా API తేడాలను ప్రతిబింబించవచ్చు.
పాఠకుల కోసం, practical తేడా సులభమైనది. ఒక announce చేసిన model capability ప్రతి product లేదా evaluation environment లో అందుబాటులో ఉండే limit తో తప్పనిసరిగా identical గా ఉండకపోవచ్చు.
Google యొక్క స్వంత workflow మనకు ఒక ముఖ్యమైన విషయాన్ని చెబుతుంది
Google యొక్క software-migration examples లో మరో ఉపయోగకరమైన వివరం ఉంది.
Critical AI-generated migrations ఆటోమేటిక్ గా production కు సిద్ధంగా ఉన్నాయని కంపెనీ చెప్పదు.
Deployment కు ముందు ముఖ్యమైన migrations automated testing, emulation, manual auditing, review ద్వారా వెళ్తాయని Google చెబుతోంది.
కాబట్టి అసలు workflow AI నేరుగా production కు వెళ్లడం లాగా కాకుండా, AI పని తర్వాత tests, evidence, review, తర్వాత production అన్న క్రమంలో ఎక్కువగా కనిపిస్తుంది.
Argon నుండి నేర్చుకోవాల్సిన ఎక్కువ ముఖ్యమైన పాఠం ఇదే కావచ్చు.
Models పెద్ద units పని చేయగలిగేలా మారుతున్న కొద్దీ, verification కూడా వాటితోపాటు కదలాలి.
ప్రతి individual AI action ను ఒక human approve చేయడం తప్పనిసరిగా లక్ష్యం కాదు. అలా చేస్తే automation యొక్క ప్రయోజనంలో చాలా భాగం పోతుంది.
బదులుగా, complex tasks లో meaningful checkpoints ఉండవచ్చు, అక్కడ system తన పని correct గా ఉందని evidence ఇవ్వాల్సి ఉంటుంది.
ఒక software migration కోసం, దీని అర్థం ప్రతి major component తర్వాత tests కావచ్చు. Infrastructure optimization కోసం, ఒక change కొనసాగే ముందు performance measurements కావచ్చు. Research కోసం, model దాని పై conclusions నిర్మించే ముందు evidence ను validate చేయడం కావచ్చు.
Delegate చేసిన job ఎంత పెద్దదైతే, ఆ checkpoints అంత ముఖ్యమవుతాయి. ఏ స్థాయి autonomy తో పనిచేసే AI agents కు కూడా ఇదే పాఠం వర్తిస్తుంది.
చిత్రం 3 కోసం టెక్స్ట్ వివరణ
ఒక దీర్ఘకాలం నడిచే task ఒక goal నుండి మొదలై, AI plan, ఒక work stage, evidence లేదా tests గుండా వెళ్లి, ఒక checkpoint కు చేరుకుంటుంది. ఈ checkpoint నుండి, path correct చేసుకుని వెనక్కు loop కావచ్చు, తర్వాతి stage కు కొనసాగవచ్చు, లేదా ఆగిపోవచ్చు. కొనసాగించడం తర్వాతి stage కు, మరింత evidence లేదా tests కు, final validation కు, డెలివరీ కు దారి తీస్తుంది. ముగింపు statement ఇలా చెబుతుంది, లక్ష్యం ప్రతి action కు human approval కాదు, లక్ష్యం meaningful boundaries వద్ద verification.
Argon బలంగా ఉంది, కానీ leaderboard కంటే job ఎక్కువ ముఖ్యం
ఒక model launch ను ఒకే ప్రశ్నకు తగ్గించాలని అనిపించవచ్చు: Argon GPT లేదా Claude కంటే better నా?
అందుబాటులో ఉన్న evidence అంత సులభమైన conclusion ను support చేయదు.
Argon కొన్ని evaluations లో lead చేస్తుంది, మరికొన్నింటిలో ఇతర frontier models కంటే వెనుకబడి ఉంటుంది. ఇది ఉపయోగకరమైన information.
Serious work కోసం models ను పరిగణించే organizations ఎక్కువగా ఇలా అడగాలి: ఇది మా నిర్దిష్ట task ను పూర్తి చేయగలదా? దీనికి ఎంత తరచుగా human intervention అవసరం? ఏదైనా తప్పు జరిగితే ఇది recover అవగలదా? మేము ఫలితాన్ని verify చేయగలమా? విజయవంతమైన completion కు ఎంత ఖర్చవుతుంది?
ఒక model overall benchmark లో కొన్ని points తేడాతో lead చేస్తుందా అన్నదానికంటే ఈ ప్రశ్నలే ఎక్కువ ముఖ్యం.
Long-running పని కోసం, ఉపయోగకరమైన కొలమానం క్రమంగా ఈ model ఎంత intelligent అనేది నుండి ఈ system job ను ఎంత reliably పూర్తి చేయగలదు అనేదానికి మారుతోంది.
Gemini 4 Argon మీకు ముఖ్యమా?
ప్రతి ఒక్కరూ Argon ను లేదా long-horizon AI ను లోతుగా study చేయాల్సిన అవసరం లేదు.
| పాఠకుడు | లోతు | ఏమి ముఖ్యం |
|---|---|---|
| సాధారణ AI వినియోగదారు | తెలుసుకోండి | ఎక్కువ context మరియు ఎక్కువ execution time ఆటోమేటిక్గా ఎక్కువ reliable ఫలితాలు అని అర్థం కాదు. |
| Developer / knowledge worker | ఉపయోగించండి | Argon లాంటి models పెద్ద jobs చేపట్టగలవు, కానీ ముఖ్యమైన పనికి ఇప్పటికీ evidence మరియు checkpoints అవసరం. |
| AI application builder | నైపుణ్యం సాధించండి | Long-running agents కు model చుట్టూ state management, verification, recovery, observability, cost controls అవసరం. |
| Technology leader | తెలుసుకోండి | AI ను కేవలం demonstrations ఆధారంగా కాకుండా, పూర్తయిన outcomes, intervention, verification, cost ఆధారంగా evaluate చేయండి. |
మీరు Argon తో experiment చేస్తుంటే, practical ప్రారంభ బిందువు సాధ్యమైనంత పొడవైన task ను వెతకడం కాదు.
- మీరు independent గా verify చేయగల ఫలితం ఉన్న ఒక పెద్ద task ను ఎంచుకోండి.
- Success అంటే ఏమిటో నిర్వచించండి.
- Evidence ఎక్కడ ఉత్పత్తి కావాలో నిర్ణయించండి.
- తర్వాత human intervention అవసరం అయ్యే ముందు model వాస్తవంగా ఎంత పనిని పూర్తి చేయగలదో కొలవండి.
ఇది ఒక benchmark score కంటే మీకు చాలా ఎక్కువ చెబుతుంది.
Argon యొక్క నిజమైన test అది ఎంతసేపు పనిచేయగలదు అనేది కాదు
Gemini 4 Argon ముఖ్యమైనది ఎందుకంటే Google frontier AI ను పెద్ద units పని వైపుకు నెడుతోంది.
దీని పెద్ద execution budget, బలమైన independent ఫలితాలు, Google యొక్క అంతర్గత engineering examples మనం AI కు delegate చేయగల పని మొత్తం పెరుగుతోందని సూచిస్తున్నాయి.
కానీ పొడవైన execution dependable execution తో సమానం కాదు.
Google స్వంతంగా testing, auditing, human review ను ఉపయోగించడం ఈ తేడాను బలపరుస్తుంది.
కాబట్టి Argon యొక్క announcement లో అత్యంత ఆసక్తికరమైన సంఖ్య చివరికి one million tokens కాకపోవచ్చు.
ఎక్కువ ముఖ్యమైన కొలమానం ఎవరైనా intervene అవ్వాల్సి రాకముందు model ఎంత ఉపయోగకరమైన, verifiable పనిని పూర్తి చేయగలదు అనేదే అవుతుంది.
Long-running AI ఒక impressive demonstration గా మిగిలిపోతుందా లేదా everyday work లో dependable భాగంగా మారుతుందా అన్నది నిర్ణయించే సంఖ్య ఇదే.
References and further reading
- Google — Gemini 4 Argon. Argon యొక్క announce చేసిన capabilities, output-token విస్తరణ, software migration, optimization, scientific work కు సంబంధించిన Google యొక్క అంతర్గత examples కు ఇది ప్రాథమిక మూలం. ఈ article లోని అంతర్గత ఫలితాలు Google నివేదించిన evidence గా గుర్తించబడ్డాయి. ↩
- Vals AI — Gemini 4 Argon. Coding, professional, agentic benchmarks లో Argon యొక్క independent evaluation. Performance task ను బట్టి ఎలా మారుతుందో చూడటానికి, Google announce చేసిన capabilities ను independent గా test చేసిన configuration తో పోల్చడానికి ఇది ఉపయోగకరం. ↩
- Zapier — AutomationBench. వాస్తవ tool workflows ఉపయోగించి realistic end-to-end business automation ను evaluate చేస్తుంది. ఒక benchmark ను lead చేయడానికి, ప్రతి task ను reliably పూర్తి చేయడానికి మధ్య తేడాను అర్థం చేసుకోవడానికి ఇది ముఖ్యంగా ఉపయోగకరం. ↩
- Artificial Analysis — Gemini 4 Argon. Argon యొక్క general capability, long-context performance, ఇతర frontier models మధ్య దాని స్థానం గురించి అదనపు independent assessment ను అందిస్తుంది.