

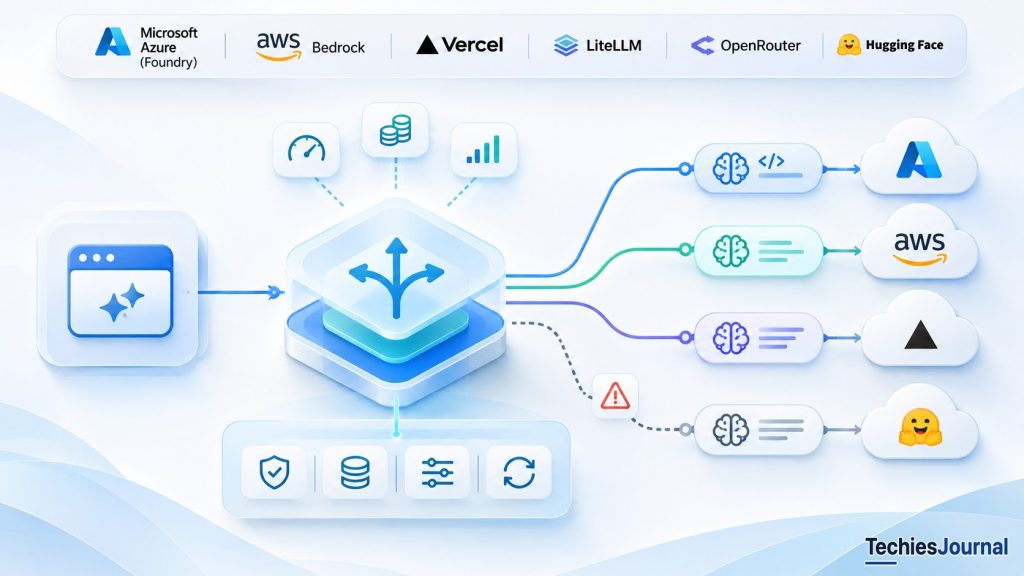
यह समझिए कि सीधे AI API कब पर्याप्त हैं, मॉडल राउटिंग कैसे काम करती है और कौन सी आर्किटेक्चर समस्याएँ एक अतिरिक्त परत को उचित ठहराती हैं।
एक कंपनी अपने कस्टमर-सपोर्ट इंजीनियरों को तकनीकी घटनाएँ सुलझाने में मदद के लिए एक AI असिस्टेंट शुरू करती है। पहला संस्करण सीधा-सादा है। जब कोई इंजीनियर टिकट खोलता है, तो एप्लिकेशन घटना का विवरण निकालता है, उसे एक भाषा मॉडल को भेजता है और अगले क़दमों के सुझावों के साथ एक सारांश पाता है।
टीम एक प्रोवाइडर API के ज़रिए एक ही मॉडल इस्तेमाल करती है। नतीजे अपने इच्छित उपयोग के लिए पर्याप्त सटीक हैं, जवाब का समय स्वीकार्य है और संचालन की लागत संभालने लायक है। कोई model router, AI gateway या जटिल इन्फ़रेंस इंफ़्रास्ट्रक्चर नहीं है। इससे भी ज़रूरी बात यह है कि उसे लाने का कोई कारण भी नहीं है।
छह महीने बाद असिस्टेंट हज़ारों टिकट वर्गीकृत करता है, लंबी बातचीत का सारांश बनाता है, कठिन घटनाओं की जाँच करता है और ग्राहकों के लिए जवाब का मसौदा तैयार करता है। कुछ काम सरल हैं, जबकि कुछ के लिए अधिक सक्षम मॉडल चाहिए। लागत बढ़ गई है और कभी-कभार प्रोवाइडर की रेट लिमिट प्रोसेसिंग में रुकावट डालती है।
डेवलपर model router देखना शुरू करते हैं। लेकिन कोई उत्पाद चुनने से पहले उन्हें यह पहचानना होगा कि वे कौन सी समस्या सुलझाना चाहते हैं। अलग-अलग राउटिंग तकनीकें अलग-अलग फ़ैसले लेती हैं। ग़लत तकनीक लाने से एप्लिकेशन बेहतर हुए बिना जटिलता बढ़ सकती है।
असली सवाल यह है कि एप्लिकेशन की ज़रूरतें मॉडल या प्रोवाइडर के चयन को कब इतना अहम बना देती हैं कि उसे अलग से संभालना उचित हो।
सीधा मॉडल एक्सेस अक्सर काफ़ी होता है
AI एप्लिकेशन आम तौर पर प्रोवाइडर API को अनुरोध भेजता है। मॉडल चलाने के लिए ज़रूरी कंप्यूटिंग संसाधन प्रोवाइडर चलाता है। एप्लिकेशन फिर भी तय करता है कि क्या पूछना है, क्रेडेंशियल की सुरक्षा करता है, आउटपुट की जाँच करता है और आगे की किसी भी बिज़नेस कार्रवाई को नियंत्रित करता है।
यह एक व्यावहारिक प्रोडक्शन आर्किटेक्चर है। अगर कोई उपयुक्त मॉडल वर्कलोड की गुणवत्ता, लेटेंसी, उपलब्धता और लागत की ज़रूरतें पूरी करता है, तो राउटिंग सेवा की कोई सिद्ध भूमिका नहीं है। सीधा इंटीग्रेशन यह जानना भी आसान बनाता है कि अनुरोध कहाँ चलते हैं और समस्या आने पर किस सेवा की जाँच करनी है।
सपोर्ट असिस्टेंट में शुरुआत में दो अनुमान-योग्य वर्कफ़्लो हैं। एक तय मॉडल दोनों को ठीक-ठाक संभाल लेता है। एक और नेटवर्क हॉप, एक और पॉलिसी कॉन्फ़िगरेशन और एक और संचालन निर्भरता जोड़ने से पहले डेवलपरों को उस इंटीग्रेशन की असली सीमाएँ नापनी चाहिए।
पहली जटिलता तब आती है जब हर काम के लिए एक ही मॉडल उचित न हो। नियमित वर्गीकरण और जटिल घटना विश्लेषण की ज़रूरतें अलग होती हैं। एप्लिकेशन पहले के लिए एक छोटा जाँचा-परखा मॉडल और दूसरे के लिए अधिक सक्षम मॉडल इस्तेमाल कर सकता है। यह चुनाव वह एप्लिकेशन कोड में साफ़ तौर पर लागू कर सकता है। यह समर्पित राउटर के बिना मॉडल चयन है।
दूसरी जटिलता तब आती है जब चुना हुआ मॉडल कई एक्ज़ीक्यूशन प्रोवाइडर से उपलब्ध हो। एक प्रोवाइडर सस्ता हो सकता है, दूसरा तेज़ और तीसरा अधिक माँग के समय ज़्यादा उपलब्ध। यह प्रोवाइडर चयन है, एक अलग फ़ैसला, जो अलग राउटिंग इंफ़्रास्ट्रक्चर को उचित ठहरा सकता है।
मॉडल एक्सेस को व्यवस्थित करने के तीन तरीक़े
एप्लिकेशन सारे चयन-फ़ैसले अपने कोड में रख सकता है। वह एक साझा राउटिंग कंपोनेंट ला सकता है जिसका स्वामित्व और रखरखाव उसके पास हो। या वह समर्थित फ़ैसले समर्पित राउटिंग इंफ़्रास्ट्रक्चर को सौंप सकता है, चाहे वह मैनेज्ड सेवा हो या सेल्फ़-होस्टेड गेटवे।
इस चित्र का सुलभ पाठ विकल्प
तीन लेआउट की तुलना: एप्लिकेशन से प्रोवाइडर का सीधा कनेक्शन, दो प्रोवाइडर तक एप्लिकेशन की आंतरिक राउटिंग और दो प्रोवाइडर तक ले जाने वाली अलग राउटर सेवा।
चित्र में दिखाया गया पाठ: AI एप्लिकेशन जोड़ने के तीन तरीक़े | राउटिंग की ज़िम्मेदारी की जगह बदलती है, नतीजे जाँचने की बुनियादी ज़रूरत नहीं | A. सीधा API | B. एप्लिकेशन राउटिंग | C. समर्पित राउटर | एप्लिकेशन | तय मॉडल चयन | बिज़नेस नियम और जाँच | प्रोवाइडर API | एक एक्ज़ीक्यूशन ठिकाना | राउटिंग लॉजिक | ऐप टीम का कोड | राउटर या गेटवे | मैनेज्ड या सेल्फ़-होस्टेड | प्रोवाइडर A | प्रोवाइडर B | अतिरिक्त राउटिंग सेवा नहीं | टीम राउटिंग संभालती है | नई स्वतंत्र सेवा सीमा
एप्लिकेशन-प्रबंधित राउटिंग एक छोटा फ़ंक्शन हो सकता है जो हर काम को एक स्वीकृत मॉडल से जोड़ता है। जब केवल कुछ स्थिर वर्कफ़्लो हों, तब इसे अलग प्लेटफ़ॉर्म की तुलना में संभालना आसान हो सकता है। जैसे-जैसे अधिक एप्लिकेशन को साझा प्रोवाइडर क्रेडेंशियल, फ़ेलओवर, उपयोग सीमाएँ और रिपोर्टिंग चाहिए, केंद्रीकृत राउटिंग दोहराए गए कोड को घटा सकती है। फिर भी मैनेज्ड राउटर एक बाहरी निर्भरता बन जाता है और सेल्फ़-होस्टेड गेटवे एक और सेवा बन जाता है जिसे सुरक्षित ढंग से चलाना पड़ता है।
ये तरीक़े विकल्प हैं, कोई तय क्रम नहीं। आर्किटेक्चर को सिद्ध ज़रूरतों के पीछे चलना चाहिए।
मॉडल राउटिंग और प्रोवाइडर राउटिंग एक-दूसरे की जगह नहीं ले सकतीं
मान लीजिए सपोर्ट असिस्टेंट को दो अनुरोध मिलते हैं। एक टिकट को पासवर्ड, नेटवर्क या एप्लिकेशन समस्या के रूप में वर्गीकृत करता है। दूसरा कई सिस्टम से आए परस्पर विरोधी साक्ष्य वाली एक जटिल घटना की जाँच करता है।
एप्लिकेशन वर्गीकरण के लिए Model A और घटना विश्लेषण के लिए Model B चुन सकता है। मॉडल राउटिंग तय करती है कि काम कौन सा मॉडल करेगा।
अब मान लीजिए Model B दो स्वीकृत इन्फ़रेंस प्रोवाइडर के ज़रिए चल सकता है। एप्लिकेशन मॉडल चुन चुका है, फिर भी राउटर यह चुन सकता है कि वह कहाँ चले। प्रोवाइडर राउटिंग पहले से चुने गए मॉडल के लिए एक्ज़ीक्यूशन का ठिकाना चुनती है।
इस चित्र का सुलभ पाठ विकल्प
घटना अनुरोध जाँचे हुए मॉडल चयन, स्वीकृत प्रोवाइडर पात्रता और वैकल्पिक एक्ज़ीक्यूशन ठिकानों तक जाता है, जबकि एक प्रोवाइडर पॉलिसी से बाहर रखा गया है।
चित्र में दिखाया गया पाठ: मॉडल चयन प्रोवाइडर चयन नहीं है | प्रोवाइडर चुनने से पहले मॉडल काम के लिए उपयुक्त होना चाहिए | घटना अनुरोध | काम और ज़रूरतें पहचानें | जाँचा हुआ मॉडल चुनें | नियमित: Model A | जटिल: Model B | पात्रता लागू करें | पैरामीटर, सुरक्षा और प्रोवाइडर पॉलिसी | Provider 1 | पात्र ठिकाना | Provider 2 | Provider 3 बाहर | वर्कलोड के लिए स्वीकृत नहीं | एप्लिकेशन जाँच | केवल स्वीकृत आउटपुट लें | एक्ज़ीक्यूशन के बाद नतीजा एप्लिकेशन को लौटाएँ
फ़ॉलबैक फिर से अलग चीज़ है। किसी विफलता के बाद सिस्टम उसी मॉडल के लिए कोई दूसरा पात्र प्रोवाइडर आज़मा सकता है, या उसे किसी दूसरे मॉडल को आज़माने के लिए कॉन्फ़िगर किया जा सकता है। दूसरे मॉडल पर जाने से गुणवत्ता, संरचना और क्षमताएँ प्रभावित हो सकती हैं, इसलिए बैकअप मॉडलों का मूल्यांकन उस काम के लिए करना होगा, उन्हें बराबर मान लेना ठीक नहीं होगा।
कुछ उत्पाद इन तंत्रों को जोड़ देते हैं। Microsoft Foundry Model Router और Amazon Bedrock Intelligent Prompt Routing अपने-अपने दायरे और सीमाओं के साथ स्वचालित मॉडल चयन का उदाहरण देते हैं। OpenRouter प्रोवाइडर राउटिंग और पॉलिसी नियंत्रणों का दस्तावेज़ देता है। Vercel AI Gateway प्रोवाइडर राउटिंग और कॉन्फ़िगर किए गए मॉडल फ़ॉलबैक का दस्तावेज़ देता है। LiteLLM मॉडल समूह, डिप्लॉयमेंट राउटिंग, रीट्राई और फ़ॉलबैक का दस्तावेज़ देता है।
ये अलग-अलग तंत्रों के उदाहरण हैं। ये इस बात का साक्ष्य नहीं हैं कि सभी उत्पाद एक जैसा व्यवहार देते हैं या कोई एक उत्पाद हर जगह बेहतर है।
एक घटना अनुरोध का राउटर से होकर गुज़रना
असिस्टेंट को एक घटना मिलती है जिसमें त्रुटि इतिहास, सेवा विवरण और समस्या-निवारण नोट्स हैं। उसे श्रेणी, संभावित कारण, गंभीरता और समर्थक साक्ष्य के साथ एक संरचित आकलन चाहिए। यह परिदृश्य काल्पनिक है और नियंत्रण की सीमाएँ दिखाने के लिए है, किसी वेंडर के सटीक कार्यान्वयन को दिखाने के लिए नहीं।
पहले एप्लिकेशन इस काम को जटिल विश्लेषण के रूप में पहचानता है। उसका परखा हुआ राउटिंग कॉन्फ़िगरेशन Model B की अनुमति देता है। Model A नियमित वर्गीकरण के लिए स्वीकृत है, पर इस काम की गुणवत्ता-ज़रूरत पर खरा नहीं उतरा है। राउटर उसे केवल इसलिए नहीं चुन सकता कि वह सस्ता है।
इसके बाद एक्ज़ीक्यूशन का ठिकाना सीमित किया जाता है। Provider 1 और Provider 2 Model B को सपोर्ट करते हैं और संगठन की डेटा-प्रोसेसिंग तथा इंटरफ़ेस ज़रूरतें पूरी करते हैं। Provider 3 कम कीमत देता है, पर इन घटना रिकॉर्ड को संभालने के लिए स्वीकृत नहीं है। लागत और गति पर विचार करने से पहले ही Provider 3 को बाहर कर दिया जाता है।
राउटर अपनी कॉन्फ़िगर की गई चयन पॉलिसी के आधार पर Provider 1 को चुनता है। प्रोवाइडर अनुरोध को प्रोसेस करता है और जवाब लौटाता है। एप्लिकेशन जाँचता है कि ज़रूरी फ़ील्ड मौजूद हैं, उनके मान वैध हैं और आकलन वर्कफ़्लो के लिए स्वीकार्य है। जाँच के बाद ही एप्लिकेशन उसे सहेजता है या उस पर कार्रवाई करता है।
यह ज़िम्मेदारी की एक सीमा को दिखाता है। राउटर एक पात्र एक्ज़ीक्यूशन रास्ता चुनता है और उसे चलाता है। नतीजा वैध है या नहीं और उसके बाद कौन सी बिज़नेस कार्रवाई, अगर कोई हो, की जाए, यह एप्लिकेशन तय करता है।
विफलता से उबरने की सीमाएँ हैं
मान लीजिए Provider 1 क्षमता सीमा तक पहुँच जाने के कारण जनरेशन से पहले ही अनुरोध अस्वीकार कर देता है। अगर कॉन्फ़िगर की गई पॉलिसी रीट्राई की अनुमति देती है और Provider 2 अब भी पात्र है, तो राउटर अनुरोध को वहाँ आज़मा सकता है।
स्थिति तब बदल जाती है जब Provider 1 जवाब स्ट्रीम करना शुरू करता है और कनेक्शन बीच में टूट जाता है। Provider 2 आम तौर पर पहले प्रोवाइडर की आंतरिक जनरेशन स्थिति से आगे नहीं बढ़ सकता। नया प्रयास जनरेशन फिर से शुरू कर सकता है और अलग उत्तर दे सकता है।
इस चित्र का सुलभ पाठ विकल्प
प्रोवाइडर की जल्दी अस्वीकृति पॉलिसी से नियंत्रित रीट्राई की अनुमति देती है। टूटी स्ट्रीम को रिकवरी नियम चाहिए, और दोनों में एप्लिकेशन जाँच और साइड-इफ़ेक्ट सुरक्षा चाहिए।
चित्र में दिखाया गया पाठ: फ़ेलओवर और वर्कफ़्लो रिकवरी अलग हैं | विफलता का बिंदु तय करता है कि क्या सुरक्षित रीट्राई हो सकता है | इन्फ़रेंस अनुरोध | चुना मॉडल और स्वीकृत प्रोवाइडर | प्रोवाइडर A | अनुरोध आज़माया गया | जल्दी अस्वीकृत | जनरेशन शुरू नहीं हुआ | प्रोवाइडर B रीट्राई | केवल पात्र होने पर | स्ट्रीम टूटी | अधूरा नतीजा बेकार | रिकवरी पॉलिसी | दोबारा शुरू या सुरक्षित विफल | एप्लिकेशन नियंत्रण रखता है | पूरे आउटपुट की जाँच करें | दोहराए साइड-इफ़ेक्ट रोकें | राउटर फ़ॉलबैक से बिज़नेस रिकवरी की गारंटी नहीं
अगर एप्लिकेशन आंशिक जवाब पहले ही दिखा चुका है, तो उसे इस रुकावट को साफ़ ढंग से संभालना होगा। अगर जवाब संरचित डेटा है, तो अधूरा आउटपुट पूर्ण आकलन के रूप में स्वीकार नहीं किया जा सकता। अगर मॉडल का नतीजा टिकट अपडेट या बाहरी टूल कॉल शुरू करता है, तो आइडेम्पोटेंसी और ऑथराइज़ेशन एप्लिकेशन की ज़िम्मेदारी बने रहते हैं। मॉडल कॉल दोहराने से किसी पहले ही पूरे हो चुके ऑपरेशन का अनजाने में दोहराव नहीं होना ज़रूरी है।
रीट्राई की सटीक पॉलिसी और बीच-स्ट्रीम व्यवहार प्लेटफ़ॉर्म और कॉन्फ़िगरेशन पर निर्भर करते हैं। स्वचालित फ़ेलओवर का कोई सामान्य दावा हर प्रकार की विफलता से निर्बाध रिकवरी स्थापित नहीं करता।
गुणवत्ता और लागत को साथ-साथ नापना चाहिए
असिस्टेंट रोज़ हज़ारों अनुरोध प्रोसेस करता है और टीम इन्फ़रेंस खर्च घटाना चाहती है। छोटा मॉडल प्रति कॉल सस्ता पड़ता है, पर प्रोडक्शन ट्रैफ़िक को उसकी ओर भेजने को उचित ठहराने के लिए यह काफ़ी नहीं है।
एक उदाहरणात्मक मूल्यांकन लीजिए जिसमें Model A की लागत प्रति प्रयास $0.002 है और वह 75% बार स्वीकार्य वर्गीकरण नतीजे देता है। Model B की लागत $0.008 है और वह 99% बार स्वीकार्य नतीजे देता है। यह उदाहरण वास्तविक मॉडल बेंचमार्क या असली प्रोवाइडर बिलिंग का दावा नहीं करता। यह दिखाता है कि सूचीबद्ध टोकन कीमत अकेले निर्णय का अधूरा पैमाना क्यों है।
टीम को प्रति स्वीकृत नतीजा लागत, लेटेंसी, वैलिडेशन विफलताएँ, रीट्राई और किसी भी मानव समीक्षा की तुलना करनी चाहिए। उसे हर काम के लिए एक न्यूनतम गुणवत्ता स्तर भी तय करना चाहिए। जो सस्ता मॉडल ज़रूरी शर्तों पर विफल रहता है, वह केवल इसलिए पात्र विकल्प नहीं बन जाता कि उसके औसत आकर्षक दिखते हैं।
प्रोवाइडर राउटिंग में भी ऐसे ही आर्थिक समझौते होते हैं। OpenRouter की अक्टूबर 2026 की इंजीनियरिंग रिपोर्ट पहले टोकन के समय, अनुरोध की लेटेंसी और क्षमता त्रुटियों में सुधार बताती है, साथ ही प्रति हज़ार अनुरोध लागत में 6.0% की बढ़ोतरी भी। वेंडर द्वारा बताए गए ये नतीजे यह सिद्ध नहीं करते कि हर एप्लिकेशन को उसी पॉलिसी से फ़ायदा होगा।
एक प्रतिनिधि वर्कलोड और मौजूदा तय-मॉडल या तय-प्रोवाइडर बेसलाइन से शुरू कीजिए। अधिक जटिल राउटिंग पॉलिसी तभी अपनाइए जब देखा गया सुधार एप्लिकेशन के लिए अर्थपूर्ण हो।
गोपनीयता प्रतिबंध गति और कीमत से पहले आते हैं
सपोर्ट टिकटों में ग्राहक की जानकारी, आंतरिक लॉग या संवेदनशील तकनीकी विवरण हो सकते हैं। जब एक्ज़ीक्यूशन प्रोवाइडरों के बीच घूम सकता हो, तब हर अनुमत ठिकाने को लागू डेटा-हैंडलिंग, भौगोलिक, अनुबंध संबंधी और सुरक्षा ज़रूरतों पर खरा उतरना होगा।
राउटिंग सिस्टम जानता हो सकता है कि कौन से प्रोवाइडर किसी मॉडल को चला सकते हैं, पर यह जानना कि कौन से प्रोवाइडर संगठन की जानकारी प्रोसेस करने के लिए अधिकृत हैं, इससे अलग बात है। पात्रता को प्रदर्शन या लागत की रैंकिंग से पहले तय करना होगा।
उपलब्ध नियंत्रण सेवा और इंटीग्रेशन के अनुसार अलग होते हैं। ख़ास तौर पर, OpenRouter के सीधे API के लिए दस्तावेज़ीकृत कोई फ़ीचर अपने-आप Hugging Face इंटीग्रेशन के ज़रिए उपलब्ध नहीं माना जा सकता। Hugging Face की घोषणा दिखाती है कि एक मॉडल-एक्सेस प्लेटफ़ॉर्म ने प्रोवाइडर राउटिंग कैसे सौंपी, यह नहीं कि हर अंतर्निहित पॉलिसी उसी इंटरफ़ेस से कॉन्फ़िगर की जा सकती है।
प्रतिबंधित वर्कलोड के लिए, तय प्रोवाइडर या एक्ज़ीक्यूशन के सीमित रूप से स्वीकृत ठिकानों का समूह बेरोकटोक राउटिंग से अधिक उपयुक्त हो सकता है।
गेटवे एक व्यापक समन्वय समस्या सुलझाता है
कंपनी आख़िरकार कई AI एप्लिकेशन चलाने लगती है। हर एक के अपने क्रेडेंशियल, बजट जाँच, मॉडल कॉन्फ़िगरेशन और उपयोग रिपोर्ट हैं। साझा AI गेटवे इंफ़्रास्ट्रक्चर तब भी उपयोगी बन सकता है जब कुछ एप्लिकेशन तय मॉडल इस्तेमाल करते हों।
AI गेटवे एक्सेस नियंत्रण, कोटा, लॉगिंग, खर्च की दृश्यता और राउटिंग को केंद्रीकृत कर सकता है। यह व्यापक भूमिका इस बात से अलग है कि किसी प्रॉम्प्ट का उत्तर कौन सा मॉडल दे, यह अपने-आप तय हो। सेल्फ़-होस्टेड गेटवे के लिए संगठन को डिप्लॉयमेंट, सुरक्षा, स्केलिंग और अपग्रेड संभालने होंगे। मैनेज्ड गेटवे स्थानीय संचालन का कुछ काम घटाता है, पर सेवा की उपलब्धता और पॉलिसी पर निर्भरता जोड़ देता है।
डायनामिक राउटिंग ऑब्ज़र्वेबिलिटी भी बदल देती है। टीम को पता होना चाहिए कि असल में कौन सा मॉडल चला, किस प्रोवाइडर ने अनुरोध पूरा किया, फ़ेलओवर हुआ या नहीं, अनुरोध की लेटेंसी क्या रही, कितने टोकन इस्तेमाल हुए और नतीजे ने एप्लिकेशन की स्वीकृति कसौटी पूरी की या नहीं। वरना बदलती लागत या आउटपुट व्यवहार को समझाना कठिन हो जाता है।
आर्किटेक्चर का फ़ैसला लेना
कंपनी को राउटर उत्पाद चुनने से शुरुआत नहीं करनी चाहिए। उसे पहले पहचानना चाहिए कि मौजूदा सिस्टम में कोई नापने-योग्य समस्या है या नहीं और क्या कोई छोटा बदलाव उसे सुलझा सकता है।
| स्थिति | उचित पहला तरीक़ा |
|---|---|
| एक उपयुक्त मॉडल, स्वीकार्य प्रोवाइडर विश्वसनीयता और संभालने लायक लागत | सीधा प्रोवाइडर API |
| अलग-अलग जाँचे-परखे मॉडल माँगने वाले कई अनुमान-योग्य काम | एप्लिकेशन स्तर पर साफ़ चयन |
| चुने हुए मॉडल के स्वीकृत वैकल्पिक प्रोवाइडर हैं और प्रोवाइडर विफलताएँ मायने रखती हैं | प्रोवाइडर राउटिंग या सीमित नियंत्रित फ़ेलओवर |
| कई एप्लिकेशन को साझा एक्सेस पॉलिसी, कोटा और रिपोर्टिंग चाहिए | AI गेटवे |
| अनुरोध की जटिलता बदलती है और मूल्यांकित मॉडलों में गुणवत्ता/लागत के अलग समझौते हैं | मूल्यांकित बुद्धिमान मॉडल राउटिंग |
| सख़्त डेटा-प्रोसेसिंग या एक्ज़ीक्यूशन की ज़रूरतें | तय या कड़ाई से सीमित प्रोवाइडर पात्रता |
ये शुरुआती बिंदु हैं, सार्वभौमिक नियम नहीं। टीमें ज़रूरत पड़ने पर क्षमताएँ जोड़ सकती हैं, पर हर जोड़ को एक सिद्ध समस्या सुलझानी चाहिए। उन्हें गुणवत्ता, स्वीकृत नतीजे की लागत, लेटेंसी, विफलताएँ और संचालन का प्रयास नापना चाहिए, फिर यह तय करना चाहिए कि मॉडल की स्वीकृतियाँ, प्रोवाइडर प्रतिबंध, राउटिंग बदलाव और घटनाएँ किसके ज़िम्मे हैं।
जो एप्लिकेशन सीधे API से पहले ही अच्छा चल रहे हैं, उनके लिए राउटर का योगदान कम हो सकता है। जिन सिस्टम में कई मॉडल, पात्र एक्ज़ीक्यूशन प्रोवाइडर, बदलते वर्कलोड और एप्लिकेशनों के पार पॉलिसी की ज़रूरतें हैं, उनके लिए राउटिंग मूल्यवान इंफ़्रास्ट्रक्चर बन सकती है।
राउटिंग तब इस्तेमाल कीजिए जब मॉडल और प्रोवाइडर के फ़ैसलों की लागत, विश्वसनीयता या जटिलता एप्लिकेशन की चिंता बन चुकी हो, केवल इसलिए नहीं कि कोई राउटिंग उत्पाद उपलब्ध है।
और गहराई में
- LiteLLM: Router concepts डिप्लॉयमेंट समूह, रीट्राई और फ़ॉलबैक व्यवहार का वर्णन करता है।
- Vercel: AI Gateway model fallbacks मॉडल फ़ॉलबैक और प्रोवाइडर चयन के बीच अंतर करता है।
- Microsoft: Model Router in Foundry समर्थित मॉडल-चयन व्यवहार का दस्तावेज़ देता है।
- AWS: Intelligent Prompt Routing क्षमताओं और समर्थित मॉडल-परिवार की सीमाओं का दस्तावेज़ देता है।
- OpenRouter: Provider routing प्रोवाइडर वरीयताओं और प्रतिबंधों का दस्तावेज़ देता है।
- Hugging Face: OpenRouter integration भाषा-मॉडल प्रोवाइडर राउटिंग सौंपे जाने का एक उदाहरण है।
स्रोत समीक्षा: 18 नवंबर 2026।