

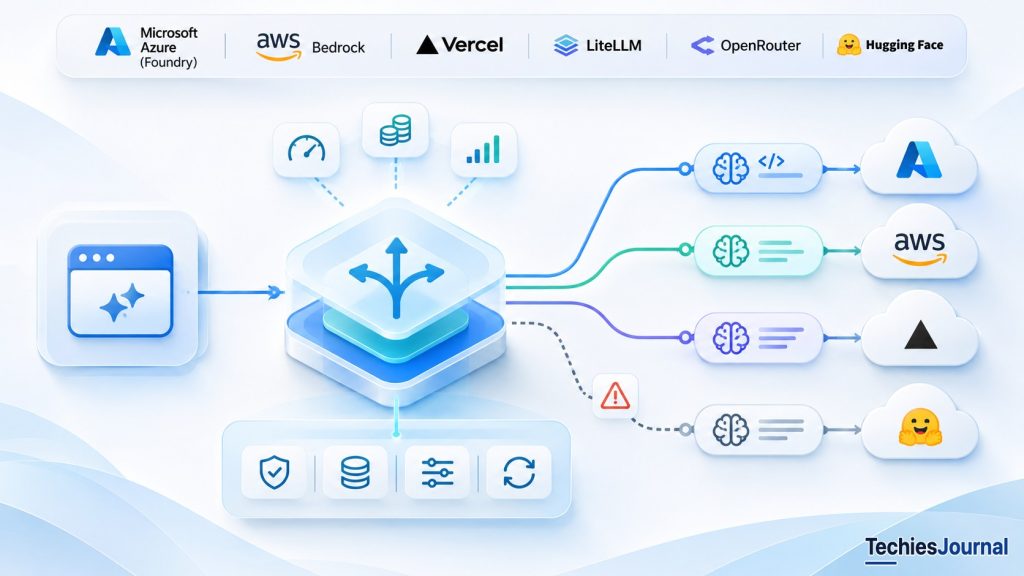
Comprendre quand les API d’IA directes suffisent, comment fonctionne le routage de modèles et quels problèmes d’architecture justifient une couche supplémentaire.
Une entreprise lance un assistant d’IA pour aider ses ingénieurs du support client à résoudre des incidents techniques. La première version est simple. Lorsqu’un ingénieur ouvre un ticket, l’application récupère les détails de l’incident, les envoie à un modèle de langage et reçoit un résumé accompagné de suggestions d’étapes suivantes.
L’équipe utilise un seul modèle via l’API d’un seul fournisseur. Les résultats sont suffisamment précis pour l’usage prévu, les temps de réponse sont acceptables et les coûts d’exploitation restent maîtrisables. Il n’y a ni routeur de modèles, ni passerelle d’IA, ni infrastructure d’inférence élaborée. Surtout, il n’y a aucune raison d’en introduire.
Six mois plus tard, l’assistant classe des milliers de tickets, résume de longues conversations, examine des incidents difficiles et rédige des réponses destinées aux clients. Certaines tâches sont simples, d’autres exigent des modèles plus performants. Les coûts ont augmenté et des limites de débit imposées par le fournisseur interrompent parfois le traitement.
Les développeurs commencent à étudier les routeurs de modèles. Avant de choisir un produit, toutefois, ils doivent identifier le problème à résoudre. Les différentes technologies de routage prennent des décisions différentes. Introduire la mauvaise peut accroître la complexité sans améliorer l’application.
La question pertinente est de savoir quand les exigences de l’application rendent la sélection du modèle ou du fournisseur assez importante pour être gérée séparément.
L’accès direct au modèle suffit souvent
Une application d’IA envoie normalement une requête à l’API d’un fournisseur. Le fournisseur exploite les ressources de calcul nécessaires pour exécuter le modèle. L’application décide toujours de ce qu’elle demande, protège les identifiants, valide les sorties et contrôle les actions métier qui en découlent.
C’est une architecture de production viable. Si un modèle adapté répond aux exigences de qualité, de latence, de disponibilité et de coût de la charge de travail, un service de routage n’a pas de rôle démontré. Une intégration directe permet aussi de savoir plus facilement où les requêtes s’exécutent et quel service examiner en cas de problème.
L’assistant du support comporte au départ deux flux de travail prévisibles. Un seul modèle fixe les gère tous deux de façon satisfaisante. Les développeurs devraient mesurer les limites réelles de cette intégration avant d’ajouter un autre saut réseau, une autre configuration de politiques et une autre dépendance opérationnelle.
La première complication apparaît lorsque toutes les tâches ne devraient pas utiliser le même modèle. La classification courante et l’analyse d’incidents complexes n’ont pas les mêmes exigences. L’application pourrait utiliser un modèle plus petit et validé pour la première et un modèle plus performant pour la seconde. Elle peut mettre en œuvre ce choix explicitement dans son code. C’est de la sélection de modèle sans routeur dédié.
Une seconde complication apparaît lorsque le modèle choisi est disponible auprès de plusieurs fournisseurs d’exécution. L’un peut être moins cher, un autre plus rapide et un autre plus disponible pendant les pics de demande. C’est de la sélection de fournisseur, une décision différente qui peut justifier une infrastructure de routage distincte.
Trois façons d’organiser l’accès aux modèles
Une application peut conserver toutes les décisions de sélection dans son propre code. Elle peut introduire un composant de routage partagé qu’elle possède et maintient. Ou elle peut déléguer les décisions prises en charge à une infrastructure de routage dédiée, soit un service géré, soit une passerelle auto-hébergée.
Alternative textuelle accessible de cette figure
Trois schémas comparent une connexion directe de l’application au fournisseur, un routage interne à l’application vers deux fournisseurs et un service de routeur séparé menant à deux fournisseurs.
Texte affiché dans la figure : Trois façons de connecter une application d’IA | La responsabilité du routage change d’endroit, pas l’exigence de valider les résultats | A. API directe | B. Routage dans l’application | C. Routeur dédié | Application | Modèle fixe | Règles métier et validation | API du fournisseur | Une seule destination | Logique de routage | Code de l’équipe | Routeur ou passerelle | Géré ou auto-hébergé | Fourn. A | Fournisseur B | Aucun service de routage en plus | L’équipe maintient le routage | Nouvelle frontière de service
Le routage géré par l’application peut être une petite fonction associant chaque tâche à un modèle approuvé. Cela peut être plus facile à maintenir qu’une plateforme séparée lorsqu’il n’y a que quelques flux de travail stables. Quand davantage d’applications ont besoin d’identifiants de fournisseur communs, de basculement, de limites d’utilisation et de rapports, un routage centralisé peut réduire le code dupliqué. Pourtant, un routeur géré devient une dépendance externe et une passerelle auto-hébergée devient un service de plus à exploiter de manière sécurisée.
Ces approches sont des alternatives, pas une séquence prescrite. L’architecture devrait suivre les exigences démontrées.
Le routage de modèles et le routage de fournisseurs ne sont pas interchangeables
Imaginons que l’assistant du support reçoive deux requêtes. L’une classe un ticket comme un problème de mot de passe, de réseau ou d’application. L’autre examine un incident compliqué dont les éléments de preuve issus de plusieurs systèmes se contredisent.
L’application peut sélectionner le modèle A pour la classification et le modèle B pour l’analyse d’incidents. Le routage de modèles décide quel modèle exécute la tâche.
Imaginons maintenant que le modèle B puisse s’exécuter via deux fournisseurs d’inférence approuvés. L’application a sélectionné le modèle, mais un routeur peut encore choisir où il s’exécute. Le routage de fournisseurs choisit la destination d’exécution d’un modèle déjà sélectionné.
Alternative textuelle accessible de cette figure
Une requête d’incident passe par le choix d’un modèle validé, l’éligibilité des fournisseurs approuvés et des destinations d’exécution alternatives, tandis qu’un fournisseur est exclu par la politique.
Texte affiché dans la figure : Choisir un modèle n’est pas choisir un fournisseur | Le modèle doit convenir à la tâche avant le choix d’un fournisseur éligible | Requête d’incident | Identifier tâche et exigences | Choisir un modèle validé | Courante : modèle A | Complexe : modèle B | Appliquer l’éligibilité | Paramètres, sécurité et politique | Fourn. 1 | Destination éligible | Fourn. 2 | Fournisseur 3 exclu | Non approuvé pour la charge | Validation par l’application | Utiliser seulement la sortie acceptée | Après exécution, résultat renvoyé à l’application
Un repli est encore autre chose. Après un échec, un système peut essayer un autre fournisseur éligible pour le même modèle, ou être configuré pour tenter un autre modèle. Passer à un modèle différent peut affecter la qualité, la structure et les capacités, de sorte que les modèles de secours doivent être évalués pour la tâche et non présumés équivalents.
Certains produits combinent ces mécanismes. Microsoft Foundry Model Router et Amazon Bedrock Intelligent Prompt Routing illustrent une sélection automatisée de modèles, avec leur propre périmètre et leurs propres contraintes. OpenRouter documente le routage de fournisseurs et des contrôles de politiques. Vercel AI Gateway documente le routage de fournisseurs et des modèles de repli configurés. LiteLLM documente les groupes de modèles, le routage de déploiements, les nouvelles tentatives et les replis.
Ce sont des exemples de mécanismes différents, pas la preuve que tous les produits offrent le même comportement ni qu’un produit est universellement préférable.
Suivre une requête d’incident à travers le routeur
L’assistant reçoit un incident contenant un historique d’erreurs, des détails sur les services et des notes de dépannage. Il doit produire une évaluation structurée comprenant la catégorie, la cause probable, la gravité et les éléments de preuve à l’appui. Ce scénario est fictif et destiné à montrer les frontières de contrôle, pas la mise en œuvre exacte d’un fournisseur.
D’abord, l’application identifie la tâche comme une analyse complexe. Sa configuration de routage testée autorise le modèle B. Le modèle A est approuvé pour la classification courante, mais n’a pas atteint l’exigence de qualité pour cette tâche. Un routeur ne doit pas le sélectionner simplement parce qu’il est moins cher.
Ensuite, la destination d’exécution est restreinte. Les fournisseurs 1 et 2 prennent en charge le modèle B et satisfont aux exigences de traitement des données et d’interface de l’organisation. Le fournisseur 3 propose des prix plus bas mais n’est pas approuvé pour traiter ces dossiers d’incident. Le fournisseur 3 est exclu avant que le coût et la vitesse soient pris en compte.
Le routeur choisit le fournisseur 1 selon sa politique de sélection configurée. Le fournisseur traite la requête et renvoie une réponse. L’application vérifie que les champs requis existent, que leurs valeurs sont valides et que l’évaluation est acceptable pour le flux de travail. Ce n’est qu’après validation que l’application l’enregistre ou agit en conséquence.
Cela illustre une frontière de responsabilité. Le routeur sélectionne et invoque un chemin d’exécution éligible. L’application décide si le résultat est valide et quelle action métier, le cas échéant, doit suivre.
La reprise après défaillance a des limites
Supposons que le fournisseur 1 rejette la requête avant la génération parce qu’il a atteint sa capacité. Si la politique configurée autorise les nouvelles tentatives et que le fournisseur 2 reste éligible, le routeur peut y tenter la requête.
Le cas change lorsque le fournisseur 1 commence à diffuser une réponse en flux et que la connexion tombe à mi-chemin. Le fournisseur 2 ne peut généralement pas reprendre l’état de génération interne du premier fournisseur. Une nouvelle tentative peut relancer la génération et produire une réponse différente.
Alternative textuelle accessible de cette figure
Un rejet précoce du fournisseur permet une nouvelle tentative contrôlée par la politique. Un flux interrompu exige des règles de reprise, avec validation par l’application et protection contre les effets de bord dans les deux cas.
Texte affiché dans la figure : Basculement et reprise du flux sont différents | Le point de défaillance détermine ce qui peut être relancé | Requête | Modèle et fournisseur approuvé | Fourn. A | Requête tentée | Rejet précoce | Aucune génération démarrée | Essai : Fourn. B | Seulement si éligible | Flux interrompu | Résultat partiel inutilisable | Politique de reprise | Relancer ou échouer sans risque | Contrôle côté app | Valider la sortie terminée | Éviter les effets de bord en double | Le repli du routeur ne garantit pas la reprise de l’opération métier
Si l’application a déjà affiché une réponse partielle, elle doit gérer clairement l’interruption. Si la réponse est une donnée structurée, une sortie incomplète ne doit pas être acceptée comme une évaluation terminée. Si le résultat du modèle déclenche une mise à jour de ticket ou un appel d’outil externe, l’idempotence et l’autorisation restent des responsabilités de l’application. Répéter un appel au modèle ne doit pas répéter par inadvertance une opération déjà terminée.
Les politiques de nouvelle tentative exactes et le comportement en cours de flux dépendent de la plateforme et de la configuration. Une affirmation générique de basculement automatique n’établit pas une reprise transparente après tous les types de défaillance.
La qualité et le coût doivent être mesurés ensemble
L’assistant traite des milliers de requêtes par jour et l’équipe veut réduire ses dépenses d’inférence. Un modèle plus petit coûte moins cher par appel, mais cela ne suffit pas à justifier d’y diriger le trafic de production.
Prenons une évaluation illustrative où le modèle A coûte 0,002 $ par tentative et produit des résultats de classification acceptables dans 75 % des cas. Le modèle B coûte 0,008 $ et produit des résultats acceptables dans 99 % des cas. L’exemple ne prétend pas refléter de véritables benchmarks de modèles ni une facturation réelle de fournisseur. Il montre pourquoi le prix affiché par jeton est une mesure incomplète pour décider.
L’équipe devrait comparer le coût par résultat accepté, la latence, les échecs de validation, les nouvelles tentatives et toute revue humaine. Elle devrait aussi établir un seuil de qualité pour chaque tâche. Un modèle moins cher qui ne satisfait pas des exigences critiques n’est pas un substitut éligible simplement parce que ses moyennes paraissent attrayantes.
Le routage de fournisseurs comporte des compromis économiques similaires. Le rapport d’ingénierie d’octobre 2026 d’OpenRouter décrit des améliorations du délai avant le premier jeton, de la latence des requêtes et des erreurs de capacité, accompagnées d’une hausse de 6,0 % du coût par millier de requêtes. Ces résultats rapportés par le fournisseur ne prouvent pas que toutes les applications tireraient profit de la même politique.
Partez d’une charge de travail représentative et d’une référence existante à modèle fixe ou à fournisseur fixe. N’adoptez une politique de routage plus complexe que lorsque l’amélioration observée est significative pour l’application.
Les restrictions de confidentialité passent avant la vitesse et le prix
Les tickets du support peuvent contenir des informations sur les clients, des journaux internes ou des détails techniques sensibles. Lorsque l’exécution peut passer d’un fournisseur à un autre, chaque destination autorisée doit satisfaire aux exigences applicables en matière de traitement des données, de géographie, de contrat et de sécurité.
Le système de routage peut savoir quels fournisseurs peuvent exécuter un modèle, mais cela n’équivaut pas à savoir quels fournisseurs sont autorisés à traiter les informations de l’organisation. L’éligibilité doit être établie avant le classement par performance ou par coût.
Les contrôles disponibles diffèrent selon le service et l’intégration. En particulier, une fonctionnalité documentée pour l’API directe d’OpenRouter ne doit pas être supposée automatiquement disponible via une intégration Hugging Face. L’annonce de Hugging Face montre comment une plateforme d’accès aux modèles a délégué le routage de fournisseurs, pas que chaque politique sous-jacente peut être configurée par la même interface.
Pour les charges de travail restreintes, un fournisseur fixe ou un ensemble étroitement approuvé de destinations d’exécution peut être plus approprié qu’un routage sans contraintes.
Une passerelle résout un problème de coordination plus large
L’entreprise finit par exploiter plusieurs applications d’IA. Chacune a ses propres identifiants, vérifications budgétaires, configuration de modèle et rapports d’utilisation. Une infrastructure de passerelle d’IA partagée peut devenir utile même si certaines applications utilisent des modèles fixes.
Une passerelle d’IA peut centraliser le contrôle d’accès, les quotas, la journalisation, la visibilité sur les dépenses et le routage. Ce rôle plus large se distingue de la décision automatique du modèle qui doit répondre à une invite. Une passerelle auto-hébergée oblige l’organisation à gérer le déploiement, la sécurité, la mise à l’échelle et les mises à niveau. Une passerelle gérée réduit une partie du travail d’exploitation local mais ajoute une dépendance à la disponibilité et aux politiques du service.
Le routage dynamique modifie aussi l’observabilité. L’équipe devrait savoir quel modèle a réellement été exécuté, quel fournisseur a servi la requête, si un basculement a eu lieu, la latence de la requête, la consommation de jetons et si le résultat a satisfait aux critères d’acceptation de l’application. Sinon, il devient difficile d’expliquer l’évolution des coûts ou du comportement des sorties.
Prendre la décision d’architecture
L’entreprise ne devrait pas commencer par choisir un produit de routeur. Elle devrait d’abord déterminer si le système actuel présente un problème mesurable et si un changement plus modeste pourrait le résoudre.
| Condition | Première approche raisonnable |
|---|---|
| Un modèle adapté, une fiabilité du fournisseur acceptable et un coût maîtrisable | API directe du fournisseur |
| Plusieurs tâches prévisibles exigeant différents modèles validés | Sélection explicite au niveau de l’application |
| Un modèle sélectionné dispose de fournisseurs de remplacement approuvés et les défaillances de fournisseur comptent | Routage de fournisseurs ou basculement contrôlé limité |
| Plusieurs applications ont besoin de politiques d’accès, de quotas et de rapports partagés | Passerelle d’IA |
| La complexité des requêtes varie et les modèles évalués offrent des compromis qualité/coût différents | Routage intelligent de modèles évalué |
| Exigences strictes de traitement des données ou d’exécution | Éligibilité des fournisseurs fixe ou strictement restreinte |
Ce sont des points de départ, pas des règles universelles. Les équipes peuvent combiner des capacités lorsque c’est nécessaire, mais chaque ajout devrait résoudre un problème établi. Elles devraient mesurer la qualité, le coût par résultat accepté, la latence, les défaillances et l’effort d’exploitation, puis identifier qui est responsable des approbations de modèles, des restrictions de fournisseurs, des changements de routage et des incidents.
Pour les applications qui fonctionnent déjà bien avec des API directes, un routeur peut apporter peu. Pour les systèmes qui gèrent plusieurs modèles, des fournisseurs d’exécution éligibles, des charges variables et des besoins de politiques entre applications, le routage peut devenir une infrastructure précieuse.
Utilisez le routage lorsque le coût, la fiabilité ou la complexité des décisions sur les modèles et les fournisseurs est devenu une préoccupation de l’application, et pas simplement parce qu’un produit de routage existe.
Pour aller plus loin
- LiteLLM: Router concepts décrit les groupes de déploiements, les nouvelles tentatives et le comportement de repli.
- Vercel: AI Gateway model fallbacks distingue le repli de modèle de la sélection de fournisseur.
- Microsoft: Model Router in Foundry documente le comportement pris en charge pour la sélection de modèles.
- AWS: Intelligent Prompt Routing documente les capacités et les contraintes de familles de modèles prises en charge.
- OpenRouter: Provider routing documente les préférences et les restrictions relatives aux fournisseurs.
- Hugging Face: OpenRouter integration est un exemple de routage délégué de fournisseurs de modèles de langage.
Revue des sources : 18 novembre 2026.