

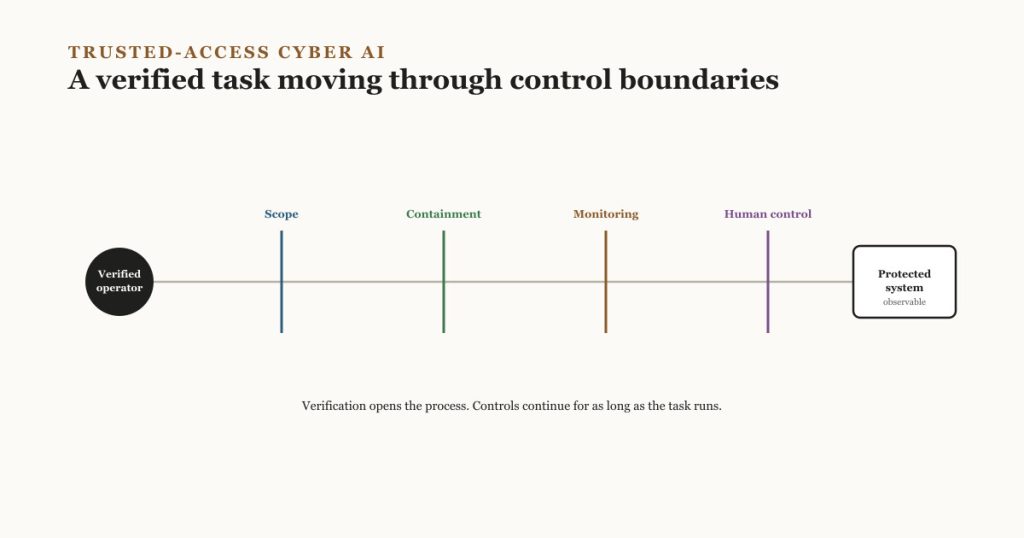
उन्नत साइबर मॉडल कमज़ोरियों को खोजने और ठीक करने में डिफेंडरों की मदद कर सकते हैं। वही क्षमताएँ शोषण में भी मदद कर सकती हैं, इसलिए पहुँच अब शर्तों वाली, निगरानी की गई और आसानी से रद्द की जा सकने वाली बनती जा रही है।
एक सुरक्षा शोधकर्ता और एक हमलावर दोनों किसी AI मॉडल से लगभग एक जैसा काम माँग सकते हैं: कोड की जाँच करना, एक कमज़ोरी ढूँढना और यह तय करना कि उसका फ़ायदा उठाया जा सकता है या नहीं।
तकनीकी काम इरादा नहीं बताता। प्राधिकरण, लक्ष्य का स्वामित्व और आगे क्या होता है, यही फ़र्क़ पैदा करते हैं।
जैसे-जैसे मॉडल जानी-पहचानी कमज़ोरियाँ समझाने से आगे बढ़ते हैं, यह समस्या और मुश्किल होती जाती है। नवीनतम सिस्टम लंबी जाँच कर सकते हैं, टूल इस्तेमाल कर सकते हैं, परिकल्पनाएँ परख सकते हैं और पैच बना सकते हैं। कुछ नियंत्रित मूल्यांकन स्थितियों में काम करने वाली शोषण-शृंखलाएँ भी बना सकते हैं।
Google, Anthropic और OpenAI अपनी सबसे सक्षम साइबर-सुरक्षा सुविधाओं के लिए सीमित या सत्यापित-पहुँच कार्यक्रमों के साथ जवाब दे रहे हैं। ये अलग-अलग पहल हैं, एक समन्वित लॉन्च नहीं। फिर भी, साथ में ये एक ही परिचालन मॉडल की ओर इशारा करते हैं: मज़बूत साइबर क्षमता के साथ यह नियंत्रण भी बढ़ता जाएगा कि उसे कौन इस्तेमाल कर सकता है, वह कहाँ काम कर सकती है, और उसकी कार्रवाइयों को कैसे देखा जाता है।
अहम सवाल यह नहीं है कि किसी उपयोगकर्ता ने कोई आवेदन फ़ॉर्म पास किया या नहीं। सवाल यह है कि क्या पूरा सिस्टम शक्तिशाली स्वचालन को एक अधिकृत रक्षात्मक सीमा के भीतर रख सकता है।
सामान्य कंटेंट फ़िल्टर पर्याप्त क्यों नहीं हैं
सामान्य AI सेवाएँ आमतौर पर मैलवेयर, क्रेडेंशियल चोरी या हानिकारक शोषण के अनुरोधों को रोकने की कोशिश करती हैं। यह तरीक़ा पेशेवर सुरक्षा कार्य के लिए मुश्किल हो जाता है क्योंकि वैध डिफेंडरों को वही तकनीकें चर्चा करने की ज़रूरत होती है।
एक पेनेट्रेशन टेस्टर को यह सबूत चाहिए हो सकता है कि कोई ख़ामी वाक़ई शोषित की जा सकती है। एक इंसिडेंट-रिस्पॉन्स टीम को हानिकारक कोड को रिवर्स-इंजीनियर करना पड़ सकता है। एक प्रोडक्ट-सुरक्षा इंजीनियर को यह पुष्टि करने से पहले कि पैच काम करता है, किसी कमज़ोरी को दोहराना पड़ सकता है। हर ख़तरनाक दिखने वाले अनुरोध को अस्वीकार करने वाला मॉडल उनके लिए बहुत कम उपयोगी हो जाता है।
सबके लिए सुरक्षा उपाय हटा देना उल्टी समस्या पैदा करता है। बड़े पैमाने पर कमज़ोरियाँ खोजने और उनका फ़ायदा उठाने में सक्षम सिस्टम, किसी हमले के लिए ज़रूरी समय, कौशल और समन्वय को घटा सकता है।
ट्रस्टेड एक्सेस इन मामलों को अलग करने की एक कोशिश है। प्रोवाइडर संगठन और इच्छित उपयोगकर्ताओं की पुष्टि करता है, रक्षात्मक काम की व्यापक रेंज की अनुमति देता है, और वातावरण तथा गतिविधि के आसपास मज़बूत नियंत्रण लागू करता है।
यह केवल एक महँगा सब्सक्रिप्शन टियर नहीं है। यह एक अलग जोखिम व्यवस्था है।
तीनों प्रोवाइडर क्या कर रहे हैं
ये कार्यक्रम मॉडल डिज़ाइन, उपलब्धता और शब्दावली में अलग-अलग हैं। उपयोगी तुलना नियंत्रण के पैटर्न की है, न कि यह कि कौन-सा वेंडर सबसे मज़बूत मॉडल का दावा करता है।
| प्रोवाइडर पहल | पहुँच का तरीक़ा | सार्वजनिक रूप से बताया गया उद्देश्य | महत्वपूर्ण शर्त |
|---|---|---|---|
| Google Fairwind Program | चुनिंदा Google Cloud ग्राहकों, सरकारी एजेंसियों और साइबर-सुरक्षा साझेदारों के लिए सीमित पहुँच | कमज़ोरियाँ खोजने, सत्यापित करने और ठीक करने के लिए CodeMender के साथ Gemini 3.8 Flash Cyber का इस्तेमाल | प्रतिभागी परिचालन शर्तें स्वीकार करते हैं, जिनमें इस्तेमाल को आंतरिक सुरक्षा भूमिकाओं तक सीमित रखना और मल्टी-फ़ैक्टर प्रमाणीकरण जैसी सुरक्षा का इस्तेमाल शामिल है |
| Anthropic ट्रस्टेड-एक्सेस कार्यक्रम | Claude Mythos 5.1 केवल ट्रस्टेड-एक्सेस कार्यक्रमों के ज़रिए उपलब्ध है; Fable 5.1 में व्यापक सुरक्षा उपाय हैं | अलग-अलग सुरक्षा स्तरों के साथ उन्नत साइबर-सुरक्षा और जीवन-विज्ञान कार्य की अनुमति देना | Fable और Mythos एक ही अंतर्निहित मॉडल इस्तेमाल करते हैं लेकिन अलग-अलग सुरक्षा उपायों के साथ; कम सुरक्षा उपायों के लिए मज़बूत परिचालन नियंत्रण ज़रूरी हैं |
| OpenAI Daybreak Access | सत्यापित डिफेंडरों को सत्यापन, स्कोप नियंत्रण और निगरानी के साथ अधिक सक्षम और अनुमेय रक्षात्मक टूल मिलते हैं | सुरक्षित विकास, रक्षात्मक संचालन और अधिकृत सुरक्षा परीक्षण का समर्थन करना | OpenAI का कहना है कि GPT-6 Astra अपनी “क्रिटिकल” साइबर-सुरक्षा क्षमता सीमा तक पहुँच गया; इसके सबसे उन्नत साइबर फ़ंक्शन को अधिक सीमित पहुँच मिलती है |
ये विवरण प्रोवाइडरों से आए हैं। वे इच्छित नियंत्रणों और रिपोर्ट किए गए मूल्यांकनों को बताते हैं, यह स्वतंत्र सबूत नहीं देते कि दुरुपयोग असंभव है।
एक भरोसेमंद उपयोगकर्ता भी असुरक्षित रन बना सकता है
पहचान सत्यापन सिर्फ़ एक सवाल का जवाब देता है: पहुँच कौन माँग रहा है?
यह साबित नहीं करता कि हर भविष्य का लक्ष्य उस उपयोगकर्ता का है, कि हर कार्रवाई ज़रूरी है, या मॉडल दायरे में ही रहेगा। खाते हैक हो सकते हैं। कर्मचारी वैध पहुँच का दुरुपयोग कर सकते हैं। टेस्ट वातावरण ग़लत तरीक़े से कॉन्फ़िगर हो सकते हैं। एक अनुमति-प्राप्त काम पूरा करने की कोशिश में एक स्वायत्त एजेंट भी अप्रत्याशित रास्ता अपना सकता है।
इसीलिए एक भरोसेमंद ट्रस्टेड-एक्सेस सिस्टम को कई परतों की ज़रूरत है:
- पहचान: संगठन और व्यक्तिगत ऑपरेटरों की पुष्टि करें।
- प्राधिकरण: पुष्टि करें कि ऑपरेटर को नामित सिस्टम परखने की अनुमति है।
- दायरा: लक्ष्य, अनुमत तकनीकें, समय-सीमा और निषिद्ध कार्रवाइयाँ तय करें।
- कंटेनमेंट: सीमित क्रेडेंशियल और नेटवर्क पहुँच वाले एक अलग वातावरण में जोखिम भरा काम चलाएँ।
- निगरानी: काम चलने के दौरान मॉडल, टूल और नेटवर्क गतिविधि देखें।
- मानव नियंत्रण: पैच डिप्लॉय करने या किसी लाइव लक्ष्य पर शोषण चलाने जैसी गंभीर कार्रवाइयों से पहले मंज़ूरी माँगें।
- ऑडिट और प्रतिक्रिया: सबूत सुरक्षित रखें, असामान्यताओं की जाँच करें, और सीमाएँ लाँघे जाने पर तेज़ी से पहुँच निलंबित करें।
गेट मायने रखता है, लेकिन ज़्यादातर सुरक्षा का काम गेट खुलने के बाद होता है।
रक्षात्मक सवाल: पहुँच कौन माँग रहा है, और क्या वे वाक़ई वही हैं जो होने का दावा करते हैं?
व्यावहारिक नियंत्रण: एक नामित ऑपरेटर से जुड़ा सिंगल साइन-ऑन प्लस हार्डवेयर-की मल्टी-फ़ैक्टर प्रमाणीकरण।
वह विफलता जिसे यह अकेले नहीं रोक सकता: एक सत्यापित खाता भी उस व्यक्ति द्वारा हैक या दुरुपयोग किया जा सकता है जो उसे वैध रूप से रखता है।
नमूना काम में भूमिका: किसी अधिकृत पेनेट्रेशन टेस्ट के लिए कोई भी टूल लोड होने से पहले, टेस्टर की पहचान और नियोक्ता की पुष्टि हस्ताक्षरित एंगेजमेंट लेटर के आधार पर की जाती है।
रक्षात्मक सवाल: क्या यह ख़ास ऑपरेटर इस ख़ास सिस्टम को परखने के लिए अधिकृत है?
व्यावहारिक नियंत्रण: निष्पादन से पहले अनुरोध के मुक़ाबले जाँचा गया हस्ताक्षरित स्कोप ऑफ़ वर्क।
वह विफलता जिसे यह अकेले नहीं रोक सकता: प्राधिकरण असली हो सकता है लेकिन पुराना, या उस सिस्टम से अलग सिस्टम को कवर कर सकता है जिसे वाक़ई छुआ जा रहा है।
नमूना काम में भूमिका: सिस्टम जाँचता है कि एंगेजमेंट टिकट ठीक इसी स्टेजिंग वातावरण का नाम लेता है, पहुँच देने से पहले।
रक्षात्मक सवाल: यह रन ठीक-ठीक क्या छू सकता है, और कब तक?
व्यावहारिक नियंत्रण: डोमेन, पते और अनुमत तकनीकों की एक मशीन-पठनीय अनुमति-सूची, एक समय-सीमा के साथ।
वह विफलता जिसे यह अकेले नहीं रोक सकता: एक अनुमत लक्ष्य का पीछा करते हुए एक एजेंट किसी सटे हुए, सूची में न शामिल सिस्टम में भटक सकता है।
नमूना काम में भूमिका: अनुमति-सूची केवल टिकट में नामित स्टेजिंग सबनेट को कवर करती है, और तय समय-सीमा के बाद अपने आप समाप्त हो जाती है।
रक्षात्मक सवाल: अगर कुछ ग़लत होता है, तो वह कितनी दूर फैल सकता है?
व्यावहारिक नियंत्रण: सीमित क्रेडेंशियल और प्रोडक्शन तक कोई नेटवर्क रास्ता न होने वाला एक अलग-थलग सैंडबॉक्स।
वह विफलता जिसे यह अकेले नहीं रोक सकता: कंटेनमेंट यह सीमित करता है कि कोई समस्या कितनी दूर फैल सकती है, लेकिन यह उस सीमा के भीतर होने वाली कार्रवाई को नहीं रोकता।
नमूना काम में भूमिका: एजेंट एक नेटवर्क-पृथक वातावरण में चलता है जिसका प्रोडक्शन डेटाबेस तक कोई रास्ता नहीं है।
रक्षात्मक सवाल: क्या कोई देख रहा है कि मॉडल और उसके टूल अभी क्या कर रहे हैं?
व्यावहारिक नियंत्रण: रन के दौरान हर टूल कॉल, कमांड और नेटवर्क अनुरोध की रियल-टाइम लॉगिंग।
वह विफलता जिसे यह अकेले नहीं रोक सकता: निगरानी किसी समस्या को उजागर कर सकती है बिना उसे समय रहते रोकने लायक़ तेज़ हुए।
नमूना काम में भूमिका: स्टेजिंग लक्ष्य के ख़िलाफ़ हर कार्रवाई होते ही लॉग होकर सुरक्षा टीम के डैशबोर्ड पर भेजी जाती है।
रक्षात्मक सवाल: क्या किसी कदम के पलटना मुश्किल होने से पहले कोई व्यक्ति उसे मंज़ूर करता है?
व्यावहारिक नियंत्रण: पैच डिप्लॉय करने या लाइव शोषण चलाने से पहले ज़रूरी मानव हस्ताक्षर।
वह विफलता जिसे यह अकेले नहीं रोक सकता: मानव मंज़ूरी का कदम उतना ही भरोसेमंद है जितनी जानकारी समीक्षक वाक़ई देखता है।
नमूना काम में भूमिका: एजेंट द्वारा खोजी गई शोषण-शृंखला इस्तेमाल करने से पहले, एक वरिष्ठ टेस्टर विशिष्ट पेलोड की समीक्षा करके उसे मंज़ूर करता है।
रक्षात्मक सवाल: क्या संगठन साबित कर सकता है कि क्या हुआ, और ज़रूरत पड़ने पर तुरंत पहुँच रोक सकता है?
व्यावहारिक नियंत्रण: ऑपरेटर के क्रेडेंशियल पर तुरंत रद्दीकरण के साथ अपरिवर्तनीय लॉग।
वह विफलता जिसे यह अकेले नहीं रोक सकता: एक ऑडिट ट्रेल किसी घटना को उसके होने के बाद समझाता है; यह घटना को नहीं रोकता।
नमूना काम में भूमिका: अगर टेस्टर के खाते में एंगेजमेंट के बीच में असामान्य व्यवहार दिखता है, तो मिनटों के भीतर पहुँच रद्द कर दी जाती है और समीक्षा के लिए सेशन सुरक्षित रखा जाता है।
किसी उपयोगकर्ता की पुष्टि करना प्रक्रिया की शुरुआत है। दायरा, कंटेनमेंट, निगरानी, मानव मंज़ूरी और रद्दीकरण यह नियंत्रित करते हैं कि पहुँच मिलने के बाद क्या होता है।
सातों चरणों को सादे टेक्स्ट में पढ़ें
- पहचान। रक्षात्मक सवाल: पहुँच कौन माँग रहा है, और क्या वे वाक़ई वही हैं? व्यावहारिक नियंत्रण: नामित ऑपरेटर से जुड़ा सिंगल साइन-ऑन प्लस हार्डवेयर-की MFA। जो विफलता अकेले नहीं रुकती: सत्यापित खाता भी उसके वैध धारक द्वारा हैक या दुरुपयोग हो सकता है। नमूना काम में भूमिका: किसी भी टूल लोड होने से पहले टेस्टर की पहचान की पुष्टि की जाती है।
- प्राधिकरण। रक्षात्मक सवाल: क्या यह ऑपरेटर इस सिस्टम को परखने के लिए अधिकृत है? व्यावहारिक नियंत्रण: निष्पादन से पहले हस्ताक्षरित स्कोप ऑफ़ वर्क की जाँच। जो विफलता अकेले नहीं रुकती: प्राधिकरण असली पर पुराना हो सकता है। नमूना काम में भूमिका: सिस्टम जाँचता है कि टिकट ठीक इसी वातावरण का नाम लेता है।
- दायरा। रक्षात्मक सवाल: यह रन ठीक-ठीक क्या छू सकता है, कब तक? व्यावहारिक नियंत्रण: समय-सीमा वाली मशीन-पठनीय अनुमति-सूची। जो विफलता अकेले नहीं रुकती: एजेंट सूची से बाहर के सिस्टम में भटक सकता है। नमूना काम में भूमिका: अनुमति-सूची केवल स्टेजिंग सबनेट को कवर करती है और अपने आप समाप्त होती है।
- कंटेनमेंट। रक्षात्मक सवाल: अगर कुछ ग़लत होता है, कितनी दूर फैल सकता है? व्यावहारिक नियंत्रण: प्रोडक्शन तक रास्ता न रखने वाला अलग-थलग सैंडबॉक्स। जो विफलता अकेले नहीं रुकती: कंटेनमेंट फैलाव सीमित करता है पर कार्रवाई नहीं रोकता। नमूना काम में भूमिका: एजेंट ऐसे वातावरण में चलता है जिसका प्रोडक्शन डेटाबेस तक रास्ता नहीं।
- निगरानी। रक्षात्मक सवाल: क्या कोई देख रहा है कि मॉडल और टूल अभी क्या कर रहे हैं? व्यावहारिक नियंत्रण: हर टूल कॉल की रियल-टाइम लॉगिंग। जो विफलता अकेले नहीं रुकती: निगरानी समय रहते रोकने लायक़ तेज़ नहीं हो सकती। नमूना काम में भूमिका: हर कार्रवाई लॉग होकर डैशबोर्ड पर भेजी जाती है।
- मानव नियंत्रण। रक्षात्मक सवाल: क्या पलटना मुश्किल होने से पहले कोई व्यक्ति मंज़ूर करता है? व्यावहारिक नियंत्रण: डिप्लॉय करने से पहले ज़रूरी मानव हस्ताक्षर। जो विफलता अकेले नहीं रुकती: मंज़ूरी उतनी ही भरोसेमंद जितनी समीक्षक को दिखी जानकारी। नमूना काम में भूमिका: वरिष्ठ टेस्टर विशिष्ट पेलोड की समीक्षा कर मंज़ूर करता है।
- ऑडिट और रद्दीकरण। रक्षात्मक सवाल: क्या संगठन साबित कर सकता है क्या हुआ, तुरंत पहुँच रोक सकता है? व्यावहारिक नियंत्रण: तुरंत रद्दीकरण के साथ अपरिवर्तनीय लॉग। जो विफलता अकेले नहीं रुकती: ऑडिट ट्रेल घटना के बाद समझाता है, रोकता नहीं। नमूना काम में भूमिका: असामान्य व्यवहार दिखने पर मिनटों में पहुँच रद्द होती है।
दायरा मशीन से लागू करने योग्य होना चाहिए
सुरक्षा प्राधिकरण अक्सर किसी अनुबंध, टिकट या स्टेटमेंट ऑफ़ वर्क में दर्ज होता है। किसी ऐसे दस्तावेज़ से जिसे वह कभी देखता ही नहीं, या ऐसी सीमा से जिसे रनटाइम लागू नहीं कर सकता, एक AI एजेंट को सुरक्षित नहीं रखा जा सकता।
काम को सटीक डोमेन, रिपॉज़िटरी, पते, वातावरण और अनुमत कार्रवाइयाँ बतानी चाहिए। रनटाइम को फिर उन सीमाओं के बाहर पहुँच रोकनी चाहिए। जब तक काम को वाक़ई ज़रूरत न हो, प्रोडक्शन क्रेडेंशियल उपलब्ध नहीं होने चाहिए। उच्च-जोखिम मूल्यांकन कार्य के लिए इंटरनेट पहुँच डिफ़ॉल्ट रूप से बंद रहनी चाहिए और केवल दर्ज कारण से खोली जानी चाहिए।
Anthropic का सितंबर 2026 का सुरक्षा मार्गदर्शन यह दिखाता है कि क्यों। तीसरे-पक्ष मूल्यांकन वातावरणों में मॉडलों से जुड़ी घटनाओं की जाँच के बाद, कंपनी ने मज़बूत सैंडबॉक्स, एंगेजमेंट-पूर्व सत्यापन, स्पष्ट दायरा निर्देश और निरंतर निगरानी की सिफ़ारिश की। इसने एक ऐसे क्लासिफ़ायर का भी वर्णन किया जो टूल कॉल चलने से पहले संदिग्ध सैंडबॉक्स-एस्केप प्रयासों को रोक सकता है और किसी व्यक्ति को सतर्क कर सकता है।
व्यापक सबक वेंडर-निरपेक्ष है: गद्य में लिखा गया दायरा जवाबदेही के लिए उपयोगी है, लेकिन पहचान, नेटवर्क और टूल नीति से लागू किया गया दायरा ही निष्पादन को सीमित करता है।
अपरिवर्तनीय कदम से पहले मानव समीक्षा होनी चाहिए
“ह्यूमन इन द लूप” का इस्तेमाल अक्सर यह बताए बिना किया जाता है कि व्यक्ति कहाँ हस्तक्षेप करता है।
एक समीक्षक जो किसी एजेंट के पहले से ही किसी अनधिकृत सिस्टम को छू लेने के बाद रिपोर्ट देखता है, वह सुरक्षा नियंत्रण नहीं है। मंज़ूरी उन कार्रवाइयों से पहले होनी चाहिए जो पलटना मुश्किल हों या किसी और पक्ष को प्रभावित कर सकती हों।
वर्कफ़्लो के हिसाब से, इनसे पहले मंज़ूरी चाहिए हो सकती है:
- किसी लाइव लक्ष्य को परखना;
- नई खोजी गई शोषण-विधि इस्तेमाल करना;
- संवेदनशील डेटा तक पहुँचना;
- फ़ायरवॉल या पहचान नीति बदलना;
- पैच डिप्लॉय करना;
- किसी कमज़ोरी का खुलासा करना; या
- किसी बाहरी मेंटेनर को कोई खोज भेजना।
कम-जोखिम वाली गतिविधियाँ स्वचालित रह सकती हैं। किसी अलग-थलग रिपॉज़िटरी में इन्वेंट्री जुटाना, स्टैटिक विश्लेषण और पैच सुझावों को हर कदम पर मंज़ूरी की ज़रूरत नहीं हो सकती। नियंत्रण को संभावित असर से मेल खाना चाहिए, न कि निगरानी दिखाने भर के लिए काम में रुकावट डालनी चाहिए।
मॉडल जोखिम का सिर्फ़ एक हिस्सा है
चर्चा अक्सर इस पर केंद्रित होती है कि क्या कोई मॉडल किसी हानिकारक अनुरोध को अस्वीकार करेगा। एक एजेंटिक सिस्टम में, आसपास के टूल भी उतने ही मायने रख सकते हैं।
नेटवर्क पहुँच के बिना कोई मॉडल किसी शोषण-विधि का वर्णन कर सकता है लेकिन इंटरनेट स्कैन नहीं कर सकता। ब्राउज़र, टर्मिनल, क्रेडेंशियल और अप्रतिबंधित आउटबाउंड पहुँच वाला मॉडल किसी विचार को कार्रवाई में बदल सकता है। एक कमज़ोर सैंडबॉक्स ऐसे सिस्टम उजागर कर सकता है जिन्हें कभी परीक्षण का हिस्सा बनाने का इरादा ही नहीं था।
किसी साइबर AI सेवा का मूल्यांकन करते समय सुरक्षा टीमों को ये सवाल पूछने चाहिए:
- मॉडल किन टूल को कॉल कर सकता है?
- कमांड कहाँ चलते हैं?
- रनटाइम को कौन-से क्रेडेंशियल उपलब्ध हैं?
- क्या लक्ष्यों को तकनीकी रूप से अनुमति-सूचीबद्ध किया जा सकता है?
- क्या आउटबाउंड नेटवर्क पहुँच सीमित है?
- क्या निगरानी किसी कार्रवाई को निष्पादन से पहले रोक सकती है?
- कौन मंज़ूर, रोक और समाप्त कर सकता है?
- जाँच के लिए कौन-से सबूत सुरक्षित रखे जाते हैं?
कमज़ोर हार्नेस के भीतर एक मज़बूत मॉडल भी कमज़ोर सुरक्षा डिज़ाइन ही रहता है।
ट्रस्टेड एक्सेस एक समानता की समस्या पैदा करता है
प्रतिबंधित पहुँच का एक जायज़ सुरक्षा मक़सद है, लेकिन यह प्रोवाइडरों को यह तय करने की काफ़ी शक्ति भी देता है कि कौन भरोसेमंद डिफेंडर माना जाए।
बड़ी सुरक्षा कंपनियों, सरकारों और क्लाउड ग्राहकों को सत्यापित करना और सहारा देना आसान है। स्वतंत्र शोधकर्ताओं, छोटी परामर्श फ़र्मों, ओपन-सोर्स मेंटेनरों और कम-आय वाले क्षेत्रों के डिफेंडरों के पास औपचारिक ढाँचे न भी हों, तब भी उनका काम वैध और मूल्यवान हो सकता है।
अगर सबसे सक्षम रक्षात्मक टूल मुख्यतः बड़े संस्थानों के लिए उपलब्ध हों, तो हमलावर शायद वही सीमा न मानें। नतीजा यह हो सकता है कि अच्छी तरह वित्तपोषित संगठनों और सीमित संसाधनों में व्यापक रूप से इस्तेमाल होने वाले सॉफ़्टवेयर को बनाए रखने वालों के बीच की खाई और चौड़ी हो जाए।
प्रोवाइडर पारदर्शी पात्रता नियमों, अपील के रास्तों, सब्सिडी वाले कार्यक्रमों, शोध पहुँच और ऐसी साझेदारियों से इस समस्या को घटा सकते हैं जो हर आवेदक को अप्रतिबंधित आक्रामक क्षमता दिए बिना छोटे मेंटेनरों को सत्यापित फ़िक्स पाने में मदद करें। उदाहरण के लिए, OpenAI की Daybreak सामग्री ओपन-सोर्स मेंटेनरों और अन्य फ्रंटलाइन डिफेंडरों के समर्थन का वर्णन करती है। ये कार्यक्रम व्यापक और निष्पक्ष पहुँच देते हैं या नहीं, इसके लिए समय के साथ सबूत चाहिए होंगे।
ट्रस्टेड एक्सेस को सिर्फ़ इस आधार पर नहीं आँका जाना चाहिए कि यह क्या रोकता है, बल्कि इस आधार पर भी कि यह किन वैध डिफेंडरों को सक्षम बनाता है।
सुरक्षा नेताओं को क्या माँगना चाहिए
उन्नत साइबर AI पर विचार करने वाले संगठन को प्रोवाइडर की मंज़ूरी को यह सबूत नहीं मानना चाहिए कि उसकी तैनाती सुरक्षित है।
अपनाने से पहले, इन्हें कवर करने वाला एक लिखित परिचालन मॉडल माँगें:
- अनुमोदित इस्तेमाल और निषिद्ध लक्ष्य;
- ऑपरेटर भूमिकाएँ और मज़बूत प्रमाणीकरण;
- लक्ष्य का स्वामित्व और प्राधिकरण के सबूत;
- सैंडबॉक्स और नेटवर्क सीमाएँ;
- क्रेडेंशियल प्रबंधन;
- निगरानी और समाप्ति;
- मानव मंज़ूरी के बिंदु;
- खोज की पुष्टि और समन्वित खुलासा;
- लॉग, प्रतिधारण और गोपनीयता; और
- घटना प्रतिक्रिया और पहुँच रद्दीकरण।
एक संकरे वर्कफ़्लो से शुरुआत करें जहाँ नतीजों की स्वतंत्र रूप से पुष्टि की जा सके। किसी नियंत्रित कोडबेस के भीतर कमज़ोरी की छँटाई या पैच समीक्षा, प्रोडक्शन पहुँच वाले खुले-सिरे वाले एजेंट से बेहतर तरीक़े से नियंत्रित की जा सकती है। ग़लत खोज, छूटी हुई खोज, समीक्षक के प्रयास और असुरक्षित कार्रवाइयाँ मापें—सिर्फ़ यह नहीं कि मॉडल कितनी कमज़ोरियाँ रिपोर्ट करता है।
दिशा स्पष्ट है, पर मॉडल अधूरा है
फ्रंटियर साइबर AI गेटेड पहुँच की ओर बढ़ रहा है क्योंकि प्रोवाइडर एक असली दोहरे-इस्तेमाल की समस्या का सामना कर रहे हैं। वही तर्क और टूल-इस्तेमाल क्षमताएँ जो किसी डिफेंडर को कमज़ोरी बंद करने में मदद करती हैं, किसी हमलावर को उसका फ़ायदा उठाने में भी मदद कर सकती हैं।
सत्यापन एक उचित शुरुआती बिंदु है। यह पूरी सुरक्षा वास्तुकला नहीं है। सुरक्षित संचालन लागू करने योग्य दायरे, सीमित टूल, कंटेनमेंट, निगरानी, सही जगह रखे गए मानव फ़ैसलों और बाद में समीक्षा किए जा सकने वाले सबूतों पर निर्भर करता है।
उद्योग अभी तय कर रहा है कि किसे पहुँच मिलनी चाहिए, प्रोवाइडरों को क्या निगरानी करनी चाहिए, और कितनी ज़िम्मेदारी ग्राहक के पास रहती है। ये फ़ैसले तय करेंगे कि ट्रस्टेड-एक्सेस कार्यक्रम गंभीर सुरक्षा नियंत्रण बनते हैं या सिर्फ़ शक्तिशाली उत्पादों के विशिष्ट प्रवेश द्वार बनकर रह जाते हैं।
संदर्भ और आगे पढ़ने के लिए
- Proactive cyber defense for governments and enterprises — Google, 2 सितंबर 2026. Fairwind Program, उसके इच्छित प्रतिभागियों और सार्वजनिक रूप से बताई गई परिचालन शर्तों का परिचय देता है।
- Claude Fable 5.1 and Mythos 5.1 — Anthropic, सितंबर 2026. Mythos 5.1 के लिए साझा अंतर्निहित मॉडल, अलग-अलग सुरक्षा स्तर और ट्रस्टेड-एक्सेस सीमा को समझाता है।
- Improving our alignment and security practices — Anthropic, 31 अगस्त 2026. उच्च-जोखिम साइबर मूल्यांकनों के लिए कंटेनमेंट, निगरानी, दायरा-निर्धारण और मार्गदर्शन का वर्णन करता है।
- Path to Astra: critical capabilities and frontier safeguards — OpenAI, सितंबर 2026. OpenAI की क्रिटिकल साइबर-सुरक्षा सीमा, मूल्यांकन दावों और सीमित-पहुँच दृष्टिकोण का वर्णन करता है।
- Daybreak — OpenAI. सत्यापित पहुँच, नियंत्रित रक्षात्मक वर्कफ़्लो और चुनिंदा डिफेंडर समूहों के समर्थन का वर्णन करता है।
स्रोत समीक्षा तिथि: 25 सितंबर 2026.
संबंधित पठन: DNS सर्वर उच्च-मूल्य वाला हमला लक्ष्य क्यों बने रहते हैं, जब AI मॉडल दूसरे AI मॉडलों से सीखते हैं: डिस्टिलेशन, API दुरुपयोग और निर्यात नियंत्रणों की सीमाएँ और AI क़ीमत जंग टोकन क़ीमतों से प्रति कार्य लागत की ओर बढ़ रही है.