

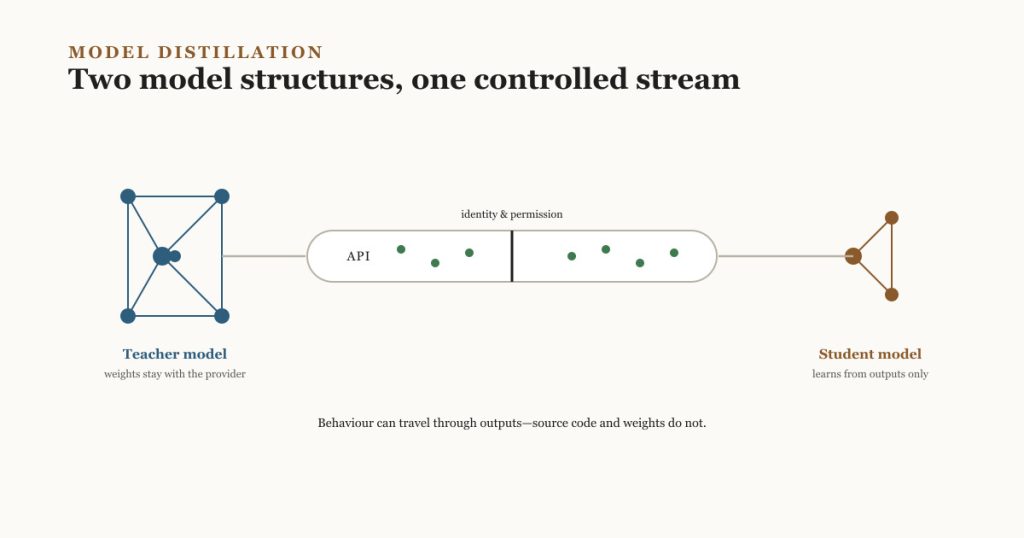
मॉडल डिस्टिलेशन एक उपयोगी इंजीनियरिंग तरीका है। मुश्किल सवाल तब शुरू होते हैं जब किसी दूसरी कंपनी का मॉडल बिना अनुमति के ट्रेनिंग डेटा का स्रोत बन जाता है।
मान लीजिए किसी कंपनी ने एक शक्तिशाली लेकिन महंगा AI मॉडल बनाया है। उसे एक छोटा वर्शन चाहिए जो सामान्य सवालों का जवाब तेज़ी से और कम लागत में दे सके।
एक तरीका यह है कि बड़े मॉडल से हज़ारों सोच-समझकर चुने गए सवाल पूछे जाएँ, उसके जवाब इकट्ठा किए जाएँ, और उन उदाहरणों से छोटे मॉडल को प्रशिक्षित किया जाए। छोटे सिस्टम में बड़े मॉडल की ठीक-ठीक कॉपी नहीं होगी, लेकिन वह उसके कुछ उपयोगी व्यवहार को सीख सकता है।
इस तरह की तकनीकों को नॉलेज डिस्टिलेशन (knowledge distillation) कहा जाता है। यह मशीन लर्निंग में व्यापक रूप से इस्तेमाल होती है और अपने आप में संदिग्ध नहीं है।
यही बुनियादी विचार विवादास्पद तब बन जाता है जब टीचर मॉडल किसी दूसरी कंपनी का हो, पहुँच उन खातों या क्षेत्रों के ज़रिए हासिल की गई हो जिन्हें प्रोवाइडर ने प्रतिबंधित किया हो, और बिना अनुमति के लाखों आउटपुट ट्रेनिंग के लिए इकट्ठा किए गए हों।
यह विवाद फ़रवरी 2026 में सार्वजनिक हुआ, जब Anthropic ने DeepSeek, Moonshot AI और MiniMax पर Claude से क्षमताएँ निकालने के लिए बड़े पैमाने पर अभियान चलाने का आरोप लगाया। यह मामला महत्वपूर्ण है, लेकिन इसलिए नहीं कि यह साबित करता है कि कोई एक देश किसी दूसरी कंपनी के मॉडल को सीधे “कॉपी” कर सकता है। यह मॉडल एक्सेस, API सुरक्षा, अनुबंध के नियमों और राष्ट्रीय निर्यात नियंत्रणों के बीच के एक अंतर को उजागर करता है।
डिस्टिलेशन असल में क्या स्थानांतरित करता है
यह विचार आज के बड़े भाषा मॉडलों से पहले का है। अपने 2015 के पेपर में, Geoffrey Hinton, Oriol Vinyals और Jeff Dean ने बताया था कि किसी बड़े मॉडल या मॉडलों के समूह के ज्ञान को एक ऐसे छोटे सिस्टम में कैसे स्थानांतरित किया जा सकता है जिसे डिप्लॉय करना आसान हो।
एक स्टूडेंट मॉडल टीचर के आउटपुट से कई तरह की चीज़ें सीख सकता है। यह अंतिम जवाब, प्रोबेबिलिटी डिस्ट्रिब्यूशन, रैंकिंग, सुधार या किसी काम को करने के तरीके के प्रदर्शन की नकल कर सकता है। भाषा मॉडल के लिए, ट्रेनिंग सामग्री में जनरेट किया गया कोड, हल की गई रीज़निंग समस्याएँ, टूल-यूज़ के उदाहरण या यह फ़ीडबैक शामिल हो सकता है कि कौन-सा जवाब बेहतर है।
स्टूडेंट को टीचर का सोर्स कोड, ट्रेनिंग डेटासेट या मॉडल वेट्स नहीं मिलते। वह आउटपुट के ज़रिए व्यवहार को देखता है। पर्याप्त अच्छी तरह डिज़ाइन किए गए उदाहरणों के साथ, ये आउटपुट अब भी मूल्यवान हो सकते हैं।
इसीलिए “मॉडल चुराना” वाक्यांश भ्रामक हो सकता है। आउटपुट-आधारित डिस्टिलेशन आमतौर पर बिल्कुल एक जैसा मॉडल नहीं बनाता। यह चुनी हुई क्षमताएँ सिखाने में लगने वाला समय और प्रयोग कम कर सकता है, ख़ासकर तब जब स्टूडेंट के डेवलपर्स को पता हो कि क्या पूछना है और जवाबों को ट्रेनिंग डेटा में कैसे बदलना है।
वैध इस्तेमाल कहाँ खत्म होता है
मॉडल प्रोवाइडर अपने प्लेटफ़ॉर्म के भीतर, प्रोडक्ट की शर्तों और डेटा नियमों के अधीन, डिस्टिलेशन का समर्थन कर सकते हैं। शोधकर्ता भी उन मॉडलों को डिस्टिल कर सकते हैं जो उनके अपने हैं या जिनके इस्तेमाल की उन्हें अनुमति है।
मुश्किल सीमा तकनीक नहीं है। यह इस बात की है कि एक्सेस और आउटपुट कैसे हासिल किए जाते हैं और कैसे इस्तेमाल होते हैं।
जो सवाल मायने रखते हैं, वे हैं:
- क्या प्रोवाइडर ने अपने आउटपुट को किसी दूसरे मॉडल को प्रशिक्षित करने के लिए इस्तेमाल करने की अनुमति दी थी?
- क्या खाते असली थे और सही तरीके से बताए गए थे?
- क्या उपयोगकर्ता ने किसी क्षेत्रीय या संगठनात्मक एक्सेस प्रतिबंध को दरकिनार किया?
- क्या पहचान या रेट-लिमिट से बचने के लिए ट्रैफ़िक को कई खातों में बाँटा गया?
- क्या असली ग्राहक को छुपाने के लिए प्रॉक्सी सेवाओं का इस्तेमाल किया गया?
- क्या इस गतिविधि ने किसी अनुबंध, प्लेटफ़ॉर्म नियम या लागू कानून का उल्लंघन किया?
सिर्फ़ प्रॉम्प्ट की ज़्यादा संख्या इन सवालों का जवाब नहीं देती। मॉडल मूल्यांकन, सिंथेटिक-डेटा जनरेशन और सामान्य व्यावसायिक उत्पाद भी भारी API ट्रैफ़िक पैदा कर सकते हैं। प्रोवाइडर्स को खातों, भुगतानों, नेटवर्क इन्फ़्रास्ट्रक्चर, समय और प्रॉम्प्ट डिज़ाइन के पैटर्न जाँचने पड़ते हैं।
रास्ता A — अनुमति-प्राप्त डिस्टिलेशन
- स्वयं का या लाइसेंस-प्राप्त टीचर मॉडल
- अनुमोदित API या आंतरिक पहुँच
- अनुमति-प्राप्त ट्रेनिंग उदाहरण
- स्टूडेंट-मॉडल ट्रेनिंग
रास्ता B — विवादित निष्कर्षण पैटर्न
- प्रतिबंधित बाहरी मॉडल
- प्रॉक्सी सेवा और समन्वित खाते
- लक्षित आउटपुट संग्रहण
- स्टूडेंट-मॉडल ट्रेनिंग
रास्ता B कहाँ विवादित है
खाता पहचान
रास्ता B ऐसे खातों पर निर्भर करता है जो असली या सही तरीके से नहीं बताए गए — यह रास्ता A के उलट है, जहाँ पहुँच प्रोवाइडर की अपनी शर्तों के तहत मिलती है।
ट्रेनिंग की अनुमति
रास्ता A केवल उन्हीं आउटपुट का इस्तेमाल करता है जिनके लिए प्रोवाइडर ने किसी दूसरे मॉडल को प्रशिक्षित करने पर सहमति दी हो। रास्ता B उस सहमति के बिना आउटपुट इकट्ठा करता है।
क्षेत्रीय पहुँच
रास्ता B में प्रोवाइडर द्वारा प्रतिबंधित किसी क्षेत्र या संगठन के ज़रिए मॉडल तक पहुँचना शामिल हो सकता है, न कि वह पहुँच जो प्रोवाइडर ने वास्तव में दी थी।
सेवा की शर्तें
रास्ता B में समन्वित खाते और प्रॉक्सी सेवाएँ आमतौर पर अपने आप में प्लेटफ़ॉर्म की शर्तों का उल्लंघन होती हैं, भले ही इकट्ठा किए गए आउटपुट का बाद में जो भी इस्तेमाल हो।
प्रोवाइडर्स मज़बूत ग्राहक सत्यापन, व्यवहार-आधारित पहचान, क्रॉस-अकाउंट विश्लेषण और संदिग्ध आउटपुट पैटर्न पर सीमाओं के साथ जवाब दे रहे हैं। इन नियंत्रणों की एक कीमत है। आक्रामक ब्लॉकिंग वैध शोध, स्टार्टअप और मूल्यांकन कार्य को बाधित कर सकती है। कमज़ोर नियंत्रण API को बिना अनुमति के डेटा-जनरेशन सेवा के रूप में इस्तेमाल होने देते हैं।
Anthropic ने क्या पाया होने का दावा किया
Anthropic की फ़रवरी 2026 की रिपोर्ट के अनुसार, नामित तीनों लैब्स ने लगभग 24,000 धोखाधड़ी वाले खातों के ज़रिए 1.6 करोड़ से ज़्यादा Claude एक्सचेंज बनाए।
कंपनी ने DeepSeek को 1,50,000 से ज़्यादा, Moonshot AI को 34 लाख से ज़्यादा और MiniMax को 1.3 करोड़ से ज़्यादा एक्सचेंज बताए। इसका कहना है कि ये अभियान कोडिंग, रीज़निंग, टूल यूज़, कंप्यूटर यूज़ और डेटा विश्लेषण जैसी क्षमताओं पर केंद्रित थे। Anthropic यह भी कहता है कि खातों को प्रॉक्सी सेवाओं के ज़रिए समन्वित किया गया था और जब नए Claude मॉडल उपलब्ध हुए तो उनका व्यवहार बदल गया।
इन विवरणों को दो शर्तों के साथ सही तरीके से बताया जाना चाहिए।
पहला, आँकड़े और ज़िम्मेदारी तय करना Anthropic की तरफ़ से है। कंपनी का कहना है कि उसने रिक्वेस्ट मेटाडेटा, IP सह-संबंध, इन्फ़्रास्ट्रक्चर संकेतकों और उद्योग भागीदारों से मिली पुष्टि का इस्तेमाल किया। पूरा अंतर्निहित सबूत सार्वजनिक नहीं है, इसलिए बाहरी पाठक सिर्फ़ इस रिपोर्ट से स्वतंत्र रूप से इस निष्कर्ष को दोबारा साबित नहीं कर सकते।
दूसरा, यह रिपोर्ट तीन कंपनियों की कथित गतिविधि के बारे में बताती है। इसे इस दावे तक नहीं बढ़ाना चाहिए कि हर चीनी AI लैब इसी तरह प्रशिक्षण करती है, या चीनी मॉडलों की प्रगति को मुख्यतः डिस्टिलेशन से समझाया जा सकता है। घरेलू शोध, ओपन मॉडल, इंजीनियरिंग सुधार, डेटा, हार्डवेयर और बड़े पैमाने का निवेश भी इसमें योगदान देते हैं।
इसलिए ज़िम्मेदार शब्दावली सीधी है: Anthropic ने एक विस्तृत आरोप लगाया है और अपनी पहचान पद्धति बताई है; सार्वजनिक सबूत अब भी अधूरा है।
API ट्रेनिंग-डेटा चैनल क्यों बन सकता है
मॉडल वेट्स जारी करने के मुक़ाबले API ज़्यादा सुरक्षित लगता है। प्रोवाइडर मॉडल को अपने ही इन्फ़्रास्ट्रक्चर पर रखता है, उपयोगकर्ताओं को प्रमाणित करता है, ट्रैफ़िक सीमित करता है और एक्सेस बदल या रद्द कर सकता है।
लेकिन हर उपयोगी जवाब मॉडल के व्यवहार के बारे में कुछ न कुछ उजागर करता है। कुछ सामान्य बातचीत बहुत कम उजागर करती हैं। ध्यान से चुने गए लाखों एक्सचेंज किसी खास कौशल को लक्षित करने वाला एक संरचित डेटासेट बना सकते हैं।
हमलावर खातों, भुगतान के तरीकों, क्लाउड सेवाओं और प्रॉक्सी नेटवर्क में ट्रैफ़िक बाँटकर इसे पकड़ना मुश्किल बना सकते हैं। अलग-अलग रिक्वेस्ट हानिरहित लग सकती हैं। यह अभियान तभी दिखाई देता है जब प्रोवाइडर बड़े सिस्टम में गतिविधि को आपस में जोड़ता है।
एक अकेला सवाल वैध हो सकता है। समन्वय उस गतिविधि का मतलब बदल देता है।
निर्यात नियंत्रण कहाँ फ़िट बैठते हैं—और कहाँ नहीं
अमेरिकी निर्यात नियंत्रण मुख्य रूप से उन्नत कंप्यूटिंग चिप्स, सेमीकंडक्टर उपकरण, और हाल में कुछ उन्नत AI मॉडल वेट्स पर केंद्रित रहे हैं। ये नियंत्रण भौतिक कंप्यूट तक पहुँच और अत्यधिक सक्षम मॉडलों के सीधे हस्तांतरण को संबोधित करते हैं।
API एक्सेस अलग है। मॉडल वेट्स प्रोवाइडर के पास ही रहते हैं जबकि उपयोगकर्ता को आउटपुट मिलता है। US Bureau of Industry and Security के नियम और मार्गदर्शन मॉडल वेट्स, इन्फ़्रास्ट्रक्चर सेवाओं, अंतिम उपयोगकर्ताओं और अंतिम उपयोगों में फ़र्क़ करते हैं; वे हर रिमोट मॉडल जवाब को अंतर्निहित मॉडल के नियंत्रित हस्तांतरण में नहीं बदलते।
इससे एक नीतिगत समस्या पैदा होती है। उन्नत चिप्स को सीमित करने से बड़े पैमाने पर प्रशिक्षण और मुश्किल हो सकता है। मॉडल वेट्स को सीमित करने से पूरे मॉडल का हस्तांतरण रोका जा सकता है। कोई भी उपाय अपने आप किसी विदेशी संगठन को बिचौलियों के ज़रिए आउटपुट इकट्ठा करने से नहीं रोकता।
Anthropic का तर्क है कि औद्योगिक-स्तर का डिस्टिलेशन किसी सीमित लैब को शुरू से पूरा प्रशिक्षण देने के मुक़ाबले सस्ते में क्षमता के अंतर का कुछ हिस्सा पाटने में मदद कर सकता है। यह निर्यात नियंत्रणों के लिए अपने व्यापक समर्थन से जुड़ा एक कंपनी का रुख़ है। यह मानने लायक है कि उच्च-गुणवत्ता वाला सिंथेटिक डेटा कुछ प्रशिक्षण कार्य कम कर देता है, लेकिन इस असर को सार्वजनिक रूप से मापना मुश्किल है। एक स्टूडेंट को फिर भी अपनी ख़ुद की आर्किटेक्चर, कंप्यूट, डेटा पाइपलाइन, ट्रेनिंग प्रक्रिया और मूल्यांकन की ज़रूरत होती है।
API के अंतर को बंद करना भी मुश्किल होगा। व्यापक प्रतिबंध वैध ग्राहकों, शोधकर्ताओं और डेवलपर्स को रोक सकते हैं, जबकि दृढ़ उपयोगकर्ता ट्रैफ़िक को दूसरे देशों या रीसेलर्स के ज़रिए भेज सकते हैं। हर API जवाब को निर्यात-नियंत्रित वस्तु मानने के मुक़ाबले पहचान जाँच, प्रॉक्सी पहचान और प्रोवाइडर का सहयोग ज़्यादा व्यावहारिक हो सकते हैं।
इंजीनियरिंग टीमों को इससे क्या सीखना चाहिए
AI सिस्टम बनाने या ख़रीदने वाली टीमों को अक्सर मिला दिए जाने वाले चार मुद्दों को अलग-अलग रखना चाहिए।
तकनीक: डिस्टिलेशन टीचर मॉडल से स्टूडेंट तक व्यवहार स्थानांतरित करने का एक सामान्य तरीका है।
अनुमति: प्रोवाइडर का अनुबंध और प्रोडक्ट नियम तय करते हैं कि आउटपुट को प्रशिक्षण के लिए इस्तेमाल किया जा सकता है या नहीं।
सुरक्षा: खाता पहचान, प्रॉक्सी, समन्वित ट्रैफ़िक और बचाव के तरीके तय करते हैं कि एक्सेस का पैटर्न दुरुपयोग वाला है या नहीं।
नीति: निर्यात नियंत्रण तय करते हैं कि कानून के तहत कौन-से चिप्स, मॉडल वेट्स, सेवाएँ, अंतिम उपयोगकर्ता या अंतिम उपयोग प्रतिबंधित हैं।
डिस्टिलेशन की योजना बना रहे संगठन को यह दस्तावेज़ करना चाहिए कि उसका टीचर डेटा कहाँ से आया, प्रशिक्षण में इस्तेमाल की अनुमति है या नहीं, डेटा कैसे रखा जाता है, और कौन-सा स्टूडेंट मॉडल उसे प्राप्त करता है। API प्रोवाइडर्स को ऐसे नियंत्रण चाहिए जो सिर्फ़ रिक्वेस्ट की मात्रा से आगे देखें और खातों में व्यवहार को आपस में जोड़ें। नीति-निर्माताओं को यह स्पष्ट होना चाहिए कि क्या नियंत्रित किया जा रहा है: हार्डवेयर, वेट्स, एक्सेस या आउटपुट।
ऐसी कोई एक रेखा नहीं है जहाँ ये चारों सवाल एक ही सवाल बन जाते हैं।
बड़ा सबक
AI क्षमता अब केवल प्रकाशित शोध, कर्मचारियों या डाउनलोड की जा सकने वाली मॉडल फ़ाइलों के ज़रिए नहीं चलती। यह आउटपुट के ज़रिए भी आगे बढ़ सकती है।
इसका मतलब यह नहीं है कि हर मॉडल जवाब गुप्त ट्रेनिंग सामग्री बन जाता है, और यह डिस्टिलेशन को चोरी के बराबर भी नहीं बनाता। इसका मतलब यह है कि मॉडल प्रोवाइडर्स को API व्यवहार को अपनी सुरक्षा सीमा का हिस्सा मानना चाहिए, जबकि ग्राहकों को जनरेट किए गए ट्रेनिंग डेटा को ऐसी सामग्री मानना चाहिए जिसका एक मूल स्रोत और लाइसेंस है।
अनसुलझा मुद्दा यह नहीं है कि क्या एक AI दूसरे AI से सीख सकता है। वह स्पष्ट रूप से सीख सकता है। मुश्किल सवाल यह तय करना है कि वह सीखना कब अधिकृत है, वह कब प्लेटफ़ॉर्म के दुरुपयोग में बदल जाता है, और क्या मौजूदा व्यापार नियम उस दुनिया के लिए बनाए गए थे जिसमें उपयोगी क्षमता को एक-एक जवाब के ज़रिए हासिल किया जा सकता है।
संदर्भ और आगे पढ़ने के लिए
- Distilling the Knowledge in a Neural Network — Geoffrey Hinton, Oriol Vinyals और Jeff Dean, 2015. बड़े मॉडलों या समूहों से ज्ञान को एक छोटे मॉडल में स्थानांतरित करने की मूल व्याख्या।
- Detecting and preventing distillation attacks — Anthropic, 23 फ़रवरी 2026. Anthropic के आरोप, पहचान पद्धति, अभियान के आँकड़े और प्रस्तावित उपाय।
- Export Administration Regulations, Part 742 — US Bureau of Industry and Security. निर्दिष्ट AI मॉडल वेट्स को कवर करने वाले प्रावधानों सहित मौजूदा नियंत्रण नीति।
- Export Administration Regulations, Part 748 — US Bureau of Industry and Security. नियंत्रित वस्तुओं और AI मॉडल वेट्स से संबंधित आवेदन और प्राधिकरण आवश्यकताएँ।
- Department of Commerce announces rescission of AI Diffusion Rule and strengthens chip-related controls — US Department of Commerce, 13 मई 2025. नीतिगत बदलाव और उन्नत सेमीकंडक्टर नियंत्रणों पर जारी ध्यान को समझाता है।
स्रोत समीक्षा तिथि: 24 सितंबर 2026.