

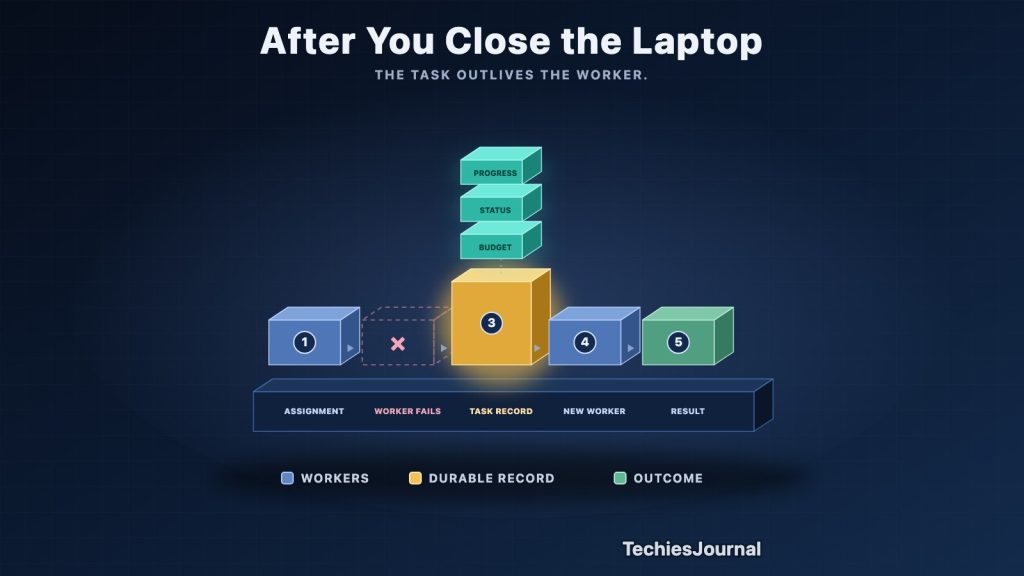
घंटों तक काम करने वाले एजेंट को सिर्फ चलने की जगह नहीं चाहिए। उसे प्रगति का टिकाऊ रिकॉर्ड चाहिए, टूल्स तक सीमित पहुँच चाहिए, और रुकने का ऐसा तरीका चाहिए जिसके बाद बिज़नेस को यह अनिश्चितता न रहे कि क्या हुआ।
काम बातचीत से ज़्यादा देर तक चलता है
एक काल्पनिक मैन्युफैक्चरिंग कंपनी की कल्पना कीजिए, जिसकी एक डिलीवरी में देरी हो रही है। परचेजिंग मैनेजर एक AI एजेंट से कहता है कि वह वैकल्पिक सप्लायर खोजे, डिलीवरी की तारीखों की तुलना करे और अगली सुबह के लिए एक सिफारिश तैयार करे। मैनेजर लैपटॉप बंद कर देता है। काम जारी रहता है।
यूज़र अनुभव में यह छोटा-सा बदलाव संचालन की बहुत बड़ी ज़िम्मेदारी पैदा करता है। कहीं न कहीं कोई सिस्टम होना चाहिए जो असाइनमेंट को याद रखे, जाँच चलाए, जानकारी का इंतज़ार करे और मैनेजर के लौटने पर नतीजा समझा सके। अगर रात में कोई worker क्रैश हो जाए, तब भी कंपनी उम्मीद करती है कि टास्क की स्थिति साफ़ रहे।
Google की 8 अक्टूबर की Gemini at Work घोषणा घंटों या दिनों तक चलने वाले persistent क्लाउड execution और एजेंटों के बीच तालमेल का वर्णन करती है। यह एंटरप्राइज़ सॉफ़्टवेयर के लिए एक उपयोगी दिशा दिखाती है, लेकिन घोषणा इस बात का प्रमाण नहीं है कि कोई खास वर्कलोड अपनी विश्वसनीयता या लागत की ज़रूरतें पूरी करेगा।
व्यावहारिक सवाल यह है कि उस अनुभव के नीचे संगठन को क्या चाहिए। Article 1 में एजेंट की सिफारिश और कार्रवाई करने की अनुमति के बीच की सीमा को देखा गया था। यहाँ ध्यान इस पर है कि असाइनमेंट जब मशीनों के बीच जाता है, अनुमतियों का इंतज़ार करता है और संसाधन खर्च करता है, तब उसे क्या चीज़ संभालने लायक बनाए रखती है।
बिज़नेस टास्क की उम्र उस प्रोसेस की उम्र पर निर्भर नहीं होनी चाहिए जो फिलहाल उस पर काम कर रही है।
चलती हुई प्रोसेस टिकाऊ टास्क नहीं है
सप्लायर जाँच की शुरुआत डिलीवरी के अनुमान जुटाने से होती है। एक घंटे बाद, उसे चला रहा worker फेल हो जाता है। नया worker शुरू करने से कंप्यूटिंग क्षमता लौट आती है। लेकिन अपने आप में वह उस worker को यह नहीं बताता कि कौन-से सप्लायर जाँचे जा चुके हैं, कौन-से नतीजे सेव हुए हैं, या कौन-सी कार्रवाई पहले ही माँगी जा चुकी है।
इस परिदृश्य में, एप्लिकेशन को worker के बाहर एक टिकाऊ टास्क रिकॉर्ड रखना चाहिए। इस रिकॉर्ड में एक स्थिर पहचान, मूल उद्देश्य, मौजूदा चरण, सेव किए गए नतीजों के संदर्भ और साफ़ स्थिति होनी चाहिए। तब worker टास्क का एक भागीदार बन जाता है, टास्क के अस्तित्व की इकलौती जगह नहीं।
यह फ़र्क ब्राउज़र डिस्कनेक्ट होने के बाद काम जारी रखने और प्रोसेस फेल होने के बाद रिकवर करने को भी अलग करता है। Microsoft का long-running hosted-agent दस्तावेज़ बैकग्राउंड execution और resilience में अंतर करता है। इसका बताया गया रिकवरी तंत्र प्रोसेस खोने के बाद handler में दोबारा प्रवेश कर सकता है, जबकि सार्थक प्रगति को सुरक्षित रखने की ज़िम्मेदारी एप्लिकेशन की रहती है। वर्णित hosted-agent क्षमताएँ preview में हैं, जो प्रोडक्शन के लिए उनकी उपयुक्तता आँकते समय मायने रखता है।
मान लीजिए जाँच ने अनुमोदित सप्लायरों की खोज पूरी कर ली है और अब मैनेजर की अनुमति का इंतज़ार कर रही है कि खोज का दायरा बढ़ाया जाए। एक उपयोगी चेकपॉइंट उस सीमा और उसके पीछे के सबूत को सुरक्षित रखेगा। सिर्फ बातचीत का ट्रांसक्रिप्ट सेव करने पर रिकवर हो रहे एप्लिकेशन को अंदाज़ा लगाना पड़ेगा कि अनुमति माँगी गई थी, मिल गई थी, या अभी लंबित है।
टिकाऊ workflow सिस्टम एक और तरीका देते हैं। Temporal का workflow दस्तावेज़ दर्ज की गई event history और replay के ज़रिए रिकवरी का वर्णन करता है। यह एक खास execution मॉडल है, जिसमें workflow कोड पर पाबंदियाँ हैं। इसे हर एजेंट runtime का वर्णन नहीं मान लेना चाहिए, और न ही यह मान लेना चाहिए कि इससे मनमाने मॉडल कॉल दोहराने योग्य हो जाते हैं।
इसलिए डिज़ाइन का फ़ैसला ठोस है: तय कीजिए कि प्रगति का मालिक कौन-सा कॉम्पोनेंट है, वह पूरे हो चुके चरणों को कैसे दर्ज करता है, और नया worker अगली सुरक्षित सीमा कैसे ढूँढता है। “persistent” बताई गई कोई सेवा खरीद लेने से पूरे एप्लिकेशन के लिए इन सवालों का जवाब नहीं मिल जाता।
इंतज़ार और काम को अलग रखें
एजेंट को दो संभावित सप्लायर मिलते हैं, लेकिन एक के लिए इंजीनियरिंग रिव्यू ज़रूरी है। टास्क अब सुबह तक इंतज़ार कर सकता है। उस पूरे इंतज़ार में worker को सक्रिय रूप से चालू रखने से इंतज़ार की अवधि उसकी कंप्यूटिंग लागत का हिस्सा बन जाएगी, जबकि ज़रूरी नहीं कि जाँच आगे बढ़े।
इस असाइनमेंट के लिए एक समझदार डिज़ाइन सेव किए गए टास्क को उसे आगे बढ़ाने वाले संसाधनों से अलग रखता है। कोई टिकाऊ event या निर्धारित जाँच टास्क को तब दोबारा शुरू होने लायक बना सकती है जब रिव्यू आ जाए। फिर एक worker ज़रूरी state लोड करके आगे बढ़ता है। इंटरफ़ेस को दिखाना चाहिए कि टास्क इंजीनियरिंग का इंतज़ार कर रहा है, न कि यह धुंधला संकेत देना कि वह अब भी सोच रहा है।
कुछ अपवाद हैं। ब्राउज़र सेशन, लोड किया हुआ लोकल मॉडल या कोई विशेषज्ञ टूल दोबारा बनाना महँगा हो सकता है। उस वातावरण को बनाए रखना फ़ायदेमंद हो सकता है। फ़ैसला मापी गई सेटअप लागत और वर्कलोड की ज़रूरतों पर होना चाहिए, इस धारणा पर नहीं कि हर एजेंट को हमेशा चलती मशीन चाहिए।
यही अनुशासन समानांतर काम पर भी लागू होता है। कई स्वतंत्र सप्लायरों को एक साथ जाँचने से बीता हुआ समय घट सकता है, लेकिन अतिरिक्त worker downstream सिस्टमों पर एक साथ ज़्यादा अनुरोध भी पैदा करते हैं। अगर सप्लायर API पहले से ही अड़चन है, तो worker की संख्या बढ़ाने से सिर्फ टकराव बढ़ सकता है।
परचेजिंग टास्क के लिए, मैं concurrency की सीमाएँ टास्क के स्तर पर भी तय करूँगा और साझा सेवाओं के स्तर पर भी। सप्लायर जाँच को सारी उपलब्ध क्षमता इसलिए नहीं खा लेनी चाहिए कि उसे खोजने के लिए और शाखाएँ मिल गईं। ज़रूरी काम को queue में जगह चाहिए, और कम प्राथमिकता वाले काम के लिए देरी की साफ़ नीति चाहिए।
यह एक इंफ्रास्ट्रक्चर चुनाव है जिसका बिज़नेस पर असर होता है। ज़्यादा क्षमता प्रतिक्रिया-गति सुधार सकती है, लेकिन प्रवेश नियमों के बिना क्षमता यह अनुमान लगाना कठिन बना देती है कि किसका काम समय पर पूरा होगा।
टास्क को बजट और रुकने का नियम दीजिए
एजेंट ने सप्लायरों की तुलना कर ली है, लेकिन सबूत अधूरे हैं। वह फिर से खोजने का फ़ैसला करता है, किसी दूसरे एजेंट से विकल्पों की समीक्षा करवाता है और एक दस्तावेज़ विश्लेषण दोहराता है। हर कदम अकेले देखने पर तर्कसंगत लग सकता है। साथ मिलकर, वे ऐसी जाँच बन सकते हैं जो कभी किसी फ़ैसले तक नहीं पहुँचती।
इस वर्कलोड के लिए, बजट सिर्फ मॉडल टोकन तक सीमित नहीं होना चाहिए। टास्क टूल कॉल, अस्थायी कंप्यूटिंग वातावरण, स्टोरेज और मानवीय समीक्षा भी इस्तेमाल कर सकता है। यह दावा करने से पहले कि सस्ता मॉडल पूरी प्रक्रिया को सस्ता बनाता है, टीमों को इन सभी लागतों को साथ मिलाकर मापना चाहिए।
Google की घोषणा model routing और ऐसी प्रोजेक्ट खर्च सीमाओं का वर्णन करती है जो सीमा पूरी होने पर एजेंट का काम रोक देती हैं। ये vendor द्वारा बताए गए नियंत्रण हैं, इस परचेजिंग workflow में बचत का कोई स्वतंत्र माप नहीं। प्रोजेक्ट की सीमा एक एप्लिकेशन-स्तर का सवाल भी छोड़ जाती है: जब यह खास असाइनमेंट आगे नहीं बढ़ सकता, तब उसका क्या होना चाहिए?
मैं टास्क को बीते समय, बार-बार की कोशिशों, सौंपे गए काम और खर्च की सीमाएँ दूँगा, और साथ में एक साफ़ escalation रास्ता। जब बचा हुआ बजट एक और उपयोगी खोज का बोझ नहीं उठा सकता, तब एजेंट को अपने पास मौजूद सबूत लौटाने चाहिए, बताना चाहिए कि क्या अनसुलझा है, और फ़ैसला माँगना चाहिए।
रोक (pause) की भी एक टिकाऊ स्थिति होनी चाहिए। अगर कोई बाहरी अनुरोध अभी चल रहा है, तो इंटरफ़ेस को यह बताना चाहिए। Cancel करने से आगे का कोई भी योग्य काम शुरू नहीं होना चाहिए, जबकि एप्लिकेशन पहले से चल रही कार्रवाइयों का नतीजा तय करता है। उसे वह रिकॉर्ड नहीं मिटाना चाहिए जो उन्हें समझाने के लिए चाहिए।
असुविधाजनक समझौता यह है कि सीमाओं में बँधा एजेंट वांछित उत्तर देने से पहले रुक सकता है। यही सही नतीजा हो सकता है। संगठन को यह जानना ज़रूरी है कि ऑटोमेशन अपने सबूतों या संसाधनों की सीमा तक कब पहुँच गया, बजाय इसके कि वह उस लगातार गतिविधि का खर्च उठाता रहे जो प्रगति जैसी दिखती है।
सिर्फ मशीनों को नहीं, असाइनमेंट को संचालित कीजिए
अगली सुबह हो सकता है कि हर सर्वर डैशबोर्ड हरा हो जबकि सप्लायर टास्क अब भी अटका हो। इंफ्रास्ट्रक्चर की उपलब्धता ऑपरेशंस टीम को बताती है कि कॉम्पोनेंट पहुँच में हैं। यह परचेजिंग मैनेजर को नहीं बताती कि असाइनमेंट आगे बढ़ रहा है, अनुमति का इंतज़ार कर रहा है, या जारी नहीं रह पा रहा।
इस परिदृश्य में, मैं टास्क की आखिरी सार्थक प्रगति, इंतज़ार का कारण, कोशिशें, खर्च और बाहरी कार्रवाइयों के संदर्भ ट्रैक करूँगा। तकनीकी लॉग उसी टास्क पहचान से जुड़े होने चाहिए ताकि ऑपरेटर मैनेजर के सवाल से संबंधित सबूत तक पहुँच सके। इन रिकॉर्ड तक पहुँच सप्लायर और कॉन्ट्रैक्ट जानकारी की संवेदनशीलता के अनुरूप होनी चाहिए।
सिस्टम पर भरोसा करने से पहले, सार्थक सीमाओं पर रुकावटों का परीक्षण कीजिए। क्लाइंट को डिस्कनेक्ट कीजिए। नतीजा सेव होने के बाद worker को रोकिए। किसी अनुमति में देरी कीजिए। टास्क का बजट खत्म कीजिए। टूल अनुरोध लंबित रहते हुए cancel कीजिए। हर परीक्षण से समझ में आने वाली टास्क स्थिति और रिकवरी या escalation का तय रास्ता निकलना चाहिए।
इसका मतलब यह नहीं कि हर एप्लिकेशन को समर्पित एजेंट प्लैटफ़ॉर्म चाहिए। छोटी, दोहराई जा सकने वाली दस्तावेज़ खोज के लिए पारंपरिक job queue और डेटाबेस पर्याप्त हो सकते हैं। अनुमतियों और बाहरी कार्रवाइयों तक फैली परचेजिंग जाँच के लिए ज़्यादा समृद्ध orchestration उचित हो सकता है। अतिरिक्त मशीनरी की अपनी रखरखाव लागत होती है, इसलिए जटिलता विफलता के परिणामों के अनुरूप होनी चाहिए।
अवसर यह है कि काम बातचीत के बाद भी जारी रहे, बिना उसकी प्रगति को अदृश्य या संसाधन उपयोग को असीमित बनाए। भरोसेमंद एजेंट इंफ्रास्ट्रक्चर किसी संगठन को असाइनमेंट का हिसाब रखने देता है, तब भी जब उसे चला रहा worker गायब हो चुका हो।
और गहराई से जानें
हर स्रोत 9 October 2026 को खोलकर जाँचा गया था। प्रोडक्ट का व्यवहार और उपलब्धता बदल सकती है, इसलिए भरोसा करने से पहले उन्हें दोबारा जाँच लें।
- Google Cloud: Gemini at Work 2026. 8 अक्टूबर 2026 को प्रकाशित। Vendor की घोषणा, जो persistent execution, काम सौंपने और लागत नियंत्रणों का वर्णन करती है। यह स्वतंत्र विश्वसनीयता मूल्यांकन नहीं है।
- Microsoft: Resilience for Long-Running Hosted Agents. Runtime रिकवरी और एप्लिकेशन के स्वामित्व वाली प्रगति के बीच की सीमा समझाता है। वर्णित क्षमताएँ preview में हैं।
- Temporal: Workflow Execution Overview. Temporal के टिकाऊ execution मॉडल में event history और replay को समझाता है।