

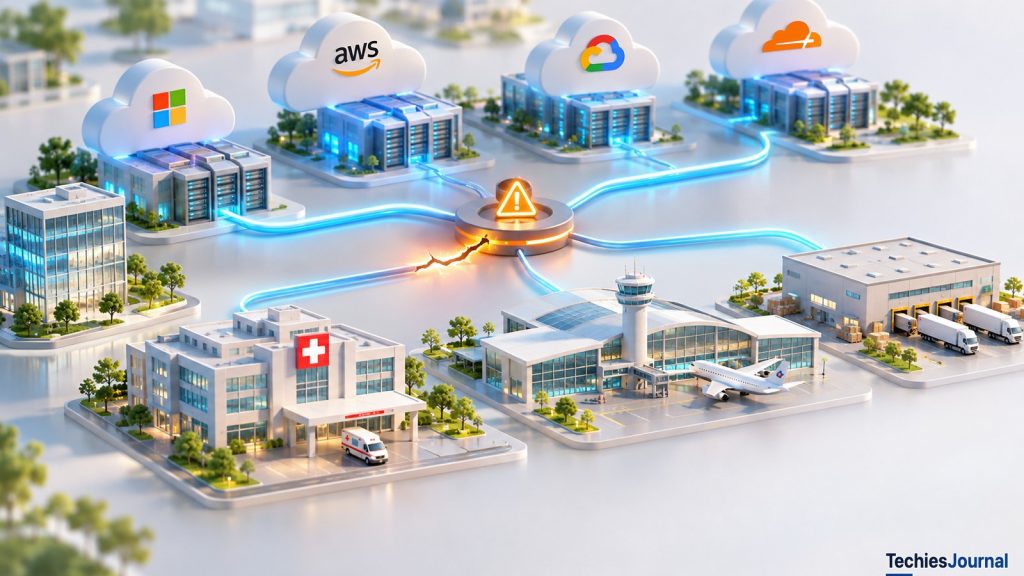
पाँच साल की बड़ी तकनीकी रुकावटें साझा निर्भरताओं, व्यावसायिक असर और रेज़िलिएंस के फ़ैसलों के बारे में क्या बताती हैं।
किसी संगठन के अपने सिस्टम स्वस्थ हों, तब भी उसका कारोबार रुक सकता है
एक संगठन के पास दो नेटवर्क कनेक्शन, क्लस्टर किए हुए सर्वर, रेप्लिकेटेड डेटाबेस, बैकअप और एक डिज़ास्टर रिकवरी साइट है। उसके इंजीनियरों ने सालों तक ज्ञात आंतरिक विफलता बिंदुओं को हटाया है। फिर कर्मचारियों की पहुँच किसी ज़रूरी बाहरी सेवा से कट जाती है। संगठन के अपने उपकरण ठीक चल रहे हैं, फिर भी एक अहम व्यावसायिक प्रक्रिया सामान्य ढंग से आगे नहीं बढ़ पाती।
इसका मतलब यह नहीं कि क्लाउड कंप्यूटिंग ने भरोसेमंदी को कमज़ोर किया है। कई मामलों में क्लाउड प्लेटफ़ॉर्म उससे बेहतर उपलब्धता, सुरक्षा और संचालन क्षमता देते हैं जितनी कोई संगठन किफ़ायत से खुद बना सकता है। लेकिन सिस्टम को किसी बाहरी प्रदाता के पास ले जाने से यह बदल जाता है कि कंपनी कौन-सी विफलताएँ रोक सकती है, किनसे सीधे उबर सकती है और किन्हें उसे तब सहना पड़ता है जब कोई और सेवा बहाल कर रहा हो।
यह फ़र्क इसलिए मायने रखता है क्योंकि कोई व्यावसायिक प्रक्रिया शायद ही कभी अकेले एक एप्लिकेशन पर टिकी होती है। किसी ग्राहक के ऑर्डर के लिए एक आइडेंटिटी सेवा, एक पेमेंट बिचौलिया, एक नेटवर्क सुरक्षा प्लेटफ़ॉर्म और एक डेटा सिस्टम चाहिए हो सकते हैं। बाकी सब चालू हों, तब भी इनमें से कोई एक बाधा बन सकता है।
सवाल यह नहीं है कि कारोबारों को क्लाउड और सॉफ़्टवेयर-एज़-ए-सर्विस (SaaS, यानी इंटरनेट पर सेवा के रूप में मिलने वाला सॉफ़्टवेयर) प्रदाताओं से बचना चाहिए या नहीं। सवाल यह है कि क्या उनकी कंटिन्यूटी योजनाएँ (यानी संकट में भी ज़रूरी काम जारी रखने की योजनाएँ) ज़रूरी सेवाएँ पहुँचाने के लिए लगने वाली तकनीक और संगठनों की पूरी शृंखला को गिनती में लेती हैं।
पाँच साल की बड़ी रुकावटें
नीचे की घटनाएँ उनके दर्ज नतीजों और विफलता के अलग-अलग तंत्रों के आधार पर चुनी गई हैं। यह दुनिया भर के आउटेज की गिनती नहीं, बल्कि उदाहरणों की एक उदाहरणात्मक सूची है। अवधि और असर अलग-अलग पैमानों को दर्शाते हैं और उनकी तुलना ऐसे नहीं की जानी चाहिए जैसे वे एक ही आँकड़ा हों।
| तारीख़ | घटना | दर्ज परिचालन या वित्तीय असर | मामला क्या दर्शाता है |
|---|---|---|---|
| अप्रैल 2022 | Atlassian Cloud | 775 ग्राहकों की 883 साइटें हटा दी गईं, और कुछ की बहाली 14 दिन तक खिंची | बड़े पैमाने की रिकवरी सामान्य फ़ेलओवर से अलग हो सकती है Atlassian की समीक्षा |
| फ़रवरी 2024 | Change Healthcare | UnitedHealth ने 2024 में 2.2 अरब डॉलर की सीधी प्रतिक्रिया लागत और Optum Insight में 867 मिलियन डॉलर का व्यावसायिक व्यवधान असर बताया | अहम लेन-देन बिचौलिए कई अन्यथा अलग संगठनों को जोड़ते हैं UnitedHealth 2024 Form 10-K |
| जुलाई 2024 | CrowdStrike सॉफ़्टवेयर अपडेट | Delta ने लगभग 7,000 रद्द उड़ानें, 380 मिलियन डॉलर का राजस्व असर और 170 मिलियन डॉलर का अतिरिक्त खर्च बताया | साझा सॉफ़्टवेयर घटक लंबी परिचालन रिकवरी पैदा कर सकते हैं Delta 2024 Form 10-K |
| जून 2025 | Google Cloud | साझा API-प्रबंधन इन्फ़्रास्ट्रक्चर से शुरू हुआ व्यापक सेवा व्यवधान | वैश्विक नीति और कंट्रोल निर्भरताएँ कई सेवाओं को प्रभावित कर सकती हैं Google Cloud की घटना रिपोर्ट |
| जून 2025 | Cloudflare | Cloudflare के अनुसार कई उत्पादों को प्रभावित करने वाला 2 घंटे 28 मिनट का व्यवधान | एक प्लेटफ़ॉर्म किसी दूसरे प्रदाता की स्टोरेज सेवा पर निर्भर हो सकता है Cloudflare जून 2025 पोस्टमॉर्टम |
| अक्टूबर 2025 | AWS us-east-1 | DynamoDB से जुड़ी DNS समस्याओं के बाद EC2 और लोड-बैलेंसर की रिकवरी में कठिनाइयाँ आईं | शुरुआती खराबी ठीक होने से सभी निर्भर सेवाएँ तुरंत बहाल नहीं होतीं AWS की घटना रिपोर्ट |
| नवंबर 2025 | Cloudflare | फैलाए गए कॉन्फ़िगरेशन डेटा से हुआ व्यापक व्यवधान | साझा कॉन्फ़िगरेशन रास्ते साझा जोखिम पैदा कर सकते हैं Cloudflare नवंबर 2025 पोस्टमॉर्टम |
| फ़रवरी 2026 | Google Vertex AI Gemini API | लगभग 1 घंटा 58 मिनट तक API त्रुटियाँ बढ़ीं | AI पर आधारित एप्लिकेशन पारंपरिक प्लेटफ़ॉर्म निर्भरताएँ साझा कर सकते हैं Google Cloud स्टेटस रिपोर्ट |
| नवंबर 2026 | Microsoft Exchange Online | 12 से 13 नवंबर को मेलबॉक्स कनेक्टिविटी और कुछ निर्भर Microsoft 365 सुविधाएँ प्रभावित हुईं। Microsoft का प्रारंभिक मूल कारण पहले का नेटवर्क क्षमता अपग्रेड था। कुल वित्तीय नुकसान की पुष्टि नहीं हुई | उत्पादों के नाम अलग हों, तब भी SaaS सुविधाएँ अंतर्निहित सेवाएँ साझा कर सकती हैं Microsoft की घटना रिपोर्टों का PennO365 अंश |
सिर्फ़ यह तालिका यह साबित नहीं कर सकती कि आउटेज ज़्यादा बार हो रहे हैं। Uptime Institute के 2025 के शोध ने तो उलटे लगातार चौथे साल कुल आउटेज की आवृत्ति और आम तौर पर दर्ज गंभीरता में गिरावट बताई। उसने यह भी आगाह किया कि सीमित पारदर्शिता और भरोसेमंद रिपोर्टिंग की वजह से आउटेज के आँकड़ों को संदेह के साथ देखना चाहिए। Uptime Institute का विश्लेषण
ज़्यादा उपयोगी तुलना यह पूछती है कि कोई व्यवधान तकनीकी घटक से व्यावसायिक प्रक्रिया तक कैसे पहुँचा, और उस पर निर्भर लोगों के लिए कौन-सी रिकवरी संभव रही।
बैकअप होना और काम वापस पाना एक बात नहीं: Atlassian
अप्रैल 2022 में Atlassian की एक मेंटेनेंस स्क्रिप्ट ने सिर्फ़ इच्छित एप्लिकेशन की जानकारी हटाने के बजाय पूरी क्लाउड साइटें हटा दीं। Atlassian की post-incident review (घटना के बाद की समीक्षा) में 883 साइटें और 775 प्रभावित ग्राहक दर्ज हैं, और आख़िरी बहालियाँ 18 अप्रैल को पूरी हुईं। कुछ ग्राहकों को 14 दिन तक चला व्यवधान झेलना पड़ा। Atlassian की समीक्षा
Atlassian के पास रिकवरी के तंत्र थे, लेकिन उसकी स्थापित बहाली प्रक्रिया अलग-अलग साइटों या छोटे समूहों के लिए उपयुक्त थी। आपस में जुड़े उत्पादों में सैकड़ों साइटें दोबारा बनाने के लिए अतिरिक्त प्रक्रियाओं और ऑटोमेशन की ज़रूरत पड़ी। कंपनी की समीक्षा यह भी बताती है कि साइट रिकॉर्ड हटने से ग्राहकों से संवाद के लिए इस्तेमाल होने वाले संपर्क और सहायता वर्कफ़्लो बाधित हुए।
अहम फ़र्क तीन सवालों के बीच है: क्या इन्फ़्रास्ट्रक्चर किसी घटक की विफलता झेल सकता है? क्या डेटा सुरक्षित है? क्या पूरी व्यावसायिक सेवा ज़रूरी पैमाने और गति से बहाल की जा सकती है? एक का सकारात्मक जवाब बाकी की गारंटी नहीं देता।
ग्राहक के लिए इसका संकेत एक समानुपातिक कंटिन्यूटी परीक्षण की ओर जाता है। पहचानिए कि SaaS उत्पाद एक दिन या एक हफ़्ते उपलब्ध न हो तो कौन-सा काम रुक जाएगा। तय कीजिए कि ज़रूरी दस्तावेज़, संपर्क विवरण, मंज़ूरियाँ या कार्य निर्देश किसी स्वीकृत स्वतंत्र तरीके से पहुँच में हैं या नहीं। पूरा डुप्लिकेट SaaS प्लेटफ़ॉर्म ज़रूरी नहीं हो सकता। सबसे अहम काम को जारी रखने का कोई परखा हुआ तरीका ज़्यादा उपयोगी हो सकता है।
साझा लेन-देन सेवा: Change Healthcare
फ़रवरी 2024 के Change Healthcare पर साइबर हमले ने स्वास्थ्य सेवा की लेन-देन सेवाओं को बाधित किया। UnitedHealth ने ख़तरे को रोकने के लिए प्रभावित सिस्टम अलग कर दिए, जो इस प्लेटफ़ॉर्म पर निर्भर संगठनों के क्लेम और भुगतान से जुड़े वर्कफ़्लो के रुकने का एक कारण बना। यह साइबर सुरक्षा की घटना थी, सामान्य क्लाउड इन्फ़्रास्ट्रक्चर आउटेज नहीं। UnitedHealth 2024 Form 10-K
अपनी 2024 की वार्षिक फ़ाइलिंग में UnitedHealth ने 2.2 अरब डॉलर की सीधी प्रतिक्रिया लागत और Optum Insight में अनुमानित 867 मिलियन डॉलर का व्यावसायिक व्यवधान असर बताया। उसने यह भी बताया कि उसने 2024 के अंत तक देखभाल प्रदाताओं को 9 अरब डॉलर से ज़्यादा के ब्याज-मुक्त ऋण दिए। फ़ाइलिंग के अनुसार 2.2 अरब डॉलर की सीधी प्रतिक्रिया लागत में इन ऋणों को देने से जुड़ी लागत शामिल है। ऋण स्वयं वित्तीय सहायता हैं और उन्हें घटना के नुकसान में नहीं जोड़ा जाना चाहिए। फ़ाइलिंग की वित्तीय श्रेणियों को पूरे उद्योग के एक कुल नुकसान अनुमान में भी नहीं बदला जाना चाहिए। UnitedHealth 2024 Form 10-K
यह घटना दिखाती है कि एक बिचौलिया कई अन्यथा स्वतंत्र संगठनों के बीच लेन-देन के लिए कैसे ज़रूरी हो सकता है। उनके अपने सर्वर और नेटवर्क उपलब्ध रह सकते हैं, फिर भी क्लेम और भुगतान रुक सकते हैं, क्योंकि कोई ज़रूरी बाहरी कदम पूरा नहीं हो पाता।
व्यावहारिक मुद्दा यह नहीं है कि हर स्वास्थ्य सेवा प्रदाता को अपना लेन-देन नेटवर्क रखना चाहिए या नहीं। मुद्दा यह है कि क्या अहम व्यावसायिक प्रक्रियाओं को बाहरी बिचौलिए तक मैप किया गया है, क्या वैकल्पिक इंतज़ाम अनुबंध और तकनीक दोनों के लिहाज़ से संभव हैं, और क्या लंबे व्यवधान के लिए नकदी प्रवाह या मैन्युअल प्रक्रिया की आकस्मिक योजनाएँ पर्याप्त हैं।
जब कंप्यूटर लौट आए पर संचालन नहीं: CrowdStrike और Delta
19 जुलाई 2024 को CrowdStrike के एक खराब सिक्योरिटी कंटेंट अपडेट से Windows सिस्टम पर व्यापक विफलताएँ हुईं। बुनियादी समस्या एक साझा सॉफ़्टवेयर घटक थी, किसी क्लाउड रीजन का सार्वभौमिक आउटेज नहीं। Delta 2024 Form 10-K
Delta Air Lines ने पाँच दिनों में लगभग 7,000 उड़ानें रद्द होने, अनुमानित 380 मिलियन डॉलर के सीधे राजस्व असर और लगभग 170 मिलियन डॉलर के अतिरिक्त परिचालन खर्च की जानकारी दी। उसने रद्द उड़ानों की वजह से लगभग 50 मिलियन डॉलर का ईंधन खर्च बचने की भी पहचान की। ये कंपनी की बताई अलग-अलग वित्तीय प्रभाव हैं, पूरी घटना के लिए पुष्ट शुद्ध नुकसान की गणना नहीं। Delta 2024 Form 10-K
एक एयरलाइन को विमान, क्रू, यात्री, हवाई अड्डे और शेड्यूल का तालमेल बिठाना पड़ता है। किसी कंप्यूटर को बहाल करने से ये सारे तत्व तुरंत अपनी सही परिचालन स्थिति में नहीं लौट आते। देरी से बैकलॉग बनते हैं, और बैकलॉग से रिकवरी का अतिरिक्त काम बनता है।
यह फ़र्क एयरलाइनों से आगे भी लागू होता है। बहाल हुए ऑर्डर सिस्टम में ऐसे लेन-देन रह सकते हैं जिनका मिलान करना हो। बहाल हुए कस्टमर सर्विस प्लेटफ़ॉर्म के सामने जमा कतार हो सकती है। किसी अस्पताल प्रणाली को इलाज का समय दोबारा तय करना पड़ सकता है। इसलिए किसी उद्यम को सिर्फ़ यह नहीं मापना चाहिए कि उसकी तकनीक कब लौटी, बल्कि यह भी कि कारोबार कब फिर स्वीकार्य सेवा दे सका।
प्रदाता के पीछे की निर्भरता: Google Cloud और Cloudflare
12 जून 2025 को विश्व स्तर पर वितरित नीति जानकारी में हुआ एक बदलाव Google Cloud के API-प्रबंधन इन्फ़्रास्ट्रक्चर के एक सॉफ़्टवेयर दोष से टकराया। Google की कई सेवाओं में व्यवधान आया। Google की घटना रिपोर्ट के अनुसार नए कोड पाथ में एरर हैंडलिंग और फ़ीचर-फ़्लैग सुरक्षा नहीं थी, इसलिए खाली नीति फ़ील्ड कुछ ही सेकंड में विश्व भर में रेप्लिकेट हो गए और नीति-जाँच सेवा हर रीजन में बार-बार क्रैश हुई। एक kill switch (आपात बंद करने का स्विच) ने लगभग 40 मिनट में मुख्य असर ख़त्म किया, जबकि us-central1 में रिकवरी में लगभग 2 घंटे 40 मिनट तक लगे। Google Cloud की घटना रिपोर्ट
उसी दिन Cloudflare ने Workers KV, Access, Gateway, WARP और Turnstile समेत कई सेवाओं पर दो घंटे 28 मिनट का असर बताया। उसकी अपनी टाइमलाइन थोड़ी लंबी है, लगभग दो घंटे 36 मिनट। Cloudflare ने Workers KV के इस्तेमाल वाली एक बाहरी स्टोरेज निर्भरता की विफलता को निकटतम ट्रिगर बताया। Cloudflare के कई उत्पाद कॉन्फ़िगरेशन, ऑथेंटिकेशन या कंटेंट डिलीवरी के लिए उस सेवा पर निर्भर थे। कंपनी ने बताया कि कोर DNS और अपनी CDN की ज़्यादातर कार्यक्षमता समेत कई अहम सेवाएँ अप्रभावित रहीं और चालू रहीं। Cloudflare जून 2025 पोस्टमॉर्टम
यहाँ कोई कारोबार Cloudflare पर निर्भर हो सकता था, जबकि Cloudflare खुद किसी और इन्फ़्रास्ट्रक्चर सेवा पर निर्भर थी। उस अंतर्निहित प्रदाता से कारोबार का कोई सीधा रिश्ता न हो, यह संभव है। सीधे विक्रेताओं की गिनती करने या एप्लिकेशन अलग-अलग प्लेटफ़ॉर्म पर चलाने से ज़रूरी नहीं कि विफलता के रास्ते स्वतंत्र साबित हों।
सबक यह है कि किसी अहम व्यावसायिक कार्य के लिए निर्भरताओं को उस स्तर पर खोजा जाए जो मायने रखता है। यह मानना भी ज़रूरी है कि प्रदाता की हर सुविधा विफल नहीं हुई थी। कौन-सी सेवाएँ प्रभावित हुईं, यह सटीक पहचानना ईमानदार रेज़िलिएंस आकलन का हिस्सा है।
एक घटक की बहाली से AWS की रिकवरी पूरी क्यों नहीं हुई
अक्टूबर 2025 में us-east-1 रीजन में Amazon DynamoDB से जुड़ी DNS-प्रबंधन समस्या ने एक रीजनल एंडपॉइंट के कनेक्शनों को प्रभावित किया। AWS की post-event रिपोर्ट आगे की समस्याओं का वर्णन करती है, जो EC2 इंस्टेंस लॉन्च, होस्ट प्रबंधन और Network Load Balancer हेल्थ चेक में आईं। AWS की घटना रिपोर्ट
शुरुआती DynamoDB समस्या सारे निर्भर संचालन बहाल होने से पहले ही हल हो गई थी। कुछ मौजूदा EC2 इंस्टेंस स्वस्थ बने रहे, जबकि नए इंस्टेंस लॉन्च करना बाधित था। यह फ़र्क ग्राहकों के वास्तविक अनुभव को बदल देता है। पर्याप्त मौजूदा क्षमता पर चलने वाला वर्कलोड चलता रह सकता है, जबकि जिसे नए इंस्टेंस, रिप्लेसमेंट क्षमता या कुछ ख़ास प्रबंधन संचालन चाहिए, वह जूझता है।
इंजीनियरिंग की प्रासंगिक चिंता सिर्फ़ यह नहीं कि कई availability zone हैं या नहीं। चिंता यह है कि क्या प्रस्तावित रिकवरी कार्रवाई किसी ऐसी साझा सेवा पर निर्भर है जो खुद भी बाधित हो सकती है। उदाहरण के लिए, जिस फ़ेलओवर योजना को नई क्षमता चाहिए, उसे यह मानकर चलने के बजाय कि प्रोविज़निंग हमेशा सफल होती है, क्षमता और कंट्रोल-सेवा की सीमाओं के विरुद्ध परखा जाना चाहिए।
TechiesJournal का क्लाउड कंट्रोल प्लेन आउटेज: सर्वर चल रहे हों तो भी सर्विस चालू क्यों नहीं होती बताता है कि ये कंट्रोल सेवाएँ कैसे विफल होती हैं। वे यहाँ सिर्फ़ इसलिए मायने रखती हैं कि वे प्रदाता के अपना इन्फ़्रास्ट्रक्चर बहाल करने और ग्राहक के अपना व्यावसायिक कार्य बहाल करने के बीच का अंतर समझाने में मदद करती हैं।
हाल की Microsoft 365 घटना क्या जोड़ती है
12 नवंबर 2026 को Microsoft ने Exchange Online मेलबॉक्स कनेक्टिविटी की समस्याएँ बताईं, जो Outlook on the web और कई कनेक्शन प्रोटोकॉल को प्रभावित कर सकती थीं। घटना के दौरान आए अपडेट में बताया गया कि बड़ी संख्या में सर्वर अचानक अनुपलब्ध हो गए, जिससे बचे हुए इन्फ़्रास्ट्रक्चर पर लोड आ गया, और प्रभावित सर्वरों पर एक कोर प्रक्रिया पर ज़रूरत से ज़्यादा बोझ पड़ गया। बाद के अपडेट में बताया गया कि Microsoft द्वारा एक अपस्ट्रीम ऑथेंटिकेशन और रूटिंग कॉन्फ़िगरेशन घटक पर पैच लगाने के बाद स्थिरता सुधर रही थी। Microsoft की घटना रिपोर्टों का PennO365 अंश
14 नवंबर तक Microsoft ने University of Pennsylvania की PennO365 सेवा को जो रिकॉर्ड भेजे थे, उनमें दोनों घटनाएँ सेवा बहाल के रूप में दिख रही थीं। Microsoft ने एक प्रारंभिक मूल कारण (preliminary root cause) बताया: पहले के नेटवर्क क्षमता अपग्रेड के दौरान आई एक समस्या, जो हाल के एक नेटवर्क बदलाव के बाद सामने आई। उसने कहा कि यह साइबर या AI से जुड़ी नहीं, बल्कि एक तकनीकी समस्या थी, और पूरी Post-Incident Report बाद में आएगी।
Microsoft ने Exchange Online पर निर्भर अन्य Microsoft 365 उत्पादों की ख़ास कार्यक्षमता पर असर की भी जानकारी दी। इसका मतलब यह नहीं कि हर जुड़ा उत्पाद या हर सुविधा अनुपलब्ध थी।
साक्ष्य की सीमा, 14 नवंबर 2026 को की गई समीक्षा: समीक्षा किए गए रिकॉर्ड में Microsoft का औपचारिक मूल-कारण फ़ील्ड अब भी खाली था और उसकी पूरी Post-Incident Report प्रकाशित नहीं हुई थी, इसलिए प्रारंभिक कारण बदल सकता है। दोनों घटना रिकॉर्ड अलग-अलग समाप्ति समय भी देते हैं। कुल व्यावसायिक वित्तीय नुकसान की पुष्टि नहीं हुई। इसलिए यह घटना SaaS की कार्यात्मक निर्भरताओं का हालिया उदाहरण है, वित्तीय नुकसान के दावे या कारण के निश्चित आरोपण का आधार नहीं।
जोखिम व्यावसायिक प्रक्रिया में बैठा है, सिर्फ़ एप्लिकेशन में नहीं
इन मामलों को साथ देखें तो ज़रूरी काम रुकने के चार अलग तरीके दिखते हैं। डेटा को बड़े पैमाने पर बहाल करना कठिन हो सकता है। कोई लेन-देन बिचौलिया अनुपलब्ध हो सकता है। साझा सॉफ़्टवेयर एक साथ कई संगठनों को रोक सकता है। जो सेवा स्वतंत्र दिखती है, वह किसी दूसरे प्रदाता या साझा कंट्रोल घटक पर निर्भर हो सकती है।
विश्लेषण की उपयोगी इकाई एक महत्वपूर्ण व्यावसायिक सेवा है। कल्पना कीजिए कि कोई कंपनी ऑनलाइन भुगतान स्वीकार करती है। उसका स्टोरफ्रंट स्वस्थ रह सकता है जबकि पेमेंट बिचौलिया अनुपलब्ध हो। या फिर उसका स्टोरफ्रंट ऑफ़लाइन हो सकता है जबकि कोई स्वीकृत टेलीफ़ोन या मैन्युअल प्रक्रिया सीमित मात्रा में ज़रूरी कारोबार बचाए रखे। दोनों स्थितियों में अकेला एप्लिकेशन अपटाइम प्रतिशत ग्राहक के अनुभव का अधूरा पैमाना है।
इस चित्र का सुलभ टेक्स्ट विकल्प
सेवा पाँच कड़ियों की शृंखला है: स्टोरफ्रंट, आइडेंटिटी सेवा, पेमेंट बिचौलिया, सुरक्षा प्लेटफ़ॉर्म और डेटा सिस्टम।
चार कड़ियाँ चालू हैं। पेमेंट बिचौलिया बंद है।
योजना न हो तो ग्राहक भुगतान नहीं कर सकता और व्यावसायिक सेवा रुक जाती है।
परखी हुई वैकल्पिक प्रक्रिया हो तो स्वीकृत फ़ोन या मैन्युअल प्रक्रिया टूटी कड़ी को बायपास करती है, और ज़रूरी भुगतान सीमित रूप में जारी रहते हैं।
यह कोई नई खोज नहीं है। स्थापित कंटिन्यूटी और परिचालन-रेज़िलिएंस पद्धतियाँ पहले से तकनीकी रिकवरी और अहम व्यावसायिक कार्यों के जारी रहने में फ़र्क करती हैं। NIST का कंटिन्जेंसी-प्लानिंग मार्गदर्शन और वित्तीय क्षेत्र के परिचालन-रेज़िलिएंस ढाँचे व्यावसायिक असर, निर्भरताओं, रिकवरी प्राथमिकताओं और परीक्षण पर ज़ोर देते हैं। NIST का कंटिन्जेंसी-प्लानिंग मार्गदर्शन Bank of England का रेज़िलिएंस मार्गदर्शन
आधुनिक उद्यम के लिए बदलाव यह है कि इन सवालों को उन बाहरी और डाउनस्ट्रीम सेवाओं पर भी लागू किया जाए जिन्हें वह सीधे नहीं चलाता।
नुकसान के आँकड़े असल में हमें क्या बताते हैं?
Delta और UnitedHealth बड़े असर बताते हैं, लेकिन वे अलग-अलग लागत श्रेणियों और बहुत अलग व्यावसायिक माहौल का वर्णन करते हैं। उन आँकड़ों को जोड़ देने से एक प्रभावशाली संख्या तो बनेगी, पर उसकी कोई उपयोगी व्याख्या नहीं होगी।
Uptime Institute व्यापक संदर्भ देता है। अपने 2025 के वार्षिक आउटेज विश्लेषण में उसके 2024 के सर्वे के 54% उत्तरदाताओं ने कहा कि उनके सबसे हालिया मध्यम से गंभीर आउटेज की लागत 100,000 डॉलर से ज़्यादा रही, और हर पाँच में से एक (20%) ने 1 मिलियन डॉलर से ज़्यादा बताई। ये चुने हुए प्रभावशाली आउटेज के बारे में सर्वे के जवाब हैं, उन रकमों से ऊपर जाने वाले सभी क्लाउड आउटेज का हिस्सा नहीं। रिपोर्ट यह भी आगाह करती है कि आउटेज का मापन अधूरा है। Uptime Institute का विश्लेषण
इसके बजाय किसी कंपनी का अपना फ़ैसला इस सवाल से शुरू होना चाहिए कि एक घंटे, एक दिन या कई दिन तक एक व्यावसायिक सेवा खो देने का संभावित नतीजा क्या होगा। उसे रुके हुए लेन-देन, कर्मचारियों की उत्पादकता, ग्राहक को हुआ नुकसान, नियामकीय दायित्व, नकदी प्रवाह, रिकवरी खर्च और सेवा बहाल होने के बाद के बैकलॉग पर विचार करना चाहिए। जहाँ कंपनी के पास ठोस अनुमान नहीं हैं, वहाँ उन्हें प्रकाशित नुकसान आँकड़ों के बजाय परिदृश्य (scenario) कहना चाहिए।
उद्यम को अलग तरीके से क्या करना चाहिए?
ठोस प्रतिक्रिया के लिए हर तकनीकी प्लेटफ़ॉर्म की नकल ज़रूरी नहीं। उसके लिए सुरक्षा को उस रुकावट से मिलाना ज़रूरी है जिसे कारोबार सह नहीं सकता।
पहले, ज़रूरी व्यावसायिक सेवा का नाम तय कीजिए, सिर्फ़ एप्लिकेशन का नहीं। फिर उसे पहुँचाने के लिए ज़रूरी सिस्टम, बाहरी प्रदाता, आइडेंटिटी सेवाएँ, डेटा स्रोत और लेन-देन बिचौलिए खोजिए। दर्ज कीजिए कि इनमें से कौन-सी निर्भरताएँ ऊपर से स्वतंत्र दिखने वाले संचालनों के बीच साझा हैं।
इसके बाद स्वीकार्य व्यवधान और न्यूनतम सेवा स्तर तय कीजिए। कोई आंतरिक नॉलेज साइट एक दिन का व्यवधान सह सकती है, जबकि भुगतान या आपातकालीन संचार का कार्य नहीं सह सकता। जवाब को व्यावसायिक नतीजे को दर्शाना चाहिए, तकनीक की प्रतिष्ठा को नहीं।
अंत में, किसी ख़ास विफलता का अभ्यास कीजिए। अगर सामान्य आइडेंटिटी या सहयोग प्लेटफ़ॉर्म अनुपलब्ध हो तो क्या कर्मचारी किसी स्वतंत्र आपातकालीन संपर्क सूची तक पहुँच सकते हैं? क्या आने वाले लेन-देन को सुरक्षित ढंग से कतार में रखकर बाद में मिलाया जा सकता है? क्या सामान्य SaaS इंटरफ़ेस के बिना अहम जानकारी वापस पाई जा सकती है? क्या फ़ेलओवर के लिए कोई ऐसी कंट्रोल सेवा चाहिए जो खुद भी बंद हो सकती है? इस अभ्यास में व्यावसायिक कार्य की असल बहाली मापी जानी चाहिए, जिसमें बैकलॉग और मैन्युअल काम भी शामिल हों।
इसमें समझौते भी हैं। स्वतंत्र प्लेटफ़ॉर्म, कई रीजन और मल्टी-क्लाउड आर्किटेक्चर कुछ सहसंबद्ध विफलताएँ घटा सकते हैं, लेकिन वे संचालन लागत, रेप्लिकेशन की जटिलता और सुरक्षा ज़िम्मेदारियाँ भी बढ़ाते हैं। कभी परखी हुई वैकल्पिक व्यावसायिक प्रक्रिया ज़्यादा समानुपातिक नियंत्रण होती है। कभी लागत और नतीजे बड़ी तकनीकी रिडंडेंसी को सही ठहराते हैं। चुनाव व्यावसायिक ज़रूरत और यथार्थवादी परीक्षण के आधार पर होना चाहिए।
AI की सीमित भूमिका
AI-आधारित परिचालन टूल लॉग विश्लेषण, अलर्ट की ग्रुपिंग और जाँच के सुझावों में मदद कर सकते हैं। उनकी विज्ञापित क्षमताएँ अपने आप में इस बात का प्रमाण नहीं कि वे बड़ी घटनाओं में रिकवरी छोटी करते हैं। प्रोडक्शन बदलने वाली किसी भी कार्रवाई के लिए अब भी उचित सत्यापन और अधिकार चाहिए।
AI सेवाएँ भी निर्भरता बन सकती हैं। Cloudflare ने बताया कि उसके जून 2025 के Workers KV घटनाक्रम के दौरान Workers AI इन्फ़रेंस अनुरोध विफल हुए। यह इस बात का ठोस उदाहरण है कि आधुनिक AI सुविधा पारंपरिक कॉन्फ़िगरेशन और प्लेटफ़ॉर्म इन्फ़्रास्ट्रक्चर पर निर्भर होती है। Cloudflare जून 2025 पोस्टमॉर्टम
इसलिए AI को भी अन्य अहम सेवाओं की तरह उसी निर्भरता और कंटिन्यूटी आकलन में रखना चाहिए। वह किसी घटना की जाँच करने की टीम की क्षमता सुधार सकता है, लेकिन स्वतंत्र संचार, रिकवरी परीक्षणों और ठोस परिचालन नियंत्रणों की ज़रूरत ख़त्म नहीं करता।
भरोसेमंदी और रेज़िलिएंस को साथ-साथ मापा जाना चाहिए
क्लाउड सेवाओं ने ज़्यादा संगठनों को पर्याप्त भरोसेमंदी और रिकवरी क्षमताएँ उपलब्ध कराई हैं। इस समीक्षा की घटनाएँ यह साबित नहीं करतीं कि इन्फ़्रास्ट्रक्चर आउटसोर्स करने से कारोबार कम भरोसेमंद हो जाता है, और वे यह भी स्थापित नहीं करतीं कि कई प्रदाताओं का इस्तेमाल हमेशा बेहतर है।
वे यह ज़रूर दिखाती हैं कि प्लेटफ़ॉर्म अपटाइम और बिज़नेस कंटिन्यूटी अलग-अलग नतीजे क्यों हैं। किसी सेवा को रिडंडेंसी के साथ डिज़ाइन किया जा सकता है, फिर भी वह किसी साझा कॉन्फ़िगरेशन विफलता से प्रभावित हो सकती है। प्रदाता अपने तकनीकी सिस्टम बहाल कर सकता है, जबकि उसके ग्राहक अब भी व्यावसायिक प्रक्रियाएँ बहाल कर रहे हों। कोई संगठन मूल खराबी से बच सकता है, फिर भी उसे नतीजे भुगतने पड़ सकते हैं क्योंकि कोई ज़रूरी बिचौलिया अनुपलब्ध है।
इसलिए एक उपयोगी रेज़िलिएंस योजना उस व्यावसायिक सेवा से शुरू होती है जिसे जारी रहना है, उसकी निर्भरताओं को संगठन के अपने नेटवर्क से आगे तक खोजती है, और परखती है कि व्यवधान के दौरान असल में क्या चल सकता है। वह हर निर्भरता मिटाने की कोशिश करने के बजाय वहाँ स्वतंत्रता पर खर्च करती है जहाँ व्यावसायिक असर लागत को सही ठहराता है।
भरोसेमंद तकनीक कारोबार को चालू रखने में मदद करती है। व्यावसायिक रेज़िलिएंस के लिए उस समय की योजना भी चाहिए जब वह तकनीक उपलब्ध न हो।
संदर्भ और आगे पढ़ने के लिए
- Atlassian: Post-Incident Review on the April 2022 Outage. ग्राहकों की गिनती, हटाने का तंत्र, सहायता पर असर और रिकवरी की टाइमलाइन।
- UnitedHealth Group: 2024 Form 10-K. Change Healthcare घटना की लागत और व्यावसायिक व्यवधान की चर्चा।
- Delta Air Lines: 2024 Form 10-K. जुलाई 2024 के परिचालन और वित्तीय असर की चर्चा।
- Google Cloud: June 12, 2025 Service Disruption Incident Report. तंत्र और रिकवरी।
- Cloudflare: Cloudflare Service Outage June 12, 2025. साझा स्टोरेज निर्भरता, प्रभावित और अप्रभावित उत्पाद।
- AWS: Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia Region, October 2025. DynamoDB, EC2 और लोड-बैलेंसर समस्याओं का क्रम।
- Cloudflare: November 18, 2025 Outage. कॉन्फ़िगरेशन प्रसार और सेवाओं पर असर।
- Google Cloud: Vertex AI Gemini API Incident, February 27, 2026. Google Cloud का आधिकारिक घटना रिकॉर्ड।
- Microsoft: Exchange Online incident EX1550543 and Microsoft 365 incident MO1550821, November 12 to 14, 2026. Microsoft की घटना रिपोर्टें, जैसी University of Pennsylvania के PennO365 घटना अंश में कॉपी हैं। यह पेज हर 15 मिनट में रिफ़्रेश होता है, इसलिए Microsoft के रिपोर्ट अपडेट करने पर पेज बदलता है।
- Uptime Institute: Annual Outage Analysis 2025. कार्यकारी सारांश: आउटेज के रुझान, दर्ज लागतें और मापन की सीमाएँ।
- TechiesJournal: क्लाउड कंट्रोल प्लेन आउटेज: सर्वर चल रहे हों तो भी सर्विस चालू क्यों नहीं होती. क्लाउड कंट्रोल सेवाएँ कैसे विफल होती हैं और क्या जाँचना चाहिए।
- NIST: SP 800-34 Rev. 1, Contingency Planning Guide for Federal Information Systems. बिज़नेस इम्पैक्ट एनालिसिस, अंतर-निर्भरताएँ, रिकवरी प्राथमिकताएँ और परीक्षण।
- Bank of England and PRA: SS1/21, Operational resilience: Impact tolerances for important business services. महत्वपूर्ण व्यावसायिक सेवाएँ, इम्पैक्ट टॉलरेंस, मैपिंग और परिदृश्य परीक्षण।
स्रोत 14 नवंबर 2026 को पढ़े गए थे। Microsoft की घटना की समीक्षा तब भी जारी थी, और घटना के ब्योरे बदल सकते हैं।