

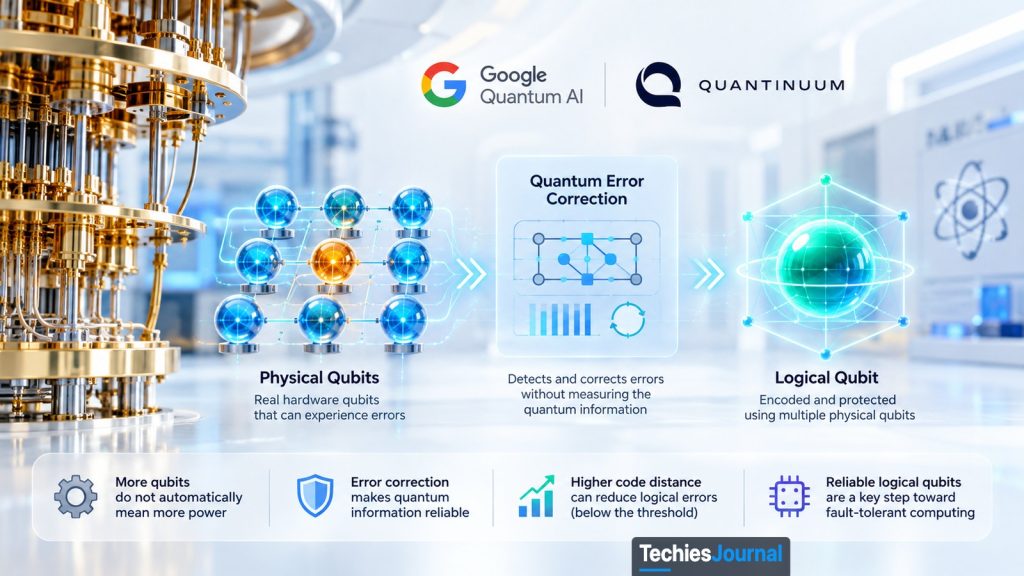
क्वांटम कंप्यूटरों की तुलना अक्सर उनमें मौजूद क्यूबिट की संख्या से की जाती है। लेकिन ज़्यादा क्यूबिट का मतलब यह नहीं कि कंप्यूटर ज़्यादा सक्षम है। इसे समझने के लिए हमें देखना होगा कि क्वांटम जानकारी कैसे रखी जाती है, गलतियाँ कैसे होती हैं, और लॉजिकल क्यूबिट असल में किस समस्या को हल करते हैं।
ज़्यादा क्यूबिट होना काफ़ी क्यों नहीं है
जब हम पारंपरिक कंप्यूटरों की तुलना करते हैं, तो अक्सर उनके प्रोसेसर, मेमोरी और प्रोसेसिंग क्षमता को देखते हैं। तेज़ प्रोसेसर या ज़्यादा मेमोरी प्रदर्शन सुधार सकती है, हालाँकि असली फ़ायदा काम के प्रकार पर निर्भर करता है।
क्वांटम कंप्यूटरों को भी इसी तरह देखना स्वाभाविक है। अगर एक क्वांटम प्रोसेसर में 100 क्यूबिट हैं और दूसरे में 1,000, तो हम मान सकते हैं कि दूसरी मशीन काफ़ी ज़्यादा शक्तिशाली है।
लेकिन क्वांटम कंप्यूटिंग में एक समस्या है जो इस तुलना को सीधा नहीं रहने देती।
क्वांटम जानकारी नाज़ुक होती है। वातावरण की गड़बड़ियों, अधूरे ऑपरेशन या माप के दौरान हुई गलतियों से क्यूबिट अपनी इच्छित अवस्था खो सकता है। भले ही हर ऑपरेशन बहुत सटीक हो, गणनाएँ लंबी होने पर वे छोटी गलतियाँ मायने रखने लगती हैं।
एक ऐसे क्वांटम कंप्यूटर की कल्पना कीजिए जिसमें दो-क्यूबिट ऑपरेशन की एरर रेट 0.1% है, यानी लगभग हर 1,000 ऑपरेशन में एक विफल होता है।
किसी एक ऑपरेशन के लिए यह स्वीकार्य लग सकता है। लेकिन एक जटिल क्वांटम एल्गोरिदम को लाखों या अरबों ऑपरेशन की ज़रूरत पड़ सकती है। प्रभावी एरर प्रबंधन के बिना, लंबी गणना को सही ढंग से पूरा करने की संभावना बहुत कम हो सकती है।
छोटी गलतियाँ कैसे जुड़ती जाती हैं
प्रति ऑपरेशन एक एरर रेट और ऑपरेशन की एक संख्या चुनें। नतीजा यह संभावना है कि एरर करेक्शन के बिना हर एक ऑपरेशन सही चलेगा। यह सिर्फ़ एक उदाहरण है: यह मानता है कि हर ऑपरेशन एक ही दर से स्वतंत्र रूप से विफल होता है। असली हार्डवेयर प्लेटफ़ॉर्म और ऑपरेशन के हिसाब से अलग होता है।
लगातार 1,000 ऑपरेशन
हर ऑपरेशन के सही चलने की संभावना
36.8%
| लगातार ऑपरेशन, प्रति ऑपरेशन 0.1% पर | सबके सही चलने की संभावना |
|---|---|
| 100 | 90.5% |
| 1,000 | 36.8% |
| 10,000 | 22,000 में लगभग 1 |
| 100,000 | 10^43 में 1 से भी कम |
| 1,000,000 | 10^434 में 1 से भी कम |
| 1,000,000,000 | 10^434511 में 1 से भी कम |
क्यूबिट जोड़ने से भरोसेमंदी अपने-आप नहीं बढ़ती। उन अतिरिक्त क्यूबिट को भी नियंत्रित करना, मापना और गलतियों से बचाना पड़ता है।
यहीं फ़िज़िकल और लॉजिकल क्यूबिट का अंतर अहम हो जाता है।
फ़िज़िकल और लॉजिकल क्यूबिट क्या हैं?
फ़िज़िकल क्यूबिट वह असली हार्डवेयर है जो क्वांटम जानकारी रखता है। तकनीक के आधार पर यह एक ट्रैप किया हुआ आयन, एक न्यूट्रल एटम या एक सुपरकंडक्टिंग इलेक्ट्रिकल सर्किट हो सकता है।
ये भौतिक प्रणालियाँ अलग-अलग तरह से व्यवहार करती हैं, पर उनकी एक साझा चुनौती है। प्रोसेसर के ऑपरेशन करते समय उनकी क्वांटम अवस्थाओं को पर्याप्त रूप से स्थिर रहना होता है।
शोधकर्ताओं ने फ़िज़िकल क्यूबिट की गुणवत्ता सुधारने, गलतियाँ घटाने और क्वांटम जानकारी को ज़्यादा देर तक बचाए रखने में वर्षों लगाए हैं।
फिर भी, अलग-अलग क्यूबिट को बेहतर बनाने से जो हासिल हो सकता है उसकी एक सीमा है। बहुत लंबी गणनाएँ करने वाले कंप्यूटर को तब भी गलतियाँ संभालने में सक्षम होना चाहिए जब उसका हार्डवेयर पूरी तरह दोषरहित न हो।
पारंपरिक कंप्यूटर भरोसेमंदी को कई तरीकों से संभालते हैं। एक जाना-पहचाना तरीका है जानकारी को अतिरिक्त बिट के साथ रखना, ताकि गलतियाँ पकड़ी या सुधारी जा सकें।
क्वांटम कंप्यूटरों को इससे मिलती-जुलती क्षमता चाहिए, हालाँकि वे किसी अज्ञात क्वांटम अवस्था की नकल करके कई एक जैसी प्रतियों की तुलना नहीं कर सकते।
इसके बजाय वे क्वांटम एरर करेक्शन का इस्तेमाल करते हैं।
बुनियादी विचार है क्वांटम जानकारी को कई फ़िज़िकल क्यूबिट में एन्कोड करना। किसी एक फ़िज़िकल क्यूबिट के गलती-मुक्त रहने पर निर्भर रहने के बजाय, सिस्टम क्यूबिट के एक समूह का इस्तेमाल करता है ताकि उनके सामूहिक रूप से दर्शाए गए जानकारी की रक्षा हो सके।
इस सुरक्षित इकाई को लॉजिकल क्यूबिट कहते हैं।
इसलिए लॉजिकल क्यूबिट कोई दूसरे तरह का फ़िज़िकल हार्डवेयर नहीं है। यह एरर-करेक्टिंग कोड के ज़रिए कई फ़िज़िकल क्यूबिट में एन्कोड की गई क्वांटम जानकारी है।
ज़रूरी फ़िज़िकल क्यूबिट की संख्या कोड, हार्डवेयर की गुणवत्ता और ज़रूरी सुरक्षा के स्तर पर निर्भर करती है।
अहम अंतर यह है कि फ़िज़िकल क्यूबिट हार्डवेयर देते हैं, जबकि लॉजिकल क्यूबिट प्रोसेस हो रही जानकारी को सुरक्षित रखने का तरीका देते हैं।
क्वांटम एरर करेक्शन कैसे काम करता है
लॉजिकल क्यूबिट का विचार समझना तब आसान होता है जब हम देखें कि गलती होने के बाद क्या होता है।
मान लीजिए क्वांटम जानकारी को कई फ़िज़िकल क्यूबिट में एन्कोड किया गया है। संचालन के दौरान उनमें से एक क्यूबिट में गलती हो जाती है।
सिस्टम समस्या ढूँढने के लिए हर क्यूबिट को सीधे नहीं पढ़ सकता। सुरक्षित क्वांटम जानकारी को सीधे मापने से गणना के लिए ज़रूरी अवस्था बिगड़ या नष्ट हो सकती है।
इसके बजाय, क्वांटम एरर-करेक्टिंग कोड प्रोसेसर को एन्कोड की गई जानकारी को सीधे उजागर किए बिना क्यूबिट के बीच कुछ संबंध मापने देते हैं।
इन मापों से वह मिलता है जिसे शोधकर्ता एरर सिंड्रोम कहते हैं।
एरर सिंड्रोम सिस्टम को संकेत देता है कि क्या गड़बड़ हुई होगी। फिर एक क्लासिकल डिकोडिंग प्रक्रिया उन संकेतों की व्याख्या करती है और सबसे संभावित सुधार तय करती है।
प्रोसेसर कोई सुधार ऑपरेशन लागू कर सकता है, या सुधार का हिसाब रख सकता है ताकि बाद के ऑपरेशन और माप सही ढंग से समझे जाएँ।
चूँकि गणना के दौरान कभी भी गलतियाँ हो सकती हैं, इस प्रक्रिया को दोहराना पड़ता है।
लक्ष्य यह गारंटी देना नहीं है कि फ़िज़िकल क्यूबिट कभी विफल नहीं होंगे। लक्ष्य यह है कि अलग-अलग फ़िज़िकल गलतियाँ उस लॉजिकल जानकारी को न बदल दें जिस पर एल्गोरिदम निर्भर है।
हालाँकि एक अहम सीमा है। एरर करेक्शन असीमित नहीं है।
अगर बहुत ज़्यादा गलतियाँ हो जाएँ, या सिस्टम गलती की जानकारी की व्याख्या ग़लत कर दे, तो सुरक्षित लॉजिकल अवस्था फिर भी बिगड़ सकती है।
बची रह गई उस विफलता को लॉजिकल एरर कहते हैं।
लॉजिकल क्यूबिट की भरोसेमंदी इस पर निर्भर करती है कि एन्कोडिंग और सुधार प्रक्रिया इन लॉजिकल एरर को कितने प्रभावी ढंग से घटाती हैं।
एक गलती को एक सुधार चक्र से गुज़रते देखें
छह चरणों से गुज़रें। नौ क्यूबिट लेख का वैचारिक चित्र हैं, कोई हार्डवेयर डिज़ाइन या ख़ास कोड नहीं। हर चरण का पाठ ऊपर के लेख का ही है।
जानकारी को फैलाना
मान लीजिए क्वांटम जानकारी को कई फ़िज़िकल क्यूबिट में एन्कोड किया गया है। लॉजिकल क्यूबिट एरर-करेक्टिंग कोड के ज़रिए कई फ़िज़िकल क्यूबिट में एन्कोड की गई क्वांटम जानकारी है।
एक क्यूबिट गलत हो जाता है
संचालन के दौरान उनमें से एक क्यूबिट में गलती हो जाती है। सिस्टम समस्या ढूँढने के लिए हर क्यूबिट को सीधे नहीं पढ़ सकता, क्योंकि सुरक्षित क्वांटम जानकारी को सीधे मापने से गणना के लिए ज़रूरी अवस्था बिगड़ या नष्ट हो सकती है।
डेटा नहीं, संबंध मापना
क्वांटम एरर-करेक्टिंग कोड प्रोसेसर को एन्कोड की गई जानकारी को सीधे उजागर किए बिना क्यूबिट के बीच कुछ संबंध मापने देते हैं। इन मापों से वह मिलता है जिसे शोधकर्ता एरर सिंड्रोम कहते हैं, जो सिस्टम को संकेत देता है कि क्या गड़बड़ हुई होगी।
संभावित सुधार तय करना
एक क्लासिकल डिकोडिंग प्रक्रिया उन संकेतों की व्याख्या करती है और सबसे संभावित सुधार तय करती है।
सुधार लागू करना, या उसका हिसाब रखना
प्रोसेसर कोई सुधार ऑपरेशन लागू कर सकता है, या सुधार का हिसाब रख सकता है ताकि बाद के ऑपरेशन और माप सही ढंग से समझे जाएँ।
गलतियाँ आती रहती हैं
चूँकि गणना के दौरान कभी भी गलतियाँ हो सकती हैं, इस प्रक्रिया को दोहराना पड़ता है। यह असीमित नहीं है: अगर बहुत ज़्यादा गलतियाँ हो जाएँ, या सिस्टम गलती की जानकारी की व्याख्या ग़लत कर दे, तो सुरक्षित लॉजिकल अवस्था फिर भी बिगड़ सकती है। बची रह गई उस विफलता को लॉजिकल एरर कहते हैं।
लॉजिकल क्यूबिट की भरोसेमंदी क्या तय करती है?
सभी लॉजिकल क्यूबिट एक जैसी सुरक्षा नहीं देते।
क्वांटम एरर-करेक्टिंग कोड की एक अहम विशेषता है उसकी कोड डिस्टेंस।
कोड डिस्टेंस उस फ़िज़िकल एरर का न्यूनतम वज़न बताती है जो अनदेखे लॉजिकल ऑपरेशन की तरह काम कर सकता है। मानक क्वांटम एरर-करेक्टिंग कोड की मान्यताओं के तहत, डिस्टेंस-3 कोड एक मनमानी फ़िज़िकल गलती को सुधार सकता है।
डिस्टेंस बढ़ाने से ज़्यादा गलतियों से सुरक्षा मिल सकती है, लेकिन इसके लिए अतिरिक्त फ़िज़िकल संसाधन भी चाहिए।
इससे एक व्यावहारिक सवाल उठता है: अगर हम एक लॉजिकल क्यूबिट की रक्षा के लिए ज़्यादा फ़िज़िकल क्यूबिट लगाएँ, तो क्या नतीजा सचमुच ज़्यादा भरोसेमंद होगा?
जवाब अंतर्निहित हार्डवेयर और सुधार प्रक्रिया की गुणवत्ता पर निर्भर करता है।
एरर करेक्शन में खुद ऐसे ऑपरेशन और माप शामिल हैं जो विफल हो सकते हैं। जब फ़िज़िकल एरर रेट बहुत ऊँची हो, तो और संसाधन जोड़ने से समस्याएँ घटने के बजाय और बढ़ सकती हैं।
जिस सीमा पर कोड का आकार बढ़ाना भरोसेमंदी सुधारना शुरू कर सकता है, शोधकर्ता उसे एरर-करेक्शन थ्रेशोल्ड कहते हैं।
संबंधित थ्रेशोल्ड के नीचे बड़े कोड कम लॉजिकल एरर रेट दे सकते हैं। उसके ऊपर कोड डिस्टेंस बढ़ाने से भरोसेमंदी न सुधरे, ऐसा हो सकता है।
क्वांटम कंप्यूटिंग में यह सबसे अहम पड़ावों में से एक है, क्योंकि यह दिखाता है कि क्या अतिरिक्त हार्डवेयर का इस्तेमाल सुरक्षित क्वांटम जानकारी को क्रमशः ज़्यादा भरोसेमंद बनाने में किया जा सकता है।
यह सिद्धांत हम प्रायोगिक शोध में देख सकते हैं।
Nature में प्रकाशित काम में, Google ने सर्फ़ेस-कोड थ्रेशोल्ड के नीचे क्वांटम एरर करेक्शन दिखाया। शोधकर्ताओं ने बताया कि कोड डिस्टेंस बढ़ने पर लॉजिकल एरर घटे, और परखे गए क्रम में कोड डिस्टेंस हर बार दो बढ़ाने पर एरर-दमन गुणक लगभग 2.14 रहा।
अक्टूबर 2026 में, Quantinuum ने बताया कि परखे गए कलर-कोड डिस्टेंस क्रम में हर क्रमिक वृद्धि पर दमन गुणक लगभग 12 रहा।
प्रयोगों में अलग-अलग हार्डवेयर और अलग-अलग एरर-करेक्टिंग कोड इस्तेमाल हुए, इसलिए उनके संख्यात्मक नतीजों को सीधे प्रदर्शन की रैंकिंग नहीं मानना चाहिए।
दोनों नतीजों को अहम बनाता है मज़बूत एन्कोडिंग और कम लॉजिकल एरर रेट के बीच दिखा हुआ संबंध।
यह ऐसे क्वांटम सिस्टम बनाने की ओर प्रगति दिखाता है जिनकी भरोसेमंदी अतिरिक्त फ़िज़िकल संसाधन जोड़ने पर बेहतर हो सके।
एक भरोसेमंद लॉजिकल क्यूबिट अभी पूरा क्वांटम कंप्यूटर नहीं है
एक बार जब हम समझ जाते हैं कि लॉजिकल क्यूबिट जानकारी की रक्षा कैसे करते हैं, तो एक और सवाल उठता है।
अगर शोधकर्ता बेहद भरोसेमंद लॉजिकल क्यूबिट बना सकते हैं, तो उपयोगी फ़ॉल्ट-टॉलरेंट क्वांटम कंप्यूटर बनाना अब भी इतना कठिन क्यों है?
जवाब है कि क्वांटम जानकारी को रखना और उससे गणना करना अलग-अलग इंजीनियरिंग चुनौतियाँ हैं।
एक लॉजिकल क्यूबिट एरर करेक्शन के कई दौरों में अपनी एन्कोड की हुई अवस्था को बचाए रख सकता है। इसे लॉजिकल मेमोरी कहते हैं।
लेकिन क्वांटम कंप्यूटर को उस जानकारी पर ऑपरेशन भी करने होते हैं। एन्कोड किए गए क्यूबिट पर काम करने पर इन ऑपरेशन को लॉजिकल गेट कहते हैं।
लॉजिकल गेट चलाना एन्कोड की गई जानकारी को स्थिर रखने से ज़्यादा जटिल है। ऑपरेशन को इच्छित नतीजा देना होता है, बिना ऐसी गलतियाँ लाए जो कोड की दी हुई सुरक्षा को दबा दें।
क्वांटम कंप्यूटरों को कई लॉजिकल क्यूबिट का तालमेल बिठाना, माप करना, एरर की जानकारी प्रोसेस करना और गणनाओं को व्यावहारिक संचालन समय में पूरा करना भी होता है।
Quantinuum का अक्टूबर 2026 का शोध इस अंतर को दिखाता है।
कंपनी ने कोड डिस्टेंस 7 पर प्रति एरर-करेक्शन दौर लगभग दस लाख में पाँच की लॉजिकल मेमोरी एरर रेट बताई।
क्वांटम जानकारी को बचाए रखने के लिए यह एक अहम नतीजा है। हालाँकि, इसके लॉजिकल गेट प्रयोग डिस्टेंस 5 तक पहुँचे और लॉजिकल ऑपरेशन के सार्वभौमिक समूह के बजाय क्लिफ़ॉर्ड सर्किट इस्तेमाल हुए। शोधकर्ताओं ने ऐसे डिकोडिंग तरीकों का भी मूल्यांकन किया जिनकी प्रोसेसिंग गति वास्तविक-समय संचालन के अनुकूल हो सकती है, लेकिन बताए गए प्रयोगों ने वास्तविक-समय डिकोडिंग और सुधारात्मक फ़ीडबैक के एकीकृत चक्र को नहीं दिखाया।
यह नतीजा मज़बूत लॉजिकल मेमोरी सुरक्षा और भरोसेमंद लॉजिकल गेट की ओर प्रगति का प्रमाण देता है। यह अभी सामान्य क्वांटम एल्गोरिदम के लिए ज़रूरी पूरी फ़ॉल्ट-टॉलरेंट कंप्यूटिंग प्रक्रिया को नहीं दिखाता।
अक्टूबर 2026 का Quantinuum नतीजा क्या दिखाता है, और क्या नहीं
यह एक प्रयोग कितनी दूर जाता है, यह देखने के लिए फ़ॉल्ट-टॉलरेंट कंप्यूटर का कोई हिस्सा चुनें। पाठ ऊपर के लेख का ही है।
एन्कोड की गई जानकारी को बचाए रखनादिखाया गया
कंपनी ने कोड डिस्टेंस 7 पर प्रति एरर-करेक्शन दौर लगभग दस लाख में पाँच की लॉजिकल मेमोरी एरर रेट बताई। क्वांटम जानकारी को बचाए रखने के लिए यह एक अहम नतीजा है।
स्रोत: Quantinuum, अक्टूबर 2026 का प्रीप्रिंट (स्रोत जाँच के समय तक पीयर रिव्यू नहीं हुआ था)। arXiv:2610.24077
एन्कोड किए गए क्यूबिट पर ऑपरेशनआंशिक रूप से दिखाया गया
लॉजिकल गेट प्रयोग डिस्टेंस 5 तक पहुँचे और लॉजिकल ऑपरेशन के सार्वभौमिक समूह के बजाय क्लिफ़ॉर्ड सर्किट इस्तेमाल हुए।
काफ़ी तेज़ डिकोडिंग, चक्र के भीतर हीनहीं दिखाया गया
शोधकर्ताओं ने ऐसे डिकोडिंग तरीकों का मूल्यांकन किया जिनकी प्रोसेसिंग गति वास्तविक-समय संचालन के अनुकूल हो सकती है, लेकिन बताए गए प्रयोगों ने वास्तविक-समय डिकोडिंग और सुधारात्मक फ़ीडबैक के एकीकृत चक्र को नहीं दिखाया।
सामान्य क्वांटम एल्गोरिदम चलानानहीं दिखाया गया
यह नतीजा मज़बूत लॉजिकल मेमोरी सुरक्षा और भरोसेमंद लॉजिकल गेट की ओर प्रगति का प्रमाण देता है। यह अभी सामान्य क्वांटम एल्गोरिदम के लिए ज़रूरी पूरी फ़ॉल्ट-टॉलरेंट कंप्यूटिंग प्रक्रिया को नहीं दिखाता।
संचालन की गति भी मायने रखती है। दो मशीनें प्रति करेक्शन दौर एक जैसी एरर रेट बता सकती हैं, फिर भी उन दौरों को पूरा करने में बहुत अलग समय ले सकती हैं।
एक व्यावहारिक क्वांटम कंप्यूटर को भरोसेमंदी, प्रोसेसिंग गति, डिकोडिंग क्षमता और ज़रूरी फ़िज़िकल हार्डवेयर के बीच संतुलन बनाना होगा।
इसीलिए लॉजिकल क्यूबिट का विकास फ़ॉल्ट-टॉलरेंट क्वांटम कंप्यूटिंग की ओर एक बड़ा कदम है, लेकिन आख़िरी कदम नहीं।
क्वांटम-कंप्यूटिंग के दावों को कैसे समझें?
अब एक ऐसी घोषणा पर विचार कीजिए कि किसी कंपनी ने 30 लॉजिकल क्यूबिट दिखाए हैं।
यह नतीजा बताता है कि शोधकर्ताओं ने एक ख़ास एन्कोड की हुई क्वांटम प्रणाली बनाई। लेकिन इसका महत्व समझने के लिए हमें जानना होगा कि उन क्यूबिट की रक्षा कैसे की गई, वे कितने भरोसेमंद ढंग से चले और कौन-सी गणनाएँ दिखाई गईं।
इसी तरह, बेहद कम लॉजिकल एरर रेट की घोषणा को संदर्भ चाहिए। क्या एरर रेट जानकारी रखते समय मापी गई या लॉजिकल ऑपरेशन करते समय? क्या यह प्रति गेट, प्रति जाँच दौर या किसी समयावधि में मापी गई? क्या कोड डिस्टेंस बढ़ने पर सिस्टम ज़्यादा भरोसेमंद हुआ?
ये ब्योरे बताते हैं कि हार्डवेयर असल में क्या कर सकता है।
क्वांटम घोषणा को कैसे पढ़ें
अधिकतम दो सवालों के जवाब दें। यह TechiesJournal का अपना पढ़ने का सहायक है, जो इस हिस्से पर आधारित है। यह किसी असली घोषणा पर फ़ैसला नहीं है।
घोषणा किस चीज़ की गिनती बता रही है?
पूछें कि उनकी रक्षा कैसे की गई। यह नतीजा बताता है कि शोधकर्ताओं ने एक ख़ास एन्कोड की हुई क्वांटम प्रणाली बनाई। इसका महत्व समझने के लिए हमें जानना होगा कि उन क्यूबिट की रक्षा कैसे की गई, वे कितने भरोसेमंद ढंग से चले और कौन-सी गणनाएँ दिखाई गईं।
क्या एरर रेट जानकारी रखते समय मापी गई या लॉजिकल ऑपरेशन करते समय?
यह मेमोरी का नतीजा है। पूछें कि यह प्रति गेट, प्रति जाँच दौर या किसी समयावधि में मापी गई, और क्या कोड डिस्टेंस बढ़ने पर सिस्टम ज़्यादा भरोसेमंद हुआ।
यह ऑपरेशन का नतीजा है। पूछें कि यह प्रति गेट, प्रति जाँच दौर या किसी समयावधि में मापी गई, और क्या कोड डिस्टेंस बढ़ने पर सिस्टम ज़्यादा भरोसेमंद हुआ।
पहले यही पूछें। बेहद कम लॉजिकल एरर रेट की घोषणा को संदर्भ चाहिए। क्या एरर रेट जानकारी रखते समय मापी गई या लॉजिकल ऑपरेशन करते समय? क्या यह प्रति गेट, प्रति जाँच दौर या किसी समयावधि में मापी गई?
क्या यह संसाधन अनुमान है या ऐसी मशीन जिसने गणना चलाई?
अनुमान है, प्रदर्शन नहीं। ये अनुमान भविष्य की संभावित ज़रूरतों को समझने के लिए उपयोगी हैं। वे इस बात का प्रदर्शन नहीं हैं कि मौजूदा क्वांटम हार्डवेयर वह गणना पूरी कर सकता है। संख्या के पीछे की हार्डवेयर मान्यताएँ पढ़ें।
पूछें कि उसने क्या गणना की। ये ब्योरे बताते हैं कि हार्डवेयर असल में क्या कर सकता है: क्यूबिट की रक्षा कैसे की गई, वे कितने भरोसेमंद ढंग से चले और कौन-सी गणनाएँ दिखाई गईं।
यही सिद्धांत भविष्य के क्वांटम कंप्यूटरों के अनुमानों पर भी लागू होता है।
उदाहरण के लिए, शोधकर्ताओं ने अनुमान प्रकाशित किए हैं कि फ़ॉल्ट-टॉलरेंट क्वांटम कंप्यूटर से RSA-2048 को फ़ैक्टर करने के लिए कितने फ़िज़िकल क्यूबिट की ज़रूरत पड़ सकती है।
Craig Gidney के 2025 के संसाधन अनुमान ने ख़ास हार्डवेयर मान्यताओं के तहत दस लाख से कम नॉइज़ी फ़िज़िकल क्यूबिट वाला एक संभावित तरीका बताया। Iceberg Quantum के Pinnacle 1.2 अध्ययन ने बाद में एक अलग प्रस्तावित आर्किटेक्चर और मान्यताओं के साथ, एक माइक्रोसेकंड के कोड चक्र पर, 48,000 से 72,000 फ़िज़िकल क्यूबिट के सिम्युलेटेड अनुमान बताए। एक मिलीसेकंड के कोड चक्र पर वही अध्ययन 714,000 से 2.1 मिलियन देता है।
ये अनुमान भविष्य की संभावित ज़रूरतों को समझने के लिए उपयोगी हैं। वे इस बात का प्रदर्शन नहीं हैं कि मौजूदा क्वांटम हार्डवेयर वह गणना पूरी कर सकता है।
यह अंतर ख़ासकर सुरक्षा योजना के लिए मायने रखता है। संगठनों को किसी ख़ास क्यूबिट-संख्या के पड़ाव का इंतज़ार करने के बजाय, स्थापित सुरक्षा मार्गदर्शन और जिस जानकारी की उन्हें रक्षा करनी है उसकी उम्र के आधार पर पोस्ट-क्वांटम क्रिप्टोग्राफ़ी की तैयारी करनी चाहिए।
इस विषय पर और जानने के लिए TechiesJournal का Post-Quantum Cryptography Goes Default-On देखें।
क्वांटम कंप्यूटरों के विकास में क्या मायने रखता है?
एक उपयोगी क्वांटम कंप्यूटर बनाने के लिए कई क्षेत्रों में एक साथ प्रगति चाहिए।
फ़िज़िकल क्यूबिट ज़्यादा भरोसेमंद होने चाहिए। एरर-करेक्टिंग कोड को अत्यधिक ओवरहेड के बिना क्वांटम जानकारी की रक्षा करनी चाहिए। लॉजिकल ऑपरेशन इतने सटीक चलने चाहिए कि लंबी गणनाओं को सहारा दे सकें, और गलतियों को डिकोड करने वाले क्लासिकल सिस्टम क्वांटम हार्डवेयर के साथ क़दम मिला सकें।
ये ज़रूरतें आपस में गहराई से जुड़ी हैं। एक हिस्से को सुधारने से बाकी अपने-आप हल नहीं हो जाते।
क्वांटम कंप्यूटिंग सीख रहे किसी व्यक्ति के लिए, इस संबंध को समझना ताज़ा प्रोसेसर विनिर्देश रटने से ज़्यादा उपयोगी है।
क्वांटम सिस्टम पर सीधे काम करने वाले इंजीनियरों और शोधकर्ताओं के लिए, गहरी चुनौतियाँ कोड डिज़ाइन, डिकोडिंग एल्गोरिदम, नॉइज़ का व्यवहार, लॉजिकल गेट का क्रियान्वयन और आर्किटेक्चर को बढ़ाने की भौतिक लागत हैं।
क्वांटम कंप्यूटिंग प्रभावशाली प्रायोगिक नतीजे देती रहेगी। कुछ बेहतर फ़िज़िकल क्यूबिट दिखाएँगे, कुछ ज़्यादा प्रभावी एरर करेक्शन, और कुछ लॉजिकल ऑपरेशन करने के नए तरीके।
इन प्रगतियों का महत्व इस पर निर्भर करता है कि वे बड़े इंजीनियरिंग लक्ष्य में कैसे योगदान देती हैं।
फ़िज़िकल क्यूबिट क्वांटम गणना को संभव बनाते हैं। लॉजिकल क्यूबिट क्वांटम जानकारी को गलतियों से बचाना संभव बनाते हैं। फ़ॉल्ट-टॉलरेंट क्वांटम कंप्यूटिंग के लिए ज़रूरी है कि उपयोगी एल्गोरिदम चलते समय वह सुरक्षा प्रभावी बनी रहे।
प्रगति का असली पैमाना यह नहीं कि मशीन में कितने क्यूबिट हैं, बल्कि यह है कि क्या वे क्यूबिट इतनी भरोसेमंदी से साथ काम कर सकते हैं कि सार्थक गणनाएँ पूरी हो सकें।
और गहराई में
- Quantum Error Correction Below the Surface Code Threshold, Google Quantum AI का शोध, Nature में प्रकाशित। बताता है कि कोड डिस्टेंस बढ़ाने से लॉजिकल एरर कैसे घट सकते हैं।
- Quantum Error Correction Well Below the Color Code Threshold, Quantinuum, अक्टूबर 2026 का प्रीप्रिंट। कलर कोड से लॉजिकल मेमोरी सुरक्षा और एरर दमन को परखता है।
- From Memory to Logic, Quantinuum, 13 नवंबर 2025। क्वांटम मेमोरी की रक्षा और लॉजिकल ऑपरेशन करने के बीच के इंजीनियरिंग अंतर बताता है।
- How to Factor 2048 Bit RSA Integers with Less Than a Million Noisy Qubits, Craig Gidney, 2025। दिखाता है कि फ़ॉल्ट-टॉलरेंट आर्किटेक्चर किसी जटिल क्वांटम एल्गोरिदम के लिए ज़रूरी संसाधनों के अनुमान को कैसे प्रभावित करते हैं।
- Pinnacle 1.2, Iceberg Quantum, 22 अक्टूबर 2026। सिम्युलेटेड RSA-2048 संसाधन अनुमानों और उनकी मान्यताओं का कंपनी का मूल विवरण।
शोध की समीक्षा: 30 अक्टूबर 2026। प्रायोगिक निष्कर्ष, प्रीप्रिंट और संसाधन अनुमान अपने बताए गए प्रमाण के अनुसार प्रस्तुत किए गए हैं। सार्वजनिक प्रकाशन से पहले समय-संवेदनशील नतीजे दोबारा जाँचें।