

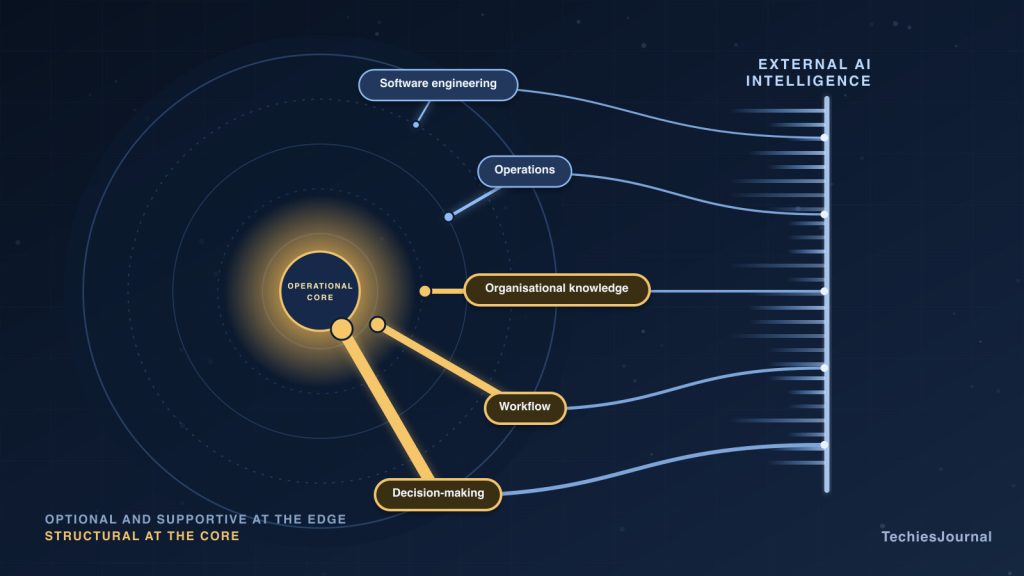
AI अपनाने की शुरुआत अक्सर एक सीधे-सादे business case से होती है। एक coding assistant developers को तेज़ी से काम करने में मदद करता है। एक agent दोहराव वाला operational काम संभाल लेता है। एक model ऐसे documents का सार बना देता है जिन्हें पहले कर्मचारी घंटों में पढ़कर जाँचते थे।
एक decision service requests को वर्गीकृत करती है या तय करती है कि आगे कौन-सा workflow चलेगा। हर उपयोग अपने आप में सही बैठ सकता है।
आर्थिक पक्ष भी आकर्षक हो सकता है। एक कंपनी उसी team के साथ ज़्यादा काम पूरा कर सकती है, दोहराव वाली मेहनत घटा सकती है और ऐसी क्षमताएँ ख़ुद बनाने से बच सकती है जो कोई AI service तुरंत दे सकती है।
मैं इस दिशा का समर्थन करता हूँ।
लेकिन जैसे-जैसे AI लोगों की मदद करने से आगे बढ़कर इस बात का हिस्सा बन रहा है कि कंपनी ख़ुद कैसे चलती है, मुझे लगता है कि एक और पहलू पर बराबर ध्यान देना ज़रूरी है:
कंपनी की कितनी क्षमता अब भी कंपनी की अपनी है?
यह बाहरी AI providers का विरोध करने वाला तर्क नहीं है। आज के business पहले से ही cloud platforms, SaaS products, databases, payment services और कई दूसरी बाहरी technologies पर बहुत निर्भर हैं।
फ़र्क़ यह है कि AI अब उन क्षेत्रों में आने लगा है जहाँ पहले इंसानी judgement, engineering ज्ञान और application logic होती थी। इससे ऐसी निर्भरता बन सकती है जो किसी और technology service को सिर्फ़ इस्तेमाल करने से कहीं ज़्यादा गहरी हो।
यह जोखिम पहले दिन शायद ही कभी दिखता है। यह धीरे-धीरे बनता है, जैसे-जैसे technology सफल होती जाती है।
Efficiency चुपचाप निर्भरता बन सकती है
software development को ही लीजिए। एक कंपनी coding agents इसलिए अपनाती है क्योंकि वे productivity बढ़ाते हैं। Developers उनका इस्तेमाल code लिखवाने, failures की जाँच करने, tests लिखने, changes review करने और system के अनजान हिस्सों को समझने में करते हैं।
शुरुआत में agent साफ़ तौर पर एक assistant है। engineering क्षमता संगठन के भीतर ही रहती है। लेकिन अब उसी कंपनी की कल्पना कीजिए, कई साल बाद। अब agents रोज़मर्रा के implementation काम का बड़ा हिस्सा संभालते हैं।
Teams छोटी हो जाती हैं। कुछ junior भूमिकाएँ ख़त्म हो जाती हैं। Documentation पर कम ध्यान दिया जाता है, क्योंकि ज़रूरत पड़ने पर agent repository ख़ुद देख सकता है।
Engineers अनजान systems को ख़ुद समझकर वह ज्ञान बनाने के बजाय model से समझाने के लिए कहने के आदी हो जाते हैं। इनमें से कोई भी फ़ैसला ज़रूरी नहीं कि ग़लत हो। अलग-अलग देखें तो हर एक तर्कसंगत हो सकता है।
लेकिन साथ मिलकर वे एक अहम सवाल खड़ा करते हैं:
अगर वह AI क्षमता उपलब्ध न रहे, बहुत ज़्यादा महँगी हो जाए या कंपनी की ज़रूरतों के लिए अनुपयुक्त हो जाए, तो संगठन कितना काम आत्मविश्वास के साथ ख़ुद कर पाएगा?
यहीं से efficiency एक architecture का मुद्दा बनने लगती है।
इस figure का सुलभ text विकल्प
पाँच चरण क्रम में। एक, AI सहायक: व्यक्ति को काम करने में मदद करता है। दो, एकीकृत workflow: AI एक दोहराए जाने वाले business process का हिस्सा बन जाता है। तीन, Operational क्षमता: systems और teams मानकर चलते हैं कि AI उपलब्ध रहेगा। चार, संरचनात्मक निर्भरता: AI layer बदलने के लिए migration, evaluation या संगठनात्मक बदलाव की ज़रूरत पड़ती है। पाँच, सोच-समझकर प्रबंधित निर्भरता: संगठन ज्ञान, evaluation, fallback और provider बदलने की क्षमता अपने पास रखता है। लक्ष्य है प्रबंधित निर्भरता, AI से दूरी नहीं। यह TechiesJournal का विश्लेषण है।
इस समस्या का एक पहलू हम पहले देख चुके हैं
TechiesJournal के एक पिछले Perspective, When AI Does the Junior Work, Who Develops the Next Generation of Professionals?, में मैंने उस असर को देखा था जो उस काम के automate होने से पड़ता है जिससे लोग परंपरागत रूप से अनुभव हासिल करते थे।
चिंता यह नहीं थी कि junior काम हमेशा हाथ से ही होना चाहिए। चिंता यह थी कि जब वह काम ख़त्म होता है, तो संगठनों को समझना चाहिए कि उसके साथ और क्या ख़त्म हो जाता है। रोज़मर्रा के काम अक्सर तुरंत मिलने वाले output से ज़्यादा कुछ करते हैं।
वे लोगों को सिखाते हैं कि systems कैसे व्यवहार करते हैं। वे उन्हें ग़लतियों से रूबरू कराते हैं। वे judgement बनाते हैं। वे उन senior engineers, analysts और specialists को तैयार करते हैं जिनकी संगठन को आगे चलकर ज़रूरत होगी।
AI पर निर्भरता में भी ऐसा ही एक समानांतर जोखिम है। जब हम काम AI को सौंपते हैं, तो उस काम के लिए ज़रूरी ज्ञान का कुछ हिस्सा भी धीरे-धीरे सौंप सकते हैं। तुरंत मिलने वाला productivity लाभ दिखता है। जो क्षमता खो रही है, उसे देखना कहीं ज़्यादा मुश्किल है।
इससे यह सिर्फ़ workforce की चर्चा नहीं रह जाती। यह operational resilience का सवाल बन जाता है।
निर्भरता तब और गहरी होती है जब AI software के भीतर आ जाता है
Coding agents को समझना अब भी अपेक्षाकृत आसान है, क्योंकि एक इंसानी engineer साफ़ तौर पर शामिल रहता है। Decision-oriented AI स्थिति बदल देता है। परंपरागत रूप से, software के कई फ़ैसले सीधे application logic में लिखे होते हैं।
उदाहरण के लिए:
एक निश्चित सीमा से ऊपर के transaction को अतिरिक्त review चाहिए। एक customer category की request एक workflow का पालन करती है। शर्तों का एक ख़ास मेल एक तय कार्रवाई पैदा करता है। ये नियम कंपनी के अपने होते हैं।
कंपनी उन्हें देख सकती है, test कर सकती है, बदल सकती है और किसी बाहरी intelligence service से पूछे बिना चला सकती है। यह ढाँचा अब फैलने लगा है।
TypeSafe का Jev, उदाहरण के लिए, ख़ास तौर पर software के भीतर इस्तेमाल के लिए एक तेज़ decision model के रूप में विकसित किया जा रहा है। लंबा text बनाने के बजाय यह state लेता है और probabilities के साथ structured decisions देता है।
OpenAI ने भी अपना Decisions API limited preview में पेश किया है, जो classification, routing और पहले से तय विकल्पों में से application की अगली कार्रवाई चुनने जैसे कामों के लिए बनाया गया है।
ये technologies इसीलिए दिलचस्प हैं कि ये software को ज़्यादा adaptive बना सकती हैं। लेकिन ये निर्भरता का स्वरूप भी बदल देती हैं।
अगर कोई application किसी बाहरी model से पूछती है:
इस request को कौन-सा रास्ता लेना चाहिए?
तो model अब सिर्फ़ किसी कर्मचारी की मदद नहीं कर रहा। वह application के व्यवहार का हिस्सा बन गया है। इसके लिए architecture के बारे में अलग तरह से सोचना ज़रूरी है।
| आयाम | Deterministic application logic | AI-assisted decision क्षमता |
|---|---|---|
| व्यवहार | स्पष्ट नियम अपेक्षित रास्ता तय करते हैं | model अनुमत नतीजों में से चुनने में मदद करता है |
| स्वामित्व | Logic मुख्य रूप से कंपनी के code में रहती है | workflow कंपनी का होता है, लेकिन कुछ व्यवहार किसी बाहरी model पर निर्भर हो सकता है |
| परीक्षण | सटीक नियमों और नतीजों को आम तौर पर assert किया जा सकता है | प्रतिनिधि मामलों में व्यवहार परखने के लिए evaluations की ज़रूरत पड़ सकती है |
| Provider बदलना | अक्सर implementation की अदला-बदली | व्यवहार की तुलना और दोबारा validation की ज़रूरत पड़ सकती है |
| Fallback | एक जाना-पहचाना deterministic रास्ता | सोच-समझकर बनाया गया fallback या escalation चाहिए |
| सबसे उपयुक्त | स्थिर नियम और साफ़ शर्तें | ऐसी स्थितियाँ जहाँ अनिश्चितता या judgement सचमुच मूल्य जोड़ती है |
API बदलने से ज़रूरी नहीं कि क्षमता भी बदल जाए
यह सोचना लुभावना है कि provider को एक interface के पीछे रख देने से यह हल हो जाएगा। यह अच्छी engineering practice है, लेकिन शायद काफ़ी न हो। मान लीजिए एक संगठन कई सालों से एक decision model इस्तेमाल कर रहा है।
समय के साथ वह बनाता है:
- prompts या decision definitions
- evaluation datasets
- confidence thresholds
- escalation नियम
- monitoring
- exception handling
- model के व्यवहार पर आधारित business processes।
अब कोई दूसरा provider ज़्यादा आकर्षक हो जाता है। API integration बदलना आसान हो सकता है। व्यवहार शायद उतना आसान न हो। नया model edge cases को अलग तरह से वर्गीकृत कर सकता है।
Confidence scores अलग तरह से व्यवहार कर सकते हैं। Thresholds को दोबारा calibrate करना पड़ सकता है। Business users को नए नतीजे validate करने पड़ सकते हैं। Regulated workflows को नई मंज़ूरी की ज़रूरत पड़ सकती है।
यानी बदलाव करना किसी software library को बदलने जैसा कम, और decision system का एक हिस्सा बदलने जैसा ज़्यादा हो सकता है। इसलिए निर्भरता ज़रूरी नहीं कि API में हो। वह उस सब कुछ में है जो संगठन ने उस AI के व्यवहार के आसपास खड़ा किया है।
कीमत निर्भरता के सामने आने का सिर्फ़ एक रास्ता है
यह मान लेना बहुत सरल होगा कि कंपनियाँ निर्भर हो जाएँ तो AI providers लगातार कीमतें बढ़ाते जाएँगे। ऐसा सामान्य दावा करने का कोई आधार नहीं है, और प्रतिस्पर्धा कीमतों को ऊपर की तरह नीचे भी धकेल सकती है।
ज़्यादा अहम बात यह है कि unit price और कुल निर्भरता अलग-अलग चीज़ें हैं।
एक model सस्ता हो सकता है, फिर भी कंपनी कुल मिलाकर ज़्यादा ख़र्च कर सकती है।
क्यों?
क्योंकि वह AI का इस्तेमाल ज़्यादा जगहों पर करने लगती है। एक developer हर coding काम के लिए agent इस्तेमाल करता है। Customer support agent-assisted हो जाता है। Internal search में models लगते हैं।
Security analysis में models लगते हैं। Business workflows decision services को call करने लगते हैं। एक AI interaction हज़ारों या लाखों automated interactions बन जाता है।
TypeSafe, Jev नाम की व्याख्या करते हुए, यह बात साफ़ कहता है: ज़्यादा efficiency machine intelligence की कहीं ज़्यादा माँग खोल सकती है। जब अतिरिक्त इस्तेमाल मूल्य पैदा करता है, तो यह commercial रूप से सकारात्मक है।
लेकिन इसका मतलब है कि संगठनों को AI की economics सिर्फ़ आज की token कीमत के आधार पर नहीं बनानी चाहिए। ज़्यादा अहम सवाल यह है कि business का कितना हिस्सा आख़िरकार बाहरी intelligence को लगातार ख़रीदने पर निर्भर होगा।
निर्भरता को सोच-समझकर डिज़ाइन करना
यह architecture की जानी-पहचानी सोच है। Enterprise architects दशकों से निर्भरता को portability, service abstraction, disaster recovery, data ownership, open standards और exit planning के ज़रिए संभालते आए हैं। AI भी यही अनुशासन माँगता है।
लेकिन एक और तत्व मायने रखता है, क्योंकि AI technology के साथ-साथ ज्ञान की जगह भी ले सकता है। अगर कोई कंपनी database को एक cloud से दूसरे में ले जाती है, तब भी उसके engineers databases को समझते हैं।
अगर वह payroll SaaS platform बदलती है, तब भी उसकी HR team payroll को समझती है।
लेकिन अगर संगठन कोई क्षमता विकसित करना धीरे-धीरे इसलिए छोड़ देता है कि AI system वह काम कर रहा है, तो कंपनी आख़िरकार उस system को बदलने के लिए ज़रूरी कुछ विशेषज्ञता खो सकती है।
Technology पर निर्भरता और क्षमता पर निर्भरता साथ-साथ विकसित हो सकती हैं।
इसका मतलब यह नहीं कि कंपनियों को सब कुछ ख़ुद बनाना चाहिए। ज़्यादातर संगठनों को frontier models नहीं बनाने चाहिए, और न ही ऐसे products दोहराने चाहिए जो विशेषज्ञ vendors कहीं ज़्यादा कुशलता से दे सकते हैं।
लक्ष्य ज़्यादा सरल है:
बाहरी intelligence का इस्तेमाल कीजिए, लेकिन उसके आसपास की क्षमता पर से अनावश्यक नियंत्रण मत छोड़िए।
इसका मतलब है कि कई चीज़ें संगठन के नियंत्रण में रखी जाएँ।
इस figure का सुलभ text विकल्प
छह चीज़ें जिन्हें संगठन को अपने नियंत्रण में रखना चाहिए। एक, business context: data, policies, शब्दावली और domain का ज्ञान। दो, evaluation: यह जानना कि किसी भी model के लिए अच्छा क्या होता है। तीन, decision boundaries: जहाँ deterministic नियम काफ़ी हैं, वहाँ उन्हें रखना। चार, fallback व्यवहार: यह तय करना कि AI के अनुपलब्ध या अनिश्चित होने पर क्या होगा। पाँच, आंतरिक विशेषज्ञता: काम को इतना समझना कि AI को परख सकें। छह, provider boundaries: हर जगह provider-specific मान्यताएँ बनाने से बचना। केंद्रीय सिद्धांत है बाहरी intelligence का इस्तेमाल करना, लेकिन उसके आसपास की क्षमता पर से अनावश्यक नियंत्रण न छोड़ना। यह TechiesJournal का विश्लेषण है।
Business context
कंपनी का data, policies, शब्दावली और domain ज्ञान सिर्फ़ किसी vendor-specific implementation के भीतर नहीं होना चाहिए।
Evaluation
संगठन को यह पता होना चाहिए कि “अच्छा” क्या होता है, चाहे इस समय कोई भी model इस्तेमाल हो रहा हो। अगर कोई दूसरा model लाया जाए, तो कंपनी उसे अपनी अपेक्षाओं के आधार पर परख सकने में सक्षम होनी चाहिए।
Decision boundaries
जहाँ deterministic नियम काफ़ी हैं, वहाँ उन्हें deterministic ही रहना चाहिए। AI वहाँ इस्तेमाल होना चाहिए जहाँ judgement या अनिश्चितता सचमुच मूल्य जोड़ती है, न कि सीधे-सादे business logic की जगह सिर्फ़ इसलिए कि वह ऐसा कर सकता है।
Fallback व्यवहार
महत्वपूर्ण workflows में यह तय होना चाहिए कि अगर AI service उपलब्ध न हो, अनिश्चित हो या अपनी मंज़ूर की गई operating conditions से बाहर हो, तो क्या होगा।
आंतरिक विशेषज्ञता
कर्मचारियों को business और technical क्षमता को इतना ज़रूर समझना चाहिए कि वे परख सकें कि AI क्या कर रहा है।
Provider boundaries
Application architecture को provider-specific मान्यताओं को बेवजह हर जगह फैलाने से बचना चाहिए। इनमें से कोई भी निर्भरता को ख़त्म नहीं करता। ये निर्भरता को संभालने लायक बनाते हैं।
Exit की योजना exit ज़रूरी होने से पहले शुरू होनी चाहिए
जब AI implementation अच्छी तरह चल रही हो, तब यह समय से पहले की बात लग सकती है। ठीक तभी यह सबसे आसान होता है। Gartner ने हाल ही में agentic AI के लिए vendor forward-deployed engineering पर चर्चा करते हुए एक संबंधित बात कही।
उसकी चिंता यह है कि संगठन शुरुआत में तेज़ प्रगति कर सकते हैं, लेकिन बने हुए system को स्वतंत्र रूप से चलाने और आगे बढ़ाने के लिए पर्याप्त आंतरिक क्षमता नहीं बना पाते।
उसकी सिफ़ारिश में knowledge transfer, ownership और शुरुआत से ही exit strategy शामिल हैं, इस इंतज़ार के बजाय कि रिश्ता बदलना मुश्किल हो जाए। मुझे लगता है कि यह सिद्धांत forward-deployed engineering से आगे भी लागू होता है।
किसी बाहरी AI service को critical क्षमता का हिस्सा बनाने से पहले संगठन को समझ लेना चाहिए:
- अगर यह service उपलब्ध न हो, तो हमें क्या बदलना पड़ेगा?
- कौन-सा ज्ञान हमें अपने भीतर चाहिए होगा?
- किसे दोबारा validate करना पड़ेगा?
- कौन-सा data और कौन-से evaluations हमारे नियंत्रण में हैं?
- क्या कोई दूसरा model यह भूमिका निभा सकता है?
- इसे बदलते समय क्या चालू रहेगा?
ये सवाल इसलिए नहीं पूछने हैं कि हमें provider के विफल होने की उम्मीद है। ये सवाल इसलिए पूछने हैं कि ज़िम्मेदार architecture यह मानकर चलता है कि technology बदलती है।
लागत को सिर्फ़ खपत से आगे नापना चाहिए
इससे AI FinOps के बारे में मेरी सोच भी बदलती है। Tokens, model calls, agent runtime और tool usage अब भी मायने रखते हैं। लेकिन आर्थिक तस्वीर इससे बड़ी है।
एक परिपक्व संगठन को आख़िरकार यह समझने की ज़रूरत पड़ सकती है:
चलाने की लागत
इस AI workflow की आज कितनी लागत है?
मूल्य
उस ख़र्च से कौन-सा काम या business नतीजा मिलता है?
बदलने की लागत
इस क्षमता को कहीं और ले जाने में कितना ख़र्च आएगा?
क्षमता की लागत
AI के काम करने की वजह से कौन-से आंतरिक कौशल कमज़ोर हो रहे हैं? आख़िरी दो को dashboard में रखना ज़्यादा मुश्किल है। फिर भी लंबे समय में वे token pricing के छोटे-से फ़र्क़ से ज़्यादा मायने रख सकते हैं।
मेरा दृष्टिकोण
Enterprise AI अपनाने का पहला दौर ज़्यादातर क्षमता के बारे में था। क्या model उपयोगी code लिख सकता है? क्या वह documents समझ सकता है? क्या agent काम पूरा कर सकता है?
क्या decision model workflow बेहतर कर सकता है?
अगला दौर एक और पहलू माँगता है:
जब ये systems रोज़मर्रा के काम का हिस्सा बन जाते हैं, तो संगठन का क्या होता है?
एक सफल AI system का इस्तेमाल स्वाभाविक रूप से ज़्यादा होगा। Teams उसके आसपास processes डिज़ाइन करेंगी। कर्मचारी उस पर निर्भर रहना सीख जाएँगे। Software यह मानकर चलने लगेगा कि वह उपलब्ध रहेगा।
यह विफलता नहीं है। सफल technology adoption ऐसा ही दिखता है। लेकिन सफलता निर्भरता पैदा करती है।
Architecture की ज़िम्मेदारी उस निर्भरता को ख़त्म करना नहीं है। उसकी ज़िम्मेदारी यह पक्का करना है कि संगठन उसे समझे और इतना नियंत्रण अपने पास रखे कि technology, economics या business की ज़रूरतें बदलने पर ख़ुद को ढाल सके।
मेरे लिए सिद्धांत सरल है:
AI का इस्तेमाल वहाँ कीजिए जहाँ वह मूल्य पैदा करता है। उसे अनावश्यक काम हटाने दीजिए। उसे फ़ैसले बेहतर करने दीजिए। लेकिन ज्ञान, evaluation, architecture और operational नियंत्रण अपने पास रखिए, ताकि संगठन उस intelligence के मिलने का तरीक़ा बदल सकें।
असली फ़र्क़ उन कंपनियों के बीच नहीं है जो AI पर निर्भर हैं और जो नहीं हैं। ज़्यादातर गंभीर संगठन शायद निर्भर होंगे। फ़र्क़ उस निर्भरता के बीच होगा जो संयोग से बन गई और उस निर्भरता के बीच जिसे सोच-समझकर डिज़ाइन किया गया।
संबंधित लेख: Building Agentic Systems: From Your First Agent to a Reliable System में agent की स्वायत्तता बढ़ने पर सीमाओं और विश्वसनीयता की चर्चा है, और Jev Explained: Why This AI Model Makes Decisions Instead of Writing Answers ऊपर बताए गए decision model को समझाता है।
स्रोत और आगे पढ़ने के लिए
स्रोत समीक्षा: 5 अक्टूबर 2026।
- TypeSafe AI — Introducing System One Models & Jev. TypeSafe की early-access decision model की introduction और structured software decisions के लिए ख़ास तौर पर AI डिज़ाइन करने के पीछे का तर्क। 15 सितंबर 2026 को प्रकाशित। स्रोत में दिए गए performance आँकड़े vendor द्वारा बताए गए हैं।
- OpenAI — DevDay 2026 Recap: Decisions API. Classification, routing और पहले से तय विकल्पों में से कार्रवाई चुनने के लिए Decisions API का OpenAI का विवरण, जो 29 सितंबर 2026 को limited preview में था। उपलब्धता तब से बदल सकती है।
- Gartner — Gartner Predicts 70% of Enterprises Will Abandon Agentic AI Built by Vendor Forward-Deployed Engineering by 2028. Forward-deployed AI engineering का Gartner का विश्लेषण, जिसमें knowledge transfer, ownership, आंतरिक क्षमता और exit planning पर ज़ोर है। यह पूर्वानुमान vendor forward-deployed engineering के बारे में है, सभी enterprise AI के बारे में नहीं।
- TechiesJournal — When AI Does the Junior Work, Who Develops the Next Generation of Professionals?. पहले का एक Author Perspective, इस बारे में कि जब AI वह काम automate कर देता है जिससे पहले भविष्य के पेशेवरों की क्षमता विकसित होती थी, तो संगठनों को क्या खोने का जोखिम है।
- TechiesJournal — Building Agentic Systems: From Your First Agent to a Reliable System. agent की स्वायत्तता बढ़ने पर सीमाओं, विश्वसनीयता और operating विचारों की व्यावहारिक चर्चा।