

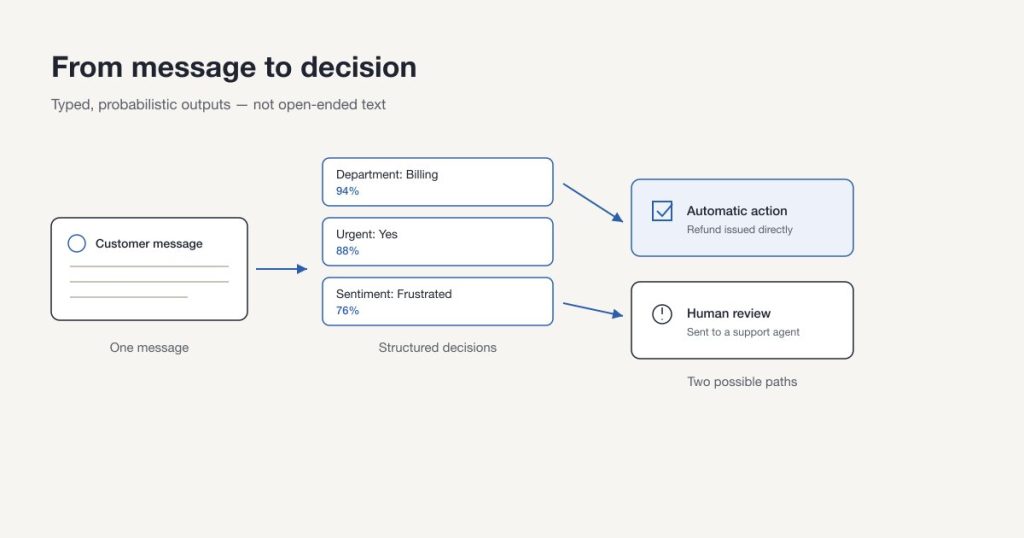
कल्पना कीजिए कि एक ग्राहक सपोर्ट टीम को यह संदेश भेजता है:
मेरा भुगतान दो बार कट गया है, और मुझे यह आज ही ठीक करवाना है।
इस आवेदन को जवाब लिखने के लिए किसी AI मॉडल की जरूरत नहीं होती। किसी के जवाब देने से पहले, सिस्टम को केवल यह तय करना होता है:
- यह संदेश किस टीम के पास जाना चाहिए?
- क्या यह मामला जरूरी है?
- ग्राहक कितना नाराज़ लग रहा है?
- क्या मॉडल इस केस को अपने-आप रूट करने के लिए पर्याप्त आश्वस्त है?
कई AI सिस्टम इस तरह के काम को एक बड़े लैंग्वेज मॉडल के पास भेजते हैं—वही तरह का मॉडल जो ईमेल लिखने, विचार समझाने और बातचीत करने के लिए बनाया गया है। यह मॉडल अपने फैसले को बताने के लिए एक पैराग्राफ या एक JSON ऑब्जेक्ट बना सकता है। फिर आवेदन को उस आउटपुट का उपयोग करने से पहले उसे वैलिडेट करना पड़ता है।
Jev, सितंबर 2026 में TypeSafe AI द्वारा जारी किया गया एक मॉडल, एक अलग सवाल से शुरू होता है: अगर सॉफ्टवेयर को सिर्फ एक फैसला चाहिए, तो किसी मॉडल से किसी इंसान के लिए जवाब बनवाने की जरूरत ही क्यों?
Jev खुले-सिरे वाला टेक्स्ट नहीं बनाता। यह किसी आवेदन द्वारा दी गई जानकारी का मूल्यांकन करता है और पहले से तय किए गए मानों को संभावनाओं (probabilities) के साथ लौटाता है। TypeSafe इस श्रेणी को System One model कहती है—यानी ऐसा मॉडल जो सॉफ्टवेयर के अंदर तेज़, संरचित फैसले लेने के लिए बनाया गया है। यह TypeSafe की अपनी शब्दावली है, कोई स्थापित इंडस्ट्री श्रेणी नहीं।
यह विचार आशाजनक है। इसे बढ़ा-चढ़ाकर पेश करना भी आसान है। Jev अनपेक्षित आउटपुट संरचनाओं को रोक सकता है, लेकिन फिर भी यह गलत फैसला ले सकता है। इसके सबसे मजबूत प्रदर्शन दावे फिलहाल TypeSafe के अपने मूल्यांकनों से आते हैं, और मॉडल के बारे में कई अहम जानकारियां अभी भी सार्वजनिक नहीं की गई हैं।
यह लेख बताता है कि Jev क्या बदलता है, क्या वैसा ही रहता है, और यह तरीका असली सिस्टम में कहां फिट बैठ सकता है—या नहीं बैठता।
समस्या हमेशा लिखने की नहीं होती
बड़े लैंग्वेज मॉडल इसलिए लचीले होते हैं क्योंकि वे टेक्स्ट को एक-एक टोकन करके बनाते हैं। इसी वजह से एक ही मॉडल बिलिंग की समस्या समझा सकता है, कोड लिख सकता है, किसी रिपोर्ट का सार बना सकता है या किसी सवाल का जवाब दे सकता है।
सॉफ्टवेयर ऑटोमेशन को अक्सर इससे कहीं संकुचित चीज़ चाहिए होती है। किसी आवेदन को एक रूट चुनना पड़ सकता है, एक स्कोर तय करना पड़ सकता है, यह तय करना पड़ सकता है कि किसी ऑपरेशन को दोबारा कोशिश करनी है या नहीं, या यह तय करना पड़ सकता है कि कब किसी इंसान को कमान संभालनी चाहिए। यहां जरूरी उत्पाद एक पैराग्राफ नहीं है। जरूरी है फैसला।
डेवलपर पहले से ही किसी LLM से JSON लौटाने के लिए कह सकते हैं या संरचित-आउटपुट फीचर इस्तेमाल कर सकते हैं। इससे इंटरफेस बेहतर होता है, लेकिन अंदर का मॉडल अब भी एक सीक्वेंस बनाने के इर्द-गिर्द ही बना होता है। इसमें एक संकुचित फैसले की तुलना में ज्यादा समय और कंप्यूटेशन लग सकता है।
TypeSafe की दलील है कि मशीन-से-मशीन फैसलों के लिए शुरुआत से ही उनके इर्द-गिर्द डिज़ाइन किया गया एक मॉडल होना चाहिए। कंपनी Jev को ऐसा बताती है जो असंरचित या संरचित स्थिति (state) स्वीकार करता है और टाइप्ड, प्रोबैबिलिस्टिक फैसले लौटाता है जिन्हें कोड सीधे इस्तेमाल कर सकता है। यह उत्पाद के उद्देश्य की TypeSafe की अपनी परिभाषा है (वेंडर का दावा), कोई स्वतंत्र रूप से स्थापित निष्कर्ष नहीं।
इससे बातचीत करने वाले मॉडल अनावश्यक नहीं हो जाते। यह अक्सर एक साथ जोड़े गए दो कामों को अलग करता है:
- किसी अनिश्चित स्थिति को समझना।
- उस नतीजे को इंसानी भाषा में व्यक्त करना।
Jev पहले काम पर केंद्रित है।
Jev रिक्वेस्ट कैसे काम करती है
TypeSafe API दस्तावेज़ के अनुसार (दस्तावेज़ीकृत, 23 सितंबर 2026 को फिर से सत्यापित), एक आवेदन तीन मुख्य तत्व भेजता है:
- State: मूल्यांकन करने के लिए जानकारी। यह टेक्स्ट, ऑब्जेक्ट या ऐरे हो सकती है।
- Questions: वे फैसले जो आवेदन मॉडल से लेना चाहता है।
- Criteria: स्वीकार्य जवाब या इस्तेमाल किए जा रहे स्केल का अर्थ।
Jev फिलहाल तीन तरह के सवालों का समर्थन करता है, लॉन्च के बाद से अपरिवर्तित:
| सवाल का प्रकार | सरल अर्थ | उदाहरण |
|---|---|---|
Choice | आवेदन द्वारा तय की गई सूची में से एक विकल्प चुनना (255 विकल्पों तक) | Billing, Technical या Sales |
Score | किसी चीज़ को क्रमबद्ध स्तरों के सेट पर आंकना (2–10 स्तर) | Calm, Frustrated या Very angry |
Noul | यह अनुमान लगाना कि हां/नहीं वाला कोई कथन सच होने की कितनी संभावना है | क्या यह जरूरी है? |
सपोर्ट संदेश के लिए, एक उदाहरणात्मक रिक्वेस्ट में Jev से एक डिपार्टमेंट चुनने, तात्कालिकता का आकलन करने और नाराज़गी को स्कोर करने के लिए कहा जा सकता है। जवाब सैद्धांतिक रूप से कुछ इस तरह दिख सकता है:
| फैसला | उदाहरणात्मक नतीजा |
|---|---|
| डिपार्टमेंट | Billing — 94% |
| जरूरी | Yes — 88% |
| नाराज़गी | High — 76% |
ये आंकड़े काल्पनिक हैं और सिर्फ इंटरफेस समझाने के लिए हैं; ये मापे गए Jev नतीजे नहीं हैं।
आगे क्या होगा, इसका फैसला लेने की जिम्मेदारी अब भी आस-पास के आवेदन की ही रहती है। यह उच्च-आत्मविश्वास वाले मामलों को अपने-आप रूट कर सकता है, जबकि अनिश्चित या ज्यादा-परिणाम वाले मामलों को किसी इंसान के पास भेज सकता है।
आज़माकर देखें: संदेश से फैसले तक
नीचे कोई अलग काल्पनिक सपोर्ट संदेश चुनें, यह देखने के लिए कि वही तीन सवाल अलग-अलग टाइप्ड जवाब कैसे दे सकते हैं। इस एक्सप्लोरर में मौजूद सारी सामग्री इसी पेज तक सीमित और काल्पनिक है—कोई भी संदेश TypeSafe या किसी अन्य सेवा को नहीं भेजा जाता।
State (संदेश): “मेरा भुगतान दो बार कट गया है, और मुझे यह आज ही ठीक करवाना है।”
- यह संदेश किस टीम के पास जाना चाहिए? (Choice) — Billing, 94%
- क्या यह जरूरी है? (Noul) — Yes, 88%
- ग्राहक कितना नाराज़ लग रहा है? (Score) — High, 76%
उदाहरणात्मक थ्रेशोल्ड नतीजा: तीनों सवालों पर आत्मविश्वास आवेदन द्वारा तय थ्रेशोल्ड से ऊपर है, इसलिए यह काल्पनिक उदाहरण अपने-आप Billing के पास जरूरी मामले के रूप में रूट हो जाता है।
State (संदेश): “मैं आज सुबह से लॉगिन नहीं कर पा रहा हूं और एक घंटे में मेरी क्लाइंट कॉल है।”
- यह संदेश किस टीम के पास जाना चाहिए? (Choice) — Technical, 81%
- क्या यह जरूरी है? (Noul) — Yes, 62%
- ग्राहक कितना नाराज़ लग रहा है? (Score) — Frustrated, 58%
उदाहरणात्मक थ्रेशोल्ड नतीजा: तात्कालिकता का आत्मविश्वास आवेदन द्वारा तय मध्य सीमा में आता है, इसलिए यह काल्पनिक उदाहरण अपने-आप हल होने के बजाय किसी इंसान के पास भेजा जाता है।
State (संदेश): “अच्छा होगा अगर ऐप रिपोर्ट को CSV के रूप में एक्सपोर्ट कर सके, कोई जल्दी नहीं है।”
- यह संदेश किस टीम के पास जाना चाहिए? (Choice) — Product, 90%
- क्या यह जरूरी है? (Noul) — No, 95%
- ग्राहक कितना नाराज़ लग रहा है? (Score) — Calm, 97%
उदाहरणात्मक थ्रेशोल्ड नतीजा: तीनों जवाब उच्च-आत्मविश्वास और कम-परिणाम वाले हैं, इसलिए यह काल्पनिक उदाहरण बिना किसी इंसानी समीक्षा के अपने-आप एक प्रोडक्ट बैकलॉग में रूट हो जाता है।
काल्पनिक इंटरैक्टिव उदाहरण। यहां दिखाया गया हर संदेश, सवाल और संभावना उदाहरणात्मक है और इसी लेख के लिए लिखा गया है—इनमें से कोई भी मापा गया Jev नतीजा नहीं है, और आपके द्वारा चुनी गई कोई भी चीज़ कहीं नहीं भेजी जाती।
TypeSafe को यह तेज़ और सस्ता होने की उम्मीद क्यों है
एक पारंपरिक जनरेटिव मॉडल आम तौर पर आउटपुट को क्रमवार बनाता है। हर नया टोकन उससे पहले बनाए गए टोकनों पर निर्भर करता है। इसलिए लंबे जवाबों के लिए बार-बार जनरेशन के चरण चाहिए होते हैं।
Jev खुले-सिरे वाली स्ट्रिंग जनरेशन को छोड़ देता है। TypeSafe का कहना है कि उसका मॉडल कई सवालों का मूल्यांकन एक साथ (parallel में) करता है और केवल वही संरचित मान लौटाता है जो आवेदन ने मांगे हैं। टेक्स्ट जनरेशन हटाने से, जब किसी वर्कफ़्लो में बहुत सारे छोटे फैसले होते हैं, तो लेटेंसी और लागत कम हो सकती है।
23 सितंबर 2026 को किए गए सोर्स रिव्यू के अनुसार, TypeSafe ने $0.042 प्रति मिलियन टोकन की इनपुट प्राइसिंग का विज्ञापन किया, जबकि आउटपुट को अपनी ही लॉन्च पोस्ट में “too cheap to meter” बताया गया। कंपनी ने लगभग 70 से 500 मिलीसेकंड के एंड-टू-एंड रिस्पॉन्स टाइम की रिपोर्ट दी और अपने चुने हुए वर्कफ़्लो पर फ्रंटियर LLM की तुलना में स्पीड में करीब 193.6× और लागत में 444.6× की बढ़त का दावा किया।
ये वेंडर-रिपोर्टेड दावे हैं, कोई स्थापित स्वतंत्र माप नहीं। TypeSafe खुद अपने लॉन्च एविडेंस में कुछ अहम सीमाओं को स्वीकार करती है:
- ये वर्कफ़्लो कंपनी की अपनी मॉडल-क्षमता टीम के सदस्यों ने बनाए थे।
- इससे चयन या डिज़ाइन पक्षपात की संभावना बनती है।
- सबसे बड़े रिपोर्ट किए गए फायदे असली दुनिया में मिलने वाले सुधार के उच्चतम स्तर को दर्शा सकते हैं।
- कुछ रेफरेंस जवाब स्वतंत्र रूप से स्थापित सच्चाई के बजाय बड़े बाहरी मॉडलों के औसत अनुमानों से आए थे।
- आज कम प्राइसिंग देखी जा सकती है, लेकिन इसकी दीर्घकालिक स्थिरता अभी साबित नहीं हुई है।
सोर्स रिव्यू के अनुसार, Jev बिना किसी वेटलिस्ट के उपलब्ध है: साइन-अप TypeSafe के डेवलपर कंसोल पर सेल्फ-सर्विस है, और नए अकाउंट के लिए थोड़ा मुफ्त टोकन भत्ता मिलता है। इससे इसे आज़माना आसान हो जाता है, लेकिन उपलब्धता सटीकता का सबूत नहीं है।
स्पीड और लागत अब भी Jev को टेस्ट करने के सार्थक कारण हैं। लेकिन ये स्वतंत्र मूल्यांकन को छोड़ देने के कारण नहीं हैं।
कैलिब्रेटेड प्रोबेबिलिटी का असल मतलब क्या है
हर मॉडल किसी जवाब के साथ एक नंबर जोड़ सकता है। मुश्किल सवाल यह है कि क्या उस नंबर पर भरोसा किया जाना चाहिए।
मान लीजिए कि कोई मॉडल सैकड़ों भविष्यवाणियां करता है और हर एक को लगभग 80% प्रोबेबिलिटी देता है। अगर मॉडल अच्छी तरह कैलिब्रेट किया गया है, तो उन भविष्यवाणियों में से लगभग 80% सही साबित होनी चाहिए। इस सांख्यिकीय संबंध को कैलिब्रेशन कहा जाता है।
कैलिब्रेशन यह गारंटी नहीं देता कि कोई खास फैसला सही है। यह किसी सिस्टम को कई फैसलों में उपयोगी नीतियां तय करने में मदद करता है। उदाहरण के लिए:
- टेस्ट किए गए आत्मविश्वास थ्रेशोल्ड से ऊपर अपने-आप कार्रवाई करें।
- मध्य सीमा में किसी बड़े मॉडल से दूसरी राय लें।
- कम-आत्मविश्वास या ज्यादा-परिणाम वाले मामलों को किसी इंसान के पास भेजें।
TypeSafe का कहना है कि वह Jev को Reinforcement Learning for Calibrated Decisions, यानी RLCD का उपयोग करके प्रशिक्षित करती है। इसका मशीन-लर्निंग प्राइमर (दस्तावेज़ीकृत, 23 सितंबर 2026 को फिर से सत्यापित) इस उद्देश्य को ऐसे फैसले बनाने के रूप में बताता है जिनकी संभावनाएं देखी गई सटीकता से मेल खाती हों।
इस दावे का मूल्यांकन उसी वातावरण में करना होगा जहां मॉडल काम करेगा। एक डेटासेट पर कैलिब्रेट किया गया मॉडल भाषा, ग्राहक, नीतियां या हमले के पैटर्न बदलने पर अविश्वसनीय हो सकता है। कैलिब्रेशन कोई स्थायी गुण नहीं है जिसे हर क्षेत्र में मान लिया जाए।
क्या Jev वाकई हैलुसिनेशन को खत्म कर देता है?
TypeSafe का कहना है कि Jev हैलुसिनेट नहीं कर सकता। इस बयान को एक संकुचित अर्थ में समझने की जरूरत है।
अगर कोई आवेदन केवल Billing, Technical और Sales की इजाजत देता है, तो Jev चौथा मान जैसे Legal गढ़ नहीं सकता। यह स्वीकृत टाइप की जगह कोई पैराग्राफ, कोई अनजाना फील्ड या कोई बिगड़ा हुआ जवाब नहीं लौटा सकता। जब AI का आउटपुट किसी सॉफ्टवेयर वर्कफ़्लो के अंदर दबा होता है, तो यह एक अहम विफलता को हटा देता है।
यह साबित नहीं करता कि चुना गया मान सही है। Jev अब भी यह कर सकता है:
- किसी तकनीकी समस्या को Billing के पास भेज सकता है।
- किसी अस्पष्ट संदेश को गलत समझ सकता है।
- किसी नए क्षेत्र में असली सटीकता से मेल न खाने वाला आत्मविश्वास दे सकता है।
- अपने प्रशिक्षण या मूल्यांकन डेटा में मौजूद पक्षपात दोहरा सकता है।
- जब स्वीकृत विकल्पों में से कोई भी सही न हो, तो सबसे कम गलत विकल्प चुन सकता है।
अंतर सीधा है:
स्कीमा-वैध जवाब का मतलब हमेशा सही फैसला नहीं होता।
टाइप सेफ्टी यह नियंत्रित करती है कि जवाब किस रूप में हो सकता है। विश्वसनीयता मॉडल, सवाल, स्वीकृत विकल्पों, डेटा, थ्रेशोल्ड और गलती के परिणामों पर निर्भर करती है।
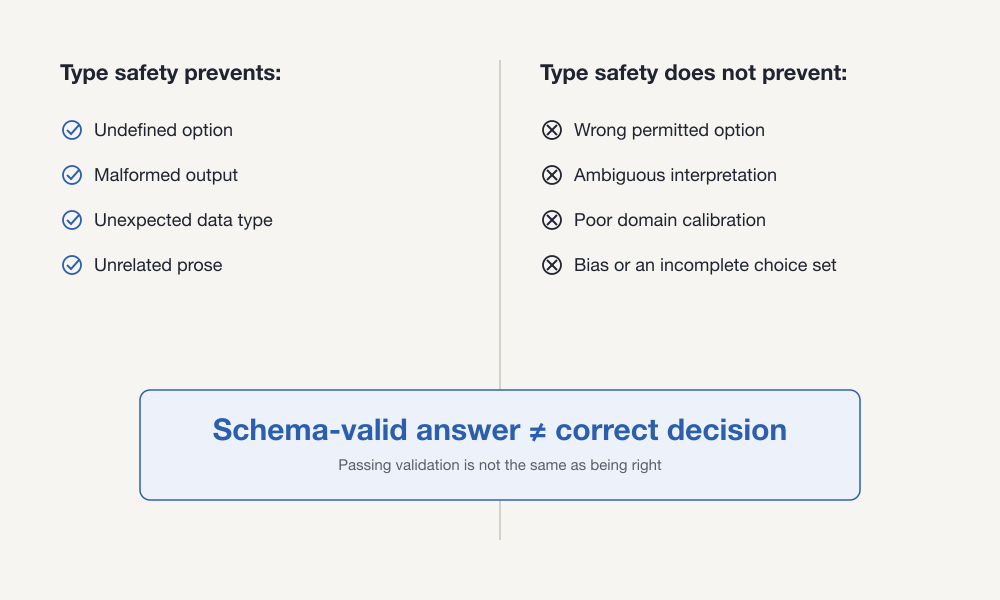
टेक्स्ट समकक्ष—टाइप सेफ्टी जो रोकती है: एक अपरिभाषित विकल्प, बिगड़ा हुआ आउटपुट, एक अनपेक्षित डेटा टाइप, असंबंधित गद्य। यह जो नहीं रोकती: एक गलत स्वीकृत विकल्प, एक अस्पष्ट व्याख्या, कमज़ोर डोमेन कैलिब्रेशन, या पक्षपात और अधूरा विकल्प-सेट।
क्या Jev सच में एक बिल्कुल नई तरह का मॉडल है?
जिस समस्या को Jev हल करता है, वह नई नहीं है। सॉफ्टवेयर लंबे समय से फैसले लेने के लिए क्लासिफायर, रीरैंकर, पॉलिसी नेटवर्क, रिवॉर्ड मॉडल और बिज़नेस नियमों का इस्तेमाल करता आया है। जनरेटिव मॉडल भी संरचित आउटपुट लौटा सकते हैं या दूसरे मॉडलों के जज के रूप में काम कर सकते हैं।
ज्यादा तर्कसंगत नयापन खुद क्लासिफिकेशन के अस्तित्व में नहीं बल्कि पूरे पैकेज में है। Jev इन्हें जोड़ता है:
- व्यापक भाषा समझ।
- ऐसे विकल्प जो रिक्वेस्ट के समय तय होते हैं, न कि स्थायी रूप से तय किया गया लेबल-सेट।
- टाइप्ड आउटपुट।
- प्रोबेबिलिटी डिस्ट्रिब्यूशन।
- एक साथ (parallel में) मूल्यांकन किए गए कई फैसले।
- सामान्य कोड के भीतर जोड़ने के लिए बनाया गया API।
एक शुरुआती स्वतंत्र शोध उदाहरण इसलिए उपयोगी है क्योंकि यह सावधान है। सितंबर 2026 के पेपर Open-Jev Judgments on CallScreenBench (Ren et al., 21 सितंबर 2026 को प्रस्तुत) ने स्कैम-कॉल स्क्रीनिंग के लिए एक ओपन Jev-शैली के इम्प्लीमेंटेशन को टेस्ट किया। इसने अपने मूल्यांकन में मज़बूत विभेदन (discrimination) और कैलिब्रेशन की रिपोर्ट दी, साथ ही उसी बैकबोन के जनरेटिव संस्करण की तुलना में कम लेटेंसी की भी। लेखकों ने यह भी बताया कि यह फायदा सटीकता में सुधार से नहीं बल्कि रीडआउट और कैलिब्रेशन से आया, उन्होंने किसी आर्किटेक्चरल नयेपन का दावा नहीं किया, सिंथेटिक कॉलर्स का इस्तेमाल किया, और स्वीकार किया कि उनका रेसिपी टेस्ट-सेट एक्सपोज़र के साथ चुना गया था।
यह TypeSafe के प्रोप्राइटरी मॉडल को मान्य नहीं करता। यह बताता है कि यह व्यापक डिज़ाइन पैटर्न जांच के लायक है, बिना यह साबित किए कि कोई नई मूलभूत श्रेणी स्थापित हो चुकी है।
Jev कहां फिट बैठ सकता है
Jev तब सबसे प्रासंगिक लगता है जब किसी सिस्टम को भाषा या संरचित आवेदन-स्थिति पर आधारित बहुत सारे तेज़, सीमित फैसले चाहिए होते हैं।
संभावित उपयोगों में शामिल हैं:
- सपोर्ट रिक्वेस्ट को रूट करना।
- किसी AI एजेंट में अगला टूल चुनना।
- यह तय करना कि किसी ऑपरेशन को दोबारा कोशिश करनी चाहिए या नहीं।
- तात्कालिकता, जोखिम, गुणवत्ता या नीति-अनुपालन को स्कोर करना।
- किसी एजेंट के ट्रेस या आउटपुट का मूल्यांकन करना।
- रिकॉर्ड्स के बड़े संग्रहों को वर्गीकृत करना।
- किसी रीयल-टाइम आवेदन में मान्य कार्रवाइयों में से चुनना।
परिणाम मायने रखते हैं। किसी ईमेल का गलत रूटिंग आमतौर पर सुधारी जा सकती है। किसी अकाउंट को ब्लॉक करना, रिफंड को नकारना, धोखाधड़ी की पहचान करना या किसी वित्तीय कार्रवाई को अधिकृत करना कहीं मज़बूत सबूत, निगरानी, ऑडिट ट्रेल और एक सार्थक अपील प्रक्रिया की मांग करता है।
Jev की तुलना आसान विकल्पों से भी करनी चाहिए। अगर कोई फैसला सटीक शर्तों का पालन करता है, तो सामान्य कोड ज्यादा अनुमानित (predictable) होता है। अगर श्रेणियां स्थिर हैं और पर्याप्त लेबल किया गया डेटा मौजूद है, तो एक पारंपरिक क्लासिफायर संभालना और चलाना आसान हो सकता है। अगर काम को स्पष्टीकरण, संश्लेषण या ऐसे जवाब की जरूरत है जिसे पहले से सूचीबद्ध नहीं किया जा सकता, तो एक जनरेटिव मॉडल बेहतर फिट रहता है।
आज़माकर देखें: कौन-सा तरीका फैसले पर फिट बैठता है?
कोई परिदृश्य चुनें यह तुलना करने के लिए कि एक निर्धारक नियम (deterministic rule), एक पारंपरिक क्लासिफायर, एक Jev-शैली का फैसला मॉडल और एक जनरेटिव LLM उस पर कैसे फिट बैठते हैं—और हर एक कहां सबसे कमज़ोर है। नीचे दिए हर परिदृश्य के लिए Jev सबसे अच्छा विकल्प नहीं है।
सबसे अच्छा फिट: निर्धारक बिज़नेस नियम। शर्त सटीक है और पहले से मालूम है (उदाहरण के लिए, एक तय खर्च सीमा), इसलिए सामान्य कोड किसी भी मॉडल से ज्यादा अनुमानित और ऑडिट करने योग्य है। एक क्लासिफायर या Jev-शैली मॉडल ऐसी अनिश्चितता जोड़ देता है जिसकी एक तय नियम को जरूरत नहीं है; यहां एक जनरेटिव LLM बेवजह का बोझ है।
अक्सर अच्छा फिट: एक Jev-शैली का फैसला मॉडल या एक पारंपरिक क्लासिफायर। श्रेणियां काफी हद तक स्थिर हैं और इनपुट उलझी हुई भाषा है, जो टाइप्ड, प्रोबेबिलिस्टिक आउटपुट के लिए उपयुक्त है। अगर लेबल किया गया डेटा और एक तय श्रेणी-सेट पहले से मौजूद है तो एक क्लासिफायर भी उतना ही अच्छा काम कर सकता है; एक निर्धारक नियम अस्पष्ट शब्दों से जूझता है, और एक जनरेटिव LLM आमतौर पर जरूरत से ज्यादा धीमा और महंगा होता है।
सबसे अच्छा फिट: एक जनरेटिव LLM। इस काम में ऐसा स्पष्टीकरण गढ़ना है जिसे पहले से एक तय विकल्प-सेट के रूप में सूचीबद्ध नहीं किया जा सकता। निर्धारक नियम, क्लासिफायर और Jev-शैली के मॉडल पहले से तय नतीजों के इर्द-गिर्द बने होते हैं, इसलिए इनमें से कोई भी खुले-सिरे वाला गद्य नहीं बना सकता।
परिणामकारी; एक से ज्यादा संकेत चाहिए। एक Jev-शैली मॉडल या क्लासिफायर एक कैलिब्रेटेड जोखिम स्कोर दे सकता है, लेकिन गलत फैसले की ऊंची कीमत का मतलब है कि नतीजे को निगरानी और अपील प्रक्रिया वाली एक व्यापक समीक्षा प्रक्रिया में फीड होना चाहिए—अकेले काम नहीं करना चाहिए। बदलते धोखाधड़ी पैटर्न के लिए अकेला कठोर नियम आमतौर पर बहुत भंगुर होता है, और इस परिणाम-स्तर पर एक जनरेटिव LLM के फ्री-टेक्स्ट आउटपुट को ऑडिट करना ज्यादा मुश्किल है।
संभावित फिट: एक Jev-शैली का फैसला मॉडल। पहले से तय टूल-सेट में से चुनना संरचनात्मक रूप से एक Choice सवाल जैसा है, और टेक्स्ट बनाए बिना ऐसा करने से एजेंट की लेटेंसी घट सकती है। अगर टूल-सेट शायद ही कभी बदलता है तो एक क्लासिफायर भी काम कर सकता है; एक जनरेटिव LLM तब उपयोगी रहता है जब एजेंट को ऐसे टूल-सेट के बारे में तर्क करना हो जो पहले से तय नहीं है।
गुणात्मक, संपादकीय रूप से लिखी गई तुलनाएं—बेंचमार्क स्कोर नहीं। नीचे दी गई तालिका यही तुलना स्थिर रूप में है।
| तरीका | सबसे अच्छा फिट | अहम सीमा |
|---|---|---|
| निर्धारक बिज़नेस नियम | जाने-पहचाने नतीजों वाली सटीक शर्तें | जब अर्थ उलझी हुई भाषा या संदर्भ पर निर्भर करता है तो भंगुर हो जाता है |
| पारंपरिक क्लासिफायर | उपयुक्त प्रशिक्षण डेटा द्वारा समर्थित स्थिर श्रेणियां | आमतौर पर एक तय काम और बनाए रखा गया लेबल डेटा चाहिए |
| Jev-शैली का फैसला मॉडल | पहले से तय विकल्पों में भाषा-आधारित लचीले फैसले | प्रोप्राइटरी व्यवहार और डोमेन विश्वसनीयता को टेस्ट करना जरूरी है |
| जनरेटिव LLM | खुले-सिरे वाला तर्क, स्पष्टीकरण या सामग्री निर्माण | संकुचित फैसलों के लिए आमतौर पर धीमा, महंगा और कम सीमित |
अब भी क्या अज्ञात है
TypeSafe ने कई अहम क्षेत्रों की स्वतंत्र रूप से जांच करने लायक पर्याप्त जानकारी सार्वजनिक नहीं की है:
- Jev की पैरामीटर संख्या।
- इसका सटीक आर्किटेक्चर।
- क्या इसे शुरू से प्रशिक्षित किया गया या किसी अन्य पूर्व-प्रशिक्षित मॉडल से अनुकूलित किया गया।
- प्रशिक्षण कंप्यूट और विस्तृत डेटा-निर्माण के तरीके।
- इसके सिंथेटिक प्रशिक्षण डेटा की पूरी संरचना।
- मॉडल वेट्स।
- व्यापक डोमेन-विशिष्ट कैलिब्रेशन नतीजे।
- पक्षपात, प्रतिकूल (adversarial) और सुरक्षा मूल्यांकन।
- दीर्घकालिक प्राइसिंग स्थिरता।
- असली प्रोडक्शन डिस्ट्रिब्यूशन में बदलाव के दौरान विश्वसनीयता।
यह मॉडल प्रोप्राइटरी है, और इस रिव्यू तक TypeSafe ने Jev के लिए कोई पूरा स्वतंत्र तकनीकी पेपर या मॉडल कार्ड प्रकाशित नहीं किया है। ये कमियां यह नहीं दिखातीं कि दावे झूठे हैं। ये बस यह सीमित करती हैं कि बाहरी लोग कितने भरोसे के साथ इनका मूल्यांकन कर सकते हैं।
Jev के पीछे के लोग और कंपनी
TypeSafe AI अपने टीम पेज पर तीन संस्थापकों की पहचान देती है:
- Diogo Almeida, CEO: TypeSafe का अपना टीम पेज उन्हें Google Brain में रहते हुए RLHF और InstructGPT के सह-आविष्कारक के रूप में श्रेय देता है; TechCrunch सहित मीडिया रिपोर्टें उन्हें OpenAI के पूर्व शोधकर्ता के रूप में भी बताती हैं जिनके काम ने ChatGPT के पीछे की इंस्ट्रक्शन-फॉलोइंग पद्धतियों में योगदान दिया।
- Erik Gafni, CTO: एक बार-बार का संस्थापक जिसके पास प्रोडक्शन AI सिस्टम बनाने और बायोटेक्नोलॉजी में मल्टीमॉडल AI लागू करने का अनुभव है।
- Sasha Sheng, COO: Meta/FAIR की पूर्व शोध इंजीनियर, जिन्होंने प्रोडक्ट और AI शोध, दोनों क्षेत्रों में काम किया है।
कुछ हेडलाइनें Almeida को “ChatGPT का आविष्कारक” कहती हैं। यह शब्दावली एक बड़ी टीम द्वारा बनाए गए सिस्टम का बहुत सारा श्रेय एक ही शोधकर्ता को दे देती है। एक ज्यादा सटीक विवरण यह है कि उनके शोध ने उन इंस्ट्रक्शन-फॉलोइंग पद्धतियों में योगदान दिया जिन्होंने ChatGPT को संभव बनाने में मदद की।
बताया जाता है कि स्टील्थ से बाहर आते समय TypeSafe ने DCVC के नेतृत्व में $40 मिलियन का सीड राउंड जुटाया—इसकी पुष्टि किसी एक TypeSafe-प्रकाशित फंडिंग घोषणा से नहीं बल्कि कई स्वतंत्र रिपोर्टों से होती है। कम से कम एक मीडिया आउटलेट ने TypeSafe को करीब $200 मिलियन के पोस्ट-मनी वैल्यूएशन का श्रेय दिया है, लेकिन इसकी स्वतंत्र रूप से पुष्टि नहीं हुई है। फंडिंग कंपनी को उत्पाद विकसित और संचालित करने में मदद कर सकती है, लेकिन यह इस बात का सबूत नहीं है कि तकनीकी दावे सही हैं।
आपको कितना सीखना चाहिए?
ज्यादातर टेक्नोलॉजी पेशेवरों को आज Jev में महारत हासिल करने की जरूरत नहीं है।
जानें
डेवलपर, आर्किटेक्ट, तकनीकी नेताओं और AI को फॉलो करने वाले छात्रों को यह व्यापक विचार समझना चाहिए: हर बुद्धिमान सॉफ्टवेयर फैसले को खुले-सिरे वाले लैंग्वेज मॉडल जवाब की जरूरत नहीं होती।
इस्तेमाल करें
बड़े पैमाने पर AI एजेंट या फैसला-केंद्रित आवेदन बनाने वाली टीमें Jev को टेस्ट करना चाह सकती हैं। व्यावहारिक मूल्यांकन में डोमेन सटीकता, कैलिब्रेशन, लेटेंसी, लागत, फॉलबैक व्यवहार, डेटा हैंडलिंग और गलत फैसलों के परिचालन प्रभाव को शामिल करना चाहिए।
महारत हासिल करें
ऑटोमेटेड फैसला प्लेटफॉर्म डिज़ाइन करने वाले इंजीनियरों को कैलिब्रेशन, मूल्यांकन डेटासेट, डिस्ट्रिब्यूशन शिफ्ट, थ्रेशोल्ड नीतियों, ऑब्ज़र्वेबिलिटी, इंसानी एस्केलेशन और गवर्नेंस की गहरी समझ चाहिए। ये कौशल किसी एक वेंडर के API से परिचित होने से कहीं ज्यादा मायने रखते हैं।
छात्र और सामान्य IT पेशेवर फिलहाल Jev के आंतरिक इम्प्लीमेंटेशन को नज़रअंदाज़ कर सकते हैं। टिकाऊ सबक भाषा-निर्माण और सॉफ्टवेयर के फैसला लेने के बीच का यह अलगाव है।
“क्या Jev, LLM की जगह ले लेगा?” से बेहतर सवाल
Jev उन मॉडलों की जगह लेने के लिए नहीं बनाया गया है जो लिखते हैं, समझाते हैं, शोध करते हैं या खुले-सिरे वाली समस्याओं पर तर्क करते हैं। यह सॉफ्टवेयर के अंदर बैठने के लिए बनाया गया है, जहां आवेदन को पहले से पता होता है कि वह किस तरह के जवाब स्वीकार कर सकता है।
इसका लॉन्च एक उपयोगी आर्किटेक्चरल सवाल उठाता है:
जब सॉफ्टवेयर को स्पष्टीकरण की नहीं बल्कि फैसले की जरूरत है, तो किसी मॉडल को जवाब लिखने के लिए भुगतान क्यों करें?
Jev एक अहम जवाब साबित हो सकता है। इसे संरचित LLM आउटपुट, छोटे फाइन-ट्यून किए गए मॉडल और स्थापित क्लासिफिकेशन तरीकों से भी मुकाबला मिल सकता है। किसी नए मॉडल युग की घोषणा करने के लिए अभी सबूत बहुत जल्दी हैं।
जो बदला है वह है वह सवाल जो डेवलपर पूछ सकते हैं। हर अनिश्चित काम को बातचीत करने वाले मॉडल के पास भेजने के बजाय, वे तय कर सकते हैं कि इस काम को भाषा-निर्माण की जरूरत है भी या नहीं।
यह फैसला किसी एक मॉडल को लेकर आज के उत्साह से कहीं ज्यादा लंबे समय तक मायने रख सकता है।
संदर्भ और आगे पढ़ने के लिए
- Introducing System One Models & Jev — TypeSafe AI, 15 September 2026. आधिकारिक लॉन्च व्याख्या, प्रदर्शन दावे, मूल्यांकन डिज़ाइन और कंपनी की अपनी योग्यताएं।
- TypeSafe API reference — TypeSafe AI, reviewed 23 September 2026. रिक्वेस्ट फॉर्मेट, सवाल प्रिमिटिव, रिस्पॉन्स संरचनाएं और दस्तावेज़ीकृत सीमाएं।
- AI primer: calibrated decisions and RLCD — TypeSafe AI, reviewed 23 September 2026. कंपनी की अपने प्रशिक्षण उद्देश्य और कैलिब्रेशन की व्याख्या की समझाइश।
- TypeSafe team — TypeSafe AI, reviewed 23 September 2026. Diogo Almeida, Erik Gafni और Sasha Sheng की आधिकारिक जीवनियां।
- Open-Jev Judgments on CallScreenBench — Ren et al., 21 September 2026. एक स्वतंत्र Jev-शैली का इम्प्लीमेंटेशन, जिसके उपयोगी नतीजे और असामान्य रूप से स्पष्ट सीमाएं हैं; यह TypeSafe के प्रोप्राइटरी Jev मॉडल का मूल्यांकन नहीं करता।
- A new kind of AI model from a ChatGPT inventor is thrilling developers — TechCrunch, 18 September 2026. कंपनी, फंडिंग, लॉन्च और शुरुआती डेवलपर दिलचस्पी पर रिपोर्टिंग।
- What is Jev, an AI “generalist” model with a new take on decision-making? — The Indian Express, updated 23 September 2026. मॉडल, सार्वजनिक उपलब्धता और शुरुआती इंटीग्रेशन का एक सामान्य विवरण।