

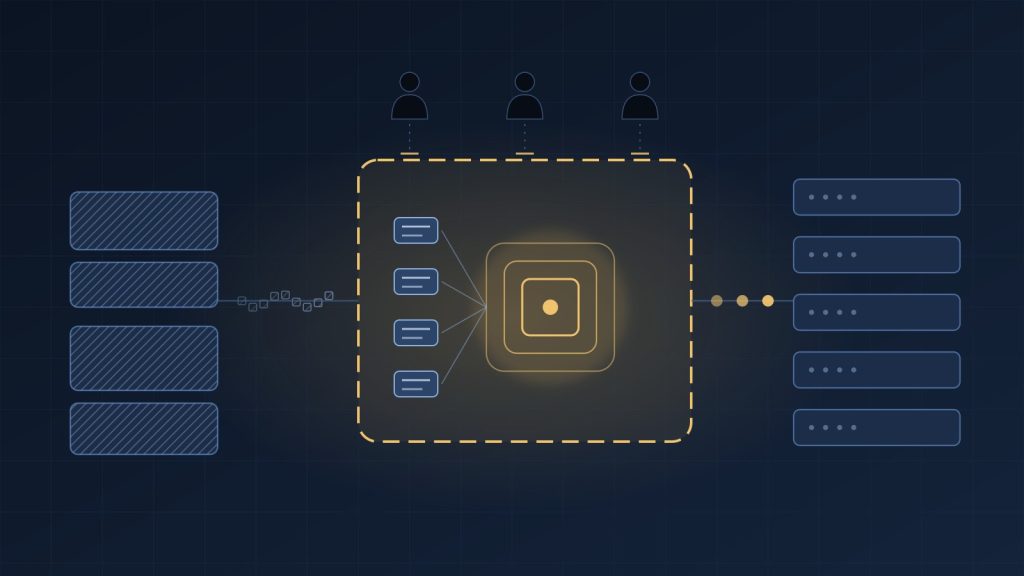
Cloud AI నుండి enterprises రెండు విషయాలను కోరుకుంటాయి, అవి పరస్పర విరుద్ధ దిశల్లో లాగవచ్చు.
తీవ్రమైన దుర్వినియోగం నుండి platform ను AI provider రక్షించాలని అవి కోరుకుంటాయి.
అదే సమయంలో, సున్నితమైన business data ను provider retain చేయకూడదని, చదవకూడదని కూడా కోరుకుంటాయి.
AI systems ఎక్కువసేపు సాగే పనులను చేపట్టే కొద్దీ ఈ రెండు అవసరాలను సమన్వయం చేయడం మరింత కష్టమవుతుంది.
ఒక్క request చూడటానికి హానిరహితంగా ఉండవచ్చు.
కానీ requests వరుసగా చూస్తే పూర్తిగా భిన్నమైనది బయటపడవచ్చు.
OpenAI Private Safety Processing ఆ సమస్యను పరిష్కరించే ప్రయత్నం.
ఈ ఆలోచనను చెప్పడం సులభం:
OpenAI సిబ్బందికి అంతర్లీన customer content కు access ఇవ్వకుండానే, interactions అంతటా ఉన్న patterns ను automated safety systems పరిశీలించడానికి అనుమతించడం.
ఆ ఆలోచన వెనుక ఉన్న architecture మరింత ఆసక్తికరమైనది.
Zero Data Retention ఎందుకు కష్టమవుతుంది
OpenAI ఇప్పటికే అర్హత ఉన్న API customers కు Zero Data Retention (ZDR) ను అందిస్తోంది.
ZDR తో, processing తర్వాత customer prompts, model responses retain చేయరని, customer స్పష్టంగా opt in అయితే తప్ప enterprise data ను model training కోసం ఉపయోగించరని OpenAI తెలిపింది.
వీటిని నిర్వహించే సంస్థలకు ఇది విలువైనది:
- ఆర్థిక సమాచారం
- ఆరోగ్య data
- గోప్యమైన business documents
- intellectual property
- proprietary research
కానీ safety systems కు సాధారణంగా retain చేసిన context వల్ల ప్రయోజనం కలుగుతూ వచ్చింది.
ఒక request ను ఊహించండి:
“ఈ industrial control system ఎలా పనిచేస్తుంది?”
ఇది సక్రమమైనదే కావచ్చు.
తర్వాత మరొకటి:
“ఏ safety protections remote commands ను ఆపుతాయి?”
ఆ తర్వాత:
“alarms రాకుండా ఎవరైనా ఆ protections ను ఎలా bypass చేయగలరు?”
ఆ ప్రమాదం స్పష్టమయ్యేది interactions అన్నింటినీ కలిపి చూసినప్పుడు మాత్రమే కావచ్చు.
ప్రతి interaction వెంటనే మాయమైపోతే, sessions అంతటా safety analysis చేయడం చాలా కష్టమవుతుంది.
దీనివల్ల ఒక సంఘర్షణ ఏర్పడుతుంది:
privacy ఏమో తక్కువ retain చేయమంటుంది
అదే సమయంలో
safety కు ఎక్కువ context అవసరం కావచ్చు.
OpenAI సమాధానం: content ను customer నియంత్రణలో ఉంచడం
ZDR తో పాటు Private Safety Processing ఉపయోగిస్తే, ఎంపిక చేసిన records ను OpenAI నియంత్రణలోని చదవగలిగే storage లో కాకుండా customer-controlled cloud storage లో నిల్వ చేస్తారు.
OpenAI ప్రస్తుతం ఇలాంటి services ద్వారా customer storage కు మద్దతు ఇస్తోంది:
- AWS S3
- Azure Blob Storage
- Google Cloud Storage
ఆ records encrypted గా ఉంటాయి.
రక్షిత data ను access చేయడానికి అవసరమైన storage ను, key authorization ను customer నియంత్రిస్తారు.
OpenAI, customer content యొక్క చదవగలిగే కాపీని ఉంచుకోకుండా, operational metadata ను, రక్షిత record ఎక్కడ నిల్వ ఉందో చూపే reference ను మాత్రమే ఉంచుకుంటుంది.
ఇది సాధారణ trust model ను మారుస్తుంది.
ఈ విధానానికి బదులుగా:
సున్నితమైన content ను provider కు పంపడం → provider దాన్ని నిల్వ చేయడం → provider దాన్ని సమీక్షించడం
design ఇలా మారుతుంది:
customer encrypted content ను తన వద్దే ఉంచుకుంటారు → ఆమోదిత రక్షిత system దాన్ని తాత్కాలికంగా process చేస్తుంది → పరిమితమైన safety result రక్షిత environment నుండి బయటకు వస్తుంది
ఈ తేడాయే ప్రధానమైనది.
ఈ చిత్రం కోసం టెక్స్ట్ వివరణ
పక్కపక్కనే రెండు flows. ఉదాహరణగా చూపిన సంప్రదాయ model: customer content provider environment కు వెళ్తుంది, తర్వాత safety review జరుగుతుంది, provider ఆ content ను retain చేయవచ్చు లేదా సమీక్షించవచ్చు. OpenAI documentation ప్రకారం protected model: customer-controlled encrypted storage నుండి attested protected runtime కు వెళ్తుంది, తర్వాత automated safety analysis జరుగుతుంది, bounded safety signal మాత్రమే బయటకు వెళ్తుంది. వివరణాత్మక protected result encrypted గా customer-controlled storage కు తిరిగి వెళ్తుంది, దీన్ని చుక్కల return గీతతో చూపారు. protected boundary లోపలి రెండు steps ను dashed outlines తో గీసి, పేరు పెట్టారు. ప్రతి step కు text label ఉంది, కాబట్టి అర్థం రంగుపై ఆధారపడదు.
మనుషుల కంటే safety system ఎక్కువ చూడగలదు
ఈ architecture లో అత్యంత ఆసక్తికరమైన భాగం Safety Review Runtime.
ఇది hardware-attested computing environment అని, ఆమోదిత workload రక్షిత customer content ను decrypt చేయగలిగేలా, human operators చేయలేనివిధంగా దీన్ని రూపొందించారని OpenAI వివరిస్తోంది.
ఈ runtime automated safety review చేస్తుంది.
ముందే నిర్వచించిన safety signals, ఆమోదిత operational metadata మాత్రమే plaintext గా protected environment నుండి బయటకు వెళ్లడానికి అనుమతి ఉంది.
వివరణాత్మక results encrypted గానే ఉండి, customer-controlled storage కు తిరిగి వెళ్తాయి.
భావనాత్మకంగా:
Encrypted customer content
↓
Hardware-protected safety runtime
↓
Automated analysis
↓
Bounded safety signal
provider తెలుసుకోగలిగేది:
నిర్వచించిన ఒక తీవ్ర ప్రమాద వర్గం గుర్తించబడింది
కానీ అందుకోనిది:
customer పూర్తి సంభాషణ.
data encrypted అని చెప్పడం కంటే ఇది చాలా ఆసక్తికరమైన architecture.
ఈ చిత్రం కోసం టెక్స్ట్ వివరణ
మూడు zones. Zone 1, customer: protected storage ను కలిగి ఉంటారు, key authorization ను నియంత్రిస్తారు, retention, configuration ను నిర్వహిస్తారు. Zone 2, protected boundary లోపల ఉన్న protected runtime: చదవగలిగే content ను తాత్కాలికంగా process చేస్తుంది, ఆమోదిత safety workload ను నడుపుతుంది. Zone 3, provider operations: పరిమితమైన safety signals ను అందుకుంటుంది, సాధారణ protected processing సమయంలో పూర్తి చదవగలిగే customer content ను అందుకోకూడదు. Encrypted records customer నుండి protected runtime కు వెళ్తాయి, bounded safety signals runtime నుండి provider operations కు వెళ్తాయి. protected runtime ను dashed outline తో గీసి, boundary లోపల ఉందని పేరు పెట్టారు, కాబట్టి అర్థం రంగుపై ఆధారపడదు.
encryption ఒక్కటే ఈ సమస్యను పరిష్కరించదు
keys OpenAI వద్ద ఉండి, దాని ఉద్యోగులు records ను స్వేచ్ఛగా decrypt చేయగలిగితే, privacy boundary చాలా బలహీనపడుతుంది.
Private Safety Processing అనేక controls కలిసి పనిచేయడంపై ఆధారపడుతుంది:
- customer-controlled storage
- customer నిర్వహించే key authorization
- hardware attestation
- పరిమితం చేసిన workloads
- ముందే నిర్వచించిన output schemas
- human access పై పరిమితులు
ముఖ్యమైన విషయం కేవలం ఇది కాదు:
data encrypted గా ఉంది.
ముఖ్యమైన విషయం ఇది:
దాన్ని ఎవరు, ఏది decrypt చేయగలదో, ఏ processing జరగవచ్చో, ఆ తర్వాత ఏ సమాచారం బయటకు వెళ్లగలదో పరిమితం చేయడానికి system ప్రయత్నిస్తుంది.
ఇది సంప్రదాయ encrypted storage కంటే confidential computing architecture కు దగ్గరగా ఉంటుంది.
safety outputs ను ఉద్దేశపూర్వకంగానే పరిమితంగా ఉంచారు
మరొక ముఖ్యమైన అంశం output boundary.
protected runtime పూర్తి analysis ను గానీ, అసలు సంభాషణను గానీ OpenAI కు తిరిగి పంపకూడదు.
గుర్తించిన safety ఆందోళన రకాన్ని సూచించే, ముందే నిర్వచించిన, bounded signals ను అది పంపగలదు.
input processing రక్షితంగా ఉన్నా, output దశలో privacy కోల్పోవచ్చు, అందువల్ల ఇది ముఖ్యం.
అసలు document ను సాంకేతికంగా దాచినా, దానిలోని సున్నితమైన సమాచారమంతా ఉన్న వివరణాత్మక summary ను ఇచ్చే safety system ను ఊహించండి.
అప్పుడు encryption వల్ల సాధించేది చాలా తక్కువ.
కాబట్టి output ను పరిమితం చేయడం privacy architecture లో భాగం.
ఇది OpenAI కు మించి ఉపయోగపడే సూత్రం:
private computation system, inputs ను ఎవరు చదవగలరో మాత్రమే కాకుండా, దాని outputs ఏ సమాచారాన్ని బయటపెట్టగలవో కూడా నియంత్రించాలి.
Zero retention అంటే అక్షరాలా ప్రతిచోటా storage శూన్యం అని కాదు
పదజాలాన్ని జాగ్రత్తగా చూడాలి.
Private Safety Processing తో, ఎంపిక చేసిన రక్షిత records safety అవసరాల కోసం customer-controlled storage లో ఉండవచ్చు.
ఆ encrypted records ను customers కనీసం 30 రోజులు retain చేయాలని OpenAI ప్రస్తుత documentation నిర్దేశిస్తోంది.
కాబట్టి “Zero Data Retention” అంటే ఇది కాదు:
inference తర్వాత ఏ data కాపీ కూడా ఎక్కడా ఉండదు.
ZDR హామీ పరిధిలోకి వచ్చే, provider-controlled సాధారణ abuse-monitoring logs లో provider customer content ను retain చేయదని దాని అర్థం.
PSP విషయంలో, రక్షిత records అవసరమైన safety కాలావధి వరకు customer storage, key controls కింద ఉంటాయి.
ఈ తేడా security, compliance teams కు ముఖ్యమైనదిగా ఉండాలి.
customer కు బాధ్యత కూడా వస్తుంది
ఈ architecture customers కు ఎక్కువ నియంత్రణ ఇస్తుంది, కానీ పని తగ్గదు.
PSP తో ZDR ఉపయోగించే సంస్థలు వీటిని నిర్వహించే బాధ్యత వహిస్తాయి:
- storage configuration
- ప్రాంతీయ storage అవసరాలు
- encryption permissions
- key authorization
- retention lifecycle
- connectivity
- validation
- safety notices కు స్పందనలు
వీటిని customer బాధ్యతలుగా OpenAI తన documentation లో స్పష్టంగా పేర్కొంది.
అంటే Private Safety Processing, AI ని private గా మార్చే ఒక checkbox మాత్రమే కాదు.
ఇది operational security పై ఆధారపడాల్సిన అవసరాన్ని జోడిస్తుంది.
storage లేదా key configuration తప్పుగా ఉంటే, safety pipeline ఉద్దేశించినట్లు పనిచేయకపోవచ్చు.
Enterprise privacy కేవలం ఒప్పంద హామీగా కాకుండా, ఎక్కువగా architecture సమస్యగా మారుతోంది.
ఇంకా మినహాయింపులు ఉన్నాయి
“private” అనే పదాన్ని సంపూర్ణమైనదిగా అర్థం చేసుకోకూడదు.
బాలల లైంగిక దుర్వినియోగ సామగ్రిగా కనిపించే వాటితో సహా (apparent child sexual abuse material) చట్టపరమైన మినహాయింపులు ఉన్నాయని OpenAI పేర్కొంది. అలాంటి సందర్భాల్లో, చట్టం ప్రకారం చేయాల్సిన manual review, reporting కోసం flag చేసిన images ను ఇప్పటికీ retain చేయవచ్చు.
తీవ్ర ప్రమాదంపై దర్యాప్తు అవసరమైనప్పుడు, నిర్దిష్ట customers కు retention policies మారవచ్చని కూడా OpenAI విస్తృత data-control documentation వివరిస్తోంది, వర్తించే policy ను బట్టి notification అవసరాలు ఉంటాయి.
కాబట్టి సరైన అర్థం ఇది కాదు:
OpenAI దేన్నీ ఎప్పటికీ access చేయడం గానీ retain చేయడం గానీ సాధ్యం కాదు.
సరైన అర్థం:
నిర్వచించిన safety, చట్టపరమైన mechanisms ను కొనసాగిస్తూనే, customer నియంత్రణను గణనీయంగా బలపరిచేలా, రోజువారీ human access ను నిరోధించేలా ఈ architecture రూపొందించబడింది.
ఇవి చాలా భిన్నమైన claims.
agents నిరంతరం పనిచేసేవిగా మారే కొద్దీ ఇది ఎందుకు మరింత ముఖ్యం
AI విడివిడి prompts నుండి ఎక్కువకాలం నడిచే agents వైపు మారినప్పుడు ఈ సమస్య మరింత ముఖ్యమవుతుంది.
chatbot కొన్ని సంభాషణలను మాత్రమే process చేయవచ్చు.
agent ఇవి చేయగలదు:
- అంతర్గత systems ను access చేయడం
- code ను execute చేయడం
- గంటల తరబడి పనిచేయడం
- పదేపదే requests చేయడం
- బాహ్య services తో interact కావడం
- అసలు user request తర్వాత కూడా పని కొనసాగించడం
కాబట్టి safety signals ఒక్క prompt లో కాకుండా, మొత్తం task అంతటా బయటపడవచ్చు.
ఎక్కువసేపు సాగే agentic interactions, safety systems కు విస్తృత context అవసరమవడానికి ఒక కారణమని OpenAI స్పష్టంగా పేర్కొంది.
అంటే privacy architecture కూడా అభివృద్ధి చెందాలి.
ప్రతి request ను విడివిడిగా పరిశీలించడం ఇకపై సరిపోకపోవచ్చు.
కానీ మొత్తం enterprise workflows ను కేంద్రీకృతంగా retain చేయడం ఆమోదయోగ్యం కాకపోవచ్చు.
ఆ రెండు చివరల మధ్య ఉన్న స్థానాన్ని చేరుకోవడానికి Private Safety Processing చేస్తున్న ప్రయత్నం ఇది.
ఇది పూర్తిగా నిరూపితమైందా?
ఇంకా లేదు.
ఉద్దేశించిన architecture ను అర్థం చేసుకునేంత వివరంగా OpenAI technical documentation ఇప్పుడు ఉంది, కానీ security claims లో చాలావరకు ఇంకా ప్రధానంగా OpenAI సొంత claims.
ఈ system అనేక ముఖ్యమైన assumptions పై ఆధారపడుతుంది:
- hardware attestation ఉద్దేశించినట్లు పనిచేయడం
- ఆమోదిత workloads కు మాత్రమే decryption సామర్థ్యం అందడం
- key permissions సరిగ్గా configure అయి ఉండటం
- bounded outputs సున్నితమైన సమాచారాన్ని leak చేయకపోవడం
- operational metadata ఊహించని సమాచారాన్ని బయటపెట్టకపోవడం
- implementation, documented design కు సరిపోలడం
ఇవన్నీ స్వతంత్ర సాంకేతిక పరిశీలన ముఖ్యమయ్యే రంగాలు.
ఆగస్టులో OpenAI తొలిసారి Private Safety Processing ను ప్రకటించినప్పుడు, architecture ను ఇంకా వివరంగా ప్రచురించలేదని బయటి కవరేజీ సరిగ్గానే గుర్తించింది.
ఆ తర్వాత OpenAI implementation documentation ను గణనీయంగా ఎక్కువగా ప్రచురించింది.
ఇది పారదర్శకతను మెరుగుపరుస్తుంది.
కానీ vendor documentation స్వతంత్ర verification గా మారదు.
Private Inference సంగతి ఏమిటి?
DevDay 2026 లో, OpenAI Private Safety Processing ను Private Intelligence అని పిలిచే విస్తృత దిశ కింద ఉంచింది, Private Inference preview ను శరదృతువులో తీసుకురావాలని ప్రణాళిక వేసినట్లు తెలిపింది.
ఇది మరింత ముఖ్యమైనదిగా మారవచ్చు.
Private Safety Processing safety review మార్గాన్ని రక్షిస్తుంది.
Private Inference, model inference లోనే privacy ను పరిష్కరించే అవకాశం ఉంది.
కానీ దాని architecture ను బాధ్యతాయుతంగా వివరించడానికి తగినంత public technical documentation ఇంకా లేదు.
ఇంకా మిగిలిన ప్రశ్నలు:
- inference ఎక్కడ నడుస్తుంది?
- encryption keys ను ఎవరు నియంత్రిస్తారు?
- ఏ hardware trust mechanism ను ఉపయోగిస్తున్నారు?
- OpenAI operators memory ను పరిశీలించగలరా?
- customer data రక్షితంగా ఉన్నప్పుడు model ను ఎలా రక్షిస్తారు?
- స్వతంత్రంగా ఏది attest చేయవచ్చు?
- confidential inference వల్ల performance పై ఎంత భారం పడుతుంది?
ఆ వివరాలు ప్రచురించే వరకు, Private Inference ను సాంకేతిక నిర్ధారణగా కాకుండా, గమనించాల్సిన అంశంగానే ఉంచాలి.
నా దృక్కోణం: privacy, safety పరస్పర విరుద్ధ ఎంపికలు కానవసరం లేదు
Enterprise AI చర్చలు తరచుగా ఒక సరళమైన trade-off ను చూపిస్తాయి:
ఒకటి, safety కోసం provider కార్యకలాపాలను పరిశీలించవచ్చు
లేదా
customer data private గా ఉంటుంది.
Private Safety Processing మూడో architectural అవకాశాన్ని సూచిస్తోంది.
కఠినంగా నియంత్రించిన computing boundary లోపల, human operators చూడలేనిదాన్ని machines పరిశీలించడానికి అనుమతించడం.
పరిమితమైన safety signals మాత్రమే బయటకు వెళ్లనివ్వడం.
అంతర్లీన records ను customer storage, key controls కింద ఉంచడం.
ఇది trust అవసరాన్ని తొలగించదు.
customer ఇప్పటికీ వీటిని నమ్మాలి:
- hardware
- implementation
- attestation system
- safety workload
- provider enforcement mechanisms
కానీ ఇది ఆ trust ను ఎక్కడ ఉంచాలో మారుస్తుంది.
ఇదే మరింత ముఖ్యమైన పరిణామం కావచ్చు.
enterprise AI privacy భవిష్యత్తు, providers ఇచ్చే ఈ హామీపై ఆధారపడకపోవచ్చు:
“మేము చూడబోమని నమ్మండి.”
బదులుగా, ఈ విధంగా రూపొందించిన architectures పై ఎక్కువగా ఆధారపడవచ్చు:
సాధారణ operation సమయంలో provider సొంత సిబ్బంది కూడా చూడకుండా సాంకేతికంగా నిరోధించబడతారు.
ఆ architecture నమ్మదగినదని రుజువైతే, privacy, safety ను ఒకే switch కు రెండు చివరలుగా చూడాల్సిన అవసరం ఇకపై ఉండకపోవచ్చు.
అవి system లో భాగంగా రూపొందించిన వేర్వేరు controls గా మారవచ్చు.
మూలాలు
మూలాలు సమీక్షించిన తేదీ: 2 అక్టోబర్ 2026.
- OpenAI — Offering Zero Data Retention for Frontier Models. Private Safety Processing గురించి, అది పరిష్కరించడానికి రూపొందించిన privacy-versus-safety సమస్య గురించి OpenAI పరిచయం.
- OpenAI API — ZDR with Private Safety Processing. customer-controlled storage, protected safety runtime, bounded outputs, customer బాధ్యతలను వివరించే ప్రస్తుత technical documentation.
- OpenAI API — Data Controls in the OpenAI Platform. ప్రస్తుత retention policies, ZDR ప్రవర్తన, endpoint పరిమితులు, safety-retention మినహాయింపులు.
- OpenAI — DevDay 2026 Announcements. Private Intelligence ను, ప్రణాళికలో ఉన్న Private Inference preview ను పేర్కొనే DevDay సారాంశం.
- The Register — OpenAI Chases Anthropic’s Biz Customers with Zero Data Retention Pledge. safety monitoring, enterprise data-retention అవసరాల మధ్య ఉన్న ఘర్షణను ఎత్తిచూపిన తొలి స్వతంత్ర కవరేజీ.
- TechCrunch — OpenAI Seeks to One-Up Anthropic with New Customer Privacy Protections. enterprise privacy ఆందోళనలు, పోటీపడే safety-retention విధానాల గురించి స్వతంత్ర నేపథ్యం.