

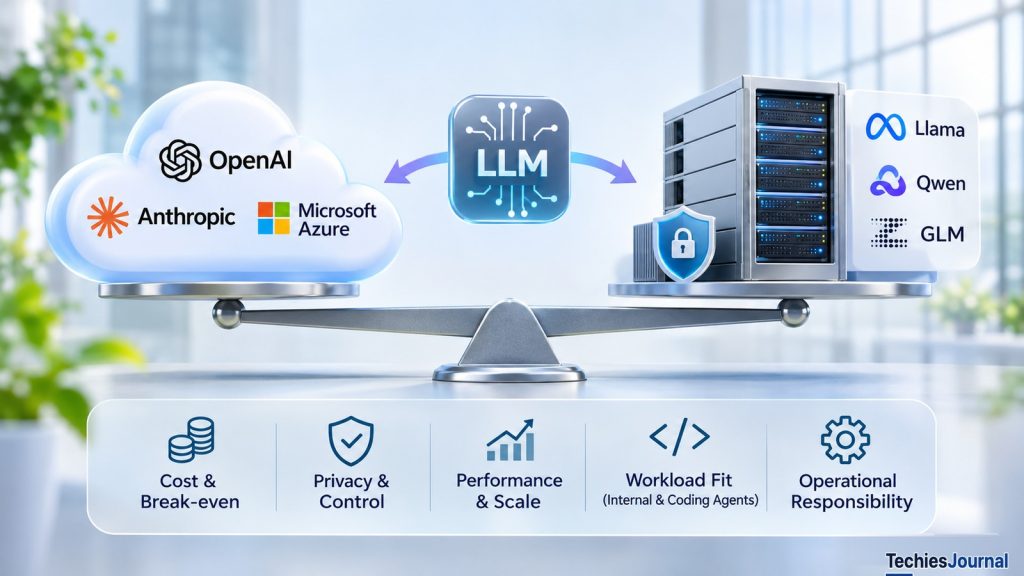
Ejecutar un modelo de lenguaje de pesos abiertos en una infraestructura privada promete más control sobre los datos, el comportamiento del modelo y los costos operativos. Pero ¿cuánto gana realmente una empresa? Dos cargas de trabajo prácticas, un agente de conocimiento interno y un agente de programación con IA, muestran por qué la capacidad del modelo, los costos de infraestructura y el trabajo que se realiza importan más que el lugar donde se ejecuta el modelo.
Una empresa quiere introducir un asistente de IA para sus empleados. El asistente debe buscar en la documentación interna, explicar procedimientos de resolución de problemas, resumir incidentes y ayudar al personal a resolver incidencias rutinarias.
El equipo de ingeniería se enfrenta a una elección. Puede usar un modelo alojado a través de una API y pagar la inferencia a medida que los empleados la usan. O puede desplegar un modelo de pesos abiertos en una infraestructura controlada por la empresa.
La segunda opción parece atractiva. La información sensible podría permanecer dentro de un entorno privado aprobado. El equipo podría conservar versiones concretas del modelo, ajustar la configuración de inferencia y evitar depender por completo de la API de un modelo comercial.
También está el argumento financiero. ¿Por qué seguir pagando por tokens si la empresa podría operar sus propias GPU?
Desde la perspectiva de la ingeniería de infraestructura, yo cuestionaría esa pregunta antes de aprobar cualquier gasto en hardware.
La pregunta da por hecho que una GPU y una suscripción a una API ofrecen una inteligencia equivalente. No es así. Una GPU aporta cómputo y memoria. La empresa sigue necesitando un modelo capaz de completar su trabajo, un runtime (entorno de ejecución) que atienda las solicitudes de forma eficiente e ingenieros que sepan operar el sistema.
La decisión debe empezar por lo que la aplicación necesita lograr, no por lo barato que la empresa puede alquilar una GPU.
La diferencia se ve con más claridad al examinar dos aplicaciones con requisitos muy distintos.
Un agente de conocimiento interno puede costar menos de lo esperado
Piensa en una empresa con 100 empleados. Cada empleado hace diez preguntas por día laborable a un agente de IA interno durante 22 días laborables.
Eso produce 22 000 interacciones al mes.
El asistente recupera información de la documentación de la empresa, resume el material relevante y genera una respuesta. Algunas preguntas pueden requerir una explicación breve, mientras que otras implican varios documentos y llamadas adicionales al modelo.
Supongamos que cada interacción completada consume una media de 6000 tokens de entrada y 1000 tokens de salida, incluidas las solicitudes repetidas al modelo.
Según el cálculo de TechiesJournal a partir de esos supuestos, la carga de trabajo mensual llega a 132 millones de tokens de entrada y 22 millones de tokens de salida.
Con las tarifas estándar publicadas de las API, los costos de inferencia del modelo serían:
| Modelo alojado | Costo mensual estimado |
|---|---|
| GPT-6 Luna | USD 24.20 |
| GPT-6.1 Sol | USD 484 |
| Claude Sonnet 5.5 | USD 484 |
| Claude Fable 5.2 | USD 1936 |
Cálculo ilustrativo con recuentos de tokens idénticos. Excluye la infraestructura de recuperación, las herramientas de pago, el procesamiento premium, los descuentos por caché y la revisión humana. No establece una calidad equivalente de los modelos ni el uso real de tokens entre proveedores. Las tarifas son tarifas del nivel estándar consultadas el 11 de noviembre de 2026. Se supone que cada interacción queda muy por debajo del umbral de 272 000 tokens de entrada a partir del cual OpenAI cobra más por los prompts, y Anthropic factura Claude Sonnet 5.5 y Claude Fable 5.2 a tarifas estándar en toda su ventana de contexto de 1M de tokens.
Fuentes: precios de la API de OpenAI y precios de la API de Anthropic.
La primera observación es importante. Según el modelo, la misma carga de trabajo supuesta puede producir una factura muy diferente.
Pero la tabla no es una clasificación de los mejores modelos para un agente interno.
Un modelo de bajo costo podría responder adecuadamente a preguntas sencillas sobre políticas internas y, aun así, tener dificultades con investigaciones de incidentes complejas. Un modelo más potente podría producir resultados más fiables, pero a un precio más alto. Los distintos tokenizadores, el comportamiento de razonamiento y los patrones de uso de herramientas también pueden cambiar el consumo real de tokens.
La pregunta relevante es si el modelo cumple los requisitos de aceptación de la aplicación.
Para este asistente interno, esos requisitos podrían incluir recuperar la información que el empleado está autorizado a ver, producir respuestas respaldadas por los documentos recuperados, reconocer cuándo falta información y responder en un tiempo aceptable.
El control de acceso debe aplicarse en la aplicación y en los sistemas de recuperación. No se debe esperar que un modelo de lenguaje haga cumplir los permisos de los documentos solo porque sus instrucciones le digan que los respete.
Si un modelo alojado de menor costo cumple los requisitos de forma constante, la empresa puede tener pocas razones financieras para operar su propia infraestructura de inferencia.
También podría enrutar las preguntas más exigentes a un modelo alojado más potente, aunque el enrutamiento introduce sus propias consideraciones de costo y calidad.
La elección del modelo puede cambiar sustancialmente la economía antes de que la organización cambie su modalidad de alojamiento.
Lo que cuesta ejecutar el modelo de forma privada
Supongamos que la empresa estudia un modelo de pesos abiertos en una GPU alquilada.
En lugar de pagar principalmente según el uso de tokens, paga por la capacidad de GPU que mantiene disponible.
Las tarifas publicadas de Runpod para Pods bajo demanda en Secure Cloud ofrecen una referencia útil:
| GPU (VRAM) | Tarifa de Secure Cloud y costo mensual con 720 horas |
|---|---|
| NVIDIA L4 (24 GB) | USD 0.59 por hora, USD 425 al mes |
| NVIDIA L40S (48 GB) | USD 1.09 por hora, USD 785 al mes |
| NVIDIA A100 (80 GB) | USD 1.79 por hora, USD 1289 al mes |
| NVIDIA H100 PCIe (80 GB) | USD 2.89 por hora, USD 2081 al mes |
USD, cifras redondeadas. Costos ilustrativos de alquiler continuo, no costos completos de inferencia en producción. Se excluyen el almacenamiento, las redes, la capacidad de disponibilidad y las operaciones. Los precios y la disponibilidad del proveedor pueden cambiar. Runpod también publica tarifas más bajas de Community Cloud para algunas de estas GPU, por ejemplo 0.79 dólares por hora para una L40S, unos 569 dólares al mes.
Fuente: precios de GPU de Runpod.
Una L40S en funcionamiento continuo cuesta aproximadamente 785 dólares al mes con la tarifa de Secure Cloud, antes de los gastos asociados. Es más que la factura ilustrativa de 484 dólares al mes de la API de Claude Sonnet 5.5.
Sería tentador concluir que la inferencia alojada es más barata. Pero esa conclusión tiene un problema.
Los 484 dólares representan un cargo calculado por una cantidad definida de tokens enviados a un modelo alojado concreto. Los 785 dólares representan el alquiler de hardware. Por sí solos no nos dicen nada sobre qué modelo de pesos abiertos puede ejecutarse en esa GPU, cuántas solicitudes puede procesar ni si sus respuestas igualan la calidad de Sonnet.
No son cotizaciones de servicio equivalentes.
Para compararlos de forma justa, la empresa debe elegir un modelo privado, evaluar sus respuestas con la misma carga de trabajo y medir cuánto trabajo aceptado completa la GPU dentro del tiempo de respuesta requerido.
Solo entonces puede calcular el costo efectivo por interacción exitosa.
El asistente interno también puede estar ocupado en horario laboral y casi inactivo por la noche. Una GPU en funcionamiento continuo cuesta dinero durante esas horas inactivas. Apagar los workers (procesos de servicio) conlleva compromisos de arranque y de disponibilidad.
Un sistema de procesamiento por lotes puede adaptarse a esas condiciones. Un asistente interactivo del que se espera una respuesta inmediata quizá no.
El beneficio económico de la inferencia privada depende de lo eficazmente que la empresa use la capacidad por la que paga.
Lo que gana la empresa al ser dueña de la inferencia
Una comparación de costos pasa por alto algunas de las razones más sólidas para ejecutar un modelo de forma privada.
Con una inferencia autogestionada, la empresa puede controlar cuándo se actualiza un modelo, conservar una versión elegida y configurar el entorno de servicio para requisitos operativos concretos.
Eso puede importar cuando la aplicación necesita un comportamiento repetible a lo largo de un proceso controlado de publicación de versiones.
La inferencia privada también puede reducir la necesidad de transmitir prompts y documentos sensibles a un servicio externo de modelos.
Pero ejecutar un modelo en local no hace que toda la aplicación sea privada de forma automática.
El asistente interno sigue recuperando documentos, construyendo prompts, escribiendo registros (logs) y usando sistemas de supervisión. Si alguno de esos componentes transmite información confidencial a otro lugar, un modelo ejecutado en local no cierra el perímetro completo de los datos.
Los servicios de modelos gestionados también pueden ofrecer protecciones de datos empresariales. La documentación de Microsoft Foundry distingue el acceso del proveedor del modelo y el uso para entrenamiento, por un lado, de la ubicación del procesamiento y del almacenamiento, por otro, que pueden variar según el tipo de despliegue y las funciones. La misma página describe la supervisión de abusos: los prompts y las respuestas que un sistema automatizado marca pueden ser muestreados y revisados por personal autorizado de Microsoft, con los datos almacenados en la geografía del cliente, salvo que el cliente esté aprobado para una supervisión de abusos modificada. Los despliegues de tipo Global y DataZone también pueden procesar datos fuera de la geografía del recurso. Las condiciones de otros proveedores son diferentes, así que hay que contrastar las condiciones del despliegue concreto con el requisito de perímetro de la organización.
Si los documentos internos deben procesarse solo dentro de un entorno definido y controlado por la empresa, la inferencia privada puede ser necesaria. Si un servicio gestionado aprobado satisface el requisito, el autoalojamiento puede aportar poco valor de seguridad en relación con su carga operativa.
La privacidad es una propiedad de toda la aplicación y de su flujo de datos, no una etiqueta asociada al endpoint del modelo.
Un agente de programación cambia el panorama económico
Ahora piensa en un equipo de software que usa agentes de programación con IA. Los agentes leen archivos del repositorio, investigan incidencias, modifican código, ejecutan pruebas y preparan cambios para su revisión.
Esto es distinto de recuperar documentación interna. Un agente de programación puede inspeccionar muchos archivos antes de identificar un problema. Su primer parche puede no superar las pruebas. Después puede analizar registros, revisar la implementación e invocar más herramientas.
Supongamos que diez desarrolladores delegan cuatro tareas de programación por día laborable durante 22 días, lo que genera 880 tareas al mes.
Para una tarea moderada, supón que el flujo de trabajo completo consume 100 000 tokens de entrada y 20 000 tokens de salida. Para una tarea más pesada, supón 500 000 tokens de entrada y 50 000 tokens de salida.
| Modelo alojado | Tareas moderadas al mes | Tareas pesadas al mes |
|---|---|---|
| Claude Sonnet 5.5 | USD 352 | USD 1320 |
| Claude Fable 5.2 | USD 1408 | USD 5280 |
| GPT-6.1 Sol | USD 352 | USD 1320 |
USD para 880 tareas, aritmética con tarifas estándar. Se supone que todos los tokens de la interacción se facturan en los niveles estándar indicados. El caso pesado es un agregado de varias llamadas, no un único prompt de 500K tokens. Se excluyen el almacenamiento en caché, las herramientas de pago, los entornos de ejecución y los costos de revisión. La calidad de los modelos y el uso real pueden variar. Las tarifas son tarifas del nivel estándar consultadas el 11 de noviembre de 2026.
Fuentes: precios de la API de Anthropic y precios de la API de OpenAI.
El almacenamiento en caché puede cambiar estos totales de forma considerable. Anthropic factura los aciertos de caché de Claude Sonnet 5.5 a 0.10 dólares por millón de tokens frente a 2 dólares por la entrada base, y OpenAI indica para la entrada en caché de GPT-6.1 Sol 0.10 dólares frente a 2 dólares. Los agentes de programación reenvían gran parte de su contexto entre llamadas, así que una factura alojada puede quedar muy por debajo de las cifras anteriores. Como sensibilidad hipotética, si el 80 % de los 440 millones de tokens de entrada del caso pesado fueran aciertos de caché, el total de Claude Sonnet 5.5 bajaría de 1320 dólares a unos 651 dólares antes de cualquier cargo por escritura en caché. Es un cálculo de TechiesJournal, no un resultado observado.
En el extremo más pesado, los cargos recurrentes del modelo se vuelven significativos. Eso hace que valga la pena investigar la inferencia privada, pero no que valga la pena desplegarla de forma automática.
El costo de generar código no es el costo de producir un cambio de software aceptado.
Un modelo barato puede resultar costoso si produce repetidamente parches que no superan las pruebas y requieren correcciones del desarrollador. Un modelo más caro puede completar trabajo difícil con menos reintentos, aunque esa ventaja debe medirse en lugar de suponerse.
Para los agentes de programación, yo mediría la finalización correcta de las tareas, el tiempo transcurrido y la corrección humana junto con los cargos del modelo.
La capacidad de un modelo de pesos abiertos para el mismo trabajo de programación
Los modelos de pesos abiertos son candidatos creíbles para tareas de programación y agénticas, pero una tabla de clasificación pública no demuestra que uno de ellos pueda sustituir a un modelo alojado en una empresa concreta.
SWE-bench Verified, que evalúa agentes con incidencias de repositorios de código públicos, se convirtió en un punto de referencia habitual. Sin embargo, en septiembre de 2026, Epoch AI clasificó el benchmark como defectuoso, por problemas de contaminación y de puntuación.
La puntuación de un modelo también puede depender del arnés (harness) del agente, los prompts, las herramientas y la configuración de ejecución. Un benchmark público no reproduce los repositorios privados, las dependencias, las pruebas ni los criterios de aceptación de una empresa.
Una comparación mejor daría a los candidatos alojados y privados un conjunto representativo de tareas internas equivalentes. El equipo examinaría correcciones de errores, generación de pruebas, actualizaciones de dependencias y cambios que abarcan varios archivos.
Para cada tarea, el equipo debería registrar si se superaron las pruebas, si el cambio cumplía lo solicitado, cuántos intentos hicieron falta, cuánto tiempo llevó y cuánta corrección del desarrollador quedó pendiente.
Esa evidencia importa más que un porcentaje destacado de benchmark cuando la decisión es si gastar dinero en operar hardware de inferencia dedicado.
El modelo elegido determina la factura del hardware
Una razón para evaluar primero la capacidad es que distintos modelos de pesos abiertos imponen requisitos de servicio muy diferentes.
Qwen3.5-27B se describe en su ficha del modelo (model card) como un modelo de lenguaje de 27 mil millones de parámetros. Con cuatro bits por parámetro, la carga teórica de pesos ronda los 13.5 GB antes de los metadatos y la sobrecarga del runtime. Vale la pena evaluar un despliegue cuantizado adecuado en una GPU de 48 GB, pero su longitud de contexto, su concurrencia y su rendimiento real (throughput) aún están por probar. Los propios ejemplos de servicio de la ficha usan paralelismo de tensores con ocho GPU y recomiendan mantener al menos 128K tokens de contexto cuando sea posible, lo que muestra lo rápido que la planificación de memoria va más allá de los pesos por sí solos.
GLM-5.3-Flash usa una arquitectura de mezcla de expertos (mixture of experts) con aproximadamente 321 mil millones de parámetros totales y 18 mil millones activos por token. El número menor de parámetros activos reduce parte del cómputo, pero no elimina la necesidad de almacenar los pesos del modelo y acceder a ellos. La explicación anterior de TechiesJournal sobre los modelos de pesos abiertos y por qué la mezcla de expertos ayuda al cómputo pero no al almacenamiento (en inglés) aborda la misma distinción para otros tres modelos.
Su checkpoint predeterminado documentado en FP8 necesita aproximadamente 306 GiB de almacenamiento de pesos antes de la sobrecarga del runtime y de la KV cache, y la configuración predeterminada de la receta publicada usa ocho GPU H200, una configuración cuyo precio no figura en la tabla de Runpod anterior. La misma receta indica un checkpoint BF16 que necesita aproximadamente el doble de la memoria de pesos de FP8 y un checkpoint NVFP4 de 4 bits que requiere GPU NVIDIA Blackwell.
Ese checkpoint predeterminado no cabe en una sola L40S. Una empresa atraída por un potente modelo de programación de pesos abiertos puede descubrir que la infraestructura privada necesaria es mucho más cara que la GPU de su primera hoja de cálculo.
Los pesos abiertos ofrecen libertad de despliegue, pero no garantizan un despliegue asequible.
Por qué varios agentes hacen más exigente la inferencia
El escenario del agente de programación también pone a prueba la concurrencia.
Un runtime de servicio de modelos debe gestionar solicitudes con distintas longitudes de contexto y tamaños de salida. En los transformers autorregresivos convencionales, el procesamiento de la entrada suele describirse como prefill, seguido de la generación de tokens durante la fase de decode (decodificación).
El runtime mantiene un estado de atención reutilizable, conocido como caché de clave-valor (key-value cache), o KV cache. Los contextos largos y los múltiples agentes activos aumentan la memoria necesaria para ese estado.
Los sistemas de servicio como vLLM emplean técnicas de planificación y de agrupación en lotes (batching) para mejorar la utilización de la GPU. Pero la memoria y el cómputo disponibles siguen siendo finitos. La guía de TechiesJournal para elegir un motor de inferencia de IA para producción compara los motores de servicio con más detalle. Cuando la demanda supera la capacidad, aparecen colas y respuestas más lentas.
Esto importa especialmente en los agentes de programación de varios pasos. Cada respuesta retrasada puede aplazar la siguiente llamada a una herramienta, prueba o corrección.
Por eso la empresa debe medir el tiempo de finalización de las tareas de principio a fin con una demanda concurrente realista, no solo la velocidad de generación de tokens de una única solicitud.
Los servicios alojados operan gran parte de la infraestructura de servicio por cuenta de los clientes, aunque siguen imponiendo límites e introducen dependencias del proveedor. La inferencia autogestionada ofrece control directo sobre la capacidad, pero exige que la propia empresa diseñe, supervise y restablezca esa capacidad.
Esa diferencia operativa forma parte de la comparación de costos.
Dónde se sitúa el punto de equilibrio
En el ejemplo de programación pesada, Claude Sonnet 5.5 produce una factura ilustrativa del modelo de 1320 dólares al mes. Una L40S alquilada de forma continua cuesta unos 785 dólares.
La diferencia parece prometedora, pero no es una prueba de ahorro, y la sensibilidad al almacenamiento en caché que vimos antes muestra cuánto puede reducirse. El despliegue privado podría necesitar un modelo más grande, más GPU, más soporte operativo o más reintentos para lograr los mismos resultados aceptados.
La comparación debe usar una medida común:
Costo por tarea aceptada = costo operativo relevante total ÷ tareas aceptadas completadas
Para la inferencia alojada, el costo total incluye el uso del modelo, los cargos relevantes por herramientas y el trabajo de aplicación y de revisión que lo rodea. Para la inferencia autogestionada, incluye las GPU o el hardware, el almacenamiento, las redes, la redundancia, el soporte operativo y una corrección humana comparable.
El artículo anterior de TechiesJournal sobre cómo los precios de la IA pasan de los precios por token al costo por tarea (en inglés) trata los costos de reintentos, almacenamiento en caché y revisión que esta medida debe incluir.
Ambos enfoques deben evaluarse con los mismos criterios de éxito, requisitos de privacidad y expectativas de tiempo de respuesta.
Un modelo privado que gestiona tareas predecibles con una utilización alta puede ser económico. Otro que requiere hardware caro pero produce resultados inciertos quizá no lo sea.
Un enfoque híbrido puede tener sentido cuando distintas cargas de trabajo requieren capacidades de modelo diferentes, siempre que el enrutamiento esté limitado por la política de datos de la empresa. Una solicitud confidencial no puede enviarse a un endpoint de nube no autorizado solo porque el modelo privado aprobado esté ocupado.
La pregunta útil es qué modalidad produce un resultado aceptado al menor costo sostenible y cumple a la vez las restricciones de la aplicación.
Lo que yo elegiría para estas cargas de trabajo
Para el asistente de conocimiento interno, empezaría por evaluar un modelo gestionado adecuado frente a los requisitos de precisión, privacidad y latencia de la empresa. Los cargos ilustrativos de la API no justifican, por sí solos, mantener capacidad de GPU dedicada.
La inferencia privada resulta atractiva cuando satisface un requisito de perímetro de procesamiento o demuestra una clara ventaja operativa con un tráfico sostenido.
Para el agente de programación, examinaría la inferencia privada con más seriedad una vez que los gastos y el uso del modelo sean considerables. Pero probaría el éxito en las tareas de programación y la corrección humana antes de tratar una tarifa baja de GPU como un ahorro.
La evidencia podría respaldar un modelo alojado, uno autogestionado o una combinación de ambos. Eso no es indecisión. Se deriva del hecho de que estas cargas de trabajo tienen requisitos distintos de capacidad, infraestructura y seguridad.
La ventaja es el control, pero el control debe crear valor
Los modelos de pesos abiertos permiten a las organizaciones conservar versiones de los modelos, operar dentro de entornos de procesamiento definidos y, potencialmente, mejorar la economía de trabajos adecuados de gran volumen.
Esos beneficios son reales. También lo son las responsabilidades añadidas en capacidad, memoria, concurrencia, fiabilidad, actualizaciones y seguridad.
El agente de conocimiento interno ilustra por qué unos cargos modestos de modelos alojados pueden debilitar el argumento de negocio a favor de una GPU privada. El agente de programación muestra por qué unas interacciones sostenidas y caras pueden hacer que valga la pena evaluar la inferencia privada, a la vez que deja al descubierto la capacidad del modelo y los límites del hardware.
Una organización debería ser dueña de su inferencia de IA cuando esa propiedad aporte una capacidad, un perímetro de privacidad o una ventaja económica que su carga de trabajo necesite de verdad y que pueda operar de forma sostenible.
El objetivo no es poseer más infraestructura. Es obtener mejores resultados con el nivel de control adecuado.
Fuentes y lecturas adicionales
- OpenAI API pricing
- Anthropic API pricing
- Runpod GPU cloud pricing
- Microsoft Foundry data privacy
- Qwen3.5-27B model card
- GLM-5.3-Flash vLLM deployment recipe
- vLLM documentation
- Epoch AI review of SWE-bench Verified
Fecha de investigación: 11 de noviembre de 2026. Todos los volúmenes de carga de trabajo, costos mensuales y ejemplos son cálculos ilustrativos, no resultados de producción observados. Los precios y los requisitos de los modelos cambian, así que comprueba las cifras actuales antes de basarte en ellas. No se afirma ningún despliegue de primera mano ni ningún benchmark emparejado entre inferencia alojada e inferencia privada.