

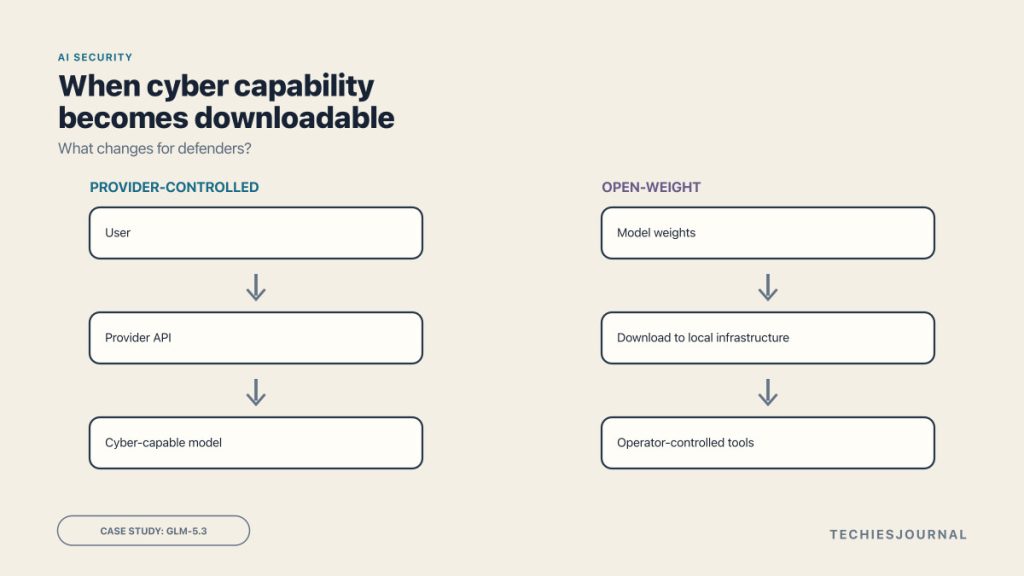
GLM-5.3 दुनिया का सबसे सक्षम साइबर मॉडल नहीं है। जो बात इसे महत्वपूर्ण बनाती है वह यह है कि वल्नरेबिलिटी-डिस्कवरी और एक्सप्लॉइट-डेवलपमेंट की सार्थक क्षमता अब डाउनलोड करने लायक़ बनती जा रही है। डिफेंडरों के लिए इससे क्या बदलता है, यहाँ बताया गया है।
सबसे सक्षम AI मॉडलों में से कुछ के साथ एक महत्वपूर्ण सीमा जुड़ी होती है। आप आम तौर पर उन्हें किसी और की सर्विस के ज़रिए इस्तेमाल करते हैं।
आप किसी API पर एक रिक्वेस्ट भेजते हैं। प्रोवाइडर मॉडल चलाता है। वह इस्तेमाल पर नज़र रख सकता है, कुछ रिक्वेस्ट पर रोक लगा सकता है, सेफ़गार्ड बदल सकता है या एक्सेस निलंबित कर सकता है।
कोई ओपन-वेट मॉडल इस रिश्ते को बदल देता है।
वेट्स जारी होते ही, कोई संगठन या व्यक्ति मॉडल को अपने इन्फ्रास्ट्रक्चर पर चला सकता है, उसे अपने टूल्स से जोड़ सकता है और यह बदल सकता है कि वह कैसा व्यवहार करे। मूल प्रोवाइडर अब हर इंटरैक्शन को नियंत्रित नहीं करता।
यह फ़र्क़ तब कहीं ज़्यादा मायने रखता है जब मॉडल सामान्य सॉफ़्टवेयर लिखने से कहीं ज़्यादा कुछ कर सके।
GLM-5.3 इसका एक उपयोगी उदाहरण है।
सितंबर 2026 में, U.S. National Institute of Standards and Technology के Center for AI Standards and Innovation, यानी CAISI, ने GLM-5.3 को अपने द्वारा जाँचे गए सबसे साइबर-सक्षम ओपन-वेट मॉडल के रूप में बताया।
यह सॉफ़्टवेयर वल्नरेबिलिटी ढूँढ सकता है और एक्सप्लॉइट डेवलपमेंट के उन हिस्सों पर काम कर सकता है जिनके लिए काफ़ी तकनीकी जानकारी चाहिए होती है।
लेकिन इसके साथ एक उतनी ही महत्वपूर्ण क़ैफ़ियत भी है।
GLM-5.3 दुनिया का सबसे सक्षम साइबर मॉडल नहीं है। NIST के मूल्यांकन में यह उसके द्वारा जाँचे गए अग्रणी U.S. फ्रंटियर मॉडलों से अब भी काफ़ी पीछे रहा।
तो फिर यह मायने क्यों रखता है?
क्योंकि महत्वपूर्ण बदलाव यह नहीं है कि किसी ओपन मॉडल ने AI रेस जीत ली है।
बदलाव यह है कि उन्नत साइबर क्षमता का एक सार्थक स्तर अब डाउनलोड किया जा सकता है।
डिफेंडरों के लिए, इससे अवसर और जोखिम दोनों बदल जाते हैं।
असल में क्या बदला है?
AI-असिस्टेड साइबरसिक्योरिटी कोई नई बात नहीं है।
डेवलपर पहले से ही कोड जाँचने, संदिग्ध व्यवहार समझाने और पैच की समीक्षा के लिए AI इस्तेमाल करते हैं। सिक्योरिटी टीमें इसका इस्तेमाल अलर्ट का सार निकालने, वल्नरेबिलिटी की जाँच करने और सिक्योरिटी रिसर्च में मदद के लिए करती हैं।
GLM-5.3 इसी राह पर आगे बढ़ता है।
इसके डेवलपर, Z.ai का कहना है कि पोस्ट-ट्रेनिंग के दौरान वल्नरेबिलिटी-डिस्कवरी डेटा और एनवायरनमेंट जानबूझकर शामिल किए गए थे।
इससे भी ज़्यादा महत्वपूर्ण बात यह है कि स्वतंत्र जाँच व्यापक क्षमता के दावे का समर्थन करती है।
NIST ने GLM-5.3 को चार बेंचमार्क पर जाँचा, जो वल्नरेबिलिटी डिस्कवरी और एक्सप्लॉइट डेवलपमेंट को कवर करते हैं।
| साइबर मूल्यांकन | GLM-5.3 | NIST मूल्यांकन में U.S. फ्रंटियर का सर्वश्रेष्ठ |
|---|---|---|
| SEC-Bench Pro | 40.4% | 90.2% |
| ExploitBench | 61.1% | 100% |
| ExploitGym | 9.4% | 44.4% |
| CAISI OSS-Fuzz | 7.7% | 23.2% |
इस टेबल को कैसे पढ़ें: “U.S. फ्रंटियर का सर्वश्रेष्ठ” वह सर्वश्रेष्ठ परिणाम है जो CAISI द्वारा जाँचे गए किसी भी जारी U.S. मॉडल ने प्रत्येक बेंचमार्क पर हासिल किया। यह सभी चार पंक्तियों में एक ही मॉडल का प्रतिनिधित्व नहीं करता। जहाँ लागू हो, वहाँ U.S. मॉडलों को साइबर सेफ़गार्ड बंद करके जाँचा गया।
स्रोत: NIST Center for AI Standards and Innovation, 17 सितंबर 2026।
इस तुलना को ध्यान से समझने की ज़रूरत है।
U.S. फ्रंटियर वाला कॉलम कोई एक मॉडल नहीं है। यह उस सर्वश्रेष्ठ परिणाम को दिखाता है जो CAISI द्वारा जाँचे गए किसी जारी U.S. मॉडल ने हर बेंचमार्क पर हासिल किया। जहाँ लागू हो, वहाँ उन मॉडलों को भी साइबर सेफ़गार्ड बंद करके जाँचा गया।
NIST के समग्र विश्लेषण ने अनुमान लगाया कि साइबर क्षमता में GLM-5.3 मौजूदा U.S. फ्रंटियर से लगभग चार महीने पीछे है।
तो यह सबूत यह नहीं दिखाता कि ओपन मॉडल फ्रंटियर तक पहुँच गए हैं।
यह दिखाता है कि ओपन वेट्स के ज़रिए उपलब्ध स्तर काफ़ी आगे बढ़ चुका है।
“डाउनलोड करने लायक़” होना मायने क्यों रखता है?
दो सक्षम मॉडलों की कल्पना कीजिए।
पहला किसी प्रोवाइडर के ज़रिए चलता है: यूज़र → प्रोवाइडर API → मॉडल।
प्रोवाइडर सिक्योरिटी बाउंड्री का हिस्सा बना रहता है। वह ऑथेंटिकेशन, इस्तेमाल की सीमा, निगरानी, सेफ़्टी पॉलिसी और एक्सेस को नियंत्रित कर सकता है।
अब एक ओपन-वेट मॉडल पर विचार कीजिए: मॉडल वेट्स → डाउनलोड → लोकल इन्फ्रास्ट्रक्चर → यूज़र-नियंत्रित मॉडल।
चित्र 1 का सुलभ (accessible) पाठ विकल्प
प्रोवाइडर-नियंत्रित: यूज़र, फिर प्रोवाइडर API, फिर प्रोवाइडर के नियंत्रण जिनमें एक्सेस, निगरानी, इस्तेमाल की पॉलिसी और कौन-सा मॉडल परोसा जाता है शामिल है, जो साइबर-सक्षम मॉडल तक ले जाते हैं। ओपन-वेट: मॉडल वेट्स, फिर डाउनलोड, फिर ऑपरेटर एनवायरनमेंट, फिर ऑपरेटर के नियंत्रण जिनमें इन्फ्रास्ट्रक्चर, टूल्स, डेटा, नेटवर्क और मॉडल कॉन्फ़िगरेशन शामिल है। एक समापन टिप्पणी बताती है कि ओपन वेट्स किसी मॉडल को अपने आप असुरक्षित नहीं बनाते, वे बस यह बदलते हैं कि मॉडल को कौन नियंत्रित करता है और वितरण के बाद कौन-से सिक्योरिटी नियंत्रण उपलब्ध रहते हैं।
ऑपरेटर तय कर सकता है कि मॉडल कहाँ चले, उसे कौन-सा डेटा मिले, वह किन टूल्स तक पहुँच सके, वह कितनी बार काम करे, उसे कैसे ढाला जाए, और उसके चारों ओर कौन-से अतिरिक्त नियंत्रण रखे जाएँ।
इससे ओपन-वेट AI अपने आप असुरक्षित नहीं बन जाता।
इसी गुण के महत्वपूर्ण फ़ायदे भी हैं।
संगठन संवेदनशील जानकारी अपने ही एनवायरनमेंट के भीतर रख सकते हैं। रिसर्चर मॉडलों का कहीं सीधे अध्ययन कर सकते हैं। सिक्योरिटी टीमें किसी बाहरी सर्विस पर पूरी तरह निर्भर हुए बिना उन्हें विशेष वर्कफ़्लो के मुताबिक़ ढाल सकती हैं।
लेकिन नियंत्रण का मॉडल बदल जाता है।
वेट्स बँटने के बाद, मूल डेवलपर उन्हीं नियंत्रणों पर भरोसा नहीं कर सकता जो किसी API प्रोवाइडर को उपलब्ध होते हैं।
यही महत्वपूर्ण फ़र्क़ है।
सबूत क्या साबित करता है, और क्या नहीं?
यह फ़र्क़ इसलिए मायने रखता है क्योंकि साइबर बेंचमार्क आसानी से नाटकीय सुर्खियाँ बना सकते हैं।
Anthropic ने स्वतंत्र रूप से GLM-5.3 को एक्सप्लॉइट-डेवलपमेंट कार्यों पर जाँचा।
अपने वर्शन के ExploitBench में, GLM-5.3 ने 410 में से 50 प्रयासों में एंड-टू-एंड एक्सप्लॉइट बनाए। उसी सेटअप में Anthropic के Claude Mythos Preview ने 410 में से 56 प्रयासों में इन्हें बनाया।
ओपन-सोर्स सॉफ़्टवेयर से जुड़े एक अन्य Anthropic बेंचमार्क में, GLM-5.3 ने 4% ट्रायल में पूर्ण कंट्रोल-फ़्लो हाईजैकिंग हासिल की। Mythos Preview ने 6% में।
Anthropic ने एक रिसर्चर-गाइडेड प्रयोग की भी जानकारी दी जिसमें GLM-5.3 ने ब्राउज़र की पहले से अज्ञात वल्नरेबिलिटी ढूँढी और एक सैंडबॉक्स्ड एनवायरनमेंट में उनमें से कई को जोड़कर एक कार्यशील एक्सप्लॉइट बना दिया।
ये नतीजे महत्वपूर्ण हैं।
लेकिन इनका मतलब यह नहीं है कि GLM-5.3 अकेले ही भरोसे के साथ वास्तविक संगठनों को कॉम्प्रोमाइज़ कर सकता है।
कोई बेंचमार्क मॉडल को एक तय किया हुआ काम, टूल्स, समय और एनवायरनमेंट देता है।
किसी वास्तविक हमले में सिस्टम को शायद यह करना पड़े
- कोई उपयोगी टारगेट खोजना।
- किसी अनजान एनवायरनमेंट को समझना।
- कोई वल्नरेबिलिटी ढूँढना।
- यह तय करना कि वह एक्सप्लॉइट करने लायक़ है या नहीं।
- एक कार्यशील एक्सप्लॉइट बनाना।
- डिफ़ेंसिव नियंत्रणों को पार करना।
- उपयोगी एक्सेस हासिल करना।
- पकड़े बिना काम करते रहना।
मौजूदा मूल्यांकन इस शृंखला के कुछ हिस्सों में प्रगति दिखाते हैं।
चित्र 2 का सुलभ (accessible) पाठ विकल्प
नौ-चरणों की शृंखला: 1. कोड या टारगेट, जहाँ से काम शुरू होता है। 2. वल्नरेबिलिटी ढूँढना। 3. एक्सप्लॉइटेबिलिटी आँकना। 4. एक्सप्लॉइट डेवलप करना। 5. टेस्ट करना और सुधारना। ये पाँच चरण मौजूदा बेंचमार्क द्वारा जाँचे गए हैं। 6. उपयोगी एक्सेस हासिल करना। 7. एनवायरनमेंट में नेविगेट करना। 8. डिफ़ेंस से बचना। 9. लक्ष्य हासिल करना। ये चार चरण इन मूल्यांकनों से प्रदर्शित नहीं होते। एक समापन टिप्पणी बताती है कि मौजूदा मूल्यांकन इस शृंखला के कुछ हिस्सों में सार्थक प्रगति दिखाते हैं, लेकिन यह नहीं दिखाते कि पूरी शृंखला अपने आप चल सकने लायक़ बन गई है।
ये यह नहीं दिखाते कि पूरी शृंखला अपने आप चल सकने लायक़ बन गई है।
यही वजह है कि दोनों छोर भ्रामक हैं।
“AI अब संगठनों को ख़ुद ही हैक कर सकता है” कहना सबूत से आगे निकल जाता है।
लेकिन “ये सिर्फ़ कोडिंग असिस्टेंट हैं” कहना सक्षम मॉडल जो कर सकते हैं उसे कम करके आँकता जा रहा है।
ओपन वेट्स सेफ़गार्ड की समस्या भी बदल देते हैं
GLM-5.3 में ऐसे सेफ़गार्ड शामिल हैं जो स्पष्ट रूप से हानिकारक रिक्वेस्ट को अस्वीकार कर सकते हैं।
Anthropic ने उन सेफ़गार्ड की जाँच की और बताया कि उसकी टेस्ट परिस्थितियों में अलग-अलग तकनीकों से उन्हें बायपास किया जा सका। उसके रिसर्चरों ने ओपन वेट्स की एक कॉपी को भी इस तरह बदला कि रिफ़्यूज़ल व्यवहार काफ़ी हद तक कम हो गया, और अपने बताए मूल्यांकनों में उन्हें सामान्य क्षमता में तुलनीय गिरावट नहीं मिली।
इनमें से कुछ टेस्ट वास्तविक बाहरी सिस्टम की बजाय सिमुलेटेड एनवायरनमेंट में किए गए थे, इसलिए सटीक बायपास प्रतिशत को वास्तविक दुनिया में हमले की सफलता का मापदंड नहीं माना जाना चाहिए।
बड़ा इंजीनियरिंग मुद्दा इससे कहीं सरल है।
किसी API मॉडल में, प्रोवाइडर यह नियंत्रित करता है कि कौन-सा मॉडल परोसा जा रहा है।
ओपन वेट्स में, ऑपरेटर एक कॉपी को नियंत्रित करता है।
इसका मतलब है कि मॉडल के भीतर मौजूद सेफ़गार्ड को पूरी सिक्योरिटी बाउंड्री नहीं माना जा सकता।
सक्षम ओपन मॉडल इस्तेमाल करने वाले संगठनों को मॉडल के चारों ओर भी नियंत्रण चाहिए होते हैं: मॉडल सेफ़गार्ड, टूल परमिशन, नेटवर्क प्रतिबंध, क्रेडेंशियल-सीमाएँ, सैंडबॉक्सिंग, और इंसानी निगरानी के साथ लॉगिंग।
चित्र 3 का सुलभ (accessible) पाठ विकल्प
एक केंद्रीय AI सिक्योरिटी मॉडल के चारों ओर आठ नियंत्रण हैं: सैंडबॉक्स (आइसोलेटेड एक्ज़ीक्यूशन), स्कोप्ड क्रेडेंशियल (सिर्फ़ उतना जितना टास्क को चाहिए), प्रतिबंधित नेटवर्क (कोई अप्रत्याशित डेस्टिनेशन नहीं), स्वीकृत टूल्स (सिर्फ़ जाँची हुई क्षमताएँ), एक्शन सीमाएँ (रेट और स्कोप बाउंड), लॉगिंग (हर एक्शन दर्ज), इंसानी मंज़ूरी (परिणामी एक्शन के लिए), और एविडेंस वैलिडेशन (निष्कर्ष पुष्ट, न कि माने गए)। एक समापन टिप्पणी बताती है कि मॉडल सेफ़गार्ड एक परत हैं, पूरी सिक्योरिटी बाउंड्री नहीं।
मॉडल जितना ज़्यादा सक्षम होता जाता है, ये आसपास के नियंत्रण उतने ही ज़्यादा महत्वपूर्ण होते जाते हैं।
यह एक ट्रेंड है, सिर्फ़ GLM-5.3 की कहानी नहीं
GLM-5.3 अचानक कहीं से नहीं आया।
2026 की शुरुआत में, NIST ने GLM-5.2 की जाँच की और पाया कि उसके सेफ़गार्ड एजेंटिक एक्सप्लॉइट डेवलपमेंट में मदद की इजाज़त दे देते थे।
इसके बाद Kimi K3 ने ओपन-वेट क्षमता के स्तर को और आगे बढ़ाया।
UK AISI और U.S. CAISI के एक साझा मूल्यांकन में, Kimi K3 ने एक्सप्लॉइट डेवलपमेंट में GLM-5.2 से बेहतर प्रदर्शन किया, हालाँकि यह अग्रणी फ्रंटियर सिस्टम से अब भी काफ़ी पीछे रहा।
GLM-5.3 ने इस स्तर को फिर आगे बढ़ा दिया।
व्यक्तिगत मॉडल के नाम बदलते रहेंगे।
जिस ट्रेंड पर नज़र रखना ज़्यादा उपयोगी है, वह है: ओपन-वेट साइबर क्षमता लगातार बेहतर होती जा रही है।
यह इसलिए मायने रखता है क्योंकि उन्नत क्षमता और केंद्रीकृत प्रोवाइडर नियंत्रण तेज़ी से अलग-अलग सवाल बनते जा रहे हैं।
डिफेंडरों के लिए क्या बदलता है?
साफ़ चिंता यह है कि डाउनलोड करने लायक़ सक्षम मॉडल हमलावरों के लिए कुछ बाधाएँ कम कर सकते हैं।
लेकिन डिफेंडर भी उसी तरह की टेक्नोलॉजी इस्तेमाल कर सकते हैं।
साइबरसिक्योरिटी में हमेशा से दोहरे इस्तेमाल वाले टूल्स रहे हैं।
कोई नेटवर्क स्कैनर किसी एडमिनिस्ट्रेटर को एनवायरनमेंट समझने में मदद कर सकता है या किसी हमलावर को टारगेट ढूँढने में मदद कर सकता है।
कोई पेनिट्रेशन-टेस्टिंग फ़्रेमवर्क किसी सिक्योरिटी टीम को डिफ़ेंस जाँचने में मदद कर सकता है या किसी को कमज़ोरियों का फ़ायदा उठाने में मदद कर सकता है।
साइबर-सक्षम AI इसमें कुछ अलग जोड़ता है। कोई मॉडल कई गतिविधियों को एक साथ जोड़ सकता है: सोचना, कोड लिखना, टूल्स चलाना, नतीजे जाँचना, तरीक़ा बदलना, और फिर कोशिश करना।
असल असर शायद पूरी तरह नए हमले गढ़ने से कम और मौजूदा सिक्योरिटी काम के कुछ हिस्सों के लिए चाहिए एक्सपर्टीज़, समय और मैनुअल मेहनत घटाने से ज़्यादा जुड़ा हो।
यह बात डिफेंडरों पर भी लागू होती है।
यह पूछने की बजाय कि
क्या हमें GLM-5.3 इस्तेमाल करना चाहिए?
सिक्योरिटी टीमों को यह पूछना चाहिए
हमारे सिक्योरिटी काम के किन हिस्सों में AI सुधार ला सकता है, और भरोसा करने से पहले हमें कौन-से सबूत और नियंत्रण चाहिए?
जाँचने लायक़ संभावित क्षेत्रों में शामिल हैं
- वल्नरेबिलिटी इन्वेस्टिगेशन।
- सिक्योर-कोड रिव्यू।
- पैच एनालिसिस।
- एक्सप्लॉइटेबिलिटी असेसमेंट।
- फ़ज़िंग वर्कफ़्लो।
- रेमीडिएशन सपोर्ट।
एक संकरे वर्कफ़्लो से शुरुआत कीजिए। उदाहरण के लिए: कोड बदलाव, AI सिक्योरिटी रिव्यू, संभावित इशू, इंसानी वैलिडेशन, टेस्ट, फ़िक्स। या: स्कैनर से मिला निष्कर्ष, AI विश्लेषण, एक्सप्लॉइटेबिलिटी असेसमेंट, सिक्योरिटी इंजीनियर का वैलिडेशन, रेमीडिएशन।
मॉडल के नतीजे को तब तक एक परिकल्पना माना जाना चाहिए जब तक तकनीकी सबूत उसकी पुष्टि न कर दे।
जब मॉडल ख़ुद एक्शन ले सके तो क्षमता ज़्यादा गंभीर बन जाती है
“इस सोर्स कोड का विश्लेषण करो” पूछने और किसी मॉडल को क्रेडेंशियल, एक शेल, नेटवर्क एक्सेस, सिक्योरिटी टूल्स, और यह तय करने की छूट देने के बीच एक बड़ा फ़र्क़ है कि आगे क्या करना है।
दूसरा सिस्टम अब सिर्फ़ सवालों के जवाब नहीं दे रहा।
वह एक्शन ले रहा है।
डिफ़ेंसिव इस्तेमाल के लिए, इसलिए मॉडल के चारों ओर का एनवायरनमेंट उतना ही मायने रखता है जितना मॉडल ख़ुद।
एक समझदार मूल्यांकन एनवायरनमेंट में यह शामिल होना चाहिए
- आइसोलेटेड टारगेट।
- संकरे दायरे वाले क्रेडेंशियल।
- प्रतिबंधित नेटवर्क एक्सेस।
- स्वीकृत टूल्स।
- एक्शन और समय की सीमाएँ।
- पूरी लॉगिंग।
- परिणामी एक्शन के लिए इंसानी मंज़ूरी।
- सिक्योरिटी निष्कर्षों के लिए दोहराए जा सकने वाले सबूत।
सिद्धांत जाना-पहचाना है: ब्लास्ट रेडियस सीमित रखो।
AI इस सिक्योरिटी सिद्धांत की जगह नहीं लेता।
यह हमें इसे सावधानी से लागू करने की एक और वजह देता है।
क्या यह आपके लिए मायने रखता है?
GLM-5.3 के अस्तित्व में आने से हर किसी को AI साइबरसिक्योरिटी को गहराई से सीखने की ज़रूरत नहीं है।
उपयोगी सवाल यह है कि यह घटनाक्रम आपके काम के लिए कितना मायने रखता है।
| आपकी भूमिका | गहराई | क्या मायने रखता है |
|---|---|---|
| सॉफ़्टवेयर डेवलपर | जानें (Know) | समझें कि AI सिक्योरिटी टूल्स कोड समझाने से आगे बढ़कर वल्नरेबिलिटी डिस्कवरी और एक्सप्लॉइटेबिलिटी विश्लेषण की ओर जा रहे हैं। |
| सिक्योरिटी इंजीनियर | इस्तेमाल करें (Use) | संकरे डिफ़ेंसिव वर्कफ़्लो में AI को जाँचें और उसके निष्कर्षों को तकनीकी सबूत से वैलिडेट करें। |
| सिक्योरिटी रिसर्चर / AI-सिक्योरिटी आर्किटेक्ट | महारत हासिल करें (Master) | साइबर मूल्यांकन, एजेंट हार्नेस, सैंडबॉक्सिंग, मॉडल सेफ़गार्ड, टूल परमिशन और क्षमता मापन को समझें। |
| अन्य टेक्नोलॉजी प्रोफ़ेशनल | नज़र रखें (Watch) | प्रोवाइडर-नियंत्रित क्षमता से आगे बढ़कर उन मॉडलों की ओर बड़े बदलाव को समझें जिन्हें संगठन ख़ुद चला सकते हैं। |
अगर आप सॉफ़्टवेयर डेवलपर हैं
आपको एक्सप्लॉइट डेवलपर बनने की ज़रूरत नहीं है।
लेकिन यह समझना फ़ायदेमंद है कि AI-असिस्टेड सिक्योरिटी रिव्यू सामान्य सॉफ़्टवेयर डेवलपमेंट का हिस्सा कैसे बन सकता है।
आगे यह देखें: AI-असिस्टेड कोड रिव्यू या वल्नरेबिलिटी विश्लेषण आपकी मौजूदा डेवलपमेंट प्रक्रिया में मौजूदा सिक्योरिटी टेस्टिंग की जगह लिए बिना कहाँ फ़िट हो सकता है।
अगर आप सिक्योरिटी इंजीनियर हैं
यह घटनाक्रम आपके लिए ज़्यादा सीधे तौर पर मायने रखता है।
एक डिफ़ेंसिव वर्कफ़्लो चुनें और जाँचें कि AI पूरे नतीजे में सुधार लाता है या नहीं, सिर्फ़ यह नहीं कि वह प्रभावशाली दिखने वाले निष्कर्ष देता है या नहीं।
आगे यह देखें: किसी नियंत्रित एनवायरनमेंट में वल्नरेबिलिटी इन्वेस्टिगेशन, पैच एनालिसिस या सिक्योर-कोड रिव्यू।
अगर आप सिक्योरिटी रिसर्चर या AI-सिक्योरिटी आर्किटेक्ट हैं
यह क्षेत्र गहरे अध्ययन के लायक़ है।
मुश्किल सवाल अब सिर्फ़ यह नहीं है कि कोई मॉडल क्या कर सकता है, बल्कि यह है कि उसे कहाँ करने की इजाज़त होनी चाहिए।
आगे यह देखें: ऐसे मूल्यांकन एनवायरनमेंट जो क्षमता, भरोसेमंदी और कंटेनमेंट को एक साथ मापते हैं।
अगर आप टेक्नोलॉजी के किसी और क्षेत्र में काम करते हैं
शायद आपको GLM-5.3 डाउनलोड करने या एक्सप्लॉइट बेंचमार्क पढ़ने की ज़रूरत नहीं है।
बड़े घटनाक्रम को समझना ही काफ़ी है: कुछ क्षमताएँ, जो पहले मुख्य रूप से नियंत्रित AI सर्विसों के पीछे मौजूद थीं, अब उन मॉडलों में जा रही हैं जिन्हें संगठन ख़ुद चला सकते हैं।
साइबरसिक्योरिटी इस बदलाव का एक उदाहरण है।
संगठनों को अभी क्या जाँचना चाहिए?
ज़्यादातर संगठनों के लिए किसी साइबर-सक्षम ओपन मॉडल को जल्दबाज़ी में डिप्लॉय करने की कोई वजह नहीं है।
यह समझने की वजह ज़रूर है कि AI सिक्योरिटी वर्कफ़्लो के भीतर पहले से कहाँ मौजूद है।
कुछ व्यावहारिक सवालों से शुरुआत कीजिए।
सिक्योरिटी टीमें पहले से AI कहाँ इस्तेमाल कर रही हैं? कोई नया मॉडल लाने से पहले मौजूदा इस्तेमाल को समझें।
संगठन से कौन-सा डेटा बाहर जा रहा है? सोर्स कोड, वल्नरेबिलिटी के विवरण और इन्फ्रास्ट्रक्चर की जानकारी संवेदनशील हो सकती है, भले ही वे पारंपरिक निजी डेटा जैसी न दिखें।
क्या लोकल मॉडल किसी वास्तविक समस्या को सुलझाएँगे? प्राइवेसी और नियंत्रण लोकल डिप्लॉयमेंट को आकर्षक बना सकते हैं, लेकिन इन फ़ायदों से अतिरिक्त ऑपरेशनल ज़िम्मेदारी जायज़ ठहरनी चाहिए।
जब मॉडल को टूल्स मिलते हैं तो क्या होता है? टूल एक्सेस, क्रेडेंशियल और नेटवर्क एक्सेस को अलग-अलग सिक्योरिटी बाउंड्री मानें।
क्या इंसान महत्वपूर्ण निष्कर्षों को दोबारा दिखा सकते हैं? कोई संभावित वल्नरेबिलिटी रिपोर्ट किसी पुष्ट वल्नरेबिलिटी के बराबर नहीं है।
क्या हर परिणामी एक्शन को बाद में फिर से जोड़कर समझा जा सकता है? अगर नहीं, तो सिस्टम का ऑडिट करना और उस पर भरोसा करना मुश्किल है।
GLM-5.3 के किसी और ज़्यादा सक्षम मॉडल से बदल जाने के बाद भी ये सवाल उपयोगी बने रहेंगे।
महत्वपूर्ण बदलाव पहुँच का है, लीडरबोर्ड का नहीं
इस तरह के घटनाक्रम को किसी मॉडल रेस तक सीमित कर देना आकर्षक लगता है।
कौन-सा मॉडल सबसे ज़्यादा स्कोर करता है? कौन-सी कंपनी आगे है? एक मॉडल दूसरे से कितने महीने पीछे है?
ये मापदंड रिसर्चरों को क्षमता पर नज़र रखने में मदद करते हैं।
ज़्यादातर टेक्नोलॉजी टीमों के लिए, ये अंतिम फ़ैसला नहीं हैं।
ज़्यादा उपयोगी सवाल ये हैं: यह मॉडल भरोसे के साथ असल में क्या कर सकता है, इसे अब भी कितनी एक्सपर्टीज़ चाहिए, यह किन चीज़ों तक पहुँच सकता है, इसके नाकाम होने पर क्या होता है, क्या इसके एक्शन को रोका जा सकता है, और क्या इसके निष्कर्षों की पुष्टि की जा सकती है?
GLM-5.3 यह नहीं दिखाता कि स्वायत्त AI हमलावर अचानक आ पहुँचे हैं।
यह कुछ ज़्यादा व्यावहारिक दिखाता है।
वल्नरेबिलिटी-डिस्कवरी और एक्सप्लॉइट-डेवलपमेंट क्षमता का एक सार्थक स्तर उन मॉडलों में उपलब्ध होता जा रहा है जिन्हें मूल प्रोवाइडर के इन्फ्रास्ट्रक्चर के बाहर डाउनलोड करके चलाया जा सकता है।
इससे हमलावरों को एक और टूल मिलता है।
इससे डिफेंडरों को भी एक और टूल मिलता है।
महत्वपूर्ण हुनर हर नए मॉडल को सीखना नहीं है।
यह जानना है कि यह क्षमता आपके काम के लिए कब मायने रखती है, इसे कितनी सुरक्षित तरह से इस्तेमाल किया जाए, और गहरी एक्सपर्टीज़ कब निवेश के लायक़ है।
जो बदला उसे जानें। जहाँ यह किसी वास्तविक समस्या को सुलझाए वहाँ इसे इस्तेमाल करें। इसमें महारत तभी हासिल करें जब आपके काम को उस गहराई की ज़रूरत हो।
संदर्भ और आगे पढ़ने के लिए
- NIST CAISI: Assessment of Z.ai’s GLM-5.3 Cyber Capabilities: इस लेख के लिए प्राथमिक स्वतंत्र सबूत। यह चार साइबर मूल्यांकनों, ओपन-वेट मॉडलों में GLM-5.3 की स्थिति, U.S. फ्रंटियर से बचे अंतर, और मॉडलों की जाँच कैसे की गई इसके महत्वपूर्ण विवरणों को समझाता है।
- Anthropic: GLM-5.3 and the Spread of Advanced Cyber Capabilities: एक्सप्लॉइट-डेवलपमेंट क्षमता और सेफ़गार्ड की उपयोगी स्वतंत्र जाँच। Anthropic ख़ुद भी एक प्रतिस्पर्धी मॉडल डेवलपर है, इसलिए इस लेख में उसकी व्याख्याओं को स्वतंत्र निष्कर्ष के बजाय एट्रिब्यूटेड विश्लेषण के रूप में लिया गया है।
- Z.ai: Preparing GLM-5.3 for Open Release: GLM-5.3 के डेवलपमेंट का मॉडल डेवलपर का अपना विवरण, जिसमें इसकी साइबर-केंद्रित पोस्ट-ट्रेनिंग और उसके अपने मूल्यांकन परिणाम शामिल हैं। वेंडर के दावों को उसी रूप में लिया गया है।
- NIST CAISI: Assessment of Z.ai’s GLM-5.2: यह समझने के लिए उपयोगी कि ओपन-वेट साइबर क्षमता में प्रगति GLM-5.3 से पहले ही शुरू हो चुकी थी।
- UK AISI / U.S. CAISI: Preliminary Assessment of Kimi K3’s Cyber Capabilities: ओपन-वेट साइबर क्षमता की प्रगति में एक और बिंदु प्रस्तुत करता है और यह दिखाता है कि स्वायत्त हमले के नतीजों को पढ़ते समय मूल्यांकन की परिस्थितियाँ क्यों मायने रखती हैं।