

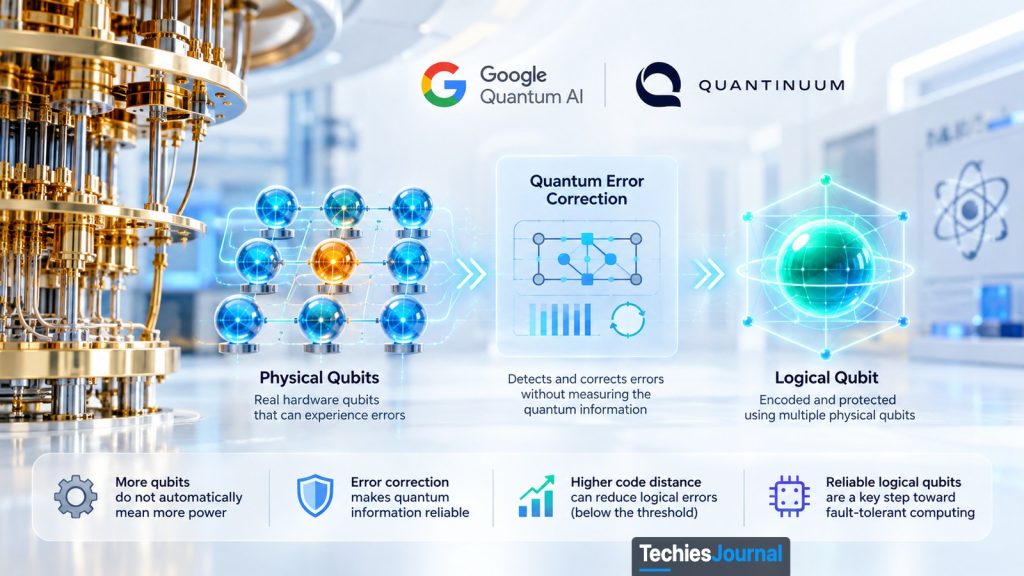
On compare souvent les ordinateurs quantiques au nombre de qubits qu’ils contiennent. Mais un nombre de qubits plus élevé ne signifie pas forcément un ordinateur plus performant. Pour comprendre pourquoi, il faut examiner comment l’information quantique est stockée, comment les erreurs surviennent et ce que les qubits logiques résolvent réellement.
Pourquoi avoir plus de qubits ne suffit pas
Lorsque nous comparons des ordinateurs classiques, nous regardons souvent leurs processeurs, leur mémoire et leurs capacités de traitement. Un processeur plus rapide ou davantage de mémoire peut améliorer les performances, même si le gain réel dépend de la charge de travail.
Il est naturel d’aborder les ordinateurs quantiques de la même manière. Si un processeur quantique compte 100 qubits et un autre 1 000, on pourrait supposer que la seconde machine est nettement plus puissante.
Mais l’informatique quantique pose un problème qui rend cette comparaison moins simple.
L’information quantique est fragile. Un qubit peut perdre l’état voulu à cause de perturbations de l’environnement, d’opérations imparfaites ou d’erreurs lors de la mesure. Même lorsque chaque opération est très précise, ces petites erreurs prennent de l’importance à mesure que les calculs s’allongent.
Prenons un ordinateur quantique dans lequel une opération à deux qubits a un taux d’erreur de 0,1 %, soit environ un échec toutes les 1 000 opérations.
Cela peut sembler acceptable pour une opération isolée. Pourtant, un algorithme quantique complexe pourrait nécessiter des millions ou des milliards d’opérations. Sans gestion efficace des erreurs, la probabilité de mener correctement à son terme un long calcul peut devenir très faible.
Comment les petites erreurs s’accumulent
Choisissez un taux d’erreur par opération et un nombre d’opérations. Le résultat est la probabilité que toutes les opérations, sans exception, réussissent, sans correction d’erreurs. Il s’agit d’une illustration : elle suppose que chaque opération échoue indépendamment, au même taux. Le matériel réel varie selon la plateforme et selon l’opération.
1 000 opérations d’affilée
Probabilité que toutes les opérations réussissent
36,8 %
| Opérations d’affilée, à 0,1 % par opération | Probabilité que toutes réussissent |
|---|---|
| 100 | 90,5 % |
| 1 000 | 36,8 % |
| 10 000 | environ 1 sur 22 000 |
| 100 000 | moins de 1 sur 10^43 |
| 1 000 000 | moins de 1 sur 10^434 |
| 1 000 000 000 | moins de 1 sur 10^434511 |
Ajouter des qubits n’améliore pas automatiquement la fiabilité. Ces qubits supplémentaires doivent eux aussi être contrôlés, mesurés et protégés des erreurs.
C’est là que la différence entre qubits physiques et qubits logiques prend toute son importance.
Que sont les qubits physiques et les qubits logiques ?
Un qubit physique est le matériel qui stocke concrètement l’information quantique. Selon la technologie, il peut s’agir d’un ion piégé, d’un atome neutre ou d’un circuit électrique supraconducteur.
Ces systèmes physiques se comportent différemment, mais ils partagent une même difficulté. Leurs états quantiques doivent rester suffisamment stables pendant que le processeur effectue des opérations.
Les chercheurs ont passé des années à améliorer la qualité des qubits physiques, à réduire les erreurs et à allonger la durée pendant laquelle l’information quantique peut être préservée.
Il existe pourtant une limite à ce que permet l’amélioration des qubits pris individuellement. Un ordinateur qui effectue de très longs calculs doit pouvoir gérer les erreurs même lorsque son matériel n’est pas parfait.
Les ordinateurs classiques assurent leur fiabilité de plusieurs façons. Une approche familière consiste à stocker l’information avec des bits supplémentaires afin de pouvoir détecter ou corriger les erreurs.
Les ordinateurs quantiques ont besoin d’une capacité comparable, même s’ils ne peuvent pas simplement copier un état quantique inconnu et comparer plusieurs copies identiques.
Ils utilisent à la place la correction d’erreurs quantique.
L’idée de base consiste à encoder l’information quantique sur plusieurs qubits physiques. Plutôt que de compter sur un seul qubit physique pour rester exempt d’erreurs, le système utilise un groupe de qubits pour protéger l’information qu’ils représentent collectivement.
Cette unité protégée s’appelle un qubit logique.
Un qubit logique n’est donc pas un autre type de matériel physique. C’est de l’information quantique encodée sur plusieurs qubits physiques au moyen d’un code correcteur d’erreurs.
Le nombre de qubits physiques nécessaires dépend du code, de la qualité du matériel et du niveau de protection requis.
La différence essentielle est que les qubits physiques fournissent le matériel, tandis que les qubits logiques offrent un moyen de protéger l’information en cours de traitement.
Comment fonctionne la correction d’erreurs quantique
L’idée de qubit logique se comprend plus facilement en suivant ce qui se passe après une erreur.
Supposons qu’une information quantique ait été encodée sur plusieurs qubits physiques. Pendant le fonctionnement, l’un de ces qubits subit une erreur.
Le système ne peut pas simplement lire chaque qubit pour trouver le problème. Mesurer directement l’information quantique protégée pourrait perturber ou détruire l’état nécessaire au calcul.
À la place, les codes correcteurs d’erreurs quantiques permettent au processeur de mesurer certaines relations entre les qubits sans révéler directement l’information encodée.
Ces mesures produisent ce que les chercheurs appellent un syndrome d’erreur.
Un syndrome d’erreur donne au système des indices sur ce qui a pu mal se passer. Un processus de décodage classique interprète ensuite ces indices et détermine la correction la plus probable.
Le processeur peut appliquer une opération corrective ou garder la trace de la correction, afin que les opérations et les mesures ultérieures soient interprétées correctement.
Comme des erreurs peuvent survenir tout au long d’un calcul, ce processus doit être répété.
L’objectif n’est pas de garantir que les qubits physiques ne tombent jamais en défaut. Il s’agit d’empêcher que des erreurs physiques individuelles modifient l’information logique dont dépend l’algorithme.
Il existe toutefois une limite importante. La correction d’erreurs n’est pas illimitée.
Si trop d’erreurs surviennent, ou si le système interprète mal l’information sur les erreurs, l’état logique protégé peut malgré tout être corrompu.
Cette défaillance résiduelle s’appelle une erreur logique.
La fiabilité d’un qubit logique dépend de l’efficacité avec laquelle le processus d’encodage et de correction réduit ces erreurs logiques.
Suivre une erreur au fil d’un cycle de correction
Parcourez les six étapes. Les neuf qubits reprennent l’image conceptuelle de l’article ; ce n’est ni une conception matérielle ni un code précis. Le texte de chaque étape reprend l’article ci-dessus.
Répartir l’information
Supposons qu’une information quantique ait été encodée sur plusieurs qubits physiques. Un qubit logique est de l’information quantique encodée sur plusieurs qubits physiques au moyen d’un code correcteur d’erreurs.
Un qubit subit une erreur
Pendant le fonctionnement, l’un de ces qubits subit une erreur. Le système ne peut pas simplement lire chaque qubit pour trouver le problème, car mesurer directement l’information quantique protégée pourrait perturber ou détruire l’état nécessaire au calcul.
Mesurer des relations, pas les données
Les codes correcteurs d’erreurs quantiques permettent au processeur de mesurer certaines relations entre les qubits sans révéler directement l’information encodée. Ces mesures produisent ce que les chercheurs appellent un syndrome d’erreur, qui donne au système des indices sur ce qui a pu mal se passer.
Déterminer la correction probable
Un processus de décodage classique interprète ces indices et détermine la correction la plus probable.
Appliquer la correction, ou en garder la trace
Le processeur peut appliquer une opération corrective ou garder la trace de la correction, afin que les opérations et les mesures ultérieures soient interprétées correctement.
Les erreurs continuent d’arriver
Comme des erreurs peuvent survenir tout au long d’un calcul, ce processus doit être répété. Il n’est pas illimité : si trop d’erreurs surviennent, ou si le système interprète mal l’information sur les erreurs, l’état logique protégé peut malgré tout être corrompu. Cette défaillance résiduelle s’appelle une erreur logique.
Qu’est-ce qui détermine la fiabilité d’un qubit logique ?
Tous les qubits logiques n’offrent pas le même niveau de protection.
Une propriété importante d’un code correcteur d’erreurs quantique est sa distance de code.
La distance de code désigne le poids minimal d’une erreur physique capable d’agir comme une opération logique non détectée. Selon les hypothèses standard des codes correcteurs d’erreurs quantiques, un code de distance 3 peut corriger une erreur physique arbitraire.
Augmenter la distance peut protéger contre davantage d’erreurs, mais exige aussi des ressources physiques supplémentaires.
Cela soulève une question pratique : si nous utilisons davantage de qubits physiques pour protéger un qubit logique, le résultat deviendra-t-il réellement plus fiable ?
La réponse dépend de la qualité du matériel sous-jacent et du processus de correction.
La correction d’erreurs elle-même fait intervenir des opérations et des mesures qui peuvent échouer. Lorsque les taux d’erreur physiques sont trop élevés, ajouter des ressources peut introduire des problèmes supplémentaires au lieu de les réduire.
Les chercheurs appellent seuil de correction d’erreurs la limite à partir de laquelle l’augmentation de la taille du code peut commencer à améliorer la fiabilité.
En dessous du seuil applicable, des codes plus grands peuvent produire des taux d’erreur logique plus faibles. Au-dessus, augmenter la distance de code peut ne pas améliorer la fiabilité.
C’est l’un des jalons les plus importants de l’informatique quantique, car il montre si du matériel supplémentaire peut servir à rendre l’information quantique protégée de plus en plus fiable.
On peut observer ce principe dans la recherche expérimentale.
Dans des travaux publiés dans Nature, Google a démontré une correction d’erreurs quantique sous le seuil du code de surface. Les chercheurs ont rapporté que les erreurs logiques diminuaient à mesure que la distance de code augmentait, avec un facteur de suppression des erreurs d’environ 2,14 pour chaque augmentation de deux de la distance de code sur la séquence testée.
En octobre 2026, Quantinuum a rapporté un facteur de suppression d’environ 12 pour chaque augmentation successive dans la séquence testée de distances du code couleur.
Les expériences reposaient sur des matériels et des codes correcteurs d’erreurs différents ; leurs résultats chiffrés ne doivent donc pas être lus comme un simple classement de performances.
Ce qui rend ces deux résultats importants, c’est la relation démontrée entre un encodage plus fort et des taux d’erreur logique plus faibles.
Elle montre des progrès vers des systèmes quantiques dont la fiabilité peut s’améliorer à mesure que des ressources physiques supplémentaires sont ajoutées.
Un qubit logique fiable n’est pas encore un ordinateur quantique complet
Une fois que l’on a compris comment les qubits logiques protègent l’information, une autre question se pose.
Si les chercheurs savent créer des qubits logiques très fiables, pourquoi des ordinateurs quantiques tolérants aux fautes et utiles restent-ils si difficiles à construire ?
C’est que stocker l’information quantique et calculer avec elle sont deux défis d’ingénierie différents.
Un qubit logique peut être capable de préserver son état encodé au fil de nombreux cycles de correction d’erreurs. C’est ce qu’on appelle la mémoire logique.
Mais un ordinateur quantique doit aussi effectuer des opérations sur cette information. Ces opérations s’appellent des portes logiques lorsqu’elles agissent sur des qubits encodés.
Exécuter une porte logique est plus compliqué que de simplement maintenir stable l’information encodée. L’opération doit produire le résultat voulu sans introduire d’erreurs qui submergent la protection apportée par le code.
Les ordinateurs quantiques doivent également coordonner de nombreux qubits logiques, effectuer des mesures, traiter l’information sur les erreurs et mener les calculs à terme dans des temps de fonctionnement réalistes.
Les travaux publiés par Quantinuum en octobre 2026 illustrent cette distinction.
L’entreprise a rapporté un taux d’erreur de mémoire logique d’environ cinq sur un million par cycle de correction d’erreurs, à une distance de code de 7.
C’est un résultat important pour la préservation de l’information quantique. Cependant, ses expériences de portes logiques ont atteint la distance 5 et utilisaient des circuits de Clifford plutôt qu’un ensemble universel d’opérations logiques. Les chercheurs ont aussi évalué des approches de décodage dont les vitesses de traitement sont potentiellement compatibles avec un fonctionnement en temps réel, mais les expériences rapportées n’ont pas démontré de boucle intégrée de décodage en temps réel et de rétroaction corrective.
Le résultat apporte la preuve d’une solide protection de la mémoire logique et de progrès vers des portes logiques fiables. Il ne démontre pas encore le processus complet de calcul tolérant aux fautes nécessaire aux algorithmes quantiques généraux.
Ce que montre le résultat de Quantinuum d’octobre 2026, et ce qu’il ne montre pas
Choisissez un élément d’un ordinateur tolérant aux fautes pour voir jusqu’où va cette seule expérience. Le texte reprend l’article ci-dessus.
Préserver l’information encodéedémontré
L’entreprise a rapporté un taux d’erreur de mémoire logique d’environ cinq sur un million par cycle de correction d’erreurs, à une distance de code de 7. C’est un résultat important pour la préservation de l’information quantique.
Source : Quantinuum, prépublication d’octobre 2026 (pas encore évaluée par les pairs au moment de la vérification des sources). arXiv:2610.24077
Opérer sur des qubits encodéspartiellement démontré
Les expériences de portes logiques ont atteint la distance 5 et utilisaient des circuits de Clifford plutôt qu’un ensemble universel d’opérations logiques.
Décoder assez vite, dans la bouclenon démontré
Les chercheurs ont évalué des approches de décodage dont les vitesses de traitement sont potentiellement compatibles avec un fonctionnement en temps réel, mais les expériences rapportées n’ont pas démontré de boucle intégrée de décodage en temps réel et de rétroaction corrective.
Exécuter des algorithmes quantiques générauxnon démontré
Le résultat apporte la preuve d’une solide protection de la mémoire logique et de progrès vers des portes logiques fiables. Il ne démontre pas encore le processus complet de calcul tolérant aux fautes nécessaire aux algorithmes quantiques généraux.
La vitesse des opérations compte aussi. Deux machines pourraient annoncer des taux d’erreur similaires par cycle de correction tout en mettant des durées très différentes pour effectuer ces cycles.
Un ordinateur quantique exploitable doit trouver l’équilibre entre fiabilité, vitesse de traitement, capacité de décodage et exigences en matériel physique.
C’est pourquoi le développement des qubits logiques est une étape majeure vers l’informatique quantique tolérante aux fautes, mais pas la dernière.
Comment interpréter les annonces en informatique quantique ?
Imaginons maintenant l’annonce d’une entreprise affirmant avoir démontré 30 qubits logiques.
Ce résultat nous apprend que les chercheurs ont créé un système quantique encodé particulier. Mais pour en mesurer la portée, il faudrait savoir comment ces qubits étaient protégés, avec quelle fiabilité ils fonctionnaient et quels calculs ont été démontrés.
De même, l’annonce de taux d’erreur logique extrêmement faibles demande du contexte. Le taux d’erreur a-t-il été mesuré pendant le stockage de l’information ou pendant des opérations logiques ? A-t-il été mesuré par porte, par cycle de vérification ou sur une période donnée ? Le système est-il devenu plus fiable à mesure que la distance de code augmentait ?
Ces détails expliquent ce dont le matériel est réellement capable.
Lire une annonce quantique
Répondez à deux questions au plus. Cette aide à la lecture est propre à TechiesJournal et s’appuie sur cette section. Elle ne constitue le verdict d’aucune annonce réelle.
Que compte l’annonce ?
Demandez comment ils étaient protégés. Ce résultat nous apprend que les chercheurs ont créé un système quantique encodé particulier. Pour en mesurer la portée, il faudrait savoir comment ces qubits étaient protégés, avec quelle fiabilité ils fonctionnaient et quels calculs ont été démontrés.
Le taux a-t-il été mesuré pendant le stockage de l’information ou pendant des opérations logiques ?
Un résultat de mémoire. Demandez s’il a été mesuré par porte, par cycle de vérification ou sur une période donnée, et si le système est devenu plus fiable à mesure que la distance de code augmentait.
Un résultat sur les opérations. Demandez s’il a été mesuré par porte, par cycle de vérification ou sur une période donnée, et si le système est devenu plus fiable à mesure que la distance de code augmentait.
Posez d’abord cette question. L’annonce de taux d’erreur logique extrêmement faibles demande du contexte. Le taux d’erreur a-t-il été mesuré pendant le stockage de l’information ou pendant des opérations logiques ? A-t-il été mesuré par porte, par cycle de vérification ou sur une période donnée ?
S’agit-il d’une estimation des ressources ou d’une machine qui a exécuté le calcul ?
Une estimation, pas une démonstration. Ces estimations sont utiles pour comprendre les besoins futurs potentiels. Elles ne démontrent pas que le matériel quantique existant peut mener ce calcul à terme. Lisez les hypothèses matérielles qui sous-tendent le chiffre.
Demandez ce qu’elle a calculé. Ces détails expliquent ce dont le matériel est réellement capable : comment les qubits étaient protégés, avec quelle fiabilité ils fonctionnaient et quels calculs ont été démontrés.
Le même principe s’applique aux estimations concernant les futurs ordinateurs quantiques.
Par exemple, des chercheurs ont publié des estimations du nombre de qubits physiques qui pourraient être nécessaires pour factoriser RSA-2048 avec un ordinateur quantique tolérant aux fautes.
L’estimation des ressources de 2025 de Craig Gidney décrivait une approche possible utilisant moins d’un million de qubits physiques bruités, sous des hypothèses matérielles précises. L’étude Pinnacle 1.2 d’Iceberg Quantum a ensuite rapporté des estimations simulées de 48 000 à 72 000 qubits physiques pour un cycle de code d’une microseconde, avec une autre architecture proposée et d’autres hypothèses. Pour un cycle de code d’une milliseconde, la même étude indique de 714 000 à 2,1 millions.
Ces estimations sont utiles pour comprendre les besoins futurs potentiels. Elles ne démontrent pas que le matériel quantique existant peut mener ce calcul à terme.
Cette distinction compte particulièrement pour la planification de la sécurité. Les organisations devraient se préparer à la cryptographie post-quantique en s’appuyant sur les recommandations de sécurité établies et sur la durée de vie des informations qu’elles doivent protéger, plutôt que d’attendre un palier particulier en nombre de qubits.
Pour en savoir plus sur ce sujet, consultez l’article de TechiesJournal La cryptographie post-quantique activée par défaut (en anglais).
Qu’est-ce qui compte à mesure que les ordinateurs quantiques progressent ?
Construire un ordinateur quantique utile exige des progrès simultanés dans plusieurs domaines.
Les qubits physiques doivent devenir plus fiables. Les codes correcteurs d’erreurs doivent protéger l’information quantique sans introduire de surcoût excessif. Les opérations logiques doivent être suffisamment précises pour permettre de longs calculs, et les systèmes classiques chargés de décoder les erreurs doivent suivre le rythme du matériel quantique.
Ces exigences sont étroitement liées. Améliorer un élément ne résout pas automatiquement les autres.
Pour quelqu’un qui découvre l’informatique quantique, comprendre cette relation est plus utile que de mémoriser les dernières caractéristiques des processeurs.
Pour les ingénieurs et les chercheurs qui travaillent directement sur des systèmes quantiques, les défis plus profonds portent sur la conception des codes, les algorithmes de décodage, le comportement du bruit, la mise en œuvre des portes logiques et le coût physique de la montée en échelle de l’architecture.
L’informatique quantique continuera de produire des résultats expérimentaux impressionnants. Certains démontreront de meilleurs qubits physiques, d’autres une correction d’erreurs plus efficace ou de nouvelles façons d’effectuer des opérations logiques.
La portée de ces avancées dépend de leur contribution à l’objectif d’ingénierie plus large.
Les qubits physiques rendent le calcul quantique possible. Les qubits logiques permettent de protéger l’information quantique contre les erreurs. L’informatique quantique tolérante aux fautes exige que cette protection reste efficace pendant l’exécution d’algorithmes utiles.
La vraie mesure du progrès n’est pas le nombre de qubits que contient une machine, mais la capacité de ces qubits à fonctionner ensemble de manière suffisamment fiable pour mener à bien des calculs significatifs.
Pour aller plus loin
- Quantum Error Correction Below the Surface Code Threshold, recherche de Google Quantum AI, publiée dans Nature. Explique comment l’augmentation de la distance de code peut réduire les erreurs logiques.
- Quantum Error Correction Well Below the Color Code Threshold, Quantinuum, prépublication d’octobre 2026. Examine la protection de la mémoire logique et la suppression des erreurs à l’aide de codes couleur.
- From Memory to Logic, Quantinuum, 13 novembre 2025. Explore les différences d’ingénierie entre la protection de la mémoire quantique et l’exécution d’opérations logiques.
- How to Factor 2048 Bit RSA Integers with Less Than a Million Noisy Qubits, Craig Gidney, 2025. Montre comment les architectures tolérantes aux fautes influencent les estimations des ressources nécessaires à un algorithme quantique complexe.
- Pinnacle 1.2, Iceberg Quantum, 22 octobre 2026. Présentation originale, par l’entreprise, des estimations simulées de ressources pour RSA-2048 et de leurs hypothèses.
Recherches examinées le 30 octobre 2026. Les résultats expérimentaux, les prépublications et les estimations de ressources sont présentés selon les éléments de preuve qu’ils avancent. Revérifier les résultats susceptibles d’évoluer avant toute publication publique.