

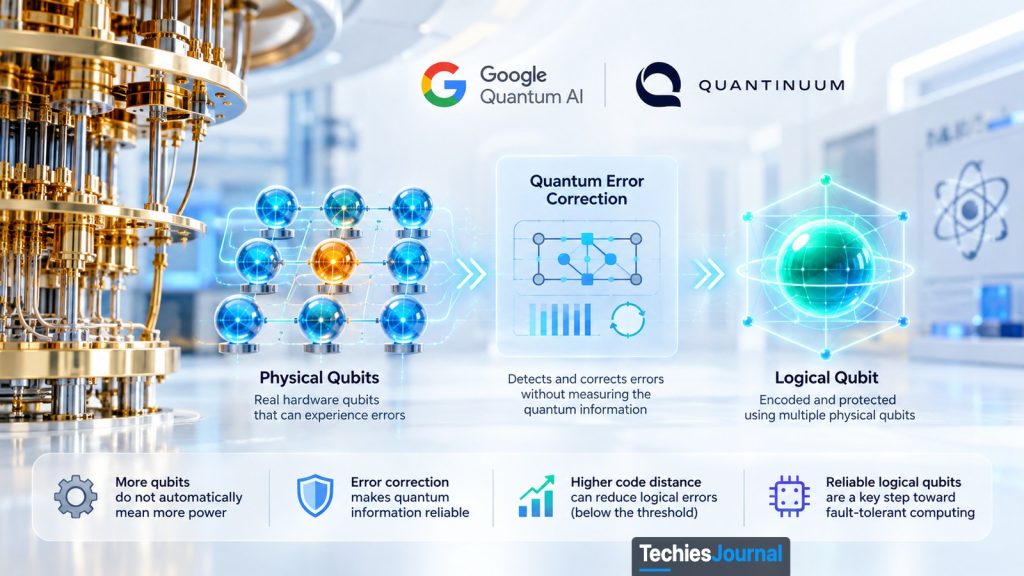
Las computadoras cuánticas suelen compararse por el número de cúbits que contienen. Pero tener más cúbits no significa necesariamente tener una computadora más capaz. Para entender por qué, hay que ver cómo se almacena la información cuántica, cómo se producen los errores y qué resuelven realmente los cúbits lógicos.
Por qué no basta con tener más cúbits
Cuando comparamos computadoras convencionales, solemos fijarnos en sus procesadores, su memoria y su capacidad de procesamiento. Un procesador más rápido o más memoria pueden mejorar el rendimiento, aunque el beneficio real depende de la carga de trabajo.
Es natural abordar las computadoras cuánticas de forma parecida. Si un procesador cuántico tiene 100 cúbits y otro tiene 1000, podríamos suponer que la segunda máquina es bastante más potente.
Pero la computación cuántica tiene un problema que hace que esta comparación no sea tan sencilla.
La información cuántica es frágil. Un cúbit puede perder el estado previsto por perturbaciones del entorno, por operaciones imperfectas o por errores durante la medición. Incluso cuando las operaciones individuales son muy precisas, esos pequeños errores cobran importancia a medida que los cálculos se alargan.
Piensa en una computadora cuántica en la que una operación de dos cúbits tiene una tasa de error del 0.1 %, es decir, aproximadamente un fallo por cada 1000 operaciones.
Puede parecer aceptable para una operación individual. Sin embargo, un algoritmo cuántico complejo podría requerir millones o miles de millones de operaciones. Sin una gestión eficaz de los errores, la probabilidad de completar correctamente un cálculo largo puede llegar a ser muy baja.
Cómo se acumulan los pequeños errores
Elige una tasa de error por operación y un número de operaciones. El resultado es la probabilidad de que todas y cada una de las operaciones funcionen, sin corrección de errores. Es una ilustración: supone que cada operación falla de forma independiente y con la misma tasa. El hardware real varía según la plataforma y según la operación.
1000 operaciones seguidas
Probabilidad de que todas las operaciones funcionen
36.8 %
| Operaciones seguidas, con un 0.1 % de error por operación | Probabilidad de que todas funcionen |
|---|---|
| 100 | 90.5 % |
| 1000 | 36.8 % |
| 10 000 | aproximadamente 1 entre 22 000 |
| 100 000 | menos de 1 entre 10^43 |
| 1 000 000 | menos de 1 entre 10^434 |
| 1 000 000 000 | menos de 1 entre 10^434511 |
Añadir más cúbits no mejora automáticamente la fiabilidad. Esos cúbits adicionales también hay que controlarlos, medirlos y protegerlos de los errores.
Aquí es donde cobra importancia la diferencia entre cúbits físicos y lógicos.
¿Qué son los cúbits físicos y lógicos?
Un cúbit físico es el hardware real que almacena la información cuántica. Según la tecnología, puede ser un ion atrapado, un átomo neutro o un circuito eléctrico superconductor.
Estos sistemas físicos se comportan de forma distinta, pero comparten un mismo reto: sus estados cuánticos deben mantenerse lo bastante estables mientras el procesador realiza operaciones.
Los investigadores llevan años mejorando la calidad de los cúbits físicos, reduciendo los errores y alargando el tiempo durante el que se puede conservar la información cuántica.
Aun así, lo que se puede lograr mejorando cúbits individuales tiene un límite. Una computadora que realiza cálculos muy largos debe poder gestionar los errores aunque su hardware no sea perfecto.
Las computadoras convencionales abordan la fiabilidad de varias maneras. Un enfoque conocido es almacenar la información con bits adicionales para poder detectar o corregir errores.
Las computadoras cuánticas necesitan una capacidad parecida, aunque no pueden limitarse a copiar un estado cuántico desconocido y comparar varias copias idénticas.
En su lugar, utilizan la corrección cuántica de errores.
La idea básica es codificar la información cuántica en varios cúbits físicos. En lugar de depender de que un solo cúbit físico se mantenga libre de errores, el sistema usa un grupo de cúbits para proteger la información que representan en conjunto.
Esta unidad protegida se llama cúbit lógico.
Por tanto, un cúbit lógico no es otro tipo de hardware físico. Es información cuántica codificada en varios cúbits físicos mediante un código corrector de errores.
El número de cúbits físicos necesarios depende del código, de la calidad del hardware y del nivel de protección requerido.
La diferencia importante es que los cúbits físicos aportan el hardware, mientras que los cúbits lógicos aportan una forma de proteger la información que se está procesando.
Cómo funciona la corrección cuántica de errores
La idea de cúbit lógico se entiende mejor si seguimos lo que ocurre después de que se produce un error.
Supongamos que la información cuántica se ha codificado en varios cúbits físicos. Durante el funcionamiento, uno de esos cúbits sufre un error.
El sistema no puede limitarse a leer cada cúbit para encontrar el problema. Medir directamente la información cuántica protegida podría perturbar o destruir el estado que necesita el cálculo.
En su lugar, los códigos cuánticos correctores de errores permiten al procesador medir ciertas relaciones entre cúbits sin revelar directamente la información codificada.
Estas mediciones producen lo que los investigadores llaman un síndrome de error.
Un síndrome de error da al sistema pistas sobre lo que puede haber fallado. Después, un proceso de decodificación clásica interpreta esas pistas y determina la corrección más probable.
El procesador puede aplicar una operación correctiva o llevar el registro de la corrección para que las operaciones y mediciones posteriores se interpreten correctamente.
Como los errores pueden producirse a lo largo de todo un cálculo, este proceso debe repetirse.
El objetivo no es garantizar que los cúbits físicos nunca fallen, sino evitar que los errores físicos individuales alteren la información lógica de la que depende el algoritmo.
Sin embargo, hay una limitación importante: la corrección de errores no es ilimitada.
Si se producen demasiados errores, o si el sistema interpreta mal la información sobre los errores, el estado lógico protegido puede corromperse de todos modos.
Ese fallo residual se llama error lógico.
La fiabilidad de un cúbit lógico depende de la eficacia con la que el proceso de codificación y corrección reduce estos errores lógicos.
Sigue un error a lo largo de un ciclo de corrección
Recorre las seis etapas. Los nueve cúbits son la imagen conceptual del artículo, no un diseño de hardware ni un código concreto. El texto de cada paso repite lo que dice el artículo más arriba.
Repartir la información
Supongamos que la información cuántica se ha codificado en varios cúbits físicos. Un cúbit lógico es información cuántica codificada en varios cúbits físicos mediante un código corrector de errores.
Un cúbit falla
Durante el funcionamiento, uno de esos cúbits sufre un error. El sistema no puede limitarse a leer cada cúbit para encontrar el problema, porque medir directamente la información cuántica protegida podría perturbar o destruir el estado que necesita el cálculo.
Medir relaciones, no los datos
Los códigos cuánticos correctores de errores permiten al procesador medir ciertas relaciones entre cúbits sin revelar directamente la información codificada. Estas mediciones producen lo que los investigadores llaman un síndrome de error, que da al sistema pistas sobre lo que puede haber fallado.
Deducir la corrección probable
Un proceso de decodificación clásica interpreta esas pistas y determina la corrección más probable.
Aplicar la corrección o llevar su registro
El procesador puede aplicar una operación correctiva o llevar el registro de la corrección para que las operaciones y mediciones posteriores se interpreten correctamente.
Los errores siguen llegando
Como los errores pueden producirse a lo largo de todo un cálculo, este proceso debe repetirse. No es ilimitado: si se producen demasiados errores, o si el sistema interpreta mal la información sobre los errores, el estado lógico protegido puede corromperse de todos modos. Ese fallo residual se llama error lógico.
¿Qué determina la fiabilidad de un cúbit lógico?
No todos los cúbits lógicos ofrecen el mismo nivel de protección.
Una propiedad importante de un código cuántico corrector de errores es su distancia del código.
La distancia del código describe el peso mínimo de un error físico que puede actuar como una operación lógica no detectada. Con los supuestos habituales de los códigos cuánticos correctores de errores, un código de distancia 3 puede corregir un error físico arbitrario.
Aumentar la distancia puede proteger frente a más errores, pero también exige recursos físicos adicionales.
Esto plantea una pregunta práctica: si usamos más cúbits físicos para proteger un cúbit lógico, ¿el resultado será realmente más fiable?
La respuesta depende de la calidad del hardware subyacente y del proceso de corrección.
La propia corrección de errores implica operaciones y mediciones que pueden fallar. Cuando las tasas de error físico son demasiado altas, añadir más recursos puede introducir problemas adicionales en lugar de reducirlos.
Los investigadores llaman umbral de corrección de errores al límite a partir del cual aumentar el tamaño del código puede empezar a mejorar la fiabilidad.
Por debajo del umbral correspondiente, los códigos más grandes pueden producir tasas de error lógico más bajas. Por encima de él, aumentar la distancia del código puede no mejorar la fiabilidad.
Es uno de los hitos más importantes de la computación cuántica, porque demuestra si el hardware adicional puede servir para que la información cuántica protegida sea cada vez más fiable.
Este principio se puede ver en la investigación experimental.
En un trabajo publicado en Nature, Google demostró la corrección cuántica de errores por debajo del umbral del código de superficie. Los investigadores informaron de que los errores lógicos disminuían a medida que aumentaba la distancia del código, con un factor de supresión de errores de aproximadamente 2.14 por cada aumento de dos en la distancia del código a lo largo de la secuencia probada.
En octubre de 2026, Quantinuum informó de un factor de supresión de aproximadamente 12 por cada aumento sucesivo en la secuencia de distancias del código de color que se probó.
Los experimentos usaron hardware y códigos correctores de errores distintos, así que sus resultados numéricos no deben tratarse como una simple clasificación de rendimiento.
Lo que hace importantes ambos resultados es la relación demostrada entre una codificación más robusta y unas tasas de error lógico más bajas.
Esa relación muestra avances hacia la construcción de sistemas cuánticos cuya fiabilidad puede mejorar a medida que se incorporan recursos físicos adicionales.
Un cúbit lógico fiable todavía no es una computadora cuántica completa
Una vez que entendemos cómo protegen la información los cúbits lógicos, surge otra pregunta.
Si los investigadores pueden crear cúbits lógicos muy fiables, ¿por qué sigue siendo tan difícil construir computadoras cuánticas tolerantes a fallos que resulten útiles?
La respuesta es que almacenar información cuántica y calcular con ella son retos de ingeniería distintos.
Un cúbit lógico puede llegar a conservar su estado codificado a lo largo de muchas rondas de corrección de errores. Esto se conoce como memoria lógica.
Pero una computadora cuántica también necesita realizar operaciones con esa información. Cuando actúan sobre cúbits codificados, estas operaciones se llaman puertas lógicas.
Ejecutar una puerta lógica es más complicado que simplemente mantener estable la información codificada. La operación debe producir el resultado previsto sin introducir errores que superen la protección que ofrece el código.
Las computadoras cuánticas también necesitan coordinar muchos cúbits lógicos, realizar mediciones, procesar la información sobre errores y completar los cálculos en tiempos de funcionamiento prácticos.
La investigación de Quantinuum de octubre de 2026 ilustra esta distinción.
La empresa informó de una tasa de error de memoria lógica de aproximadamente cinco por millón por ronda de corrección de errores con una distancia del código de 7.
Es un resultado importante para conservar la información cuántica. Sin embargo, sus experimentos con puertas lógicas llegaron a una distancia de 5 y usaron circuitos de Clifford en lugar de un conjunto universal de operaciones lógicas. Los investigadores también evaluaron enfoques de decodificación con velocidades de procesamiento potencialmente compatibles con el funcionamiento en tiempo real, pero los experimentos publicados no demostraron un bucle integrado de decodificación en tiempo real y retroalimentación correctiva.
El resultado aporta pruebas de una protección sólida de la memoria lógica y de avances hacia puertas lógicas fiables. Todavía no demuestra el proceso completo de computación tolerante a fallos que necesitan los algoritmos cuánticos generales.
Qué muestra el resultado de Quantinuum de octubre de 2026 y qué no
Elige una parte de una computadora tolerante a fallos para ver hasta dónde llega este experimento concreto. El texto repite lo que dice el artículo más arriba.
Mantener viva la información codificadademostrado
La empresa informó de una tasa de error de memoria lógica de aproximadamente cinco por millón por ronda de corrección de errores con una distancia del código de 7. Es un resultado importante para conservar la información cuántica.
Fuente: Quantinuum, preprint de octubre de 2026 (aún sin revisión por pares cuando se verificó la fuente). arXiv:2610.24077
Operar con cúbits codificadosdemostrado en parte
Los experimentos con puertas lógicas llegaron a una distancia de 5 y usaron circuitos de Clifford en lugar de un conjunto universal de operaciones lógicas.
Decodificar con suficiente rapidez, dentro del bucleno demostrado
Los investigadores evaluaron enfoques de decodificación con velocidades de procesamiento potencialmente compatibles con el funcionamiento en tiempo real, pero los experimentos publicados no demostraron un bucle integrado de decodificación en tiempo real y retroalimentación correctiva.
Ejecutar algoritmos cuánticos generalesno demostrado
El resultado aporta pruebas de una protección sólida de la memoria lógica y de avances hacia puertas lógicas fiables. Todavía no demuestra el proceso completo de computación tolerante a fallos que necesitan los algoritmos cuánticos generales.
La velocidad de operación también importa. Dos máquinas podrían declarar tasas de error similares por ronda de corrección y, sin embargo, tardar tiempos muy distintos en completar esas rondas.
Una computadora cuántica práctica debe equilibrar la fiabilidad, la velocidad de procesamiento, la capacidad de decodificación y los requisitos del hardware físico.
Por eso el desarrollo de los cúbits lógicos es un paso importante hacia la computación cuántica tolerante a fallos, pero no el último.
¿Cómo debemos interpretar los anuncios sobre computación cuántica?
Piensa ahora en un anuncio de que una empresa ha demostrado 30 cúbits lógicos.
El resultado nos dice que los investigadores crearon un sistema cuántico codificado concreto. Pero, para entender su relevancia, necesitaríamos saber cómo se protegieron esos cúbits, con qué fiabilidad funcionaron y qué cálculos se demostraron.
Del mismo modo, un anuncio de tasas de error lógico extremadamente bajas necesita contexto. ¿La tasa de error se midió al almacenar información o al realizar operaciones lógicas? ¿Se midió por puerta, por ronda de comprobación o durante un periodo de tiempo? ¿El sistema se volvió más fiable al aumentar la distancia del código?
Estos detalles explican lo que el hardware puede hacer realmente.
Cómo leer un anuncio cuántico
Responde hasta dos preguntas. Es una ayuda de lectura propia de TechiesJournal, elaborada a partir de esta sección. No es un veredicto sobre ningún anuncio real.
¿Qué contabiliza el anuncio?
Pregunta cómo se protegieron. El resultado nos dice que los investigadores crearon un sistema cuántico codificado concreto. Para entender su relevancia, necesitaríamos saber cómo se protegieron esos cúbits, con qué fiabilidad funcionaron y qué cálculos se demostraron.
¿La tasa se midió al almacenar información o al realizar operaciones lógicas?
Un resultado de memoria. Pregunta si se midió por puerta, por ronda de comprobación o durante un periodo de tiempo, y si el sistema se volvió más fiable al aumentar la distancia del código.
Un resultado de operaciones. Pregunta si se midió por puerta, por ronda de comprobación o durante un periodo de tiempo, y si el sistema se volvió más fiable al aumentar la distancia del código.
Pregunta eso primero. Un anuncio de tasas de error lógico extremadamente bajas necesita contexto. ¿La tasa de error se midió al almacenar información o al realizar operaciones lógicas? ¿Se midió por puerta, por ronda de comprobación o durante un periodo de tiempo?
¿Es una estimación de recursos o una máquina que ejecutó el cálculo?
Una estimación, no una demostración. Estas estimaciones son útiles para entender los posibles requisitos futuros. No demuestran que el hardware cuántico actual pueda completar el cálculo. Lee los supuestos de hardware que hay detrás de la cifra.
Pregunta qué calculó. Estos detalles explican lo que el hardware puede hacer realmente: cómo se protegieron los cúbits, con qué fiabilidad funcionaron y qué cálculos se demostraron.
El mismo principio se aplica a las estimaciones sobre futuras computadoras cuánticas.
Por ejemplo, varios investigadores han publicado estimaciones de cuántos cúbits físicos podrían hacer falta para factorizar RSA-2048 con una computadora cuántica tolerante a fallos.
La estimación de recursos de 2025 de Craig Gidney describió un posible enfoque con menos de un millón de cúbits físicos ruidosos, bajo supuestos de hardware específicos. Posteriormente, el estudio Pinnacle 1.2 de Iceberg Quantum informó de estimaciones simuladas de 48 000 a 72 000 cúbits físicos con un ciclo de código de un microsegundo, usando una arquitectura propuesta y unos supuestos diferentes. Con un ciclo de código de un milisegundo, el mismo estudio da entre 714 000 y 2.1 millones.
Estas estimaciones son útiles para entender los posibles requisitos futuros. No demuestran que el hardware cuántico actual pueda completar el cálculo.
La distinción es especialmente importante para la planificación de la seguridad. Las organizaciones deberían prepararse para la criptografía poscuántica a partir de las recomendaciones de seguridad establecidas y de la vida útil de la información que necesitan proteger, en lugar de esperar a que se alcance un número concreto de cúbits.
Para saber más sobre ese tema, consulta el artículo de TechiesJournal La criptografía poscuántica pasa a estar activada por defecto (en inglés).
¿Qué importa a medida que se desarrollan las computadoras cuánticas?
Construir una computadora cuántica útil requiere avances en varias áreas a la vez.
Los cúbits físicos deben ser más fiables. Los códigos correctores de errores deben proteger la información cuántica sin introducir una sobrecarga excesiva. Las operaciones lógicas deben funcionar con la precisión suficiente para sostener cálculos largos, y los sistemas clásicos encargados de decodificar los errores deben seguir el ritmo del hardware cuántico.
Estos requisitos están estrechamente relacionados. Mejorar una parte no resuelve automáticamente las demás.
Para quien está aprendiendo sobre computación cuántica, entender esta relación es más útil que memorizar las especificaciones del último procesador.
Para los ingenieros e investigadores que trabajan directamente con sistemas cuánticos, los retos de fondo tienen que ver con el diseño de códigos, los algoritmos de decodificación, el comportamiento del ruido, la implementación de puertas lógicas y el costo físico de escalar la arquitectura.
La computación cuántica seguirá produciendo resultados experimentales impresionantes. Algunos demostrarán cúbits físicos mejores; otros, una corrección de errores más eficaz o nuevas formas de realizar operaciones lógicas.
La relevancia de esos avances depende de cómo contribuyan al objetivo de ingeniería más amplio.
Los cúbits físicos hacen posible la computación cuántica. Los cúbits lógicos permiten proteger la información cuántica de los errores. La computación cuántica tolerante a fallos exige que esa protección siga siendo eficaz mientras se ejecutan algoritmos útiles.
La verdadera medida del progreso no es cuántos cúbits tiene una máquina, sino si esos cúbits pueden trabajar juntos con la fiabilidad suficiente para completar cálculos significativos.
Para profundizar
- Quantum Error Correction Below the Surface Code Threshold, investigación de Google Quantum AI publicada en Nature. Explica cómo aumentar la distancia del código puede reducir los errores lógicos.
- Quantum Error Correction Well Below the Color Code Threshold, Quantinuum, preprint de octubre de 2026. Analiza la protección de la memoria lógica y la supresión de errores con códigos de color.
- From Memory to Logic, Quantinuum, 13 de noviembre de 2025. Explora las diferencias de ingeniería entre proteger la memoria cuántica y realizar operaciones lógicas.
- How to Factor 2048 Bit RSA Integers with Less Than a Million Noisy Qubits, Craig Gidney, 2025. Muestra cómo influyen las arquitecturas tolerantes a fallos en las estimaciones de los recursos necesarios para un algoritmo cuántico complejo.
- Pinnacle 1.2, Iceberg Quantum, 22 de octubre de 2026. Relato original de la empresa sobre las estimaciones simuladas de recursos para RSA-2048 y sus supuestos.
Investigación revisada: 30 de octubre de 2026. Los hallazgos experimentales, los preprints y las estimaciones de recursos se presentan según la evidencia que declaran. Vuelve a comprobar los resultados sujetos a cambios antes de la publicación pública.