आप एक AI असिस्टेंट से पूछते हैं:
“हमारी कंपनी की पॉलिसी के मुताबिक, अगले साल में मैं कितने वेकेशन दिन कैरी कर सकता हूं?”
कुछ सेकंड बाद, आपको एक जवाब मिलता है।
यह बातचीत आसान लगती है। आपने एक सवाल पूछा; AI ने उसका जवाब दिया।
लेकिन उन दोनों बिंदुओं के बीच कई अलग-अलग चीज़ें हो सकती थीं।
AI ने ट्रेनिंग के दौरान सीखे गए पैटर्न का इस्तेमाल करके जवाब दिया हो सकता है। उसने आपके अपलोड किए गए दस्तावेज़ को पढ़ा हो सकता है। उसने कंपनी के नॉलेज बेस को खोजा हो सकता है, कुछ सही पैराग्राफ़ रिट्रीव किए हो सकते हैं, या मौजूदा जानकारी पाने के लिए किसी और सिस्टम को कॉल किया हो सकता है।
ये फ़र्क़ मायने रखते हैं क्योंकि ये तय करते हैं कि जवाब कहां से आया, वह कितना ताज़ा है, उसके पीछे क्या सबूत है, और आपको उस पर कितना भरोसा करना चाहिए।
इस सीरीज़ के भाग 1 में, हमने AI के पीछे की भाषा सीखी: मॉडल, ट्रेनिंग, इन्फरेंस, प्रॉम्प्ट, टोकन और कॉन्टेक्स्ट विंडो।
अब हम इन शब्दों का मतलब क्या है से आगे बढ़कर जब हम असल में AI का इस्तेमाल करते हैं तो क्या होता है की ओर जाते हैं।
इस पूरे लेख में याद रखने वाला सवाल आसान है:
यह जवाब कहां से आया?
मॉडल को वह सब अपने-आप नहीं पता होता जो एप्लिकेशन को पता है
एक AI मॉडल और एक AI एप्लिकेशन एक जैसे नहीं हैं।
मॉडल के पास ट्रेनिंग के दौरान सीखे गए पैटर्न होते हैं।
उसके आस-पास का एप्लिकेशन अतिरिक्त जानकारी और क्षमताओं तक पहुंच दे सकता है।
एक AI असिस्टेंट यह कर सकता है:
- अपलोड किया गया दस्तावेज़ पढ़ना;
- वेब पर खोजना;
- कंपनी के नॉलेज बेस में खोजना;
- किसी स्वीकृत डेटाबेस से पूछताछ करना;
- चुनी हुई जानकारी याद रखना;
- सॉफ़्टवेयर टूल इस्तेमाल करना;
- किसी और सिस्टम में कुछ बनाना या अपडेट करना।
अंतर्निहित मॉडल के पास वह सारी जानकारी अपने-आप नहीं होती।
बातचीत के दौरान कौन-सी जानकारी और टूल उपलब्ध हैं, यह एप्लिकेशन तय करता है।
यही एक वजह है कि सक्षम भाषा मॉडल इस्तेमाल करने के बावजूद दो AI प्रोडक्ट अलग-अलग तरह से व्यवहार कर सकते हैं।
सबसे आसान मामले से शुरू करें
मान लीजिए आपकी कंपनी की लीव पॉलिसी कहती है:
कर्मचारियों को 20 दिन की सालाना छुट्टी मिलती है। इस्तेमाल न हुए 5 दिन तक अगले साल में कैरी किए जा सकते हैं।
आप पूछते हैं:
“अगले साल में मैं कितने वेकेशन दिन कैरी कर सकता हूं?”
अगर आपने पॉलिसी नहीं दी है और एप्लिकेशन उसे एक्सेस नहीं कर सकता, तो मॉडल फिर भी जवाब दे सकता है।
शायद वह कहे:
“कई कंपनियां कर्मचारियों को पांच वेकेशन दिन कैरी करने देती हैं।”
यह सही लगता है।
यह आपकी कंपनी की पॉलिसी से मेल भी खा सकता है।
लेकिन ज़रूरी सवाल यह नहीं है कि जवाब सही लगता है या नहीं।
सवाल यह है:
जवाब किस आधार पर दिया गया?
अगर सिस्टम के पास आपकी कंपनी की पॉलिसी तक पहुंच नहीं थी, तो सिर्फ़ जवाब भरोसेमंद लगने से वह उस निजी पॉलिसी को नहीं जान सकता था।
ट्रेनिंग की जानकारी और मौजूदा जानकारी अलग-अलग हैं
आर्टिकल 1 में, हमने ट्रेनिंग को इन्फरेंस से अलग किया था।
ट्रेनिंग वह है जब मॉडल सीखता है या समायोजित होता है।
इन्फरेंस वह है जब ट्रेन्ड मॉडल नए इनपुट को प्रोसेस करके आउटपुट बनाता है।
ट्रेनिंग के दौरान मॉडल ने जो सीखा, वह कई सामान्य सवालों के जवाब देने में मदद कर सकता है। लेकिन ट्रेनिंग अपने-आप उसे अभी मौजूद हर चीज़ तक पहुंच नहीं देती।
उदाहरण के लिए, अकेली ट्रेनिंग शायद यह न दे:
- आपके निजी कंपनी दस्तावेज़;
- कल अपडेट हुई पॉलिसी;
- आज का खाता बैलेंस;
- आज सुबह की सपोर्ट टिकट;
- नवीनतम प्रोजेक्ट प्लान;
- संबंधित ट्रेनिंग अवधि के बाद बनी जानकारी।
इससे हमें एक उपयोगी फ़र्क़ मिलता है:
ट्रेनिंग की जानकारी वह है जो मॉडल ने बातचीत से पहले सीखी।
मौजूदा या सप्लाई की गई जानकारी वह है जो काम के दौरान उपलब्ध कराई गई।
ये एक जैसी नहीं हैं।
ग्राउंडिंग: AI को काम करने के लिए कुछ सही जानकारी दें
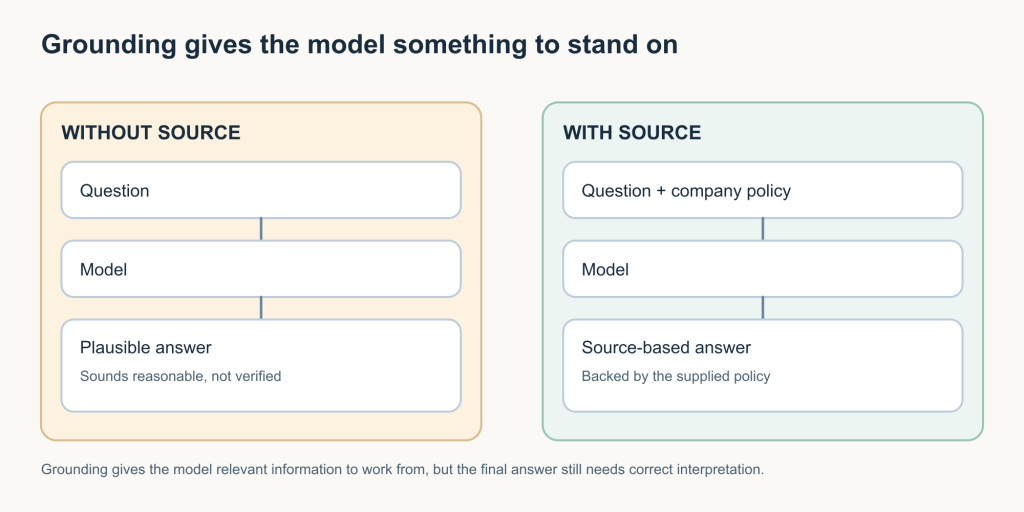
अब कंपनी की लीव पॉलिसी अपलोड करके पूछें:
“इस दस्तावेज़ के मुताबिक, अगले साल में मैं कितने वेकेशन दिन कैरी कर सकता हूं?”
स्थिति बदल जाती है।
अब एप्लिकेशन काम के लिए उपलब्ध जानकारी के हिस्से के तौर पर सही पॉलिसी टेक्स्ट मॉडल को दे सकता है।
यह ग्राउंडिंग का एक आसान उदाहरण है।
ग्राउंडिंग एक AI जवाब को सही स्रोत जानकारी से जोड़ती है।
वह जानकारी इनसे आ सकती है:
- आपके द्वारा अपलोड किया गया दस्तावेज़;
- कंपनी का नॉलेज बेस;
- एक डेटाबेस;
- एक सर्च परिणाम;
- एक प्रोडक्ट कैटलॉग;
- कोई और भरोसेमंद स्रोत।
पॉलिसी के बिना, जवाब यह हो सकता है:
“कई कंपनियां पांच दिन देती हैं।”
पॉलिसी के साथ, जवाब इसके बजाय कह सकता है:
“पॉलिसी कहती है कि कर्मचारी 5 इस्तेमाल न हुए दिन अगले साल में कैरी कर सकते हैं।”
दूसरे जवाब के पीछे एक ख़ास स्रोत है।
याद रखें
ग्राउंडिंग = AI को अपने जवाब का आधार बनाने के लिए सही जानकारी देना।
ग्राउंडिंग जवाब को ज़्यादा उपयोगी और सत्यापित करने में आसान बना सकती है।
लेकिन यह गारंटी नहीं देती कि जवाब सही है।
मॉडल अब भी स्रोत को ग़लत समझ सकता है, कोई अपवाद छोड़ सकता है, सेक्शन को ग़लत तरीक़े से जोड़ सकता है, या ऐसी बात जोड़ सकता है जो दस्तावेज़ में नहीं है।
रिट्रीवल और RAG: जवाब देने से पहले उपयोगी जानकारी ढूंढना
एक छोटी पॉलिसी अपलोड करना आसान है।
अब मान लीजिए किसी संगठन के पास हज़ारों दस्तावेज़ हैं:
- पॉलिसियां;
- कर्मचारी हैंडबुक;
- तकनीकी मैनुअल;
- प्रक्रियाएं;
- विकी पेज;
- सपोर्ट आर्टिकल।
हर बार किसी के सवाल पूछने पर उन सबको मॉडल को भेजना अक्षम होगा और शायद मॉडल एक बातचीत में जितना असरदार तरीक़े से इस्तेमाल कर सकता है, उससे ज़्यादा हो जाए।
इसके बजाय, एप्लिकेशन पहले वह जानकारी ढूंढ सकता है जो सवाल से जुड़ी लगती है।
यह रिट्रीवल है।
हमारे सवाल के लिए:
“अगले साल में मैं कितने वेकेशन दिन कैरी कर सकता हूं?”
सिस्टम ये रिट्रीव कर सकता है:
- सालाना लीव पॉलिसी;
- लीव कैरीओवर नियम;
- क्षेत्रीय रोज़गार अपवाद।
ज़रूरी बात यह है कि रिट्रीवल जानकारी ढूंढता है।
वह ख़ुद अंतिम व्याख्या नहीं बनाता।
RAG: पहले रिट्रीव करें, फिर जनरेट करें
जब रिट्रीवल को एक जेनरेटिव मॉडल के साथ जोड़ा जाता है, तो आप अक्सर Retrieval-Augmented Generation, या RAG शब्द सुनेंगे।
नाम सुनने में विचार से ज़्यादा जटिल लगता है।
इसे इस तरह सोचें:
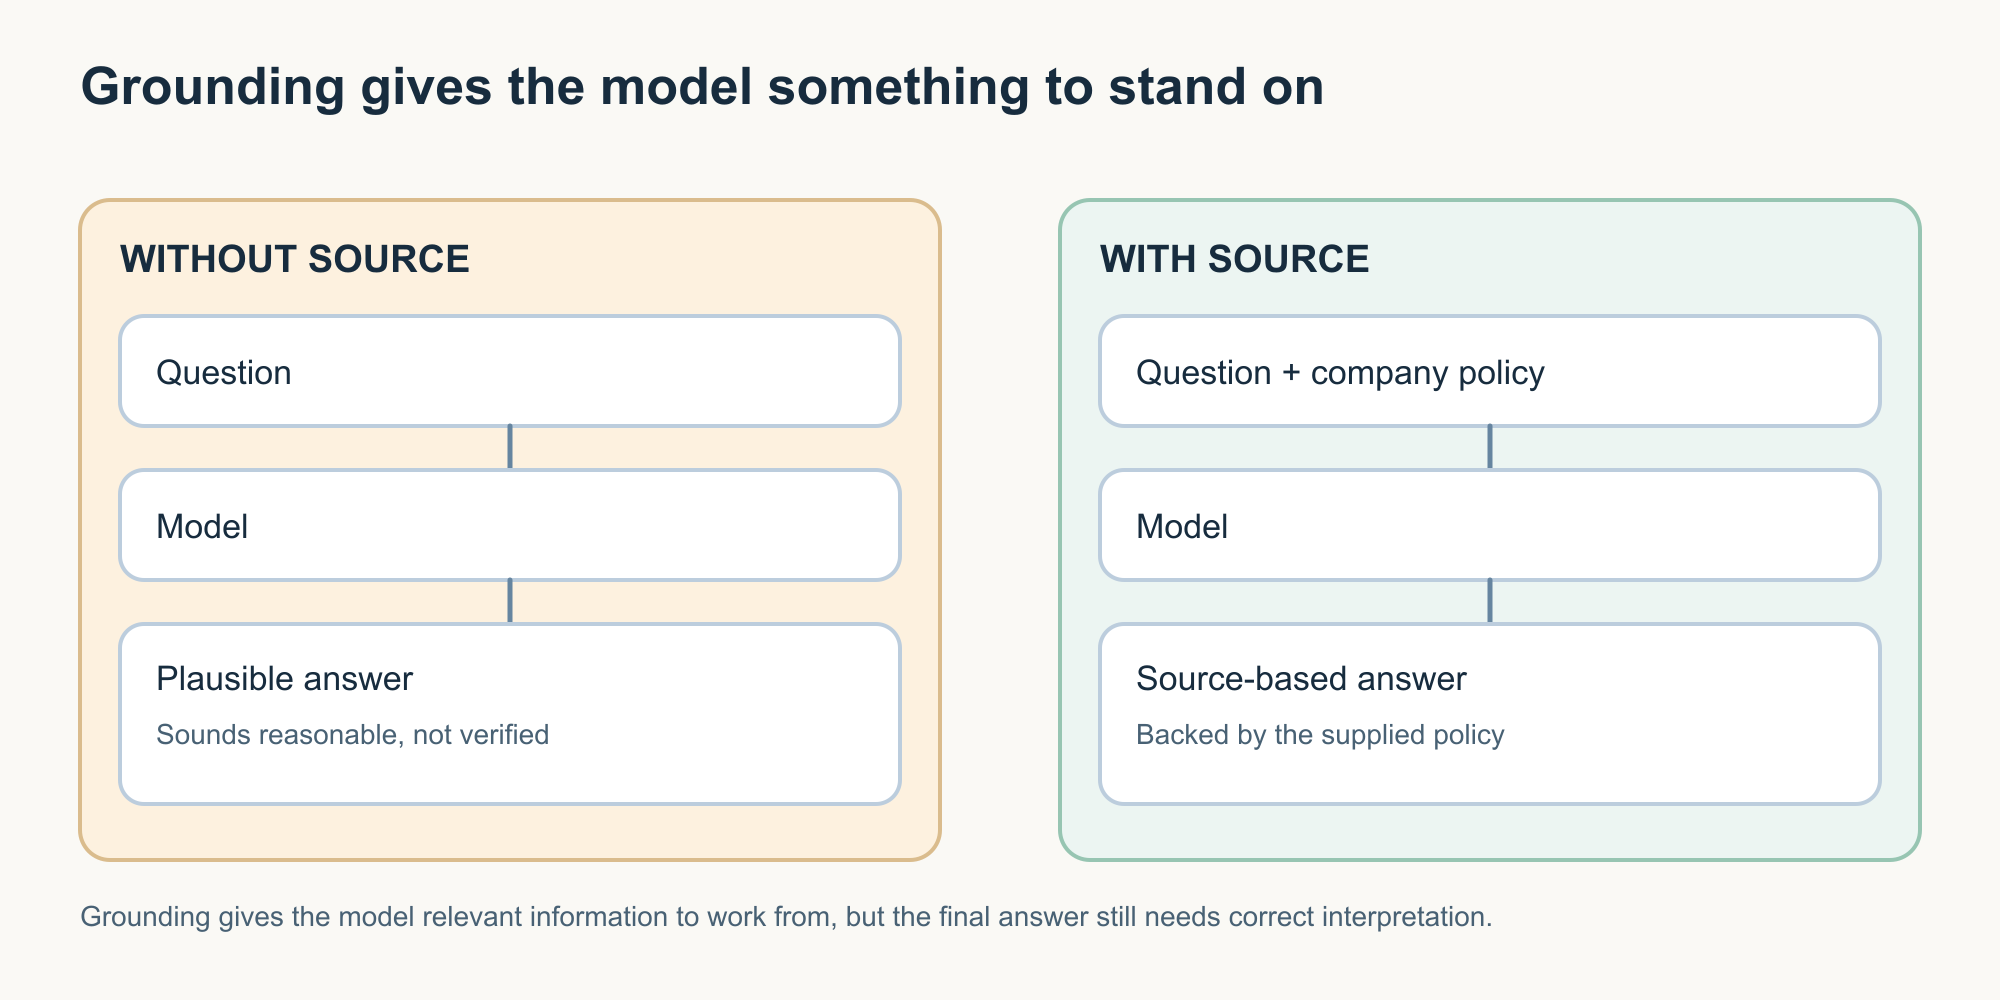
ढूंढें → दें → जवाब दें
पहले, सवाल से जुड़ी जानकारी ढूंढें।
फिर वह जानकारी मॉडल को दें।
फिर मॉडल से उसका इस्तेमाल करके जवाब बनाने को कहें।
उदाहरण के लिए:
सवाल
“मैं कितने दिन कैरी कर सकता हूं?”
रिट्रीव करें
सही पॉलिसी पैराग्राफ़ ढूंढें।
दें
वे पैराग्राफ़ भाषा मॉडल को दें।
जवाब
“कर्मचारी 5 इस्तेमाल न हुए दिन अगले साल में कैरी कर सकते हैं।”
यही RAG के पीछे का मूल विचार है।
वेक्टर डेटाबेस और एम्बेडिंग के बारे में क्या?
जब लोग RAG पर चर्चा करते हैं, तो आप ये शब्द भी सुन सकते हैं:
- एम्बेडिंग;
- वेक्टर डेटाबेस;
- सिमेंटिक सर्च;
- इंडेक्स;
- हाइब्रिड सर्च।
ये एप्लिकेशन को सही जानकारी ढूंढने में मदद कर सकते हैं, लेकिन ये RAG की परिभाषा नहीं, बल्कि लागू करने के तरीक़े हैं।
अलग-अलग सिस्टम अलग-अलग रिट्रीवल तरीक़े इस्तेमाल कर सकते हैं।
इस लेख के लिए, ज़रूरी बात बस इतनी है:
मॉडल से जवाब मांगने से पहले एप्लिकेशन उपयोगी जानकारी ढूंढता है।
RAG फिर भी असफल हो सकता है
मान लीजिए मौजूदा पॉलिसी कहती है:
“कर्मचारी 5 इस्तेमाल न हुए दिन अगले साल में कैरी कर सकते हैं।”
लेकिन रिट्रीवल सिस्टम एक पुरानी पॉलिसी ढूंढता है, जो कहती है:
“कर्मचारी 10 इस्तेमाल न हुए दिन कैरी कर सकते हैं।”
भाषा मॉडल ग़लत दस्तावेज़ से सही ढंग से जवाब दे सकता है।
यह दिखाता है कि RAG सिस्टम दो अलग-अलग जगहों पर असफल हो सकता है।
रिट्रीवल की असफलता
एप्लिकेशन ऐसी जानकारी ढूंढता है जो:
- पुरानी है;
- अधूरी है;
- असंबंधित है;
- या सवाल के लिए बस ग़लत है।
जनरेशन की असफलता
सही जानकारी रिट्रीव हो जाती है, लेकिन मॉडल उसे ग़लत समझता है या ग़लत बताता है।
ये अलग-अलग समस्याएं हैं।
एक उपयोगी नियम है:
अच्छी जनरेशन हर ख़राब रिट्रीवल को ठीक नहीं कर सकती।
और:
अच्छी रिट्रीवल अच्छे जवाब की गारंटी नहीं देती।
इसीलिए किसी AI सिस्टम का मूल्यांकन करने का मतलब अक्सर उसके आख़िरी वाक्य से कहीं ज़्यादा देखना होता है।
एक साइटेशन मदद करता है, लेकिन आपको फिर भी जांचना होगा
मान लीजिए AI कहता है:
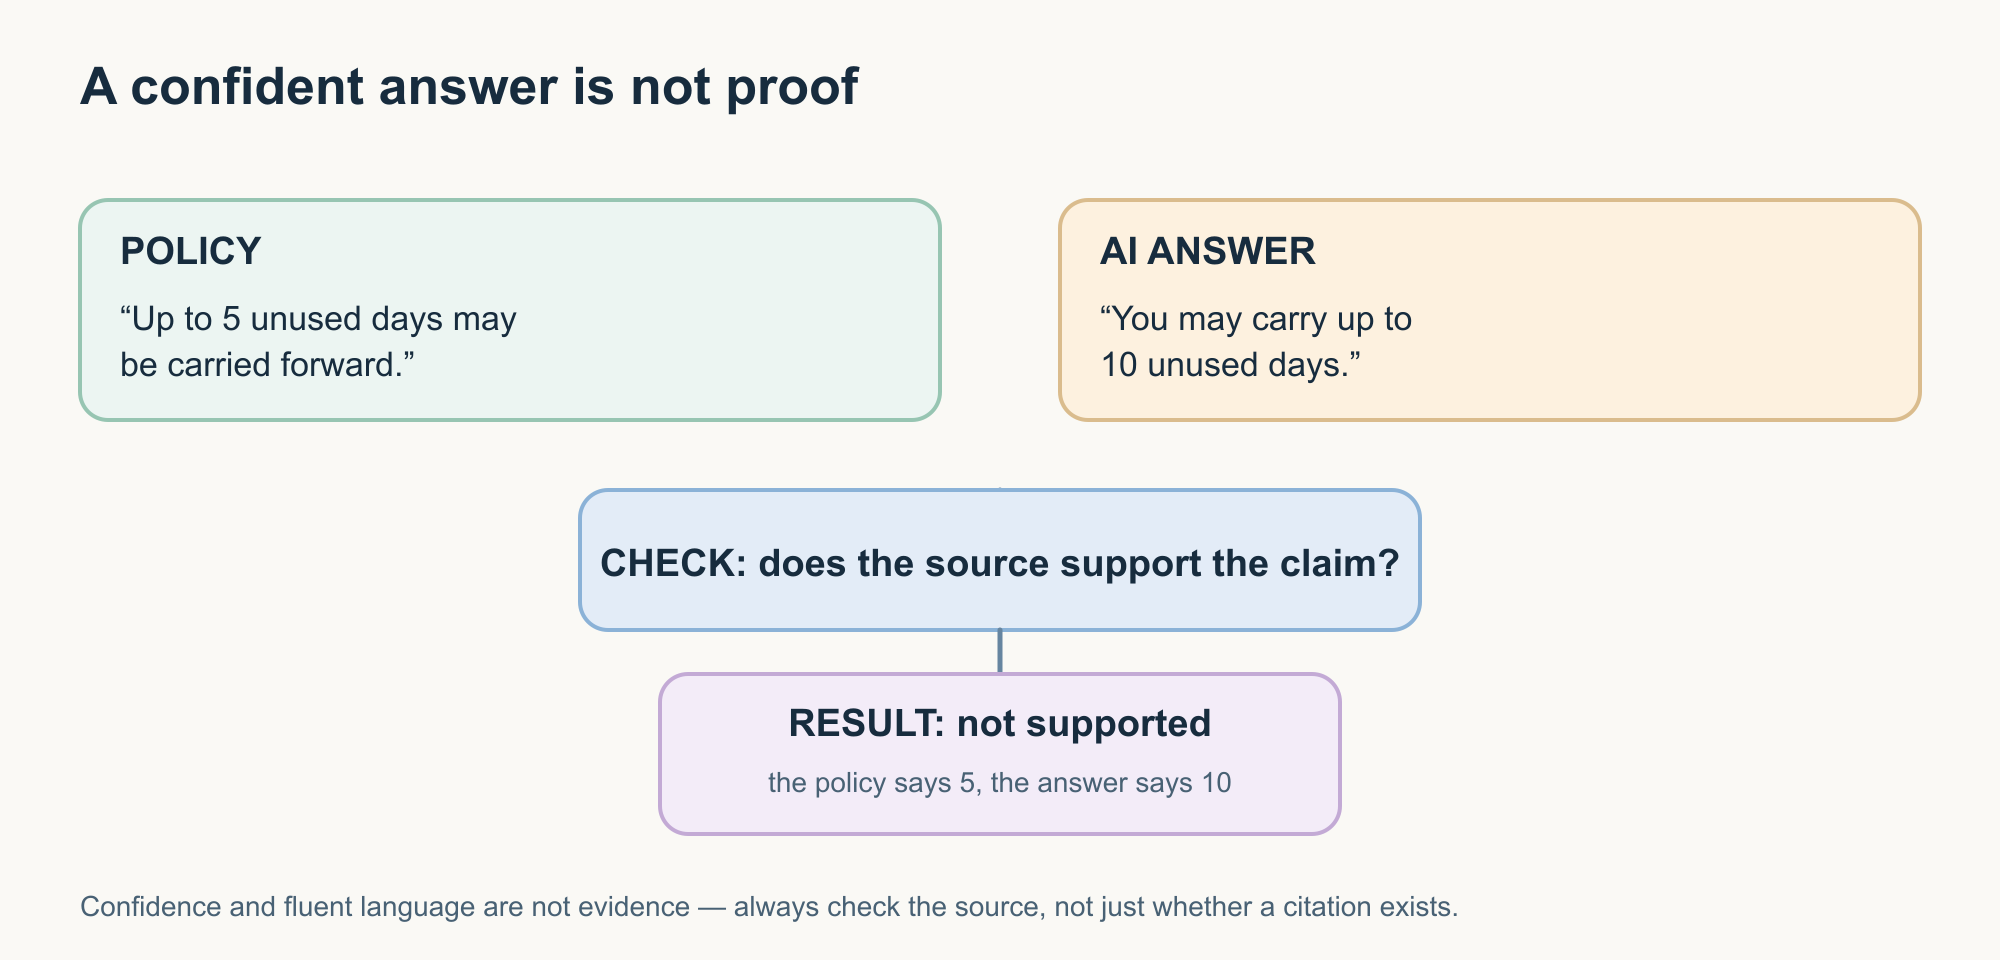
“आप 10 दिन कैरी कर सकते हैं। सालाना लीव पॉलिसी, पेज 6 देखें।”
आप पेज 6 खोलते हैं।
वहां असल में लिखा है:
“5 इस्तेमाल न हुए दिन कैरी किए जा सकते हैं।”
जवाब में एक साइटेशन है।
फिर भी वह ग़लत है।
इससे एक ज़रूरी आदत बनती है:
सिर्फ़ यह मत देखिए कि साइटेशन मौजूद है या नहीं। यह देखिए कि स्रोत उस दावे का समर्थन करता है या नहीं।
एक AI सिस्टम यह कर सकता है:
- ग़लत पैराग्राफ़ को साइट करना;
- सही पैराग्राफ़ को ग़लत समझना;
- किसी ऐसे बयान से स्रोत जोड़ना जिसका वह समर्थन नहीं करता;
- या कभी-कभी ऐसे सपोर्टिंग ब्योरे बनाना जो मौजूद ही नहीं हैं।
एक स्रोत सत्यापन को आसान बनाता है।
वह सत्यापन की ज़रूरत को ख़त्म नहीं करता।
हैल्यूसिनेशन: भरोसेमंद भाषा सबूत नहीं है
AI चर्चाओं में आप अक्सर हैल्यूसिनेशन शब्द सुनेंगे।
यह उन स्थितियों को बताता है जहां जेनरेटिव AI ऐसी जानकारी देता है जो भरोसेमंद लगती है लेकिन असमर्थित या ग़लत होती है।
NIST अपने जेनरेटिव AI जोखिम मार्गदर्शन में आत्मविश्वास से पेश किए गए ग़लत या झूठे कंटेंट के लिए कन्फैबुलेशन (confabulation) शब्द का इस्तेमाल करता है, जिसमें बनाई गई सपोर्टिंग सामग्री भी शामिल हो सकती है।
अपने पॉलिसी उदाहरण पर वापस चलते हैं।
दस्तावेज़ कहता है:
5 दिन।
AI कहता है:
10 दिन।
या यह कह सकता है:
“कर्मचारी पांच दिन कैरी कर सकते हैं, सिवाय उन कर्मचारियों के जिनकी सेवा दस साल से ज़्यादा है, वे दस दिन कैरी कर सकते हैं।”
वह अपवाद भरोसेमंद लगता है।
लेकिन मान लीजिए पॉलिसी में ऐसा कोई अपवाद नहीं है।
समस्या यह नहीं है कि वाक्य अजीब लगता है।
समस्या यह है कि वह सामान्य लगता है।
याद रखें
हैल्यूसिनेशन = ऐसी भरोसेमंद जनरेट की गई जानकारी जिसे काम के लिए उपलब्ध तथ्यों का सही समर्थन नहीं मिलता।
ग्राउंडिंग और RAG बेहतर स्रोत जानकारी देकर कुछ तरह के असमर्थित आउटपुट को कम कर सकते हैं।
वे हैल्यूसिनेशन को नामुमकिन नहीं बनाते।
ख़ुद आज़माएं: भरोसे को नहीं, जवाब को सत्यापित करें
एक छोटा, ग़ैर-संवेदनशील दस्तावेज़ चुनें जिसे आप अच्छी तरह समझते हों।
यह हो सकता है:
- सार्वजनिक प्रोडक्ट दस्तावेज़ीकरण;
- एक सॉफ़्टवेयर मैनुअल;
- बिना गोपनीय जानकारी वाले मीटिंग नोट्स;
- एक सार्वजनिक पॉलिसी दस्तावेज़।
इसे किसी ऐसे AI असिस्टेंट में अपलोड करें जो दस्तावेज़ों का समर्थन करता हो।
पहले पूछें:
“इस दस्तावेज़ को संक्षेप में बताएं।”
फिर पूछें:
“इस दस्तावेज़ से तीन सबसे ज़रूरी तथ्यात्मक निष्कर्ष दें। हर एक के लिए, वह सेक्शन या हिस्सा बताएं जो उसका समर्थन करता है। दस्तावेज़ में मौजूद न हो, ऐसी जानकारी न जोड़ें।”
अब दस्तावेज़ को ख़ुद जांचें।
पूछें:
- क्या AI ने सही जानकारी ढूंढी?
- क्या उसने कोई अपवाद छोड़ दिया?
- क्या उसने दो असंबंधित बातों को जोड़ दिया?
- क्या हर स्रोत वाक़ई उसके बगल के बयान का समर्थन करता है?
एक चीज़ जो नहीं करनी है, वह है सिर्फ़ यह पूछना:
“क्या आपका जवाब सही है?”
इससे उसी सिस्टम से उसके अपने आउटपुट का फ़ैसला करने को कहा जाता है।
सत्यापन का मतलब है सबूत की तरफ़ वापस जाना।
खोज और जनरेशन अलग-अलग काम हैं
मान लीजिए आप पूछते हैं:
“आज की ब्याज-दर घोषणा में क्या बदला?”
अगर एप्लिकेशन उस घटना के बारे में जानकारी नहीं दे सकता, तो भाषा मॉडल किसी नई घटना के बारे में सवाल का भरोसे से जवाब नहीं दे सकता।
एक AI एप्लिकेशन वेब सर्च या किसी और मौजूदा जानकारी स्रोत का इस्तेमाल करके इसे हल कर सकता है।
प्रक्रिया कुछ ऐसी दिख सकती है:
सवाल → सर्च → मौजूदा स्रोत → मॉडल → जनरेट किया गया स्पष्टीकरण
सर्च जानकारी हासिल करता है।
मॉडल उसकी व्याख्या करता है या समझाता है।
याद रखें
सर्च ढूंढता है।
जनरेशन समझाता या बनाता है।
आधुनिक AI एप्लिकेशन इन दोनों को इतनी सहजता से मिला सकते हैं कि आपको फ़र्क़ पता ही न चले।
लेकिन जवाब कितना मौजूदा या सत्यापित करने लायक़ है, यह तय करते समय यह फ़र्क़ अब भी मायने रखता है।
AI के “याद रखने” का क्या मतलब है?
एक और शब्द जिसे सावधानी चाहिए, वह है मेमोरी।
लोग अक्सर कहते हैं:
“AI को मैं याद हूं।”
लेकिन यह कई अलग-अलग तरीक़ों को बता सकता है।
एक एप्लिकेशन यह कर सकता है:
- हाल की बातचीत के संदेशों को मौजूदा कॉन्टेक्स्ट में शामिल करना;
- मॉडल के बाहर चुनी हुई जानकारी सेव करना;
- बाद की बातचीत में सेव की गई जानकारी को रिट्रीव करना;
- प्रोजेक्ट या टास्क की स्थिति बनाए रखना;
- प्राथमिकताएं सेव करना;
- पहले की बातचीत को संक्षेप में बताकर वह सारांश बाद में देना।
ये एप्लिकेशन के व्यवहार हैं।
इनका अपने-आप यह मतलब नहीं कि अंतर्निहित मॉडल ने आपकी बातचीत से स्थायी रूप से कुछ नया सीख लिया।
एक उपयोगी फ़र्क़ है:
कॉन्टेक्स्ट — मौजूदा बातचीत के लिए मॉडल को उपलब्ध जानकारी।
मेमोरी — जानकारी जिसे एप्लिकेशन सहेज कर बाद में फिर इस्तेमाल कर सकता है।
ट्रेनिंग — मॉडल ने जो सीखा है, उसमें बदलाव।
ये अलग-अलग चीज़ें हैं।
जब भी कोई प्रोडक्ट कहे कि उसके पास “मेमोरी” है, तो उपयोगी सवाल हैं:
- क्या सेव किया जा रहा है?
- वह कहां सेव है?
- वह कितने समय तक रहता है?
- क्या मैं उसे देख या नियंत्रित कर सकता हूं?
- क्या वह सिर्फ़ मॉडल को बाद में वापस दिया जाता है?
- क्या उसमें से कुछ मॉडल को बेहतर बनाने या ट्रेन करने में इस्तेमाल होता है?
अकेला मेमोरी शब्द इन सवालों का जवाब नहीं देता।
AI टेक्स्ट से ज़्यादा के साथ काम कर सकता है
हमारा उदाहरण टेक्स्ट और दस्तावेज़ों पर केंद्रित रहा है।
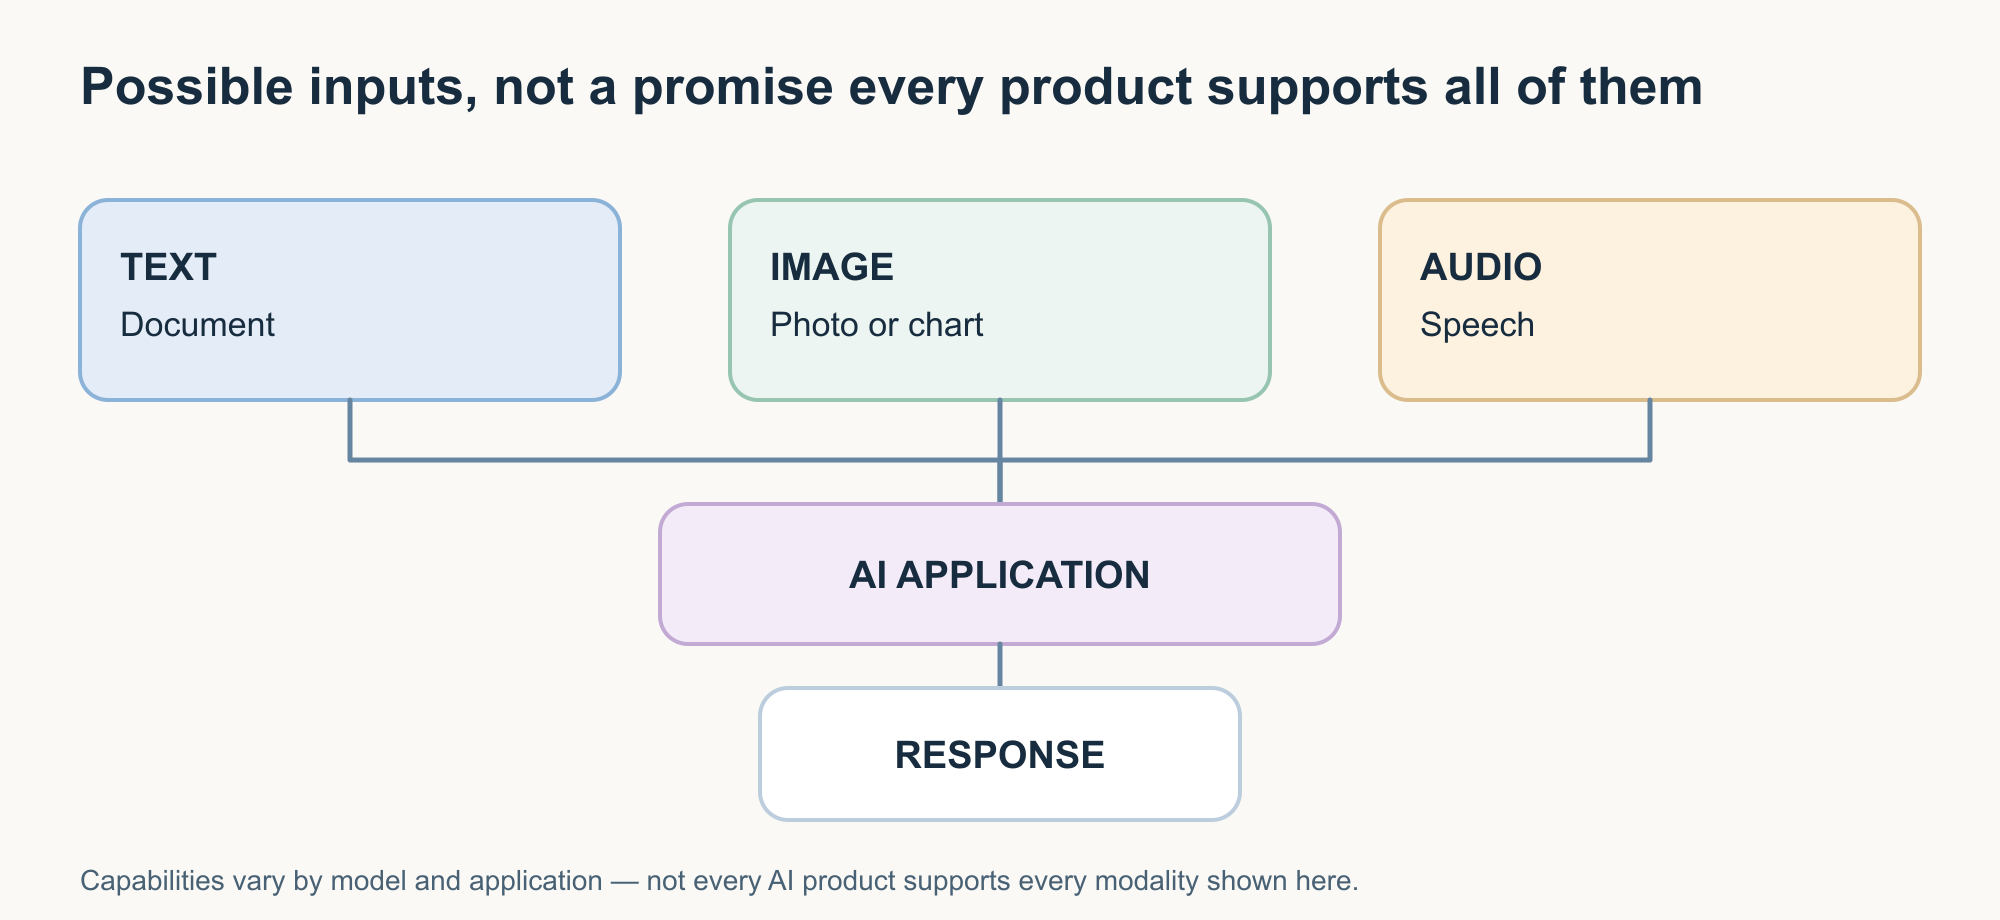
लेकिन आधुनिक AI सिस्टम इनके साथ भी काम कर सकते हैं:
- इमेज;
- ऑडियो;
- वीडियो;
- डायग्राम;
- अलग-अलग इनपुट प्रकारों का मिश्रण।
इसे आमतौर पर मल्टीमॉडल AI कहा जाता है।
उदाहरण के लिए, आप किसी उपकरण पैनल की फ़ोटो लेकर पूछ सकते हैं:
“कौन-से चेतावनी संकेतक दिख रहे हैं?”
या कोई चार्ट अपलोड करके पूछ सकते हैं:
“इन दो सालों के बीच क्या बदला, समझाएं।”
या टाइप करने के बजाय AI असिस्टेंट से बात कर सकते हैं।
याद रखें
मल्टीमॉडल = एक से ज़्यादा तरह की जानकारी के साथ काम करना।
इसका मतलब यह नहीं कि हर AI प्रोडक्ट हर मोडैलिटी को सपोर्ट करता है।
क्षमताएं मॉडल और एप्लिकेशन के हिसाब से बदलती हैं।
सवालों का जवाब देने से लेकर कार्रवाई करने तक
अब रिक्वेस्ट बदलिए।
यह पूछने के बजाय:
“मैं कितने वेकेशन दिन कैरी कर सकता हूं?”
आप पूछते हैं:
“HR को ईमेल करके मेरा बचा हुआ लीव बैलेंस पक्का करने के लिए कहें।”
ईमेल लिखना एक काम है।
उसे असल में भेजना दूसरा।
एक भाषा मॉडल यह बना सकता है:
“हाय HR, क्या आप कृपया मेरा बचा हुआ सालाना लीव बैलेंस पक्का कर सकते हैं…”
लेकिन उसे भेजने के लिए ईमेल सिस्टम तक पहुंच चाहिए।
यहीं टूल ज़रूरी हो जाते हैं।
टूल का इस्तेमाल (tool use)
एक टूल AI एप्लिकेशन को मॉडल के बाहर की किसी क्षमता के साथ बातचीत करने देता है।
उदाहरण:
- वेब सर्च;
- कैलकुलेटर;
- डेटाबेस;
- ईमेल;
- कैलेंडर;
- फ़ाइल सिस्टम;
- कोड एग्ज़िक्यूशन;
- बिज़नेस API।
एक सामान्य बातचीत ऐसी हो सकती है:
रिक्वेस्ट → मॉडल तय करता है कि टूल चाहिए → एप्लिकेशन टूल चलाता है → टूल परिणाम लौटाता है → मॉडल काम जारी रखता है
मॉडल कोई ईमेल सर्वर या डेटाबेस नहीं बन गया।
आस-पास का एप्लिकेशन उन सिस्टम तक नियंत्रित पहुंच देता है।
जवाब देना और कार्रवाई करना अलग-अलग हैं
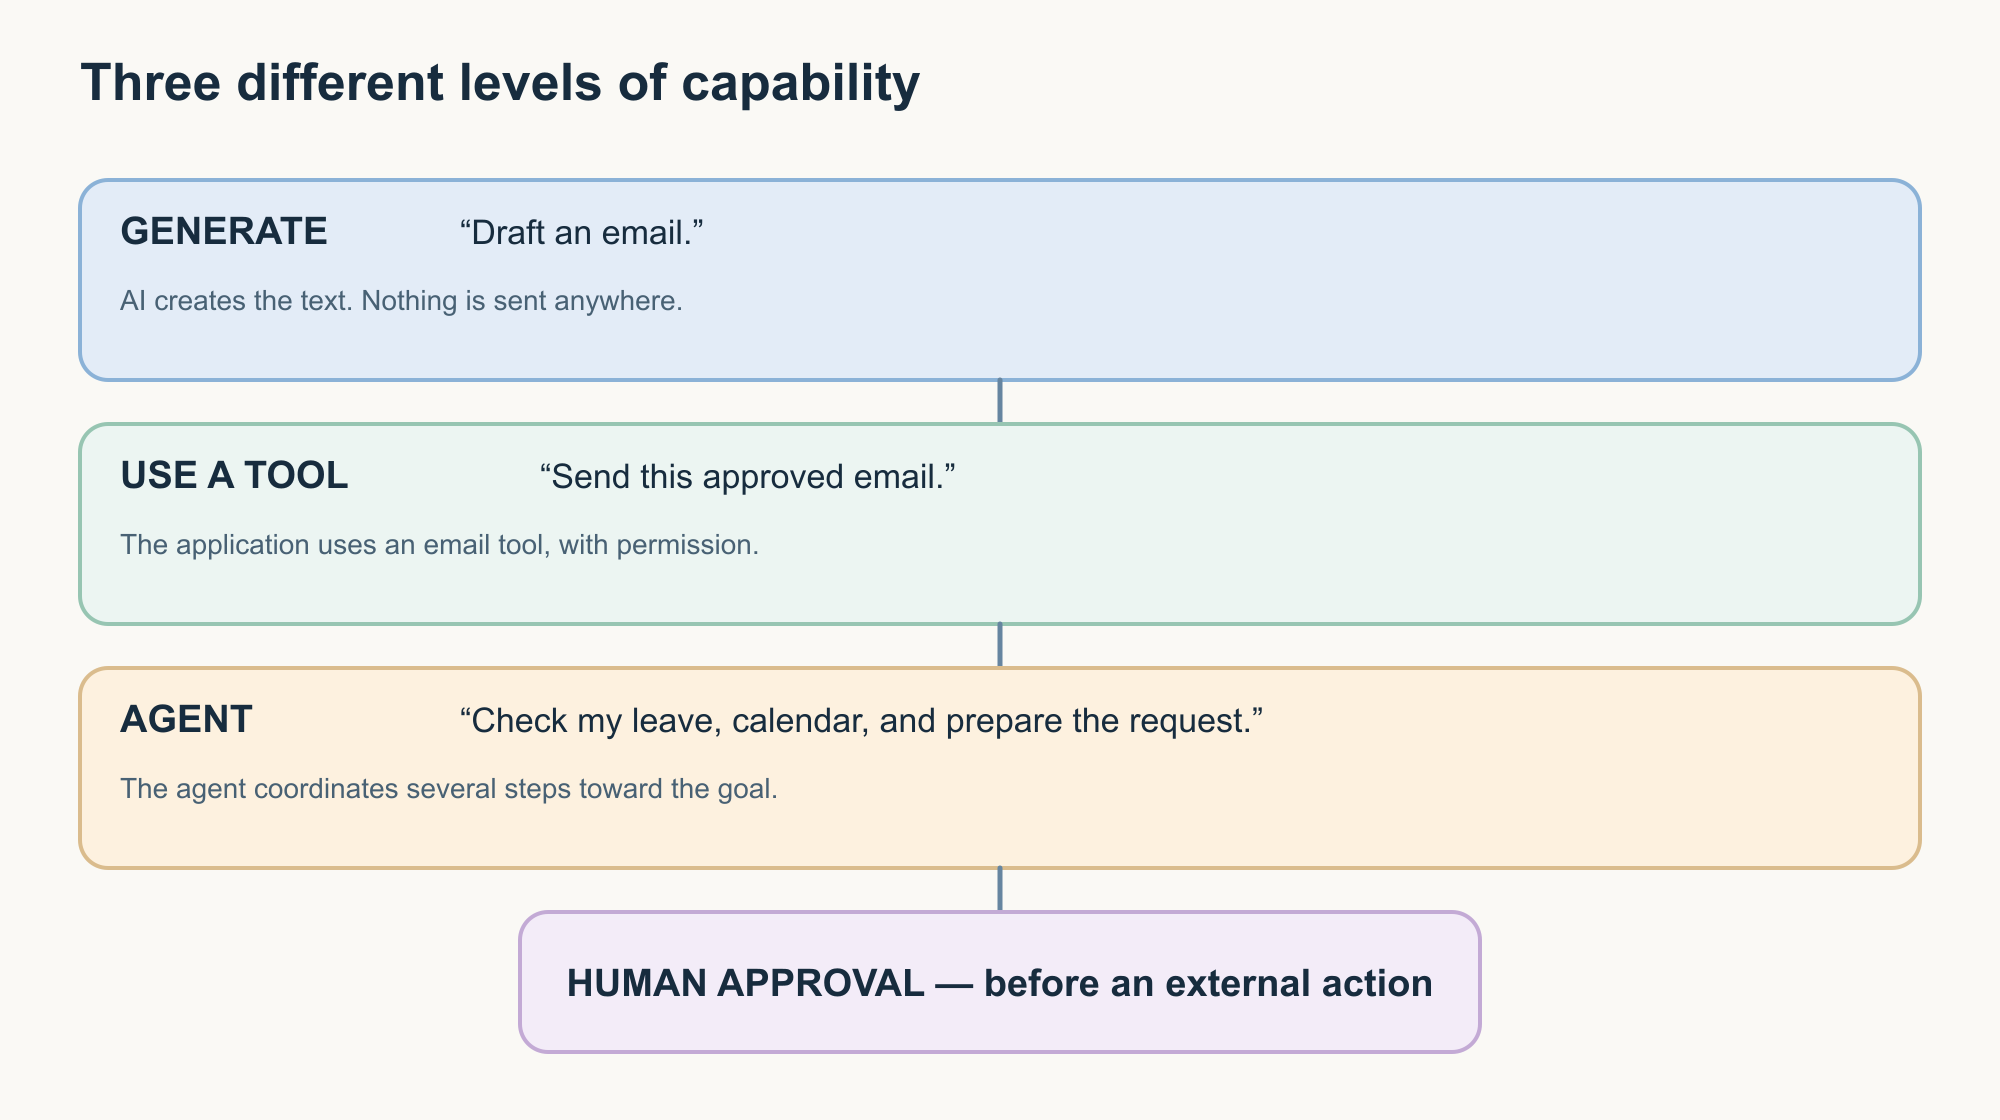
इन रिक्वेस्ट की तुलना करें:
“HR से लीव बैलेंस के बारे में पूछने के लिए एक ईमेल लिखें।”
AI टेक्स्ट बनाता है।
“यह मंज़ूर किया गया ईमेल HR को भेजें।”
एप्लिकेशन को ईमेल टूल और उसे इस्तेमाल करने की अनुमति चाहिए।
अब यह देखें:
“मेरा बचा हुआ लीव देखें, मेरा कैलेंडर देखें, दिसंबर की छुट्टी के लिए सही तारीख़ें ढूंढें, और एक लीव रिक्वेस्ट तैयार करें।”
इसके लिए कई जुड़े हुए चरण चाहिए हो सकते हैं।
सिस्टम को यह करना पड़ सकता है:
- लीव बैलेंस हासिल करना;
- कैलेंडर देखना;
- तारीख़ों की तुलना करना;
- यह तय करना कि कौन-सी जानकारी मायने रखती है;
- रिक्वेस्ट तैयार करना;
- किसी बाहरी कार्रवाई से पहले इंसानी मंज़ूरी के लिए रुकना।
यह हमें एक और व्यापक रूप से इस्तेमाल होने वाले शब्द तक ले जाता है: AI एजेंट।
AI एजेंट: किसी लक्ष्य की ओर काम करना
“एजेंट” कहे जाने वाले हर प्रोडक्ट को पूरी तरह कवर करने वाली कोई एक रोज़मर्रा की परिभाषा नहीं है।
एक व्यावहारिक आधार यह है:
एक AI एजेंट वह सिस्टम है जो यह तय करके कि कौन-से कदम उठाने हैं, और उपलब्ध जानकारी या टूल का इस्तेमाल करके उन कदमों को पूरा करके किसी लक्ष्य की ओर काम कर सकता है।
सिर्फ़ एक जवाब देने के बजाय, एक एजेंट यह कर सकता है:
- लक्ष्य को समझना;
- यह तय करना कि उसे किस जानकारी की ज़रूरत है;
- एक टूल इस्तेमाल करना;
- परिणाम देखना;
- अगला कदम चुनना;
- किसी रुकने के बिंदु तक पहुंचने तक जारी रखना।
उदाहरण के लिए:
“मेरी बिज़नेस ट्रिप प्लान करें।”
एक एजेंट कैलेंडर देख सकता है, उपलब्ध फ़्लाइट खोज सकता है, उनकी तुलना कर सकता है, एक होटल चुन सकता है, और एक यात्रा-योजना तैयार कर सकता है।
क्या उसे वाक़ई कुछ बुक करने की इजाज़त है, यह सिस्टम की अनुमतियों और नियंत्रणों पर निर्भर करता है।
इन विचारों को अलग करने का एक आसान तरीक़ा है:
असिस्टेंट — अक्सर किसी रिक्वेस्ट में मदद करता है।
टूल का इस्तेमाल — एप्लिकेशन को मॉडल के बाहर की किसी चीज़ के साथ बातचीत करने देता है।
एजेंट — किसी लक्ष्य की ओर काम करते हुए कई कदमों और टूल का समन्वय कर सकता है।
सीमाएं पूरी तरह मानकीकृत नहीं हैं, इसलिए जब प्रोडक्ट एजेंट शब्द इस्तेमाल करें तो हमें सावधान रहना चाहिए।
ऑटोमेशन और एजेंट एक जैसे नहीं हैं
जेनरेटिव AI से पहले भी बहु-चरण सॉफ़्टवेयर मौजूद था।
पारंपरिक ऑटोमेशन यह कर सकता है:
हर शुक्रवार शाम 5 बजे, यह रिपोर्ट एक्सपोर्ट करें और फ़ाइनेंस टीम को ईमेल करें।
यह प्रक्रिया पहले से तय है।
जब रास्ते का कुछ हिस्सा इस बात पर निर्भर करता है कि सिस्टम काम करते समय क्या पाता है, तो एजेंट ज़्यादा उपयोगी हो जाता है।
उदाहरण के लिए:
इस हफ़्ते के सपोर्ट इंसिडेंट की समीक्षा करें, अहम थीम पहचानें, सपोर्टिंग सबूत इकट्ठा करें, और एक प्रबंधन सारांश तैयार करें।
इंसिडेंट के हिसाब से सही कदम बदल सकते हैं।
एक उपयोगी फ़र्क़ है:
ऑटोमेशन पहले से तय प्रक्रिया का पालन करता है।
एजेंट किसी लक्ष्य की ओर काम करते हुए प्रक्रिया के कुछ हिस्से ख़ुद तय कर सकता है।
असली सिस्टम दोनों को मिला सकते हैं।
एक एजेंट अपने कई कदमों के लिए सामान्य, तय ऑटोमेशन का इस्तेमाल कर सकता है।
ज़्यादा क्षमता का मतलब है ज़्यादा सवाल
AI को ज़्यादा जानकारी और टूल तक पहुंच देना उसे बहुत ज़्यादा उपयोगी बना सकता है।
इससे नए सवाल भी पैदा होते हैं।
अगर AI दस्तावेज़ पढ़ सकता है:
वह कौन-से दस्तावेज़ों तक पहुंच सकता है?
अगर वह डेटाबेस से पूछताछ कर सकता है:
वह कौन-से रिकॉर्ड हासिल कर सकता है?
अगर वह ईमेल भेज सकता है:
क्या वह अपने-आप भेजता है, या पहले कोई इंसान मंज़ूरी देता है?
अगर वह किसी और सिस्टम को बदल सकता है:
अनचाही कार्रवाई को क्या रोकता है?
अगर वह मेमोरी सेव करता है:
क्या सेव होता है, कहां, और कितने समय तक?
इसीलिए टेक्नोलॉजी को समझना AI फ्लुएंसी का सिर्फ़ एक हिस्सा है।
हमें यह भी जानना होगा कि उसके दावों, सीमाओं, सबूतों और नियंत्रणों को कैसे परखें।
यहीं भाग 3 हमें ले जाता है।
पूरी यात्रा को साथ रखकर देखें
मूल सवाल पर वापस जाएं:
“हमारी कंपनी की पॉलिसी के मुताबिक, अगले साल में मैं कितने वेकेशन दिन कैरी कर सकता हूं?”
सिस्टम के जवाब देने के कई संभावित तरीक़े हैं।
सिर्फ़ मॉडल
सवाल → मॉडल → जनरेट किया गया जवाब
कई सामान्य सवालों के लिए उपयोगी।
अगर वह जानकारी सिस्टम के पास असल में उपलब्ध नहीं है, तो किसी निजी कंपनी पॉलिसी को स्थापित करने के लिए काफ़ी नहीं।
सप्लाई किया गया दस्तावेज़
सवाल + पॉलिसी → मॉडल → ग्राउंडेड जवाब
सही सबूत अब उपलब्ध है, लेकिन सही व्याख्या अब भी मायने रखती है।
RAG
सवाल → सही जानकारी रिट्रीव करें → मॉडल को दें → जवाब जनरेट करें → सपोर्टिंग स्रोत दिखाएं
जब सीधे देने के लिए बहुत ज़्यादा जानकारी हो, तब उपयोगी।
गुणवत्ता रिट्रीवल और जनरेशन दोनों पर निर्भर करती है।
टूल का इस्तेमाल
रिक्वेस्ट → मॉडल किसी बाहरी क्षमता को पहचानता है → टूल चलाया जाता है → परिणाम लौटता है → मॉडल आगे बढ़ता है
जब काम के लिए मौजूदा जानकारी या किसी और सिस्टम से बातचीत ज़रूरी हो, तब उपयोगी।
एजेंट
लक्ष्य → अगला कदम तय करें → जानकारी या टूल इस्तेमाल करें → परिणाम देखें → अगला कदम चुनें → अनुमतियों और रुकने के नियमों के भीतर जारी रखें
जब काम के लिए कई जुड़े फ़ैसले या कार्रवाइयां चाहिए, तब उपयोगी।
इन्हें पांच आर्किटेक्चर के तौर पर याद रखने की ज़रूरत नहीं है।
इसके बजाय, पूछें:
मेरे सवाल और इस जवाब या कार्रवाई के बीच क्या हुआ?
यह सवाल आपको हैरान करने वाली दूर तक ले जाएगा।
आर्टिकल 2 याद रखने का एक आसान तरीक़ा
| सवाल | अवधारणा |
|---|---|
| जवाब के पीछे कौन-सी जानकारी है? | ग्राउंडिंग |
| सही जानकारी कैसे ढूंढी गई? | रिट्रीवल |
| क्या जानकारी रिट्रीव करके मॉडल को दी गई? | RAG |
| क्या AI ने मॉडल के बाहर की किसी चीज़ से बातचीत की? | टूल का इस्तेमाल |
| क्या सिस्टम ने किसी लक्ष्य की ओर कई कदमों का समन्वय किया? | एजेंट |
और इन सबसे ऊपर एक सवाल होना चाहिए:
क्या मैं यह सत्यापित कर सकता हूं कि क्या हुआ?
हमने क्या सीखा
एक AI जवाब मॉडल की ट्रेनिंग के दौरान सीखी गई बात से कहीं ज़्यादा से आ सकता है।
काम के दौरान एप्लिकेशन अतिरिक्त जानकारी दे सकता है।
ग्राउंडिंग जवाब को सही स्रोत जानकारी से जोड़ती है।
रिट्रीवल उपयोगी जानकारी ढूंढता है।
RAG जानकारी रिट्रीव करता है, उसे मॉडल को देता है, और फिर एक जवाब जनरेट करता है।
एक हैल्यूसिनेशन ऐसी भरोसेमंद जनरेट की गई जानकारी है जो असमर्थित या ग़लत होती है।
मेमोरी का मतलब हो सकता है सेव की गई और बाद में फिर दी गई जानकारी; यह अपने-आप ट्रेनिंग जैसी चीज़ नहीं है।
मल्टीमॉडल AI अलग-अलग तरह की जानकारी के साथ काम कर सकता है।
टूल AI एप्लिकेशन को मॉडल के बाहर के सिस्टम के साथ बातचीत करने देते हैं।
एजेंट किसी लक्ष्य की ओर काम करते हुए जानकारी, फ़ैसलों और टूल का समन्वय कर सकते हैं।
साथ मिलकर, ये अवधारणाएं इस यात्रा को समझाती हैं:
AI से सवाल पूछना
से:
AI को जानकारी तक पहुंच देना
से:
AI को दूसरे सिस्टम से बातचीत करने देना।
इस यात्रा को समझना AI के बारे में सोचना आसान बना देता है।
यह इस सीरीज़ के सबसे ज़रूरी सवाल तक भी ले जाता है:
हम कैसे तय करें कि किसी AI सिस्टम के दावे और नतीजे हमारे भरोसे के लायक़ हैं या नहीं?
यही भाग 3 है।
AI Fluency सीरीज़
भाग 1 — भाषा सीखें AI की भाषा: वे ज़रूरी शब्द जो हर किसी को समझने चाहिए
भाग 1 AI, मशीन लर्निंग, जेनरेटिव AI, मॉडल, LLM, ट्रेनिंग, इन्फरेंस, प्रॉम्प्ट, टोकन और कॉन्टेक्स्ट विंडो को समझाता है।
भाग 2 — अनुभव को समझें AI आपके सवालों का जवाब कैसे देता है: अनुभव के पीछे के शब्दों को समझना
आप यहाँ हैं।
भाग 3 — विवेक विकसित करें AI दावों को समझना: बेहतर निर्णय लेने में मदद करने वाले शब्द
भाग 3 सटीकता, भरोसेमंदी, मूल्यांकन, बेंचमार्क, पूर्वाग्रह, गार्डरेल, प्राइवेसी, इंसानी निगरानी, रीज़निंग के दावों, और स्वायत्तता को देखेगा।
संदर्भ और आगे पढ़ने के लिए
- Google Cloud — Generative AI glossary
ग्राउंडिंग, रिट्रीवल, RAG, हैल्यूसिनेशन और जुड़ी जेनरेटिव AI अवधारणाओं को कवर करने वाली शब्दावली। - Google Cloud — Develop a generative AI application
ग्राउंडिंग, रिट्रीवल, मॉडल एडेप्टेशन और एप्लिकेशन आर्किटेक्चर पर मार्गदर्शन। - Microsoft Learn — Retrieval-Augmented Generation (RAG) and indexes
रिट्रीवल, ऑगमेंटेशन, जनरेशन, इंडेक्सिंग और अलग-अलग रिट्रीवल तरीक़ों को समझाता है। - Microsoft Learn — RAG evaluators
रिट्रीवल क्वालिटी, ग्राउंडेडनेस, रिलेवेंस और RAG सिस्टम के मूल्यांकन को कवर करता है। - NIST — Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
कन्फैबुलेशन और जेनरेटिव AI से जुड़े दूसरे जोखिमों को कवर करता है। - Google Agent Development Kit documentation
एजेंट वर्कफ़्लो, टूल के इस्तेमाल, बाहरी फ़ंक्शन और ऑर्केस्ट्रेशन को कवर करता है।
टेक्नोलॉजी और प्रोडक्ट का व्यवहार लगातार बदलता रहता है। जब मेमोरी, रिट्रीवल, टूल के इस्तेमाल या एजेंट जैसी क्षमताएं आपके काम के लिए ज़रूरी हों, तो सिर्फ़ लेबल पर भरोसा करने के बजाय जांचें कि वह ख़ास प्रोडक्ट उन्हें असल में कैसे लागू करता है।