कल्पना कीजिए कि आपकी कंपनी एक नए AI असिस्टेंट का मूल्यांकन कर रही है।
वेंडर कहता है:
“हमारा AI 95% सटीक (accuracy) है, एंटरप्राइज़-रेडी है, सुरक्षित है, स्वायत्त (autonomous) है, और आपके व्यवसाय पर प्रशिक्षित है।”
यह प्रभावशाली लगता है।
लेकिन हर हिस्से का वास्तव में क्या मतलब है?
95% किस पर सटीक?
किन जोखिमों के खिलाफ सुरक्षित?
क्या करने के लिए पर्याप्त स्वायत्त?
“आपके व्यवसाय पर प्रशिक्षित” का मतलब है कि मॉडल को फाइन-ट्यून (fine-tuned) किया गया, कंपनी दस्तावेज़ों से जोड़ा गया, या केवल रिट्रीवल के ज़रिए जानकारी तक पहुँच दी गई?
और शायद सबसे महत्वपूर्ण सवाल:
इस दावे का समर्थन कौन सा साक्ष्य (evidence) करता है?
इस सीरीज़ के भाग 1 में, हमने AI की बुनियादी भाषा सीखी।
भाग 2 में, हमने यह समझा कि AI से एक सवाल पूछने और जवाब या कार्रवाई मिलने के बीच क्या हो सकता है।
अब हम AI फ्लुएंसी के अंतिम भाग तक पहुँचे हैं:
विवेक (judgment)।
लक्ष्य हर AI दावे पर संदेह करना नहीं है।
यह जानना है कि किसी दावे को स्वीकार करने से पहले क्या पूछना चाहिए।
दावे से शुरू करें, मार्केटिंग भाषा से नहीं
इस स्टेटमेंट पर फिर से विचार करें:
“95% सटीक।”
यह हमें एक संख्या देता है।
लेकिन यह संख्या तब तक बहुत कम मायने रखती है जब तक हमें यह नहीं पता कि यह कैसे तैयार की गई।
क्या AI का परीक्षण किया गया:
- 100 सवालों पर या 100,000 पर?
- सरल सवालों पर या कठिन सवालों पर?
- सार्वजनिक जानकारी पर या कंपनी के वास्तविक दस्तावेज़ों पर?
- एक भाषा में या कई भाषाओं में?
- सावधानी से तैयार किए गए प्रॉम्प्ट पर या आम उपयोगकर्ता के सवालों पर?
- उसी तरह के काम पर जिसके लिए आपका संगठन वास्तव में इसका उपयोग करने की योजना बना रहा है?
बिना संदर्भ के एक संख्या सटीक दिखते हुए भी बहुत कम बता सकती है।
इसलिए जब आप किसी AI दावे का सामना करें, तो एक उपयोगी पहला सवाल यह है:
वास्तव में क्या मापा गया था?
सटीकता (accuracy) और विश्वसनीयता (reliability) एक जैसी नहीं हैं
सटीकता और विश्वसनीयता शब्दों का इस्तेमाल अक्सर एक जैसे अर्थ में किया जाता है।
वे नहीं हैं।
सटीकता
सटीकता यह पूछती है कि क्या कोई जवाब या भविष्यवाणी किसी अपेक्षित परिणाम के अनुसार सही है।
मान लीजिए एक AI असिस्टेंट 100 में से 95 परीक्षण सवालों का सही जवाब देता है।
उस परीक्षण पर, हम इसकी सटीकता को 95% बता सकते हैं।
लेकिन यह अभी भी बाकी पाँच विफलताओं के बारे में कुछ नहीं बताता।
क्या वे छोटी गलतियाँ थीं?
या सिस्टम ने पूरे आत्मविश्वास के साथ खतरनाक रूप से गलत जवाब दिए?
विश्वसनीयता
विश्वसनीयता यह पूछती है कि क्या सिस्टम इच्छित उपयोग के लिए पर्याप्त रूप से लगातार व्यवहार करता है।
दो सिस्टम की कल्पना करें।
सिस्टम A
95% सवालों का सही जवाब देता है लेकिन जब उसे पता नहीं होता तो कभी-कभी आत्मविश्वास से एक जवाब गढ़ लेता है।
सिस्टम B
92% सही जवाब देता है लेकिन ज़्यादातर अनिश्चित मामलों में भरोसे से कहता है:
“मेरे पास इसका जवाब देने के लिए पर्याप्त जानकारी नहीं है।”
ज़्यादातर अनिश्चित मामलों के लिए।
कौन सा बेहतर है?
इसका कोई सार्वभौमिक जवाब नहीं है।
यह काम पर निर्भर करता है।
एक सामान्य सारांश लिखने के लिए, सिस्टम A स्वीकार्य हो सकता है।
कानूनी, वित्तीय, चिकित्सा, या परिचालन निर्णयों के लिए, विफलताओं का व्यवहार औसत स्कोर से कहीं ज़्यादा मायने रख सकता है।
याद रखें
सटीकता पूछती है: क्या जवाब सही था?
विश्वसनीयता पूछती है: क्या मैं समय के साथ और विभिन्न स्थितियों में सिस्टम के स्वीकार्य व्यवहार पर भरोसा कर सकता हूँ?
यही कारण है कि केवल एक सटीकता प्रतिशत को चर्चा समाप्त नहीं करनी चाहिए।
बेंचमार्क (benchmark) एक परीक्षण है, असली दुनिया नहीं
AI घोषणाओं में अक्सर बेंचमार्क का ज़िक्र होता है।
बेंचमार्क एक मानकीकृत परीक्षण या डेटासेट है जिसका उपयोग विशेष कार्यों पर सिस्टम की तुलना करने के लिए किया जाता है।
बेंचमार्क उपयोगी हो सकते हैं।
वे शोधकर्ताओं और डेवलपर्स को इनकी तुलना करने में मदद कर सकते हैं:
- भाषा समझ;
- कोडिंग;
- गणित;
- रीज़निंग (reasoning) कार्य;
- इमेज पहचान;
- रिट्रीवल;
- सुरक्षा व्यवहार;
- अन्य क्षमताएँ।
लेकिन एक बेंचमार्क परिणाम स्वचालित रूप से यह नहीं बताता कि आपके संगठन में सिस्टम कितना अच्छा प्रदर्शन करेगा।
मान लीजिए एक AI मॉडल एक दस्तावेज़-सवाल बेंचमार्क पर उच्च स्कोर करता है।
आपके वास्तविक वातावरण में ये हो सकते हैं:
- खराब फ़ॉर्मेट किए गए PDF;
- पुरानी नीतियाँ;
- स्कैन किए गए दस्तावेज़;
- तालिकाएँ;
- परस्पर विरोधी संस्करण;
- आंतरिक संक्षिप्ताक्षर;
- कई भाषाएँ;
- अधूरा डेटा।
वे स्थितियाँ बेंचमार्क से बिल्कुल भी मेल नहीं खा सकतीं।
इसे सोचने का एक उपयोगी तरीका है:
बेंचमार्क केवल यह बताता है कि सिस्टम ने उस बेंचमार्क पर कैसा प्रदर्शन किया।
इससे आगे किसी भी बात के लिए साक्ष्य चाहिए।
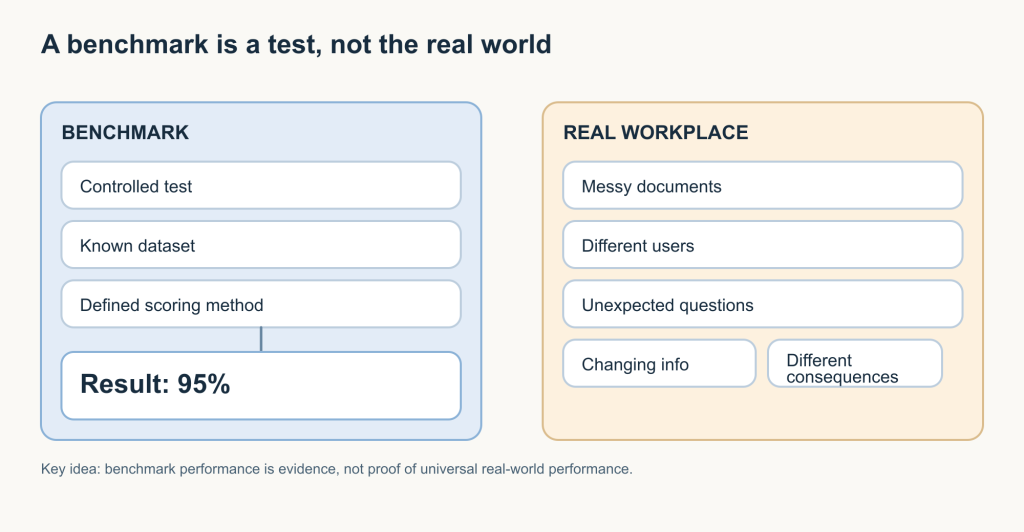
Visual 1 — बेंचमार्क बनाम वास्तविक उपयोग
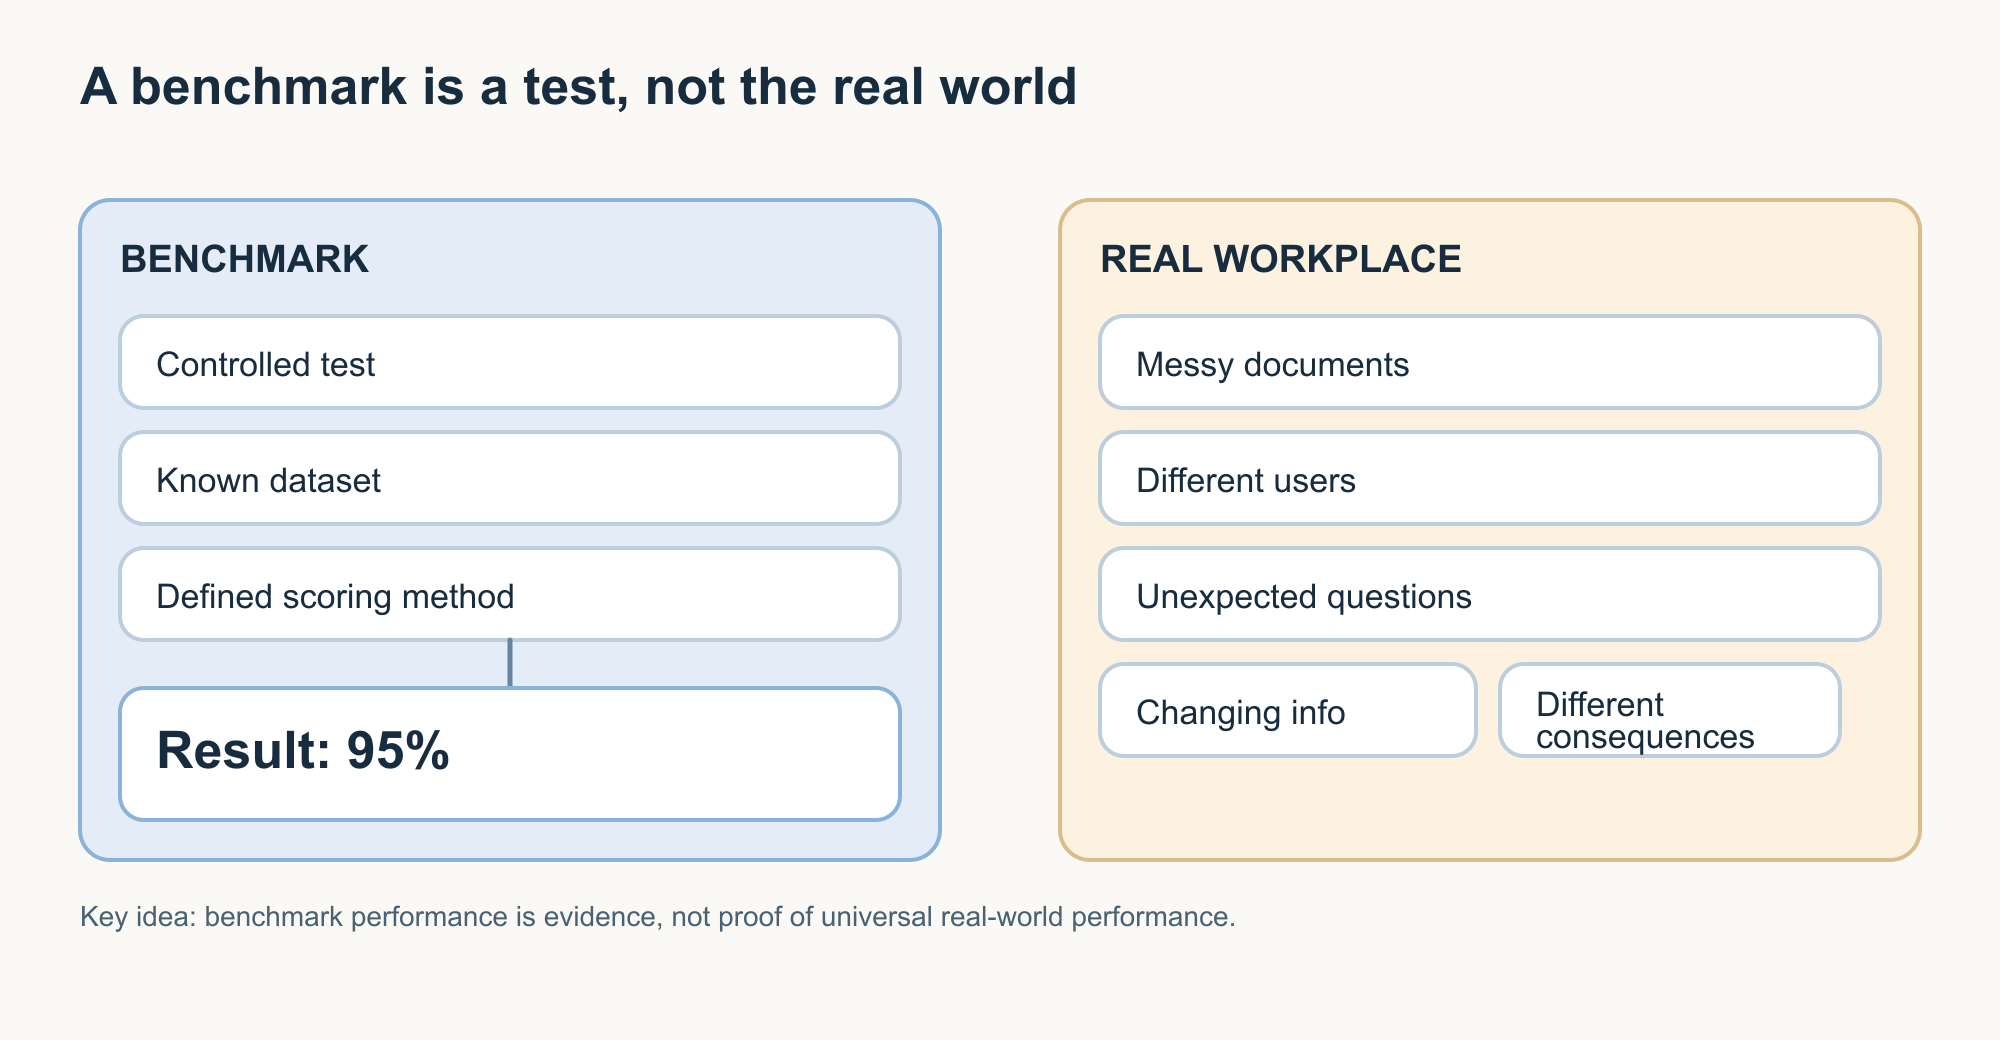
बेंचमार्क
नियंत्रित परीक्षण ज्ञात डेटासेट परिभाषित स्कोरिंग विधि
परिणाम
95%
अब इसकी तुलना करें:
वास्तविक कार्यस्थल
अव्यवस्थित दस्तावेज़ अलग-अलग उपयोगकर्ता अप्रत्याशित सवाल बदलती जानकारी अलग-अलग परिणाम
मुख्य बात: बेंचमार्क प्रदर्शन साक्ष्य है, लेकिन हर वास्तविक दुनिया की स्थिति में प्रदर्शन का प्रमाण नहीं है।
मूल्यांकन (evaluation) क्या है?
मूल्यांकन, जिसे अक्सर संक्षेप में eval कहा जाता है, यह जाँचने का एक संरचित तरीका है कि एक AI सिस्टम कैसे व्यवहार करता है।
एक बेंचमार्क मूल्यांकन का हिस्सा हो सकता है।
लेकिन मूल्यांकन बहुत व्यापक हो सकते हैं।
हमारे काल्पनिक कंपनी असिस्टेंट के लिए, हम यह जाँच सकते हैं:
- क्या यह सामान्य नीति सवालों का सही जवाब देता है?
- क्या यह सही दस्तावेज़ पुनर्प्राप्त करता है?
- क्या यह नीति में अपवाद गढ़ने से बचता है?
- क्या यह बताता है जब जानकारी उपलब्ध नहीं है?
- क्या यह सही स्रोत उद्धृत करता है?
- क्या यह एक ही सवाल को अलग-अलग तरीके से पूछे जाने पर लगातार व्यवहार करता है?
- क्या यह उन कार्रवाइयों को अस्वीकार करता है जिनके लिए इसे अधिकृत नहीं किया गया है?
- क्या यह सही टूल का उपयोग करता है?
- क्या यह ज़रूरत पड़ने पर रुककर मंज़ूरी माँगता है?
यह सिर्फ यह पूछने से कहीं ज़्यादा वास्तविक समस्या के करीब है कि क्या अंतर्निहित मॉडल ने किसी सार्वजनिक बेंचमार्क पर अच्छा स्कोर किया।
वर्तमान मूल्यांकन फ्रेमवर्क प्रदर्शन के विभिन्न पहलुओं को तेज़ी से अलग करते जा रहे हैं। उदाहरण के लिए, रिट्रीवल, ग्राउंडेडनेस, रिलेवेंस, रिस्पॉन्स कंप्लीटनेस, टूल के इस्तेमाल, टास्क पूर्णता, और सुरक्षा को एक संख्या में समेटने के बजाय अलग-अलग मापा जा सकता है।
याद रखें
बेंचमार्क = एक मानक परीक्षण।
मूल्यांकन = यह मापने के लिए एक व्यापक प्रक्रिया कि क्या सिस्टम इच्छित कार्य के लिए अच्छा व्यवहार करता है।
उस काम का मूल्यांकन करें जिसकी आपको वास्तव में परवाह है
अपने काल्पनिक AI असिस्टेंट पर वापस आते हैं।
मान लीजिए वेंडर कहता है:
“95% सटीक।”
एक बेहतर मूल्यांकन में इस तरह के वास्तविक सवाल शामिल हो सकते हैं:
“मैं अगले साल में कितने छुट्टी के दिन आगे ले जा सकता हूँ?”
“अगर मैं साल के बीच में शामिल हुआ तो क्या होगा?”
“क्या यह नीति ठेकेदारों पर लागू होती है?”
“नीति मेरे मामले का जवाब नहीं देती। मुझे क्या करना चाहिए?”
आखिरी सवाल खासतौर पर महत्वपूर्ण है।
एक उपयोगी AI सिस्टम को केवल तब अच्छा प्रदर्शन नहीं करना चाहिए जब जवाब मौजूद हो।
इसे तब भी समझदारी से व्यवहार करना चाहिए जब जवाब मौजूद न हो।
यहीं एक छोटा परीक्षण सेट किसी बड़े मार्केटिंग नंबर से ज़्यादा उजागर कर सकता है।
Visual 2 — वास्तविक कार्य का मूल्यांकन करें
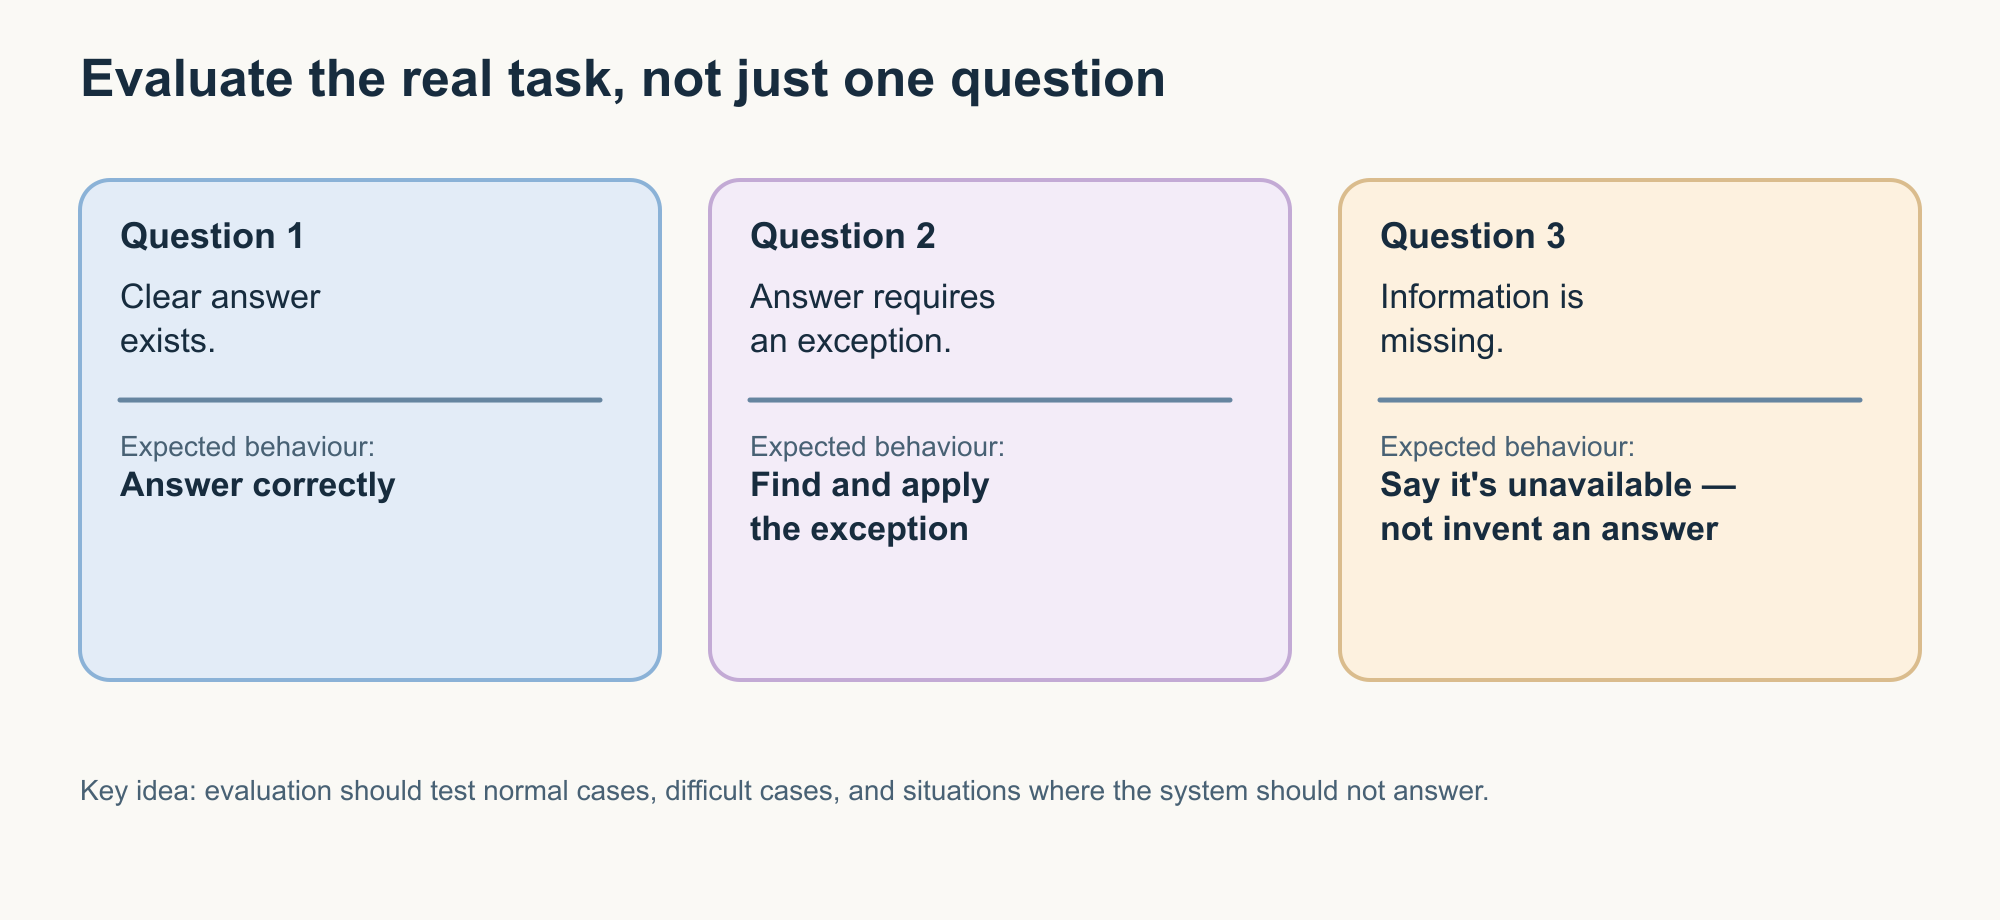
सवाल 1
स्पष्ट जवाब मौजूद है।
अपेक्षित व्यवहार: सही जवाब देना।
सवाल 2
जवाब के लिए एक अपवाद चाहिए।
अपेक्षित व्यवहार: अपवाद को ढूँढना और लागू करना।
सवाल 3
नीति में जवाब नहीं है।
अपेक्षित व्यवहार: यह कहना कि जानकारी उपलब्ध नहीं है, न कि उसे गढ़ना।
मुख्य बात: मूल्यांकन को सामान्य मामलों, कठिन मामलों, और उन स्थितियों की जाँच करनी चाहिए जहाँ सिस्टम को जवाब नहीं देना चाहिए।
एक अच्छा परिणाम सामान्य क्षमता साबित नहीं करता
यह तब खासतौर पर मायने रखता है जब आप कोई AI प्रदर्शन देखते हैं।
एक सिस्टम एक उदाहरण पर बहुत अच्छा प्रदर्शन कर सकता है।
इसका मतलब यह नहीं कि यह उतना ही अच्छा प्रदर्शन करेगा:
- अलग-अलग उपयोगकर्ताओं पर;
- अलग-अलग भाषाओं में;
- लंबे दस्तावेज़ों पर;
- असामान्य इनपुट पर;
- बदलते डेटा पर;
- अन्य उद्योगों में;
- अधिक जोखिम वाले निर्णयों में।
इसे कभी-कभी सामान्यीकरण (generalisation) समस्या कहा जाता है।
सिस्टम उन परिस्थितियों में अच्छा काम कर सकता है जिनमें उसका परीक्षण किया गया था लेकिन उनसे बाहर उतना अच्छा नहीं।
NIST का AI जोखिम प्रबंधन फ्रेमवर्क स्पष्ट रूप से यह दस्तावेज़ करने की माँग करता है कि परिणाम उन परिस्थितियों से आगे कितनी दूर तक सामान्यीकृत किए जा सकते हैं जिनमें सिस्टम को विकसित और मूल्यांकित किया गया था।
एक अच्छा सवाल है:
इसका परीक्षण कहाँ किया गया है, और कहाँ नहीं किया गया है?
बायस (bias) और निष्पक्षता (fairness) के लिए संदर्भ ज़रूरी है
एक और आम AI चर्चा बायस से जुड़ी है।
बायस का मतलब केवल यह नहीं है:
“AI की एक राय है” — यह अर्थ नहीं है।
AI सिस्टम में, बायस कई स्रोतों से आ सकता है:
- प्रशिक्षण डेटा;
- लेबल;
- ऐतिहासिक पैटर्न;
- सैंपलिंग;
- समस्या को कैसे परिभाषित किया जाता है;
- आउटपुट की व्याख्या कैसे की जाती है;
- सिस्टम को कैसे तैनात किया जाता है।
ऐतिहासिक निर्णयों पर प्रशिक्षित एक भर्ती सिस्टम पर विचार करें।
अगर पिछली भर्ती प्रथाओं ने किसी समूह को नुकसान पहुँचाया, तो सिस्टम उन निर्णयों से जुड़े पैटर्न सीख सकता है।
भले ही एक संरक्षित विशेषता को स्पष्ट रूप से हटा दिया जाए, अन्य वेरिएबल अभी भी उससे संबंधित हो सकते हैं।
यही कारण है कि निष्पक्षता का आकलन केवल यह पूछकर नहीं किया जा सकता कि क्या मॉडल जानबूझकर भेदभाव करता है।
ज़्यादा उपयोगी सवाल है:
क्या इस संदर्भ में संबंधित समूहों के लिए सिस्टम के परिणाम अनुचित अंतर पैदा करते हैं?
निष्पक्षता भी कोई एक सार्वभौमिक गणितीय नियम नहीं है।
अलग-अलग स्थितियों में अलग-अलग परिभाषाओं और समझौतों की ज़रूरत हो सकती है।
NIST हानिकारक बायस को प्रबंधित करते हुए निष्पक्षता को कई विश्वसनीयता विशेषताओं में से एक मानता है, न कि किसी एक सार्वभौमिक स्कोर में सिमटने वाली चीज़।
मॉडल के जवाब देने से पहले ही गोपनीयता (privacy) शुरू हो जाती है
मान लीजिए आपका कंपनी असिस्टेंट इन तक पहुँच सकता है:
- कर्मचारी फ़ाइलें;
- ग्राहक रिकॉर्ड;
- अनुबंध;
- ईमेल;
- वित्तीय डेटा।
एक सिस्टम पूरी तरह सटीक जवाब दे सकता है और फिर भी असुरक्षित हो सकता है अगर वह गलत व्यक्ति को जानकारी उजागर करता है।
यही कारण है कि गोपनीयता सिर्फ इतना नहीं है:
“क्या मॉडल मेरा प्रॉम्प्ट याद रखता है?” यह सवाल काफी नहीं है।
उपयोगी सवालों में शामिल हैं:
- सिस्टम किस जानकारी तक पहुँच सकता है?
- क्या यह केवल वही एक्सेस करता है जिसका उपयोगकर्ता हकदार है?
- बातचीत का डेटा कहाँ संग्रहीत किया जाता है?
- यह कितने समय तक बनाए रखा जाता है?
- क्या संवेदनशील जानकारी किसी अन्य सेवा को भेजी जाती है?
- क्या प्रशासक उपयोग की समीक्षा कर सकते हैं?
- क्या डेटा का उपयोग मॉडल सुधार के लिए किया जाता है?
- क्या एक्सेस को रद्द किया जा सकता है?
टूल और कंपनी डेटा का उपयोग करने वाले सिस्टम के लिए, एक्सेस नियंत्रण जवाब की गुणवत्ता जितना ही मायने रखता है।
अत्यधिक अनुमतियों वाला एक शक्तिशाली AI सिस्टम कम नहीं बल्कि ज़्यादा जोखिम पैदा कर सकता है।
“सुरक्षित” अपने आप में बहुत व्यापक है
अब वेंडर के बयान पर वापस आते हैं:
“एंटरप्राइज़-रेडी और सुरक्षित।”
किसके खिलाफ सुरक्षित?
सुरक्षा (security) में बहुत अलग-अलग चिंताएँ शामिल हो सकती हैं:
- अनधिकृत पहुँच;
- क्रेडेंशियल चोरी;
- प्रॉम्प्ट इंजेक्शन;
- डेटा लीकेज;
- हानिकारक फ़ाइलें;
- असुरक्षित टूल कॉल;
- विशेषाधिकार वृद्धि (privilege escalation);
- समझौता किए गए इंटीग्रेशन;
- मॉडल या सेवा का दुरुपयोग;
- सेवा से इनकार (denial of service)।
कोई भी उत्पाद हर संभव अर्थ में बस “सुरक्षित” नहीं होता।
एक बेहतर दावा यह बताएगा:
- किन खतरों पर विचार किया गया;
- कौन से नियंत्रण मौजूद हैं;
- किस तरह का परीक्षण किया गया;
- कौन से जोखिम बाकी हैं।
NIST भी सुरक्षा और लचीलेपन (resilience) को अलग-अलग विश्वसनीयता विशेषताओं के रूप में मानता है जिनके लिए मूल्यांकन और दस्तावेज़ीकरण ज़रूरी है।
याद रखें
जब आप सुनें:
“सुरक्षित AI”
तो पूछें:
किस खतरे के खिलाफ, किन परिस्थितियों में सुरक्षित?
गार्डरेल (guardrails): व्यवहार के इर्द-गिर्द नियंत्रण
आप गार्डरेल शब्द भी सुनेंगे।
गार्डरेल ऐसे नियंत्रण हैं जो AI के व्यवहार को सीमित करने या मार्गदर्शन करने के लिए बनाए गए हैं।
इनमें शामिल हो सकते हैं:
- कंटेंट फ़िल्टर;
- अनुमत-टूल सूचियाँ;
- अनुमति जाँच;
- सत्यापन नियम;
- दर सीमाएँ (rate limits);
- मानव अनुमोदन;
- नीति जाँच;
- आउटपुट प्रतिबंध।
उदाहरण के लिए, एक AI असिस्टेंट को भुगतान अनुरोध का मसौदा तैयार करने की अनुमति हो सकती है लेकिन उसे सबमिट करने की नहीं।
या इसे कर्मचारी जानकारी खोजने की अनुमति हो सकती है लेकिन केवल अनुरोध करने वाले उपयोगकर्ता की अनुमतियों के भीतर।
गार्डरेल उपयोगी होते हैं।
लेकिन किसी गार्डरेल का मौजूद होना यह मतलब नहीं रखता कि सिस्टम कभी विफल नहीं हो सकता।
एक बेहतर सवाल है:
यह गार्डरेल किस व्यवहार को नियंत्रित करता है, और उस नियंत्रण का परीक्षण कैसे किया गया है?
मानव निगरानी (human oversight) का मतलब सिर्फ एक अनुमोदन बटन जोड़ने से कहीं ज़्यादा है
कई AI उत्पाद ह्यूमन-इन-द-लूप या मानव निगरानी का ज़िक्र करते हैं।
यह भरोसा दिलाने वाला लगता है।
लेकिन निगरानी की गुणवत्ता इस बात पर निर्भर करती है कि इसे कैसे डिज़ाइन किया गया है।
कल्पना करें कि एक AI सिस्टम रोज़ाना 500 निर्णय तैयार करता है और एक कर्मचारी से हर एक को मंज़ूर करने के लिए कहता है।
तकनीकी रूप से, एक इंसान शामिल है।
व्यावहारिक रूप से, कर्मचारी बिना सार्थक समीक्षा के मंज़ूर करें पर क्लिक करना शुरू कर सकता है।
अच्छी निगरानी को इस तरह के सवालों का जवाब देना चाहिए:
- किन निर्णयों की समीक्षा ज़रूरी है?
- समीक्षक को क्या जानकारी दिखती है?
- क्या समीक्षक यह समझ सकता है कि सिस्टम ने वह सिफारिश क्यों की?
- क्या समीक्षक इसे अस्वीकार या सुधार सकता है?
- क्या उच्च-जोखिम वाले मामलों को अलग तरीके से आगे बढ़ाया जाता है?
- क्या कार्यभार यथार्थवादी है?
मानव निगरानी एक सार्थक नियंत्रण होनी चाहिए, न कि सिर्फ एक लेबल।
Visual 3 — गार्डरेल बनाम मानव निगरानी
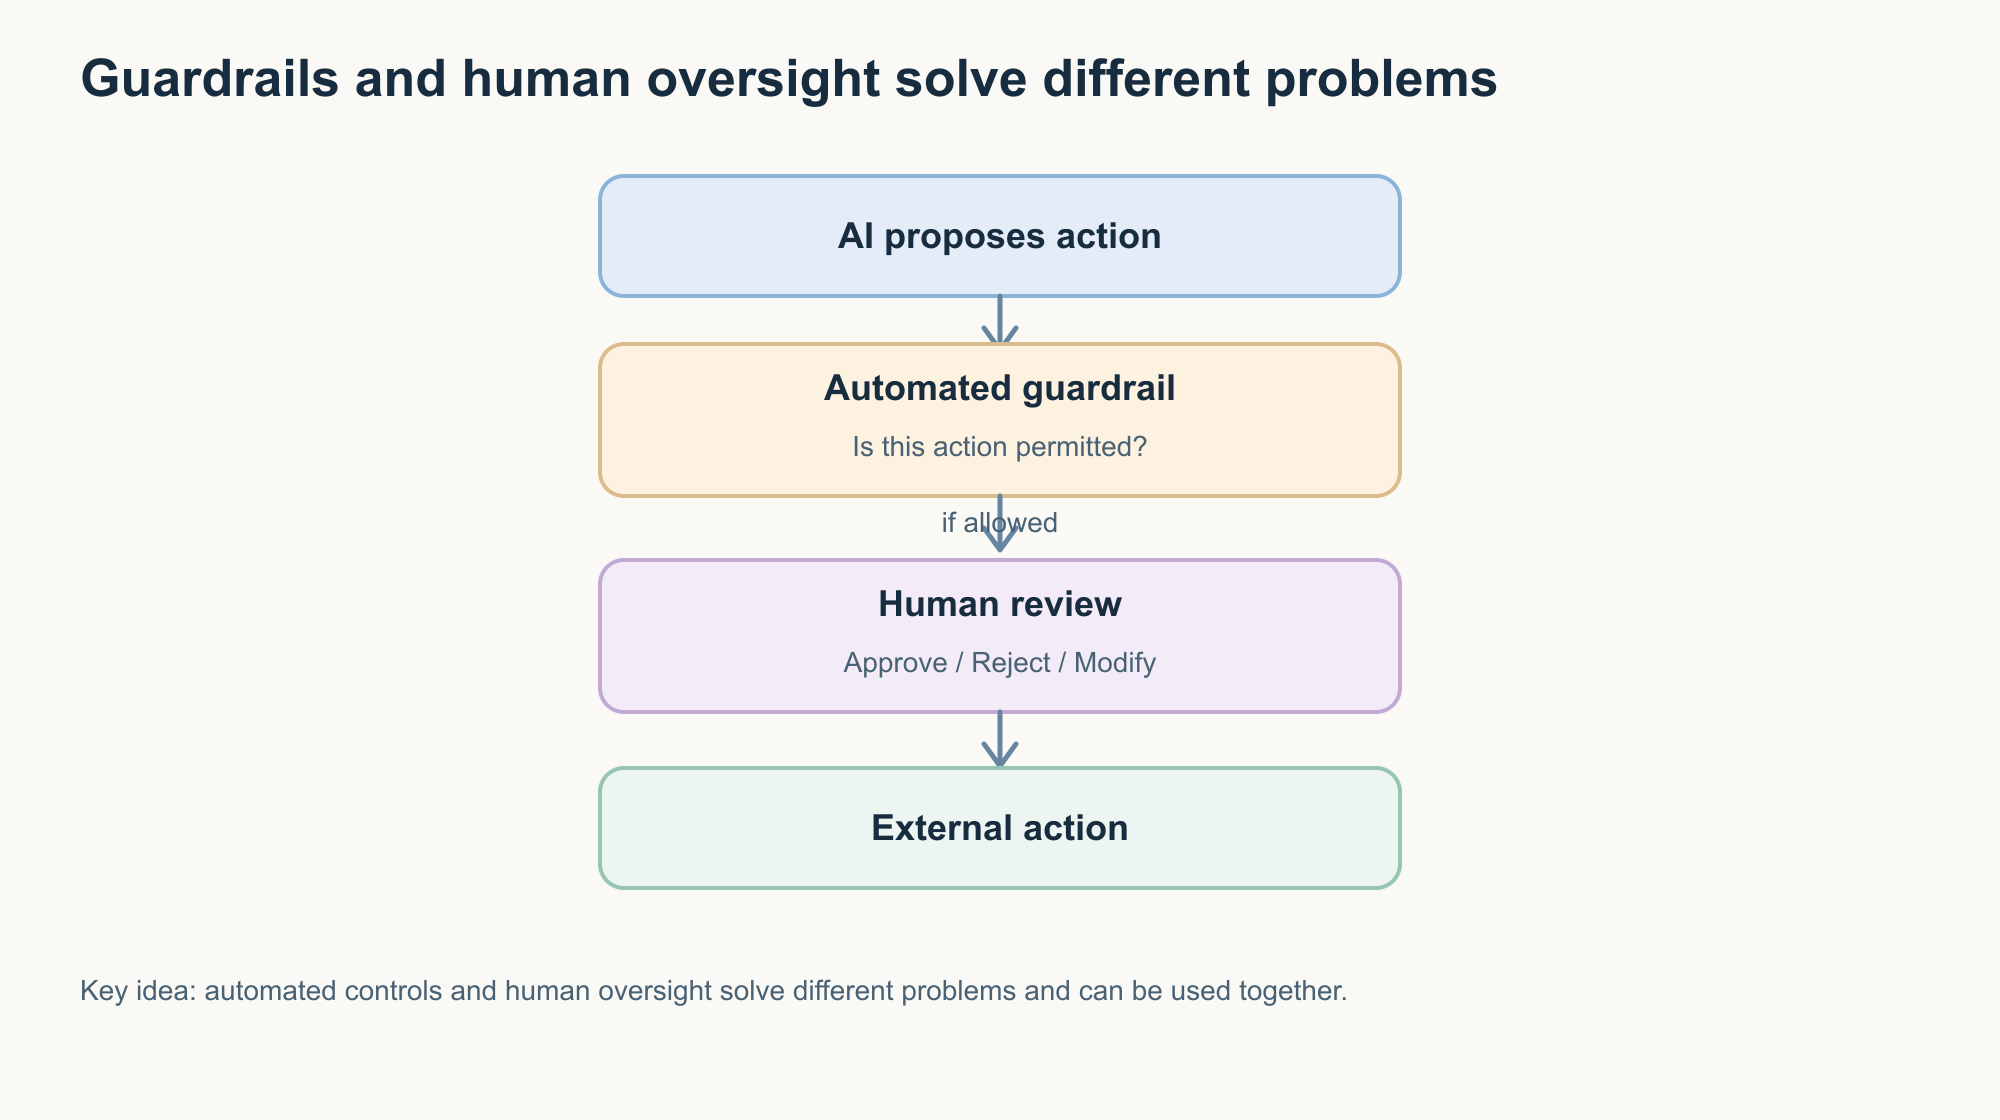
AI कार्रवाई प्रस्तावित करता है
स्वचालित गार्डरेल
क्या यह कार्रवाई अनुमत है?
अगर अनुमति है:
महत्वपूर्ण कार्रवाई के लिए मानव समीक्षा
मंज़ूर करें / अस्वीकार करें / संशोधित करें
बाहरी कार्रवाई
मुख्य बात: स्वचालित नियंत्रण और मानव निगरानी अलग-अलग समस्याओं को हल करते हैं और इन्हें साथ में इस्तेमाल किया जा सकता है।
“आपके व्यवसाय पर प्रशिक्षित” के कई अलग-अलग मतलब हो सकते हैं
यह गलत समझे जाने वाले सबसे आसान AI वाक्यांशों में से एक है।
एक वेंडर कहता है:
“सिस्टम को आपकी कंपनी के डेटा पर प्रशिक्षित किया गया है।”
तकनीकी रूप से क्या हुआ?
कई संभावनाएँ हैं।
जानकारी प्रॉम्प्ट या संदर्भ में दी जाती है
आपकी कंपनी की सामग्री कार्य के दौरान मॉडल को दी जाती है।
अंतर्निहित मॉडल ज़रूरी नहीं कि बदला गया हो।
सिस्टम RAG का उपयोग करता है
ज़रूरत पड़ने पर प्रासंगिक कंपनी जानकारी पुनर्प्राप्त कर मॉडल को दी जाती है।
फिर से, बेस मॉडल अपरिवर्तित रह सकता है।
मॉडल को फाइन-ट्यून किया गया
अतिरिक्त प्रशिक्षण ने मॉडल के पैरामीटर बदल दिए ताकि उसका व्यवहार या प्रदर्शन अनुकूलित हो सके।
ये तरीके एक जैसे नहीं हैं।
काम के आधार पर एक दूसरे से ज़्यादा उपयुक्त हो सकता है।
Visual 4 — तीन अलग-अलग तरीके
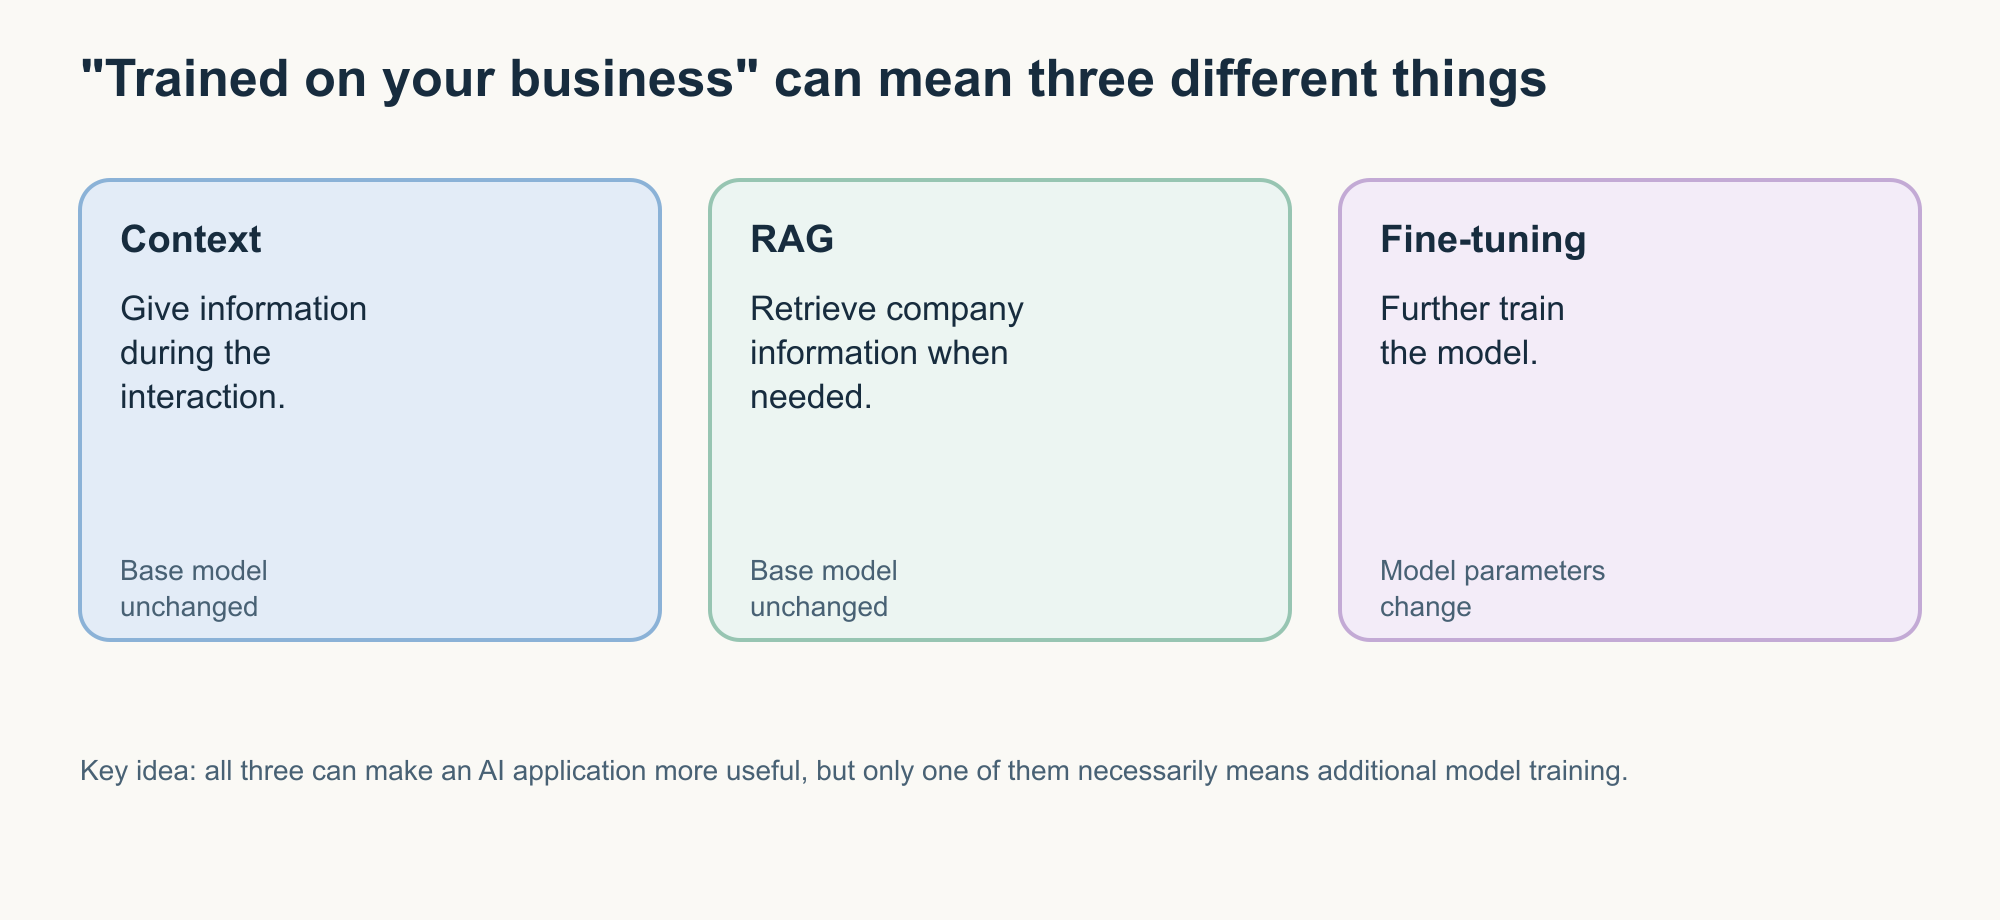
संदर्भ (Context)
बातचीत के दौरान जानकारी देना।
RAG
ज़रूरत पड़ने पर कंपनी की जानकारी पुनर्प्राप्त करना।
फाइन-ट्यूनिंग
मॉडल को आगे प्रशिक्षित करना।
मुख्य बात: तीनों एक AI एप्लिकेशन को व्यवसाय के लिए ज़्यादा उपयोगी बना सकते हैं, लेकिन इनमें से केवल एक ज़रूरी रूप से अतिरिक्त मॉडल प्रशिक्षण का मतलब रखता है।
जब कोई कहे:
“हमारा AI आपके डेटा पर प्रशिक्षित है,”
तो पूछें:
आपका मतलब संदर्भ, रिट्रीवल, या वास्तविक मॉडल प्रशिक्षण से है?
“रीज़निंग” उपयोगी भाषा है, लेकिन इसके निहितार्थ से सावधान रहें
आधुनिक AI सिस्टम को अक्सर रीज़निंग मॉडल या मज़बूत रीज़निंग क्षमताओं वाला बताया जाता है।
व्यावहारिक उत्पाद चर्चाओं में, इसका आमतौर पर मतलब है कि सिस्टम कई जुड़े हुए चरणों वाले कार्यों में बेहतर प्रदर्शन करता है, जैसे:
- गणित;
- कोडिंग;
- योजना बनाना;
- तार्किक समस्याएँ;
- जानकारी को जोड़ना।
यह क्षमता का एक उपयोगी विवरण हो सकता है।
लेकिन ऐसे शब्द:
- सोचना;
- समझना;
- रीज़निंग;
- जानना;
ये भी सामान्य मानवीय शब्द हैं।
AI के लिए इनका उपयोग करने से सिस्टम के बारे में वास्तव में प्रदर्शित की गई बातों से कहीं ज़्यादा मान लेना आसान हो जाता है।
उपयोगी सवाल यह नहीं है:
“क्या यह AI वाकई सोचता है?”
ज़्यादातर उत्पाद निर्णयों के लिए, बेहतर सवाल है:
यह कौन से कार्य कर सकता है, इसे कैसे मापा गया, और यह अभी भी कहाँ विफल होता है?
यह चर्चा को साक्ष्य से जोड़े रखता है।
स्वायत्तता (autonomy) कोई एक स्विच नहीं है
एक और लोकप्रिय शब्द है स्वायत्त (autonomous)।
एक वेंडर कह सकता है:
“हमारा AI एजेंट स्वायत्त रूप से काम करता है।”
इसका मतलब बहुत अलग-अलग हो सकता है।
सिस्टम यह कर सकता है:
- कौन सा दस्तावेज़ खोजना है यह चुनना;
- कौन सा टूल कॉल करना है यह तय करना;
- कई मध्यवर्ती निर्णय लेना;
- बिना मंज़ूरी के ईमेल भेजना;
- ग्राहक डेटा में बदलाव करना;
- वित्तीय लेनदेन निष्पादित करना।
ये बहुत अलग-अलग स्तर की स्वायत्तता हैं।
इसके बजाय:
“क्या यह स्वायत्त है?”
पूछने के बजाय पूछें:
यह खुद क्या तय कर सकता है?
और:
यह बिना मानव मंज़ूरी के क्या कर सकता है?
ये सवाल कहीं ज़्यादा उजागर करते हैं।
केवल अंतिम जवाब का नहीं, रास्ते का भी मूल्यांकन करें
यह एजेंट के साथ खासतौर पर महत्वपूर्ण हो जाता है।
मान लीजिए एक एजेंट सफलतापूर्वक सही मीटिंग बुक करता है।
अंतिम परिणाम सही दिखता है।
लेकिन शायद इसने:
- अनावश्यक सिस्टम से पूछताछ की;
- ऐसी जानकारी तक पहुँच बनाई जिसकी उसे ज़रूरत नहीं थी;
- गलत टूल को कई बार कॉल किया;
- रास्ते में संवेदनशील जानकारी उजागर कर दी;
- बार-बार विफल होने के बाद ही सफलता पाई।
अगर हम केवल अंतिम मीटिंग बुकिंग देखें, तो हम महत्वपूर्ण व्यवहार को नज़रअंदाज़ कर देते हैं।
आधुनिक एजेंट मूल्यांकन अंतिम परिणाम और उस तक पहुँचने के लिए एजेंट द्वारा की गई कार्रवाइयों के क्रम, यानी ट्रैजेक्टरी (trajectory), के बीच तेज़ी से अंतर करते जा रहे हैं। उदाहरण के लिए, Google अंतिम-प्रतिक्रिया मूल्यांकन को ट्रैजेक्टरी मूल्यांकन से अलग दस्तावेज़ करता है, जबकि Microsoft टास्क पूर्णता और टूल चयन/उपयोग के आसपास मेट्रिक्स प्रस्तुत करता है।
याद रखें
एक एजेंट के लिए:
क्या इसने काम पूरा किया?
यह एक सवाल है।
इसने काम कैसे पूरा किया?
यह एक और सवाल है।
Visual 5 — परिणाम और रास्ता दोनों का मूल्यांकन करें
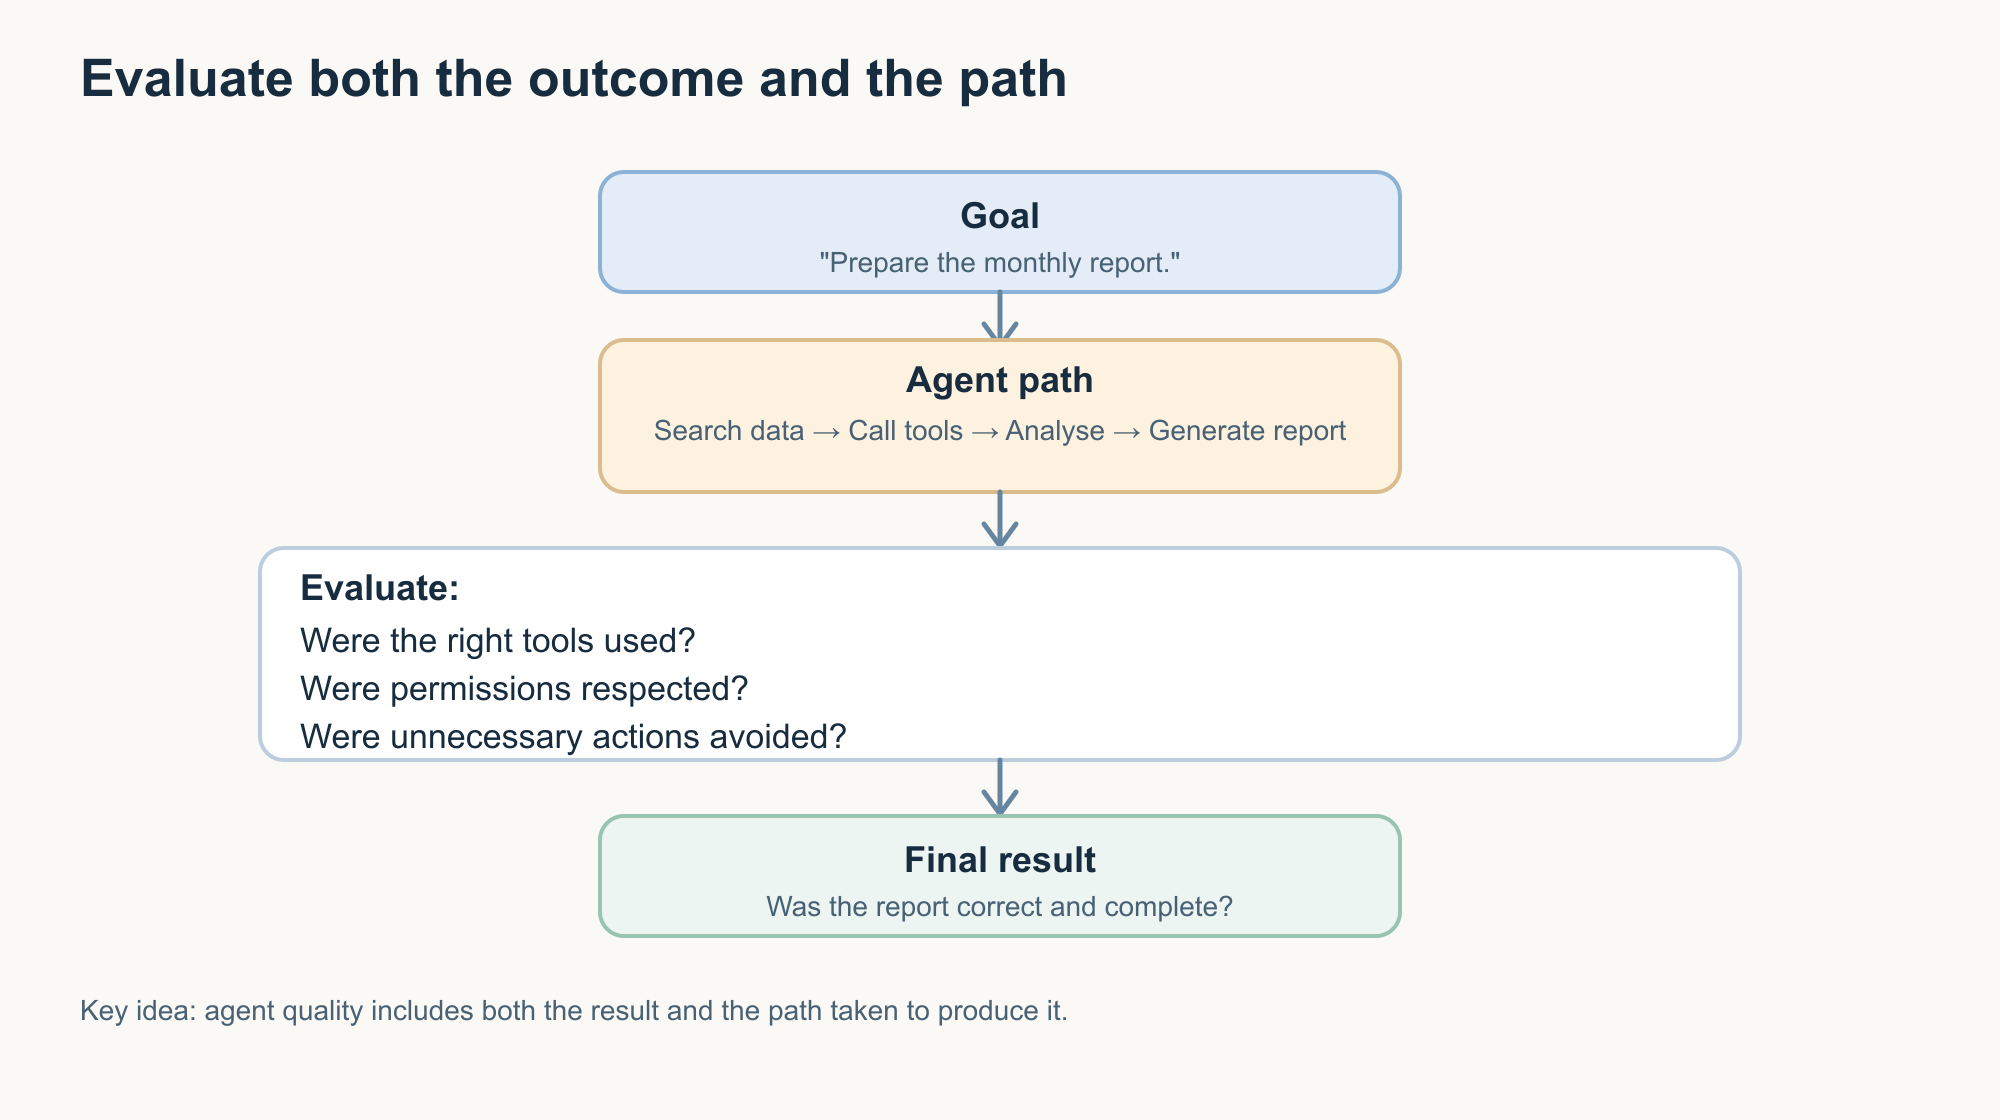
लक्ष्य
“मासिक रिपोर्ट तैयार करें।”
एजेंट का रास्ता
डेटा खोजें → टूल कॉल करें → विश्लेषण करें → रिपोर्ट बनाएं
मूल्यांकन करें:
- क्या सही टूल का इस्तेमाल हुआ?
- क्या अनुमतियों का सम्मान किया गया?
- क्या अनावश्यक कार्रवाइयों से बचा गया?
अंतिम परिणाम
क्या रिपोर्ट सही और पूर्ण थी?
मुख्य बात: एजेंट की गुणवत्ता में परिणाम और उसे तैयार करने के लिए अपनाया गया रास्ता, दोनों शामिल हैं।
एक डेमो मूल्यांकन नहीं है
AI डेमो बेहद उपयोगी हो सकते हैं।
वे हमें यह देखने में मदद करते हैं कि तकनीक क्या कर सकती है।
लेकिन एक डेमो आमतौर पर यह दिखाता है:
यह इन परिस्थितियों में एक बार काम किया।
एक मूल्यांकन पूछता है:
यह कितनी बार काम करता है, किन परिस्थितियों में, और यह कैसे विफल होता है?
एक AI सिस्टम जब इससे:
दिलचस्प प्रोटोटाइप
से:
कुछ ऐसा जिस पर लोग भरोसा करते हैं की ओर बढ़ता है, तब यह अंतर खासतौर पर महत्वपूर्ण हो जाता है।
अगर कोई वेंडर एक पॉलिश किया हुआ डेमो दिखाता है, तो उपयोगी अनुवर्ती सवाल हैं:
- कितने समान मामलों का परीक्षण किया गया?
- सफलता दर क्या थी?
- विफलता के मामले क्या थे?
- क्या सामान्य उपयोगकर्ता शामिल थे?
- क्या परीक्षण डेटा प्रतिनिधिक था?
- ज़रूरी जानकारी न होने पर क्या होता है?
- सिस्टम को अप्रत्याशित इनपुट मिलने पर क्या होता है?
एक विफल मूल्यांकन हमेशा बुरी खबर नहीं होता।
तैनाती से पहले विफलताओं को खोजना मूल्यांकन के उद्देश्यों में से एक है।
लॉन्च के बाद AI की गुणवत्ता बदल सकती है
एक मज़बूत रिलीज़-पूर्व मूल्यांकन भी अंत नहीं है।
एक AI एप्लिकेशन ऐसे वातावरण में काम करता है जो बदल सकता है।
उदाहरण के लिए:
- अंतर्निहित मॉडल बदल सकता है;
- कंपनी के दस्तावेज़ बदल सकते हैं;
- रिट्रीवल इंडेक्स अपडेट किए जा सकते हैं;
- उपयोगकर्ता नए तरह के सवाल पूछ सकते हैं;
- बाहरी टूल बदल सकते हैं;
- नीतियाँ बदल सकती हैं;
- हमलावर सिस्टम को प्रभावित करने के नए तरीके खोज सकते हैं।
इसका मतलब है कि AI सिस्टम को तैनाती के बाद भी निगरानी की ज़रूरत हो सकती है।
Google का मौजूदा एजेंट-मूल्यांकन मार्गदर्शन बार-बार होने वाले विकास मूल्यांकन, निर्धारित रिग्रेशन परीक्षण, और निरंतर उत्पादन निगरानी के बीच अंतर करता है।
सबक सरल है:
मूल्यांकन केवल लॉन्च से पहले किया जाने वाला काम नहीं है।
एक AI स्कोर हर सवाल का जवाब नहीं दे सकता
अपने काल्पनिक वेंडर पर वापस आते हैं।
कल्पना करें कि इसकी प्रस्तुति कहती है:
AI ट्रस्ट स्कोर: 92/100
यह आंतरिक रूप से उपयोगी हो सकता है अगर स्कोरिंग विधि स्पष्ट रूप से परिभाषित हो।
लेकिन इसे अंतर्निहित सवालों को छुपाना नहीं चाहिए।
एक सिस्टम हो सकता है:
- बहुत सटीक लेकिन गोपनीयता में कमज़ोर;
- सुरक्षित लेकिन अविश्वसनीय;
- अंग्रेज़ी में विश्वसनीय लेकिन किसी अन्य भाषा में कमज़ोर;
- सवालों का जवाब देने में उत्कृष्ट लेकिन टूल एक्सेस मिलने पर असुरक्षित;
- एक परीक्षित आबादी में निष्पक्ष लेकिन दूसरी में अमूल्यांकित।
यही कारण है कि AI की विश्वसनीयता को एक सार्वभौमिक स्कोर के बजाय कई जुड़ी हुई विशेषताओं के रूप में समझना बेहतर है। NIST का फ्रेमवर्क स्पष्ट रूप से वैधता और विश्वसनीयता, सुरक्षा, सुरक्षा और लचीलापन, जवाबदेही और पारदर्शिता, व्याख्येयता, गोपनीयता, और निष्पक्षता जैसी विशेषताओं को अलग करता है।
खुद आज़माएं: एक AI दावे से सवाल करें
इस तरह का एक बयान लें:
“हमारा AI असिस्टेंट 97% सटीक है।”
तुरंत यह तय न करें कि दावा अच्छा है या बुरा।
इसके बजाय पूछें:
- 97% किस काम पर?
- किस परीक्षण डेटा का उपयोग किया गया?
- कितने उदाहरणों का परीक्षण किया गया?
- क्या कठिन और जानकारी-रहित मामले शामिल थे?
- क्या प्रदर्शन हमारे जैसे उपयोगकर्ताओं पर मापा गया था?
- बाकी 3% में किस तरह की विफलताएँ हुईं?
- क्या यह संख्या केवल जवाब की सटीकता मापती है, या सुरक्षा और विश्वसनीयता भी?
- क्या तैनाती के बाद प्रदर्शन का परीक्षण किया गया है?
अब एक और दावा लें:
“हमारा एजेंट पूरी तरह स्वायत्त है।”
पूछें:
- यह कौन से निर्णय ले सकता है?
- यह किन टूल का उपयोग कर सकता है?
- किन कार्रवाइयों के लिए मंज़ूरी चाहिए?
- इसे अपनी अनुमतियों से आगे जाने से क्या रोकता है?
- कार्य की सफलता कैसे मापी जाती है?
- क्या टूल कॉल के क्रम का मूल्यांकन किया जाता है?
- सिस्टम के अनिश्चित होने पर क्या होता है?
अब आप शब्दों पर प्रतिक्रिया नहीं दे रहे हैं।
आप साक्ष्य माँग रहे हैं।
यही वह कौशल है जिसे यह लेख विकसित करने की कोशिश कर रहा है।
AI दावों का मूल्यांकन करने के लिए एक सरल फ्रेमवर्क
जब आप किसी AI दावे का सामना करें, तो पाँच सवालों का उपयोग करें।
| सवाल | यह क्या उजागर करने में मदद करता है |
|---|---|
| वास्तव में क्या दावा किया जा रहा है? | अस्पष्ट भाषा को हटाता है |
| इसे कैसे मापा गया? | मूल्यांकन विधि को उजागर करता है |
| इसका परीक्षण किस पर किया गया? | दिखाता है कि साक्ष्य आपके उपयोग-मामले से मेल खाता है या नहीं |
| यह कैसे विफल होता है? | औसत स्कोर के पीछे छुपी सीमाओं को उजागर करता है |
| विफल होने पर कौन से नियंत्रण मौजूद हैं? | क्षमता को सुरक्षा और गवर्नेंस से जोड़ता है |
ये सवाल तब भी काम करते हैं जब दावा इनसे संबंधित हो:
- सटीकता;
- विश्वसनीयता;
- सुरक्षा;
- स्वायत्तता;
- रीज़निंग;
- निष्पक्षता;
- एंटरप्राइज़ तैयारी।
वेंडर के बयान पर वापस लौटें
हमने इससे शुरुआत की थी:
“हमारा AI 95% सटीक है, एंटरप्राइज़-रेडी, सुरक्षित, स्वायत्त, और आपके व्यवसाय पर प्रशिक्षित है।”
अब हम इसे बेहतर सवालों में बदल सकते हैं।
“95% सटीक”
किन कार्यों पर?
किन अपेक्षित जवाबों के खिलाफ?
किन परिस्थितियों में?
बाकी 5% में क्या हुआ?
“एंटरप्राइज़-रेडी”
यह किस पैमाने पर संचालित हुआ है?
कौन से एक्सेस नियंत्रण, निगरानी, गवर्नेंस, और सहायता मौजूद है?
“सुरक्षित”
किन खतरों के खिलाफ?
इस दावे का समर्थन किस परीक्षण से होता है?
“स्वायत्त”
यह बिना मंज़ूरी के कौन से निर्णय और कार्रवाई कर सकता है?
“आपके व्यवसाय पर प्रशिक्षित”
क्या मॉडल को वाकई फाइन-ट्यून किया गया था?
या एप्लिकेशन संदर्भ या RAG का उपयोग कर रहा है?
मार्केटिंग वाक्य ज़रूरी नहीं कि झूठा हो गया हो।
यह परीक्षण योग्य बन गया है।
यही अंतर है।
AI फ्लुएंसी हर AI शब्द को जानना नहीं है
इन तीन लेखों में, हम तीन स्तरों से गुज़रे हैं।
भाग 1 — भाषा सीखें
हमने ऐसे शब्द सीखे:
- AI;
- मशीन लर्निंग;
- जनरेटिव AI;
- मॉडल;
- LLM;
- ट्रेनिंग;
- इन्फ़रेंस;
- प्रॉम्प्ट;
- टोकन;
- कॉन्टेक्स्ट विंडो।
भाग 2 — अनुभव को समझें
हमने यह समझा कि AI जब इनके साथ काम करता है तो क्या होता है:
- ग्राउंडिंग;
- रिट्रीवल;
- RAG;
- मेमोरी;
- मल्टीमॉडल इनपुट;
- टूल;
- एजेंट।
भाग 3 — विवेक विकसित करें
हमने सवाल पूछना सीखा:
- सटीकता;
- विश्वसनीयता;
- बेंचमार्क;
- मूल्यांकन;
- बायस;
- गोपनीयता;
- सुरक्षा;
- गार्डरेल;
- मानव निगरानी;
- फाइन-ट्यूनिंग दावे;
- रीज़निंग;
- स्वायत्तता।
शब्दों को जानना उपयोगी है।
सिस्टम कैसे काम करता है यह समझना बेहतर है।
लेकिन दोनों अकेले पर्याप्त नहीं हैं।
अंतिम कौशल यह जानना है कि किस साक्ष्य के लिए पूछना है।
अपनाने लायक आदत
आपको हर AI दावे को तकनीकी ऑडिट से चुनौती देने की ज़रूरत नहीं है।
कई रोज़मर्रा के कामों के लिए, यह अनावश्यक होगा।
लेकिन जब जवाब मायने रखता है, निर्णय के परिणाम होते हैं, या सिस्टम कार्रवाई कर सकता है, तो याद रखने लायक एक सवाल है:
इस पर भरोसा करने में मुझे सहज महसूस कराने के लिए कौन सा साक्ष्य चाहिए?
कभी-कभी जवाब सरल होगा।
एक स्रोत।
एक छोटा परीक्षण।
एक मानव समीक्षा।
एक अनुमति जाँच।
अन्य स्थितियों में, इसके लिए एक गंभीर मूल्यांकन की ज़रूरत हो सकती है।
साक्ष्य का स्तर निर्णय के महत्व से मेल खाना चाहिए।
यह उद्योग द्वारा बनाए गए हर नए शब्द को रटने से कहीं ज़्यादा उपयोगी AI फ्लुएंसी का रूप है।
AI Fluency सीरीज़
भाग 1 — भाषा सीखें AI की भाषा: वे ज़रूरी शब्द जो हर किसी को समझने चाहिए
भाग 1 AI, मशीन लर्निंग, जेनरेटिव AI, मॉडल, LLM, ट्रेनिंग, इन्फरेंस, प्रॉम्प्ट, टोकन और कॉन्टेक्स्ट विंडो को समझाता है।
भाग 2 — अनुभव को समझें AI आपके सवालों का जवाब कैसे देता है: अनुभव के पीछे के शब्दों को समझना
भाग 2 मॉडल से आगे बढ़कर ग्राउंडिंग, रिट्रीवल, RAG, हैल्यूसिनेशन, मेमोरी, मल्टीमोडल AI, टूल और एजेंट को देखता है।
भाग 3 — विवेक विकसित करें AI दावों को समझना: बेहतर निर्णय लेने में मदद करने वाले शब्द
आप यहाँ हैं।
संदर्भ और आगे पढ़ने के लिए
- NIST — AI Risk Management Framework
AI जोखिमों और विश्वसनीयता को समझने और प्रबंधित करने के लिए एक फ्रेमवर्क। - NIST — Trustworthy and Responsible AI
वैधता और विश्वसनीयता, सुरक्षा, सुरक्षा और लचीलापन, जवाबदेही और पारदर्शिता, व्याख्येयता, गोपनीयता, और निष्पक्षता को कवर करता है। - NIST AI RMF — Risks and Trustworthiness
विश्वसनीयता विशेषताओं और संदर्भ से उनके संबंध के बारे में और अधिक व्याख्या। - Microsoft Learn — RAG and AI evaluation guidance
ग्राउंडेडनेस, रिलेवेंस, रिट्रीवल गुणवत्ता, रिस्पॉन्स कंप्लीटनेस, और AI एप्लिकेशन के मूल्यांकन को कवर करता है। - Microsoft Agent Framework — Evaluation
एजेंट टास्क पूर्णता, टूल उपयोग, ग्राउंडेडनेस, रिलेवेंस, और सुरक्षा मूल्यांकन को कवर करता है। - Google Cloud — Agent Evaluation
टास्क-सफलता मूल्यांकन, अंतिम-प्रतिक्रिया मूल्यांकन, ट्रैजेक्टरी मूल्यांकन, रिग्रेशन परीक्षण, और उत्पादन निगरानी को कवर करता है।
तकनीक, मूल्यांकन के तरीके, और उत्पाद शब्दावली लगातार बदलती रहती है। वेंडर की शब्दावली को एक शुरुआती बिंदु मानें। महत्वपूर्ण निर्णयों के लिए, अंतर्निहित साक्ष्य और विशिष्ट सिस्टम दस्तावेज़ीकरण की जाँच करें।