आर्टिफिशियल इंटेलिजेंस (AI) रोज़मर्रा के काम का हिस्सा बनता जा रहा है।
लोग लिखने, खोजने, दस्तावेज़ों का विश्लेषण करने, इमेज बनाने, कोड की समीक्षा करने, मीटिंग्स को संक्षेप में बताने और सवालों के जवाब देने के लिए AI का इस्तेमाल कर रहे हैं।
साथ ही, AI से जुड़ी भाषा को समझना मुश्किल होता जा रहा है।
AI. मशीन लर्निंग. जेनरेटिव AI. LLM. मॉडल. ट्रेनिंग. इन्फरेंस. प्रॉम्प्ट. टोकन. कॉन्टेक्स्ट विंडो.
ये शब्द अक्सर साथ-साथ दिखते हैं, लेकिन इनका मतलब एक जैसा नहीं होता।
इन्हें समझने के लिए आपको AI इंजीनियर बनने की ज़रूरत नहीं है।
आपको बस इतनी भाषा जाननी है कि पता चल सके:
- आप किस तरह की टेक्नोलॉजी इस्तेमाल कर रहे हैं;
- जब आप कुछ पूछते हैं तो क्या होता है;
- एक AI सिस्टम दूसरे से अलग व्यवहार क्यों कर सकता है;
- जब कुछ स्पष्ट न हो तो कौन-से सवाल पूछने लायक हैं।
यह लेख वही आधार तैयार करता है।
एक ज़रूरी बात से शुरुआत करें
अलग-अलग शब्द सीखने से पहले, यह याद रखें:
AI कोई एक टेक्नोलॉजी नहीं है।
आर्टिफिशियल इंटेलिजेंस एक व्यापक क्षेत्र है, जिसमें अलग-अलग तरीके, मॉडल, एप्लिकेशन और मक़सद शामिल हैं।
इसीलिए इस तरह के वाक्य:
“यह AI इस्तेमाल करता है।”
अपने-आप में ज़्यादा कुछ नहीं बताते।
एक स्पैम फ़िल्टर AI इस्तेमाल कर सकता है।
उपकरण की ख़राबी का अनुमान लगाने वाला सिस्टम AI इस्तेमाल कर सकता है।
एक चैटबॉट AI इस्तेमाल कर सकता है।
इमेज बनाने वाला टूल AI इस्तेमाल कर सकता है।
ये सभी एक ही व्यापक क्षेत्र के हो सकते हैं, फिर भी बहुत अलग तरीकों से काम करते हैं।
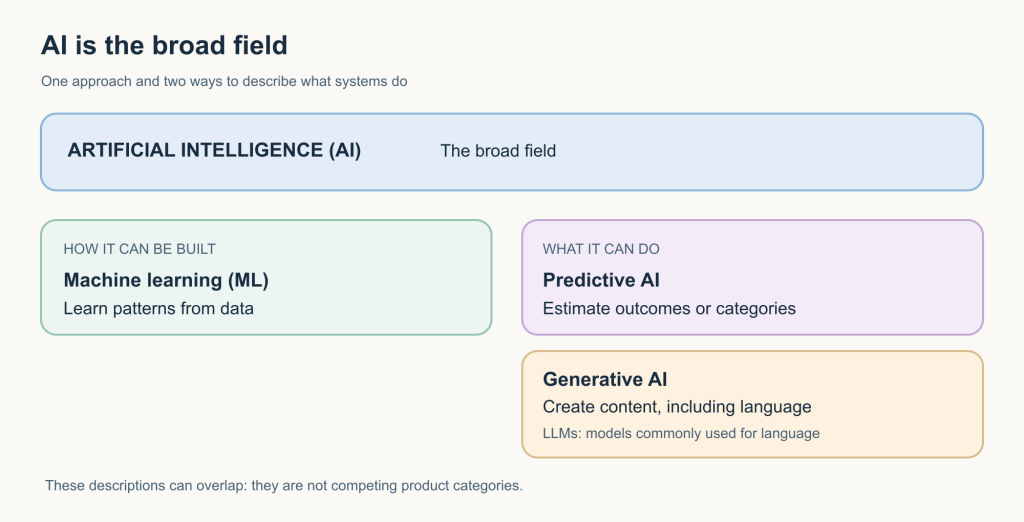
1. आर्टिफिशियल इंटेलिजेंस — बड़ा परिवार
आर्टिफिशियल इंटेलिजेंस, या AI, उन कंप्यूटर सिस्टम के लिए व्यापक शब्द है जिन्हें पैटर्न पहचानने, भाषा समझने, अनुमान लगाने, समस्याएं सुलझाने या कंटेंट बनाने जैसी क्षमताओं से जुड़े काम करने के लिए बनाया गया है।
उदाहरण:
- संदिग्ध वित्तीय लेन-देन पहचानना;
- फ़ोटो में चीज़ों को पहचानना;
- प्रोडक्ट सुझाना;
- भाषाओं का अनुवाद करना;
- मशीन की ख़राबी का अनुमान लगाना;
- टेक्स्ट, कोड, इमेज, ऑडियो या वीडियो बनाना।
याद रखने का सबसे आसान तरीका
AI = बड़ा परिवार।
“AI” को तुरंत “चैटबॉट” मत समझिए।
चैटबॉट AI एप्लिकेशन का सिर्फ़ एक प्रकार हैं।
देखें कि शब्द कैसे जुड़ते हैं
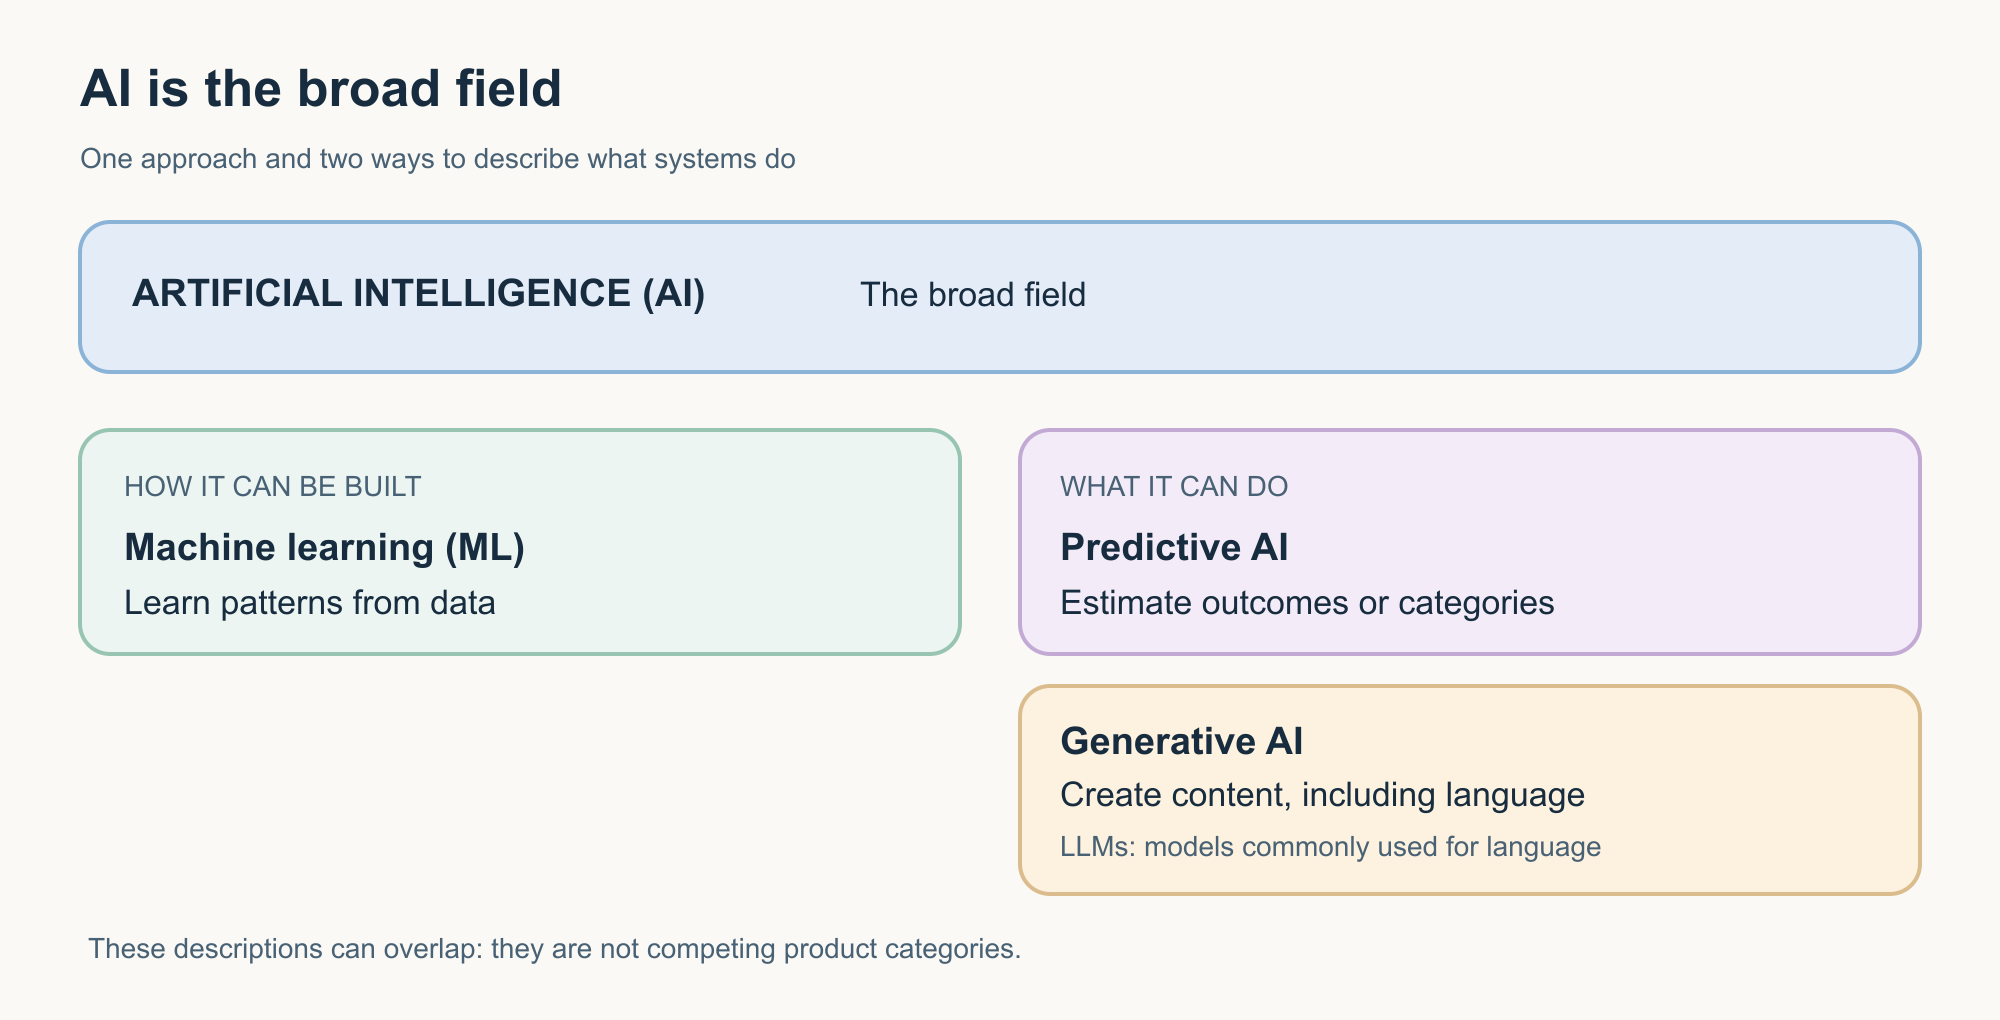
ये रिश्ते हमेशा सीधी शाखाओं जैसे नहीं होते। इनमें से कुछ श्रेणियां आपस में ओवरलैप करती हैं।
इसीलिए AI से जुड़ी शब्दावली अक्सर अलग-अलग चीज़ों को बताती है: एक क्षेत्र, एक तरीका, एक मॉडल, एक क्षमता, या एक तरह का एप्लिकेशन।
2. मशीन लर्निंग — डेटा से पैटर्न सीखना
मशीन लर्निंग, या ML, AI सिस्टम बनाने के महत्वपूर्ण तरीकों में से एक है।
हर नियम को हाथ से लिखने के बजाय, डेवलपर डेटा का इस्तेमाल करके मॉडल को ट्रेनिंग दे सकते हैं, ताकि वह उपयोगी पैटर्न सीख सके।
स्पैम पहचानने के उदाहरण पर विचार करें।
एक प्रोग्रामर हज़ारों नियम बनाने की कोशिश कर सकता है:
- अगर ईमेल में यह वाक्यांश है, तो उसे स्पैम मानें;
- अगर भेजने वाला ऐसा दिखता है, तो स्पैम स्कोर बढ़ाएं;
- अगर मैसेज में ये लिंक हैं, तो उसे अलग तरह से देखें।
यह जल्दी ही मुश्किल हो जाता है।
मशीन-लर्निंग सिस्टम इसके बजाय स्पैम और असली मैसेज के उदाहरणों से पैटर्न सीख सकता है।
ट्रेनिंग के बाद, जब वह नया ईमेल देखता है तो उन सीखे हुए पैटर्न का इस्तेमाल कर सकता है।
याद रखें
मशीन लर्निंग = उदाहरणों से पैटर्न सीखना।
इसका मतलब यह नहीं कि कंप्यूटर बिल्कुल इंसान की तरह सीखता है।
यहां “सीखना” एक तकनीकी प्रक्रिया है, जिसमें मॉडल डेटा और ऑप्टिमाइज़ेशन के आधार पर बदलता है।
3. प्रेडिक्टिव AI और जेनरेटिव AI अलग-अलग तरह की समस्याएं सुलझाते हैं
आज की AI चर्चाओं में दो शब्द बार-बार आते हैं:
प्रेडिक्टिव AI और जेनरेटिव AI।
इन्हें तुलना करके समझना आसान है।
प्रेडिक्टिव AI
प्रेडिक्टिव सिस्टम मौजूदा या भविष्य के डेटा के बारे में कोई अनुमान लगाते हैं।
उदाहरण के लिए:
क्या यह लेन-देन धोखाधड़ी हो सकता है?
क्या यह ग्राहक सेवा बंद कर सकता है?
अगले महीने कितनी मांग हो सकती है?
क्या इस मेडिकल इमेज में कोई ख़ास पैटर्न है?
आउटपुट कोई श्रेणी, संभावना, स्कोर, पूर्वानुमान या सुझाव हो सकता है।
जेनरेटिव AI
जेनरेटिव AI, जिसे अक्सर GenAI कहा जाता है, ट्रेनिंग के दौरान सीखे गए पैटर्न और इस्तेमाल के समय मिली जानकारी के आधार पर नया आउटपुट बनाता है।
वह आउटपुट यह हो सकता है:
- टेक्स्ट;
- कोड;
- इमेज;
- ऑडियो;
- वीडियो;
- या इनका मिश्रण।
उदाहरण के लिए:
इस ग्राहक शिकायत का जवाब लिखें।
इस तकनीकी दस्तावेज़ को सरल अंग्रेज़ी में समझाएं।
सोलर-पावर्ड शहर की एक इलस्ट्रेशन बनाएं।
इस डेटाबेस संरचना के लिए SQL क्वेरी बनाएं।
फ़र्क़ याद रखें
प्रेडिक्टिव AI पूछता है: “क्या होने की संभावना है?”
जेनरेटिव AI पूछता है: “मैं क्या बना सकता हूं?”
यह एक सरलीकरण है, लेकिन शुरुआत के लिए उपयोगी है।
ये श्रेणियां आपस में ओवरलैप भी हो सकती हैं। आधुनिक AI एप्लिकेशन अनुमान, निर्माण, खोज और अन्य क्षमताओं को मिला सकते हैं।
4. मॉडल क्या है?
मॉडल शब्द AI में हर जगह दिखता है।
मॉडल वह ट्रेन्ड कंप्यूटेशनल सिस्टम है, जिसने पैटर्न सीखे हैं और नए इनपुट को प्रोसेस करते समय उन पैटर्न का इस्तेमाल कर सकता है।
इसे उस हिस्से के तौर पर सोचें जो सीखा हुआ काम करता है।
एक फ्रॉड-डिटेक्शन एप्लिकेशन में ऐसा मॉडल हो सकता है जो धोखाधड़ी के जोखिम का अनुमान लगाता है।
एक इमेज एप्लिकेशन में ऐसा मॉडल हो सकता है जो चीज़ों को पहचानता है।
एक AI असिस्टेंट भाषा को समझने और बनाने के लिए एक या ज़्यादा लैंग्वेज मॉडल इस्तेमाल कर सकता है।
मॉडल महत्वपूर्ण है, लेकिन आमतौर पर वह पूरा प्रोडक्ट नहीं होता।
मॉडल और AI एप्लिकेशन एक जैसे नहीं हैं
यह फ़र्क़ समझना आसान से छूट जाता है।
मान लीजिए आप एक ऐसा AI असिस्टेंट इस्तेमाल करते हैं जो यह कर सकता है:
- सवालों के जवाब देना;
- वेब पर खोजना;
- अपलोड की गई फ़ाइलें पढ़ना;
- चुनी हुई जानकारी याद रखना;
- इमेज बनाना;
- कोड चलाना;
- दूसरे सॉफ़्टवेयर से जुड़ना।
अंतर्निहित मॉडल ज़्यादातर बुद्धिमत्ता दे सकता है, लेकिन पूरे एप्लिकेशन में उसके आस-पास और भी हिस्से होते हैं।
मॉडल और AI एप्लिकेशन एक जैसे नहीं हैं
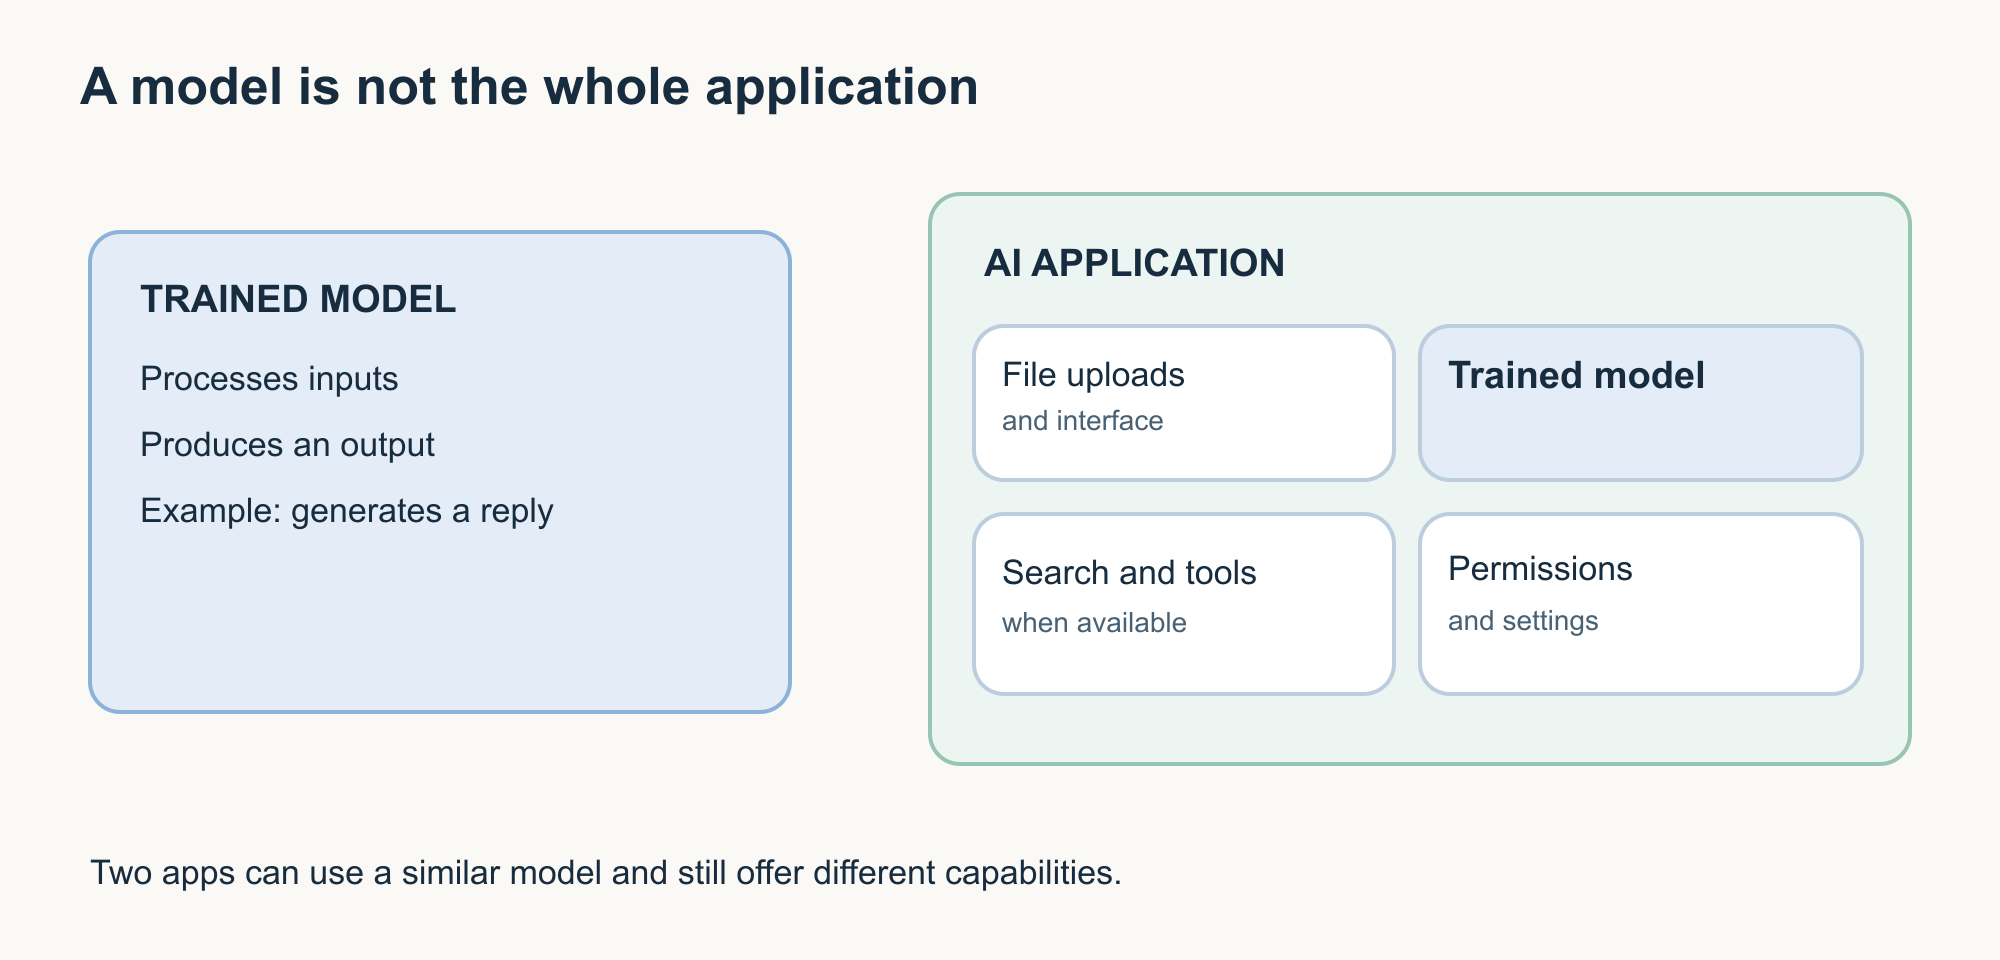
यह बताता है कि मिलते-जुलते अंतर्निहित मॉडल इस्तेमाल करने वाले दो प्रोडक्ट फिर भी अलग तरह से क्यों काम कर सकते हैं।
आस-पास का एप्लिकेशन मायने रखता है।
5. लार्ज लैंग्वेज मॉडल — भाषा के लिए बने मॉडल
लार्ज लैंग्वेज मॉडल, जिसे आमतौर पर LLM कहा जाता है, एक ऐसा मॉडल है जो भाषा के साथ काम करने के लिए बनाया गया है।
LLM इन कामों में मदद कर सकते हैं:
- सवालों के जवाब देना;
- संक्षेप में बताना;
- फिर से लिखना;
- अनुवाद करना;
- जानकारी निकालना;
- ड्राफ़्ट तैयार करना;
- टेक्स्ट का विश्लेषण करना;
- कोड बनाना।
कई आधुनिक AI असिस्टेंट LLM इस्तेमाल करते हैं।
लेकिन:
LLM का मतलब चैटबॉट नहीं है।
LLM मॉडल है।
चैटबॉट एक ऐसा एप्लिकेशन है जो बातचीत के इंटरफ़ेस के इर्द-गिर्द बनाया गया है।
वह एप्लिकेशन फ़ाइलें, टूल, खोज, मेमोरी, सुरक्षा सिस्टम और अन्य क्षमताएं भी दे सकता है।
याद रखें
LLM = लैंग्वेज मॉडल।
चैटबॉट = ऐसा एप्लिकेशन जो उसका इस्तेमाल कर सकता है।
6. ट्रेनिंग — जब मॉडल सीखता है
मॉडल उपयोगी कैसे बनता है?
ट्रेनिंग के ज़रिए।
ट्रेनिंग के दौरान, मॉडल डेटा को प्रोसेस करता है और अपने भीतर की संख्यात्मक वैल्यू को इस तरह समायोजित करता है कि वह जिस काम के लिए ट्रेन किया जा रहा है, उसमें बेहतर होता जाए।
लैंग्वेज मॉडल के लिए, इसमें बड़ी मात्रा में डेटा से सांख्यिकीय पैटर्न सीखना शामिल है।
ट्रेनिंग आपके मॉडल से सामान्य बातचीत करने से पहले ही हो जाती है।
यह एक और ज़रूरी शब्द की ओर ले जाता है।
7. इन्फरेंस — जब ट्रेन्ड मॉडल इस्तेमाल होता है
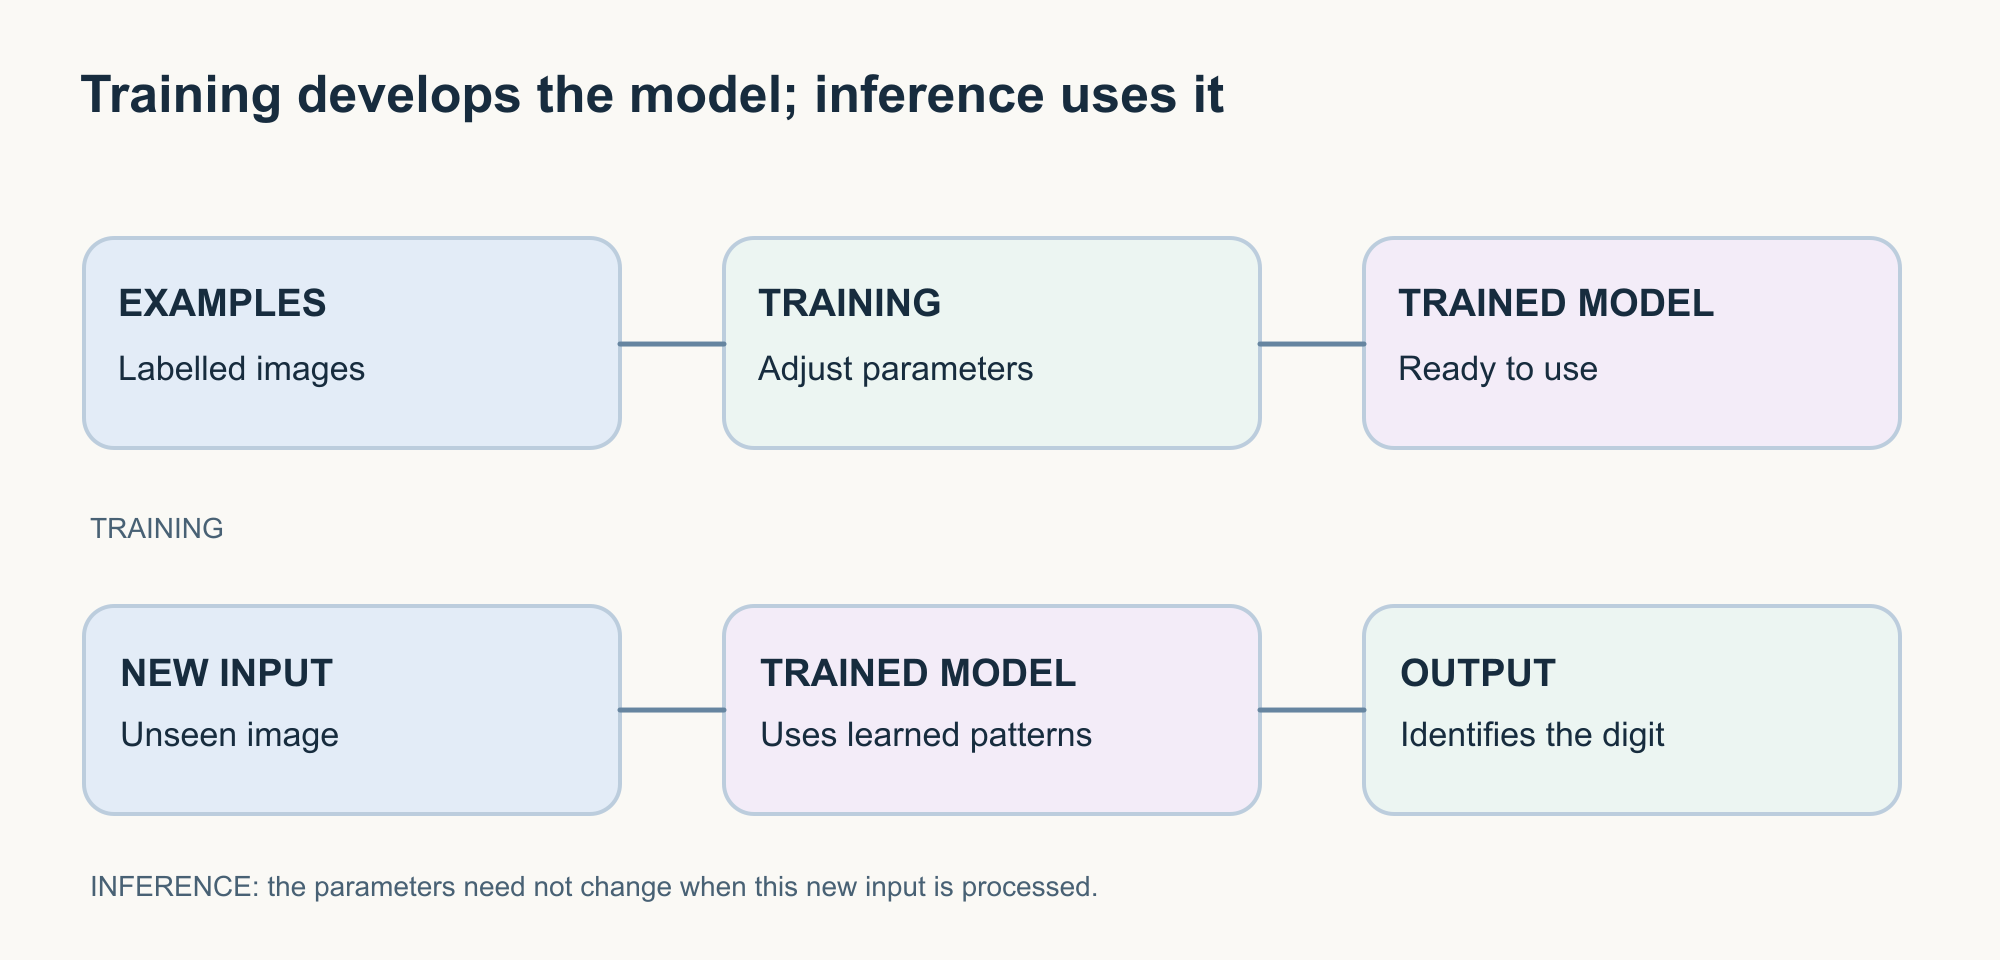
जब आप किसी ट्रेन्ड मॉडल से सवाल पूछते हैं और वह जवाब देता है, तो मॉडल इन्फरेंस कर रहा होता है।
फ़र्क़ सीधा है:
ट्रेनिंग
मॉडल सीखता है या समायोजित होता है।
इन्फरेंस
ट्रेन्ड मॉडल का इस्तेमाल किया जाता है।
इन्फरेंस: ट्रेन्ड मॉडल का इस्तेमाल करना
याद रखें
ट्रेनिंग = सीखने का चरण।
इन्फरेंस = इस्तेमाल करने का चरण।
यह फ़र्क़ इसलिए उपयोगी है क्योंकि कई बार लोग मान लेते हैं कि AI असिस्टेंट से हर बातचीत तुरंत अंतर्निहित मॉडल को कुछ सिखा देती है।
यह हमेशा सच नहीं होता।
बातचीत से मिली जानकारी सहेजी जाती है, याद रखी जाती है, या बाद में सिस्टम बेहतर बनाने के लिए इस्तेमाल होती है या नहीं — यह प्रोडक्ट, कॉन्फ़िगरेशन और प्रोवाइडर की नीतियों पर निर्भर करता है।
8. फाइन-ट्यूनिंग — किसी मक़सद के लिए अतिरिक्त ट्रेनिंग
आपने फाइन-ट्यूनिंग शब्द भी सुना होगा।
फाइन-ट्यूनिंग किसी मौजूदा मॉडल को दी जाने वाली अतिरिक्त ट्रेनिंग है, ताकि उसका व्यवहार या प्रदर्शन ख़ास कामों या क्षेत्रों के लिए बेहतर ढंग से फ़िट हो जाए।
उदाहरण के लिए, किसी मौजूदा मॉडल को ख़ास तरह के टेक्स्ट या ख़ास तरह के जवाब देने के व्यवहार पर बेहतर बनाने के लिए फाइन-ट्यून किया जा सकता है।
याद रखें
ट्रेनिंग मॉडल को बनाती या सिखाती है।
फाइन-ट्यूनिंग किसी मौजूदा मॉडल को और बेहतर ढालती है।
और एक ज़रूरी फ़र्क़:
किसी दस्तावेज़ को अपलोड करके उसके बारे में सवाल पूछना, मॉडल को फाइन-ट्यून करने जैसा नहीं है।
हम उस फ़र्क़ को आर्टिकल 2 में समझेंगे।
AI बनाने से AI इस्तेमाल करने की ओर बढ़ें
अब तक हमने सिर्फ़ टेक्नोलॉजी को देखा है।
अब सोचिए कि आप एक AI असिस्टेंट खोलकर यह टाइप करते हैं:
क्लाउड कंप्यूटिंग समझाएं।
इसके बाद जो होता है, वह शब्दों का एक और ज़रूरी समूह सामने लाता है।
9. प्रॉम्प्ट — आप AI को क्या देते हैं
प्रॉम्प्ट वह इनपुट या निर्देश है जो आप किसी AI सिस्टम को देते हैं।
उदाहरण के लिए:
क्लाउड कंप्यूटिंग समझाएं।
यह एक प्रॉम्प्ट है।
यह भी है:
क्लाउड कंप्यूटिंग को पहले साल के कॉलेज छात्र को समझाएं। एक रोज़मर्रा का उदाहरण इस्तेमाल करें और जवाब को 150 शब्दों से कम रखें।
दूसरे प्रॉम्प्ट में ज़्यादा उपयोगी दिशा-निर्देश है।
यह इन्हें बताता है:
- काम;
- ऑडियंस;
- चाहा गया उदाहरण;
- अपेक्षित लंबाई।
व्यवहार में प्रॉम्प्ट
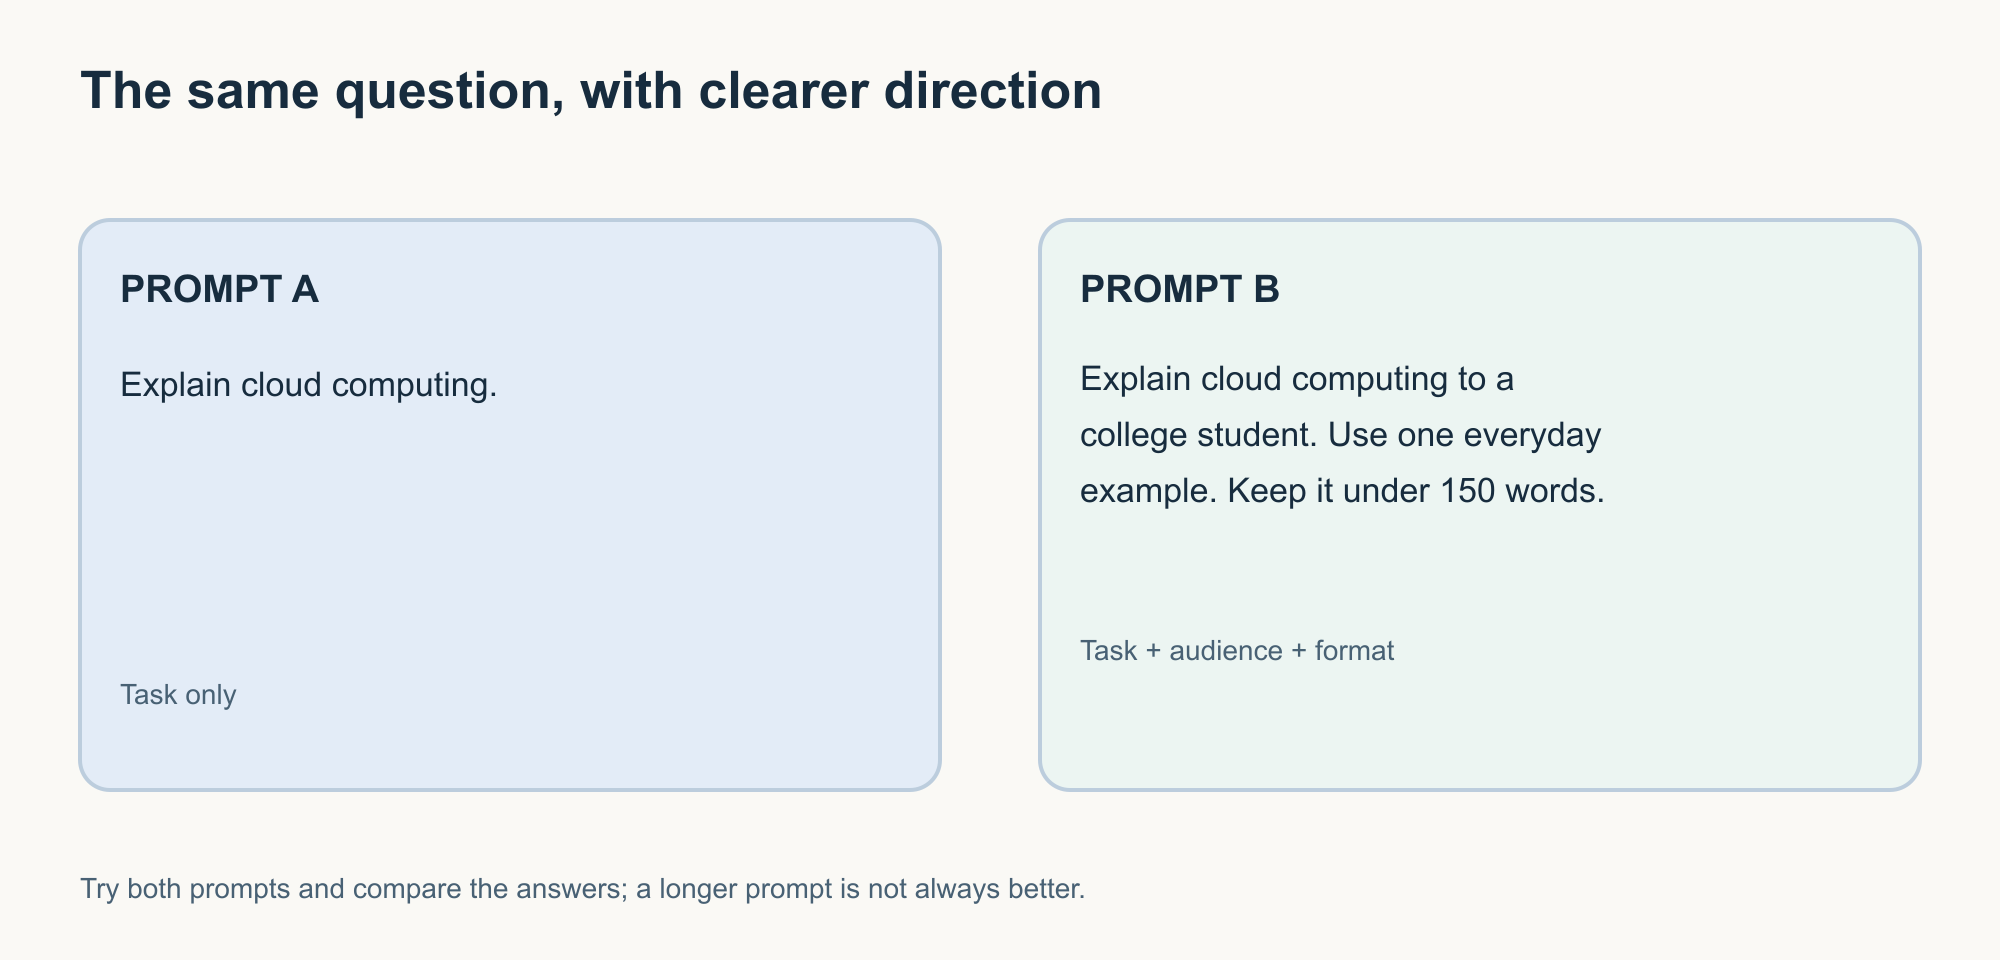
दूसरा प्रॉम्प्ट लंबा होने की वजह से बेहतर नहीं है।
वह इसलिए बेहतर है क्योंकि वह अस्पष्टता कम करता है।
याद रखें
प्रॉम्प्ट = वह जो आप AI को काम करने के लिए देते हैं।
इसमें सिर्फ़ सवाल से ज़्यादा कुछ शामिल हो सकता है।
प्रॉम्प्ट में ये शामिल हो सकते हैं:
- निर्देश;
- उदाहरण;
- पृष्ठभूमि की जानकारी;
- विश्लेषण के लिए टेक्स्ट;
- चाहा गया आउटपुट फ़ॉर्मेट;
- सीमाएं।
ज़्यादातर रोज़मर्रा के कामों के लिए आपको जटिल प्रॉम्प्ट फ़ॉर्मूलों की ज़रूरत नहीं है।
स्पष्ट मक़सद और उपयोगी कॉन्टेक्स्ट ज़्यादा मायने रखते हैं।
ख़ुद आज़माएं
एक AI असिस्टेंट खोलकर पूछें:
मशीन लर्निंग समझाएं।
नतीजा पढ़ें।
फिर यह आज़माएं:
मशीन लर्निंग को ऐसे व्यक्ति को समझाएं जिसने कभी AI के बारे में नहीं पढ़ा। स्पैम ईमेल पहचानने के उदाहरण का इस्तेमाल करें। तकनीकी शब्दजाल से बचें और जवाब को 120 शब्दों से कम रखें।
दोनों जवाबों की तुलना करें।
ख़ुद से पूछें:
- कौन-सा जवाब समझना आसान था?
- क्या बदला?
- आपके निर्देश के किस हिस्से ने यह फ़र्क़ पैदा किया?
“प्रॉम्प्ट इंजीनियरिंग” की परिभाषा रटने से यह ज़्यादा उपयोगी है।
आप असर को सीधे देख रहे हैं।
10. टोकन — जिन्हें लैंग्वेज मॉडल प्रोसेस करता है
लैंग्वेज मॉडल लिखी हुई भाषा को हमेशा एक-एक पूरे शब्द के तौर पर प्रोसेस नहीं करते।
टेक्स्ट को टोकन नाम की छोटी इकाइयों में बदला जाता है।
एक टोकन यह हो सकता है:
- पूरा शब्द;
- शब्द का हिस्सा;
- विराम चिह्न;
- या टेक्स्ट का कोई और टुकड़ा।
टोकनाइज़ेशन ठीक कैसे होगा, यह मॉडल और टोकनाइज़र पर निर्भर करता है।
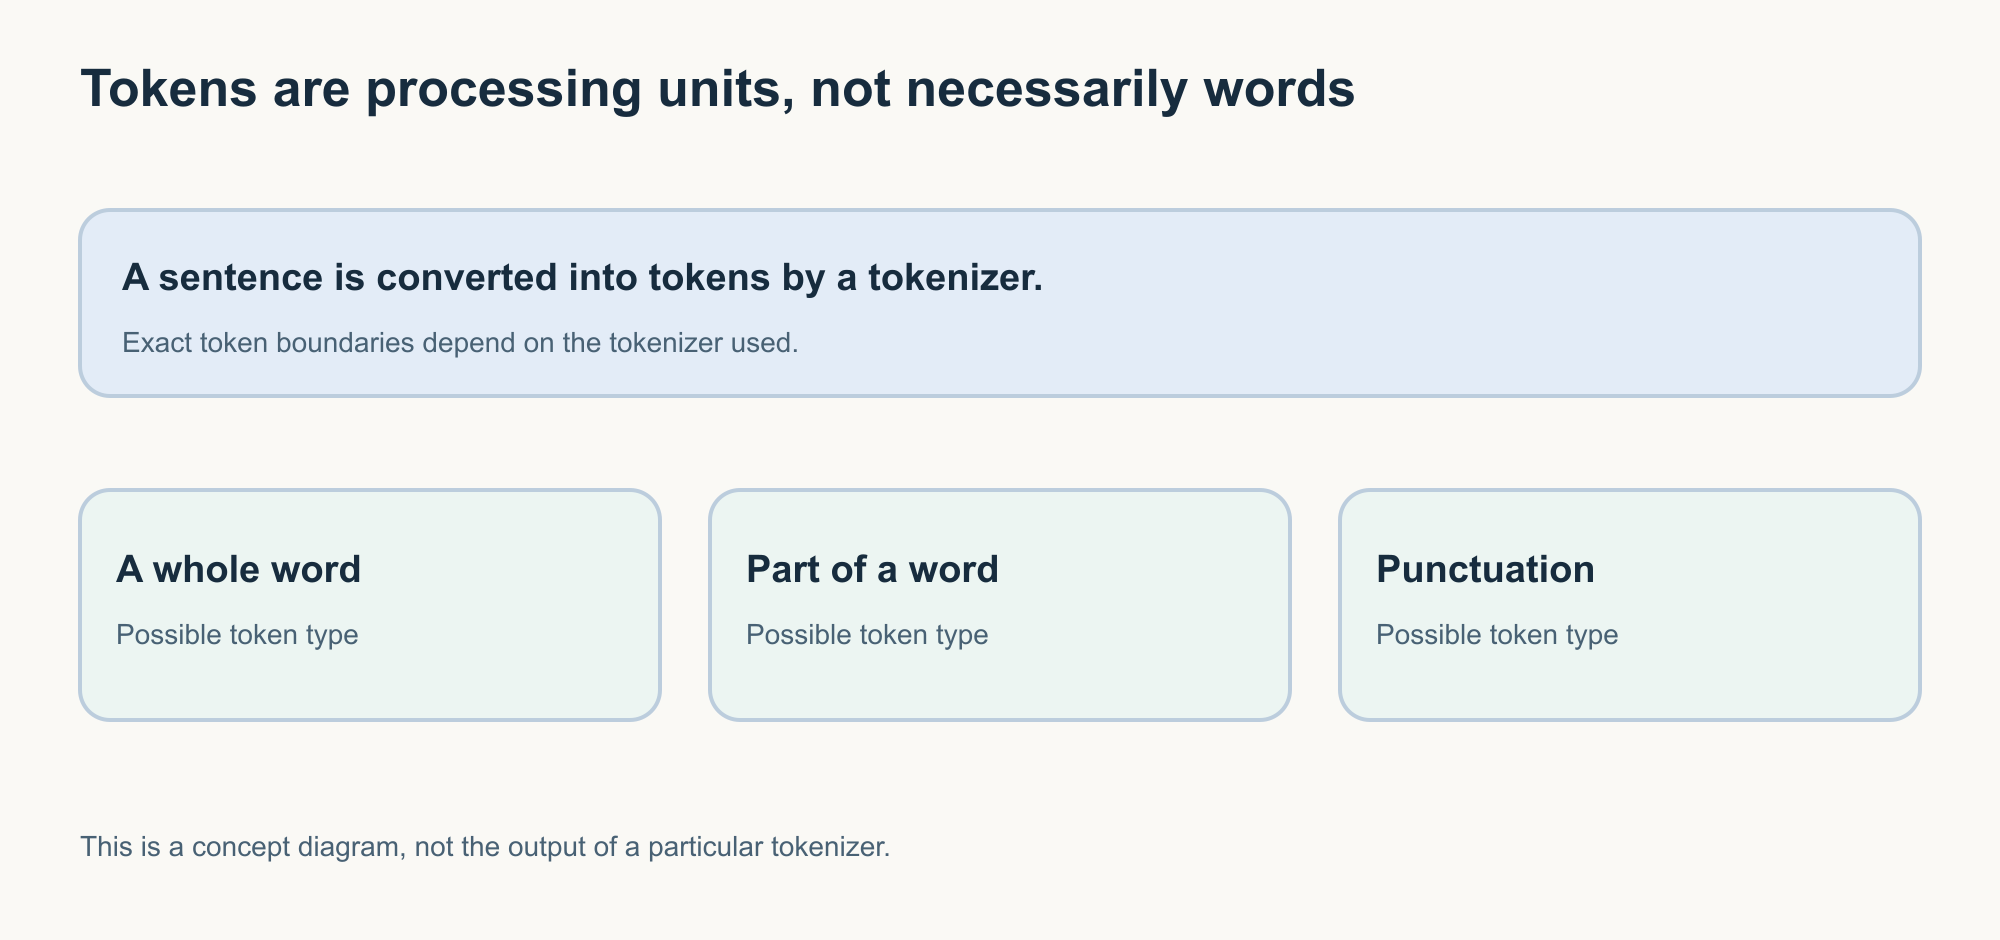
संकल्पनात्मक उदाहरण:
AI लोगों को टेक्नोलॉजी समझने में मदद कर सकता है।
यह डायग्राम जान-बूझकर संकल्पनात्मक है, क्योंकि अलग-अलग टोकनाइज़र एक ही वाक्य को अलग तरह से बांट सकते हैं।
टोकन क्यों मायने रखते हैं
टोकन की गिनती इन चीज़ों को प्रभावित कर सकती है:
- मॉडल कितनी जानकारी प्रोसेस कर सकता है;
- API का इस्तेमाल;
- कुछ सेवाओं में लागत;
- जवाब की सीमाएं;
- कॉन्टेक्स्ट-विंडो का इस्तेमाल।
याद रखें
टोकन = वे जानकारी के टुकड़े जिन्हें लैंग्वेज मॉडल प्रोसेस करता है।
इसे नियम की तरह मत इस्तेमाल करें:
एक टोकन = एक शब्द
यह हमेशा सही नहीं होता।
11. कॉन्टेक्स्ट — मौजूदा काम के लिए उपलब्ध जानकारी
मान लीजिए आप पूछते हैं:
मुख्य जोखिम क्या हैं?
यह जाने बिना कि आप किस बारे में बात कर रहे हैं, इस सवाल का जवाब देना मुश्किल है।
अगर पिछली बातचीत साइबर सुरक्षा के बारे में थी, तो उसका मतलब निवेश या हेल्थकेयर से जुड़ी बातचीत से अलग होगा।
AI सिस्टम को भी सही कॉन्टेक्स्ट चाहिए होता है।
कॉन्टेक्स्ट में ये शामिल हो सकते हैं:
- आपका मौजूदा निर्देश;
- बातचीत के पिछले हिस्से;
- अपलोड किया गया कंटेंट;
- एप्लिकेशन द्वारा दिए गए निर्देश;
- ढूंढी गई जानकारी;
- टूल के नतीजे।
एप्लिकेशन कैसे बनाया गया है, उस पर निर्भर करता है कि इसमें ठीक-ठीक क्या शामिल है।
याद रखें
प्रॉम्प्ट = वह जो आप पूछते या देते हैं।
कॉन्टेक्स्ट = काम के आस-पास उपलब्ध जानकारी।
12. कॉन्टेक्स्ट विंडो — एक बार में कितना ध्यान में रखा जा सकता है
एक मॉडल एक ही बातचीत में हमेशा असीमित जानकारी प्रोसेस नहीं कर सकता।
कॉन्टेक्स्ट विंडो बताती है कि किसी ख़ास प्रोसेसिंग कॉन्टेक्स्ट में मॉडल कितनी टोकनाइज़्ड जानकारी के साथ काम कर सकता है।
इसमें ये शामिल हो सकते हैं:
- निर्देश;
- बातचीत का इतिहास;
- दस्तावेज़;
- ढूंढे गए हिस्से;
- आपका मौजूदा सवाल;
- एप्लिकेशन द्वारा दी गई अन्य जानकारी।
कॉन्टेक्स्ट विंडो उपलब्ध जानकारी को सीमित करती है; अतिरिक्त सामग्री के लिए किसी और तरीक़े की ज़रूरत हो सकती है।
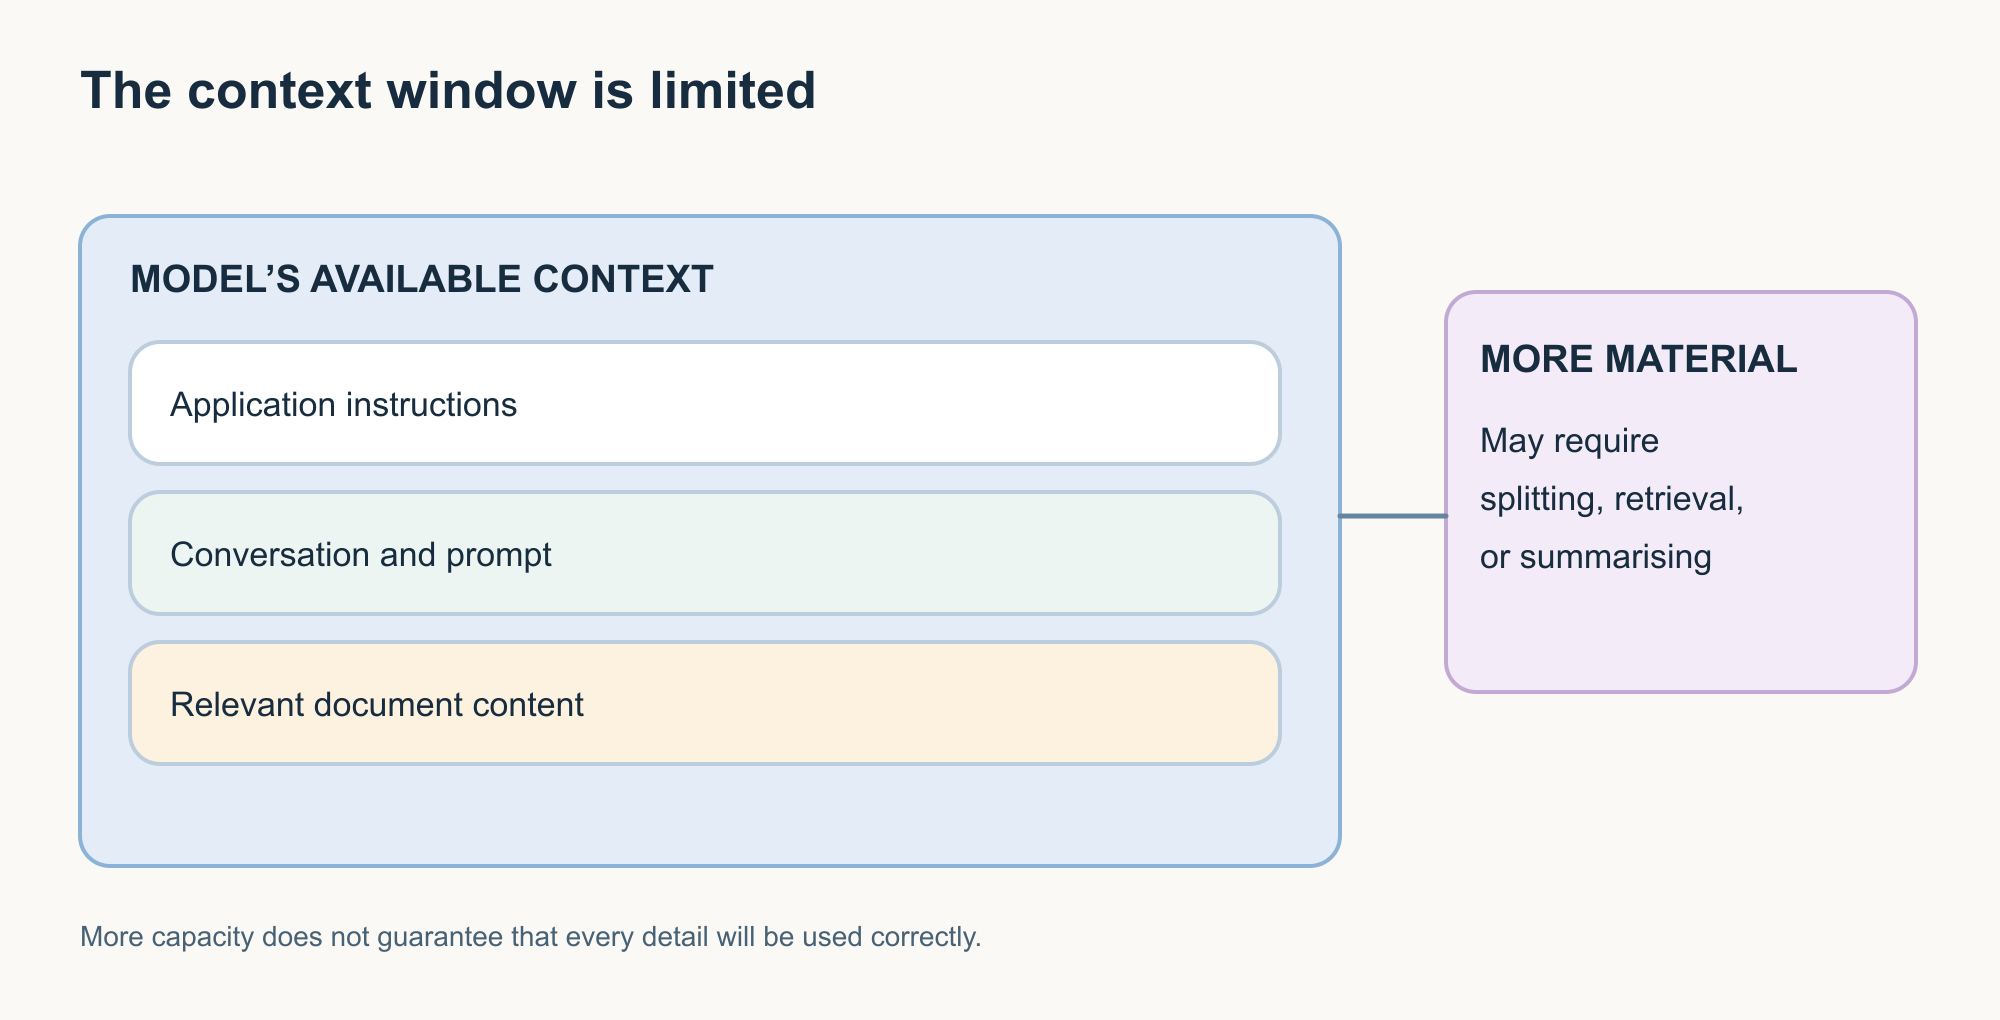
अगर उपलब्ध सामग्री समर्थित कॉन्टेक्स्ट से ज़्यादा हो जाए, तो एप्लिकेशन को यह करना पड़ सकता है:
- पुरानी जानकारी छोड़ना;
- संक्षेप में बताना;
- दस्तावेज़ों को बांटना;
- चुने हुए हिस्से ढूंढना;
- या कोई और तरीक़ा अपनाना।
अलग-अलग एप्लिकेशन इसे अलग तरह से संभालते हैं।
बड़ी कॉन्टेक्स्ट विंडो का मतलब पूरी याददाश्त नहीं है
यह फ़र्क़ मायने रखता है।
भले ही जानकारी तकनीकी रूप से कॉन्टेक्स्ट विंडो में समा जाए, मॉडल हर बारीकी को बराबर अच्छे से इस्तेमाल न करे।
कॉन्टेक्स्ट की क्षमता और भरोसेमंद समझ एक जैसी नहीं हैं।
याद रखें
कॉन्टेक्स्ट विंडो = उस बातचीत के लिए मॉडल के पास उपलब्ध काम की जगह।
यह स्थायी याददाश्त जैसी नहीं है।
शब्दों को साथ रखकर देखें
हमने कई शब्द देखे हैं।
अकेले-अकेले वे उपयोगी हैं।
साथ में वे कहीं ज़्यादा मायने रखते हैं।
मान लीजिए आप एक AI असिस्टेंट से पूछते हैं:
स्पैम-ईमेल के उदाहरण का इस्तेमाल करके मशीन लर्निंग को एक शुरुआती व्यक्ति को समझाएं।
क्या हो रहा है?
एक सवाल एप्लिकेशन, प्रॉम्प्ट, कॉन्टेक्स्ट, ट्रेन्ड मॉडल और इन्फरेंस को आपस में जोड़ता है।
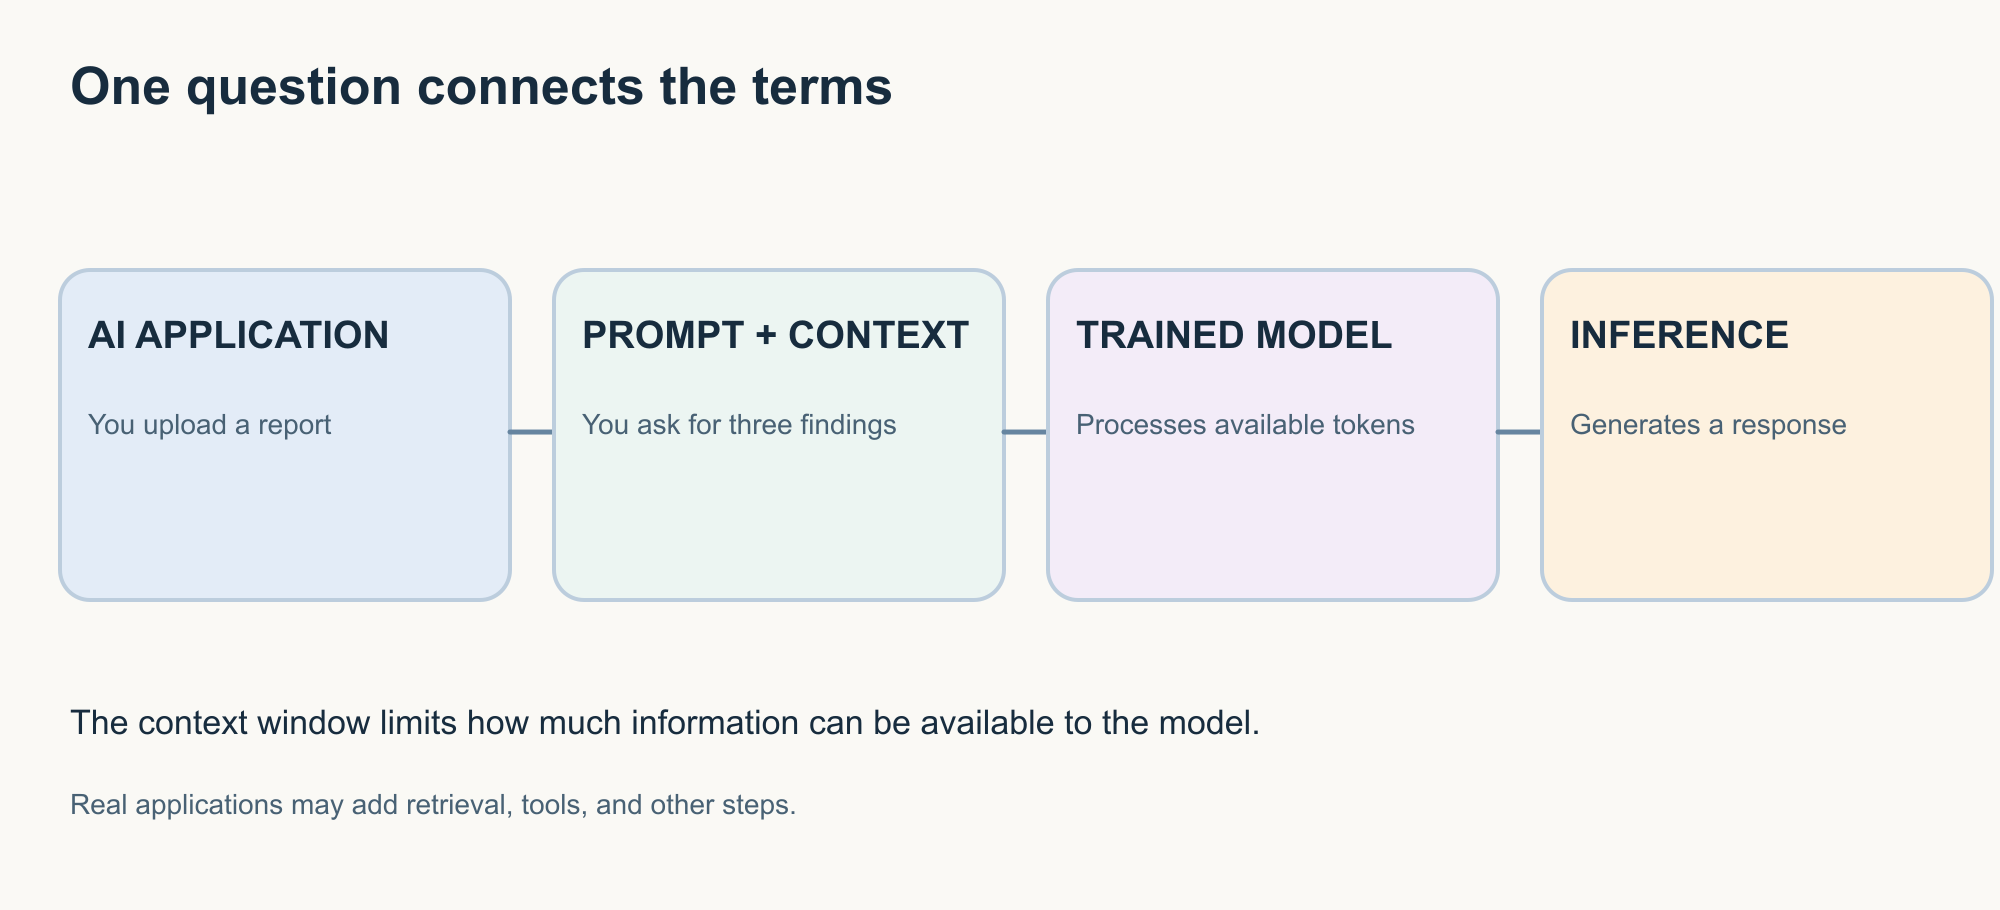
AI — व्यापक क्षेत्र।
मशीन लर्निंग — AI सिस्टम बनाने का एक तरीक़ा।
मॉडल — सीखा हुआ काम करने वाला ट्रेन्ड सिस्टम।
LLM — अगर काम लैंग्वेज मॉडल से जुड़ा है, तो यह वह मॉडल है जो आपके टेक्स्ट पर काम करता है।
प्रॉम्प्ट — आपका निर्देश।
टोकन — मॉडल द्वारा प्रोसेस किए गए टेक्स्ट के टुकड़े।
कॉन्टेक्स्ट विंडो — उपलब्ध काम की जानकारी।
इन्फरेंस — ट्रेन्ड मॉडल इनपुट को प्रोसेस करके आउटपुट बनाता है।
इससे एक सामान्य AI बातचीत की बुनियादी तस्वीर मिलती है।
यह सरल किया गया रूप है।
असली AI एप्लिकेशन में ये भी शामिल हो सकते हैं:
- सिस्टम निर्देश;
- सुरक्षा नियंत्रण;
- खोज;
- मेमोरी;
- दस्तावेज़ ढूंढना;
- बाहरी टूल;
- अन्य मॉडल।
वे अतिरिक्त हिस्से आर्टिकल 2 में ज़रूरी हो जाएंगे।
एक छोटी शब्दावली जांच
बिना पीछे देखे इनके जवाब देने की कोशिश करें।
सवाल 1
सबसे व्यापक शब्द कौन-सा है?
AI, मशीन लर्निंग, या LLM?
जवाब: AI।
सवाल 2
ट्रेनिंग और इन्फरेंस में क्या फ़र्क़ है?
ट्रेनिंग: मॉडल सीखता है या समायोजित होता है।
इन्फरेंस: ट्रेन्ड मॉडल का इस्तेमाल नए इनपुट को प्रोसेस करने के लिए किया जाता है।
सवाल 3
क्या चैटबॉट और LLM एक ही चीज़ हैं?
नहीं।
LLM एक मॉडल है। चैटबॉट एक एप्लिकेशन है, जो LLM के साथ-साथ दूसरे हिस्सों का भी इस्तेमाल कर सकता है।
सवाल 4
क्या एक टोकन हमेशा एक शब्द के बराबर होता है?
नहीं।
टोकनाइज़र के आधार पर एक टोकन एक शब्द, शब्द का हिस्सा, विराम चिह्न, या टेक्स्ट की कोई और इकाई हो सकता है।
सवाल 5
कॉन्टेक्स्ट विंडो क्या है?
किसी प्रोसेसिंग कॉन्टेक्स्ट में मॉडल के पास उपलब्ध हो सकने वाली टोकनाइज़्ड जानकारी की मात्रा।
भाषा याद रखने का एक आसान तरीक़ा
आपको हर परिभाषा अलग से रटने की ज़रूरत नहीं है।
शब्दों को इस आधार पर समूहों में बांटें कि वे किस सवाल का जवाब देते हैं।
| सवाल | शब्द |
|---|---|
| यह किस तरह की टेक्नोलॉजी है? | AI, मशीन लर्निंग, प्रेडिक्टिव AI, जेनरेटिव AI, LLM |
| काम कौन करता है? | मॉडल |
| उसने कैसे सीखा? | ट्रेनिंग, फाइन-ट्यूनिंग |
| जब मैं उसे इस्तेमाल करता हूं तो क्या होता है? | इन्फरेंस |
| मैं उसे क्या देता हूं? | प्रॉम्प्ट, कॉन्टेक्स्ट |
| वह क्या प्रोसेस करता है? | टोकन |
| वह एक बार में कितना संभाल सकता है? | कॉन्टेक्स्ट विंडो |
जब भी आपको कोई नया AI शब्द मिले, पहले यह पूछें:
यह शब्द किस सवाल का जवाब देने की कोशिश कर रहा है?
यह डिक्शनरी की परिभाषा रटने से अक्सर आसान होता है।
जो हमने अभी तक नहीं देखा
ऊपर दी गई भाषा जानने से आपको एक आधार मिल जाता है।
लेकिन यह अभी तक यह नहीं बताती कि किसी आधुनिक AI एप्लिकेशन के अंदर क्या-क्या होता है।
जैसे:
जवाब कहां से आता है?
क्या AI मौजूदा जानकारी के लिए खोज कर सकता है?
जब आप कोई दस्तावेज़ अपलोड करते हैं तो क्या होता है?
ग्राउंडिंग क्या है?
RAG क्या है?
यह मॉडल ट्रेनिंग से कैसे अलग है?
AI की मेमोरी का असल मतलब क्या है?
जब AI टूल इस्तेमाल कर सकता है तो क्या बदलता है?
असिस्टेंट कब AI एजेंट बन जाता है?
ये सवाल इस सीरीज़ के अगले भाग के हैं।
सबसे ज़्यादा क्या मायने रखता है
AI की शब्दावली सीखने का मक़सद तकनीकी दिखना नहीं है।
इसका मक़सद टेक्नोलॉजी के बारे में सोचना आसान बनाना है।
AI एप्लिकेशन और मॉडल के फ़र्क़ को समझने के बाद, आप किसी प्रोडक्ट के बारे में बेहतर सवाल पूछ सकते हैं।
ट्रेनिंग और इन्फरेंस को समझने के बाद, आप यह मानने की संभावना कम रखते हैं कि हर बातचीत मॉडल को फिर से ट्रेन कर देती है।
प्रॉम्प्ट और कॉन्टेक्स्ट को समझने के बाद, आप AI को ज़्यादा स्पष्ट जानकारी दे सकते हैं।
टोकन और कॉन्टेक्स्ट विंडो को समझने के बाद, लैंग्वेज मॉडल की कुछ सीमाओं को पहचानना आसान हो जाता है।
आपको हर परिभाषा तुरंत याद रखने की ज़रूरत नहीं है।
शब्दों का इस्तेमाल करें।
उन्हें किसी ऐसी चीज़ से जोड़ें जो आप पहले से करते हैं।
जब दोबारा उनसे सामना हो, तो वापस उनकी ओर लौटें।
शब्दावली इसी तरह समझ में बदलती है।
AI Fluency सीरीज़
भाग 1 — भाषा सीखें AI की भाषा: वे ज़रूरी शब्द जो हर किसी को समझने चाहिए
आप यहाँ हैं।
भाग 2 — अनुभव को समझें AI आपके सवालों का जवाब कैसे देता है: अनुभव के पीछे के शब्दों को समझना
भाग 2 मॉडल से आगे बढ़कर ग्राउंडिंग, रिट्रीवल, RAG, हैल्यूसिनेशन, मेमोरी, मल्टीमोडल AI, टूल और एजेंट को देखता है।
भाग 3 — विवेक विकसित करें AI दावों को समझना: बेहतर निर्णय लेने में मदद करने वाले शब्द
भाग 3 सटीकता, भरोसेमंदी, मूल्यांकन, बेंचमार्क, पूर्वाग्रह, गार्डरेल, प्राइवेसी, इंसानी निगरानी, रीज़निंग के दावों, और स्वायत्तता को देखेगा।
संदर्भ और आगे पढ़ने के लिए
जो पाठक और गहराई से जानना चाहते हैं, वे शुरुआती बिंदु के तौर पर इन स्रोतों का इस्तेमाल कर सकते हैं:
- Google for Developers — Machine Learning Glossary
मॉडल, ट्रेनिंग, इन्फरेंस, टोकन और लार्ज लैंग्वेज मॉडल सहित मशीन लर्निंग की शब्दावली को कवर करता है। - Google for Developers — Generative AI Glossary
जेनरेटिव AI और लैंग्वेज-मॉडल सिस्टम से जुड़ी शब्दावली देता है। - NIST AI Resource Center — Glossary
AI सिस्टम, भरोसेमंद AI, जोखिम और मूल्यांकन से जुड़ी परिभाषाएं और मार्गदर्शन देता है। - IBM — What is Machine Learning?
मशीन लर्निंग और आर्टिफिशियल इंटेलिजेंस से उसके रिश्ते का एक व्यावहारिक परिचय। - IBM — Generative AI vs. predictive AI: What’s the difference?
नतीजों का अनुमान लगाने वाले सिस्टम और नया कंटेंट बनाने वाले सिस्टम के फ़र्क़ को समझने के लिए उपयोगी।
टेक्नोलॉजी और शब्दावली लगातार बदलती रहती हैं। आप जिस सिस्टम का इस्तेमाल कर रहे हैं, उसके प्रोडक्ट से जुड़े व्यवहार की जांच हमेशा उसके दस्तावेज़ों से करनी चाहिए।