

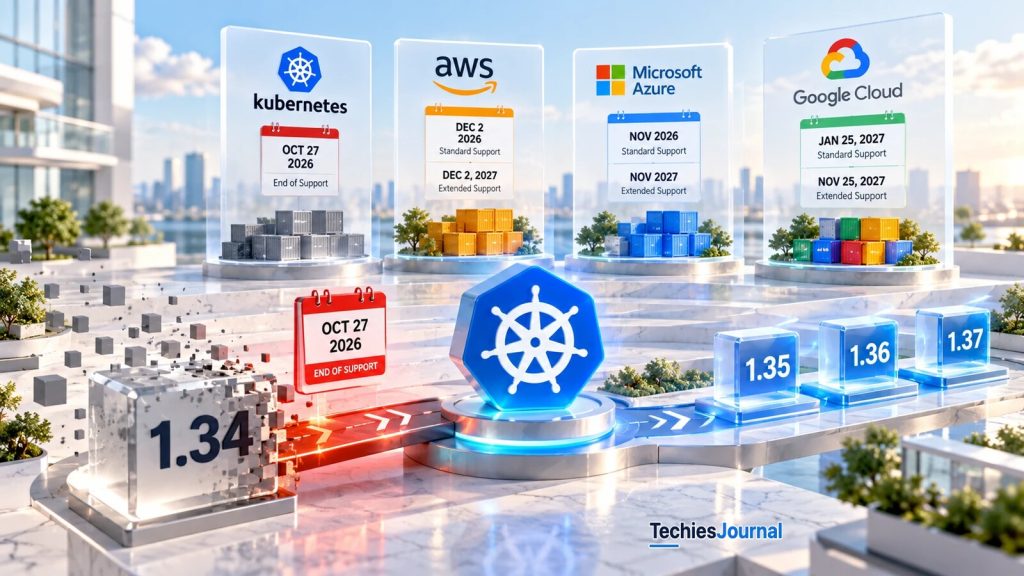
Illustration conceptuelle des calendriers de support que compare l’article. L’image désigne la date plus tardive d’Azure sous le nom « Extended Support », alors que le tableau de l’article parle de LTS.
Kubernetes 1.34 atteint la fin de son cycle de support en amont (upstream) le 27 octobre 2026. Après cette date, le projet Kubernetes ne fournira plus de manière régulière de mises à jour de sécurité ni de corrections de bogues pour la branche de version 1.34.
Pour les organisations qui exploitent leurs propres plans de contrôle Kubernetes, cette échéance compte directement. Un cluster en 1.34 peut continuer à servir ses charges de travail, mais les problèmes découverts à l’avenir risquent de ne plus recevoir de correctifs en amont pour cette version.
La situation est différente pour les équipes qui utilisent un service Kubernetes managé.
Amazon EKS, Azure Kubernetes Service (AKS) et Google Kubernetes Engine (GKE) suivent leurs propres calendriers de versions et proposent, dans certains cas, des options de support étendu. Un cluster Kubernetes 1.34 chez un fournisseur peut donc rester pris en charge plus longtemps que la même version mineure chez un autre.
La question opérationnelle immédiate n’est pas simplement de savoir si un cluster tourne en 1.34. Elle est de savoir qui maintient cette distribution, quelle période de support s’applique et si le cluster peut mener à bien une mise à niveau prise en charge sans perturber ses charges de travail.
Une version de Kubernetes, quatre calendriers de support
Le projet Kubernetes maintient actuellement les trois branches mineures les plus récentes : 1.35, 1.36 et 1.37. La version 1.34 est entrée en mode maintenance le 27 août 2026, et son dernier correctif répertorié au moment de cette vérification est la 1.34.12.
Les fournisseurs de services managés prolongent ou gèrent autrement le support au moyen de leurs propres versions testées, de leurs politiques de maintenance et de leurs dispositifs de cycle de vie.
| Plateforme | Échéance de support de Kubernetes 1.34 | Ce que cela signifie |
|---|---|---|
| En amont / autogéré | 27 octobre 2026 | Fin des versions correctives en amont (depuis le 27 août, seuls les correctifs de sécurité critiques sont acceptés) |
| Amazon EKS | Standard : 2 décembre 2026. Étendu : 2 décembre 2027 | Le support étendu est activé par défaut (politique de mise à niveau EXTENDED), moyennant un coût supplémentaire par heure de cluster. À la fin du support étendu, le cluster est mis à niveau automatiquement |
| Azure AKS | Fin de vie standard : novembre 2026. LTS : novembre 2027 | Le cycle de vie prolongé dépend de l’inscription et de l’éligibilité. Les mois publiés ne sont pas des dates exactes |
| Google GKE | Standard : 25 janvier 2027. Étendu : 25 novembre 2027 | Le support étendu ne s’applique qu’aux clusters inscrits dans le canal de publication Extended |
Sources : calendrier des versions de Kubernetes, cycle de vie d’Amazon EKS, versions prises en charge par AKS et calendrier des versions de GKE. Les dates sont à jour au 26 octobre 2026, et les calendriers des fournisseurs peuvent changer.
Ces différences ont une réelle importance opérationnelle.
Une équipe EKS dont un cluster approche de l’échéance du support standard de décembre peut avoir le temps de planifier une mise à niveau maîtrisée, même si les frais de support étendu et les mises à niveau finalement imposées par le fournisseur pèsent sur cette décision.
Pour AKS, la situation exacte d’un cluster en matière de support dépend de son inscription au cycle de vie et de sa version prise en charge. Le support à long terme n’est jamais activé automatiquement. Un cluster doit y être explicitement inscrit.
Le canal Extended de GKE maintient une version mineure prise en charge jusqu’à la fin de son support étendu, tandis que les clusters des autres canaux de publication (Rapid, Regular et Stable) suivent le calendrier du support standard et des mises à niveau automatiques.
Un cluster autogéré ne bénéficie d’aucun de ces dispositifs du seul fait que ses composants en amont restent opérationnels. Un support continu nécessiterait un éditeur de distribution adapté, un prestataire de support ou une stratégie de correctifs maintenue en interne.
Ce que les équipes plateforme doivent vérifier en premier
Avant de modifier un cluster, établissez la version réelle de son plan de contrôle et les versions qui tournent sur ses nœuds.
Pour un cluster accessible avec kubectl, deux commandes sont utiles :
kubectl version
kubectl get nodes -o wide
La première indique les informations de version du client et du serveur. La seconde affiche le détail des nœuds, y compris les versions de kubelet.
Ces commandes fournissent un point de départ, mais elles n’indiquent pas à l’exploitant si la politique de support du service managé couvre cette version.
Pour EKS, AKS ou GKE, vérifiez la version de Kubernetes configurée pour le cluster, son canal de publication ou sa politique de support dans l’interface de gestion ou la CLI du fournisseur. Incluez dans l’inventaire les pools de nœuds et les composants gérés séparément.
Le plan de contrôle et les nœuds ne passent pas forcément à une nouvelle version mineure en même temps.
Un fournisseur de service managé peut mettre à niveau le plan de contrôle automatiquement tout en exigeant une action distincte pour certains groupes de nœuds. Avec un cluster autogéré, ce sont en général les exploitants qui doivent coordonner les deux parties du processus.
Un inventaire doit donc recenser la distribution Kubernetes, la version du plan de contrôle, les versions des nœuds et des pools de nœuds, l’échéance de support, la politique de mise à niveau et toute restriction de maintenance documentée.
Ces informations déterminent si l’étape suivante est une mise à niveau urgente d’une version non prise en charge, un changement de maintenance planifié ou la vérification qu’un dispositif de support étendu est déjà actif.
Planifier la mise à niveau en fonction de la compatibilité, pas seulement de la date
Pour les clusters Kubernetes autogérés qui utilisent kubeadm, passer de la 1.34 à la 1.35 est l’étape de version mineure suivante prise en charge. Sauter directement de la 1.34 à la 1.36 ou à la 1.37 n’est pas pris en charge par le processus de mise à niveau de kubeadm.
Les services managés peuvent automatiser une partie de la mise à niveau, mais leurs chemins de mise à niveau pris en charge et leurs prérequis doivent être respectés à part.
Kubernetes maintient aussi une politique de décalage de versions (version skew policy) qui encadre les versions des composants du plan de contrôle, des kubelets et des autres services du cluster.
Un kubelet ne doit pas être plus récent que le serveur d’API avec lequel il communique. Selon la politique actuelle, il peut généralement avoir jusqu’à trois versions mineures de retard, sous réserve de restrictions supplémentaires dans les clusters où coexistent plusieurs versions du serveur d’API.
Cela permet d’échelonner les mises à niveau du plan de contrôle et des nœuds, mais cela ne signifie pas que toutes les combinaisons de versions sont prises en charge.
Le projet Kubernetes recommande de passer d’abord au dernier correctif de la version mineure actuelle, puis de viser le dernier correctif disponible de la version mineure suivante.
Avant de mettre à niveau des clusters de production, les vérifications de compatibilité les plus lourdes de conséquences portent sur les composants qui interagissent étroitement avec l’API Kubernetes.
Les webhooks d’admission peuvent dépendre de versions d’API ou de champs qui changent d’une version à l’autre. Les composants réseau et de stockage doivent prendre en charge la version cible. Les opérateurs, les définitions de ressources personnalisées et les modules complémentaires du cluster peuvent eux aussi nécessiter une mise à niveau.
Les charges de travail demandent elles aussi de l’attention. Les PodDisruptionBudgets, la disponibilité des réplicas, les contraintes d’ordonnancement et le comportement du stockage déterminent si les nœuds peuvent être drainés sans interruption inacceptable.
Une mise à niveau de version mineure qui réussit au niveau du serveur d’API n’est pas forcément une mise à niveau réussie pour les applications si des charges de travail essentielles ne parviennent pas à être replanifiées ou si un module complémentaire incompatible cesse de fonctionner.
Une vérification pratique de l’état de préparation à la mise à niveau
Pour les équipes encore en 1.34, l’évaluation suivante constitue un point de départ raisonnable.
- Support : confirmer l’échéance de support réelle de la distribution et vérifier si le support étendu est activé, disponible ou soumis à des frais supplémentaires.
- Compatibilité : examiner, au regard de la version cible, l’usage d’API obsolètes, les webhooks d’admission, les CRD, les contrôleurs, les pilotes CNI et CSI et les modules complémentaires indispensables au cluster.
- Disponibilité : vérifier les réplicas des charges de travail, les PodDisruptionBudgets, la capacité des nœuds, le comportement lors du drainage et les fenêtres de maintenance.
- Reprise : confirmer les procédures de sauvegarde et de restauration concernées, y compris la reprise d’etcd pour les plans de contrôle autogérés, et comprendre les limites qu’impose le fournisseur à un retour à une version antérieure ou à un retour arrière.
- Validation : tester la mise à niveau sur un cluster ou un pool de nœuds hors production représentatif, puis surveiller pendant le déploiement en production la santé des charges de travail, le réseau, le stockage et les taux d’erreur des applications.
Ces vérifications doivent être proportionnées à l’environnement. Un petit cluster de développement et une plateforme de production multirégion n’ont pas besoin de procédures de changement identiques, mais tous deux ont besoin d’un chemin de mise à niveau connu.
Les équipes doivent aussi éviter de supposer que le support étendu revient à repousser toute obligation de mise à niveau. Il offre un délai supplémentaire aux conditions énoncées par le fournisseur, pas une maintenance permanente d’une version donnée de Kubernetes.
Qu’est-ce qui change après le 27 octobre ?
Pour les environnements Kubernetes 1.34 autogérés qui s’appuient sur la maintenance en amont, le 27 octobre marque la fin des correctifs réguliers pour cette branche. Les organisations qui y restent doivent accepter le risque de maintenance qui en découle ou le gérer par leurs propres moyens.
Pour EKS, AKS et GKE, cette échéance rappelle qu’il faut vérifier le cycle de vie propre à chaque fournisseur ; elle ne signifie pas que tous les clusters 1.34 managés cessent d’être pris en charge du jour au lendemain.
La bonne décision dépend du modèle d’exploitation. Une organisation disposant d’un chemin de mise à niveau testé peut raisonnablement passer dès maintenant à une version mineure prise en charge. Une autre peut recourir à une prolongation officiellement prise en charge pour terminer le travail de compatibilité et planifier un changement moins risqué.
Ce qu’il faut éviter, c’est de laisser un cluster sur une version vieillissante parce que les charges de travail semblent saines et que personne n’a confirmé qui est responsable de sa maintenance.
Le cycle de vie en amont de Kubernetes 1.34 prend fin le 27 octobre 2026. La responsabilité opérationnelle consiste à établir l’échéance qui s’applique réellement à chaque cluster et à mener à bien une mise à niveau prise en charge et testée avant que cette couverture n’expire.
Pour aller plus loin
- Kubernetes: Version 1.34 Release Schedule. Cycle de vie officiel de la version, date d’entrée en mode maintenance et échéance de fin de vie en amont.
- Kubernetes: Version Skew Policy. Relations de versions prises en charge entre serveurs d’API, kubelets, contrôleurs et autres composants du cluster.
- Kubernetes: Upgrading kubeadm Clusters. Processus officiel de mise à niveau des clusters autogérés et exigences d’enchaînement des versions mineures.
- Amazon EKS: Kubernetes Version Lifecycle. Dates du support standard et du support étendu d’EKS, politiques de version et considérations de facturation associées.
- Microsoft Learn: Supported Kubernetes Versions in AKS. Cycle de vie standard d’AKS, support à long terme et calendriers des mises à niveau déclenchées par la plateforme.
- Google Cloud: GKE Release Schedule. Dates du support standard et du support étendu de GKE, disponibilité selon les canaux de publication et planification des mises à niveau.
À lire aussi sur ce site
- Ingress-NGINX est retiré : ce que les équipes Kubernetes doivent faire ensuite (en anglais), sur un autre composant Kubernetes qui ne reçoit plus de correctifs de sécurité et sur la manière de planifier la migration.
- Kubernetes 1.37 : trois changements que les équipes plateforme doivent comprendre avant de mettre à niveau (en anglais), sur la version mineure la plus récente que cet article cite parmi les branches prises en charge.
Recherches vérifiées le 26 octobre 2026. Les dates de support évoluent dans le temps et doivent être revérifiées dans la documentation des fournisseurs avant toute publication ou modification opérationnelle. Cet article traite du cycle de vie et de la planification des mises à niveau. Il ne remplace pas les instructions de mise à niveau propres à chaque plateforme.