

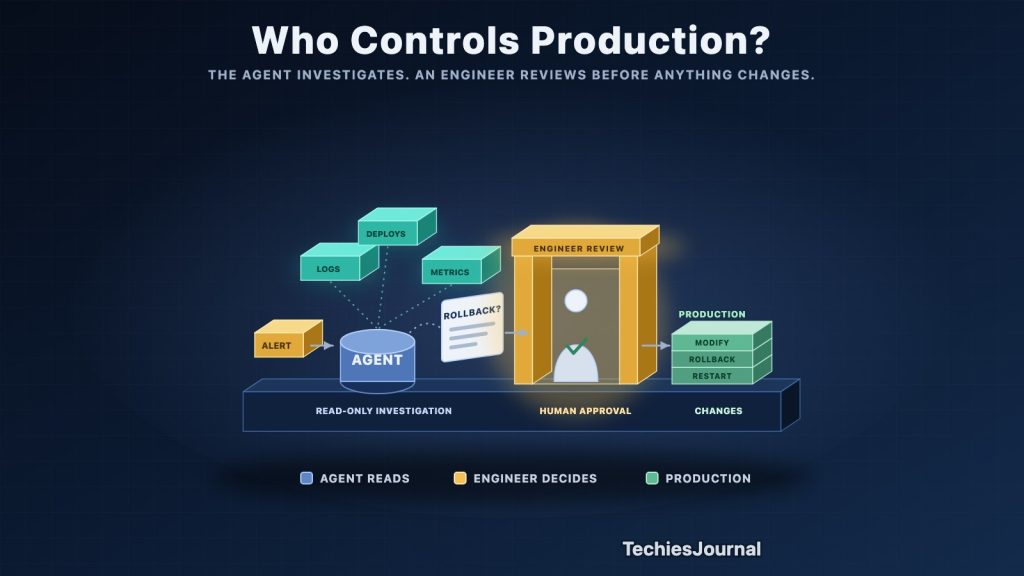
AI एजेंट प्रोडक्शन इंसीडेंट की जाँच कर सकते हैं और समाधान सुझा सकते हैं। जैसे-जैसे उन्हें ऑपरेशनल सिस्टम तक पहुँच मिल रही है, इंजीनियरों को समझना होगा कि एजेंट क्या execute कर सकते हैं और उन कार्रवाइयों पर नियंत्रण कैसे रखा जाता है।
एक प्रोडक्शन डिप्लॉयमेंट के कुछ ही देर बाद एक एप्लिकेशन HTTP 500 एरर देने लगता है। ऑन-कॉल इंजीनियर को अलर्ट मिलता है, लेकिन एक AI incident-response एजेंट पहले ही जाँच शुरू कर चुका है।
वह एप्लिकेशन लॉग, हाल के डिप्लॉयमेंट और मॉनिटरिंग डेटा देखता है। एजेंट ताज़ा रिलीज़ को संभावित कारण के रूप में पहचानता है और उसे rollback (पिछले संस्करण पर लौटाने) की सलाह देता है।
समय का मेल इस सुझाव को विश्वसनीय बनाता है। फिर भी, लॉग में डेटाबेस कनेक्शन की विफलताएँ भी दिखती हैं। इंजीनियर को rollback करने से पहले यह तय करना होगा कि इन विफलताओं का कारण डिप्लॉयमेंट था या नहीं।
यह एक काल्पनिक परिदृश्य (fictional scenario) है, जो ऐसे फ़ैसले को दिखाता है जो तब और अहम हो जाता है जब AI एजेंट तकनीकी सवालों के जवाब देने से आगे बढ़कर प्रोडक्शन सिस्टम के साथ सीधे काम करने लगते हैं।
AI एजेंट अब इंसीडेंट मैनेजमेंट का हिस्सा हैं
Microsoft का Azure SRE Agent, जो मार्च 2026 से generally available है, इंसीडेंट की जाँच कर सकता है, ऑपरेशनल जानकारी देख सकता है और अनुमत remediation कार्रवाइयों की सलाह दे सकता है या उन्हें execute कर सकता है। Google का Gemini Cloud Assist भी AI-सहायता से इंफ्रास्ट्रक्चर की जाँच में मदद करता है, हालाँकि उसकी जाँच क्षमता अभी Preview में है और उस तक पहुँच सीमित है।
ये टूल अलग-अलग स्रोतों से जानकारी जुटाने की मैनुअल मेहनत घटा सकते हैं। कई डैशबोर्ड खोलने और डिप्लॉयमेंट हिस्ट्री खँगालने के बजाय, इंजीनियरों को शुरुआती जाँच मिल सकती है, जिसमें प्रासंगिक लॉग, बदलाव और संभावित स्पष्टीकरण होते हैं।
इनकी उपयोगिता कुछ हद तक उपलब्ध जानकारी की गुणवत्ता पर निर्भर करती है। जिस एप्लिकेशन में ट्रेस अधूरे हों, लॉगिंग असंगत हो या डिप्लॉयमेंट रिकॉर्ड गायब हों, उसकी जाँच करने वाले एजेंट को वही कठिनाइयाँ आती हैं जो ऐसे सिस्टम पर काम करने वाले इंजीनियर को आती हैं।
किसी विफलता से जुड़ी घटना की पहचान करने और उसका कारण स्थापित करने में भी फ़र्क़ है। आउटेज से ठीक पहले हुआ डिप्लॉयमेंट जाँच के लायक है, लेकिन सिर्फ़ उसका समय rollback को उचित नहीं ठहराता।
जब एजेंट मरम्मत की कोशिश करता है, तब क्या होता है?
सितंबर 2026 में प्रकाशित शोध स्वायत्त (autonomous) इंसीडेंट रिस्पॉन्स की कठिनाइयों की कुछ झलक देता है।
Incident-Arena बेंचमार्क ने डिप्लॉय किए गए एप्लिकेशन से जुड़े 20 fault-injected इंसीडेंट पर AI एजेंटों को परखा। परखे गए frontier मॉडल उसके मूल्यांकन में 64.3% से कम स्कोर कर सके, और विफलताओं में अधूरी मरम्मत और असुरक्षित regression शामिल थे।
एक अन्य बेंचमार्क, SRE-Marathon, ने लगातार चलते Kubernetes वातावरण में एक-दूसरे पर चढ़ी विफलताओं पर काम करने वाले एजेंटों को परखा। शोध में पाया गया कि वातावरण के बदलते रहने के दौरान समस्याओं की पहचान करना अक्सर मरम्मत पूरी करने से आसान था।
दोनों अध्ययन preprint हैं, और कोई भी व्यावसायिक incident-response उत्पादों के प्रदर्शन को स्थापित नहीं करता। उनके नतीजे इस्तेमाल किए गए वातावरण, कार्यों और मूल्यांकन के तरीक़ों पर निर्भर करते हैं।
फिर भी वे rollback वाले परिदृश्य से प्रासंगिक हैं।
मान लीजिए डिप्लॉयमेंट में एक डेटाबेस माइग्रेशन शामिल था जिसने वह संरचना बदल दी जिसकी एप्लिकेशन अपेक्षा करता है। तब अकेले एप्लिकेशन को rollback करने से अतिरिक्त संगतता (compatibility) समस्याएँ पैदा हो सकती हैं।
इंसीडेंट की जाँच करने वाले इंजीनियर को प्रस्तावित कार्रवाई को मंज़ूर करने से पहले इस निर्भरता को समझना होगा। वही मरम्मत करने की कोशिश करने वाले AI एजेंट को प्रासंगिक जानकारी तक पहुँच और नतीजों का हिसाब लगाने का भरोसेमंद तरीक़ा चाहिए।
प्रोडक्शन तक पहुँच ज़िम्मेदारी बदल देती है
जो एजेंट लॉग पढ़ता है, उसकी ऑपरेशनल भूमिका उस एजेंट से अलग है जो सर्विस रीस्टार्ट कर सकता है, डिप्लॉयमेंट rollback कर सकता है या इंफ्रास्ट्रक्चर में बदलाव कर सकता है।
Azure SRE Agent कॉन्फ़िगर किए जा सकने वाले execution मोड सपोर्ट करता है, जिनमें कुछ Azure इंफ्रास्ट्रक्चर ऑपरेशनों के लिए review नियंत्रण शामिल हैं। हालाँकि, उसका डॉक्यूमेंटेशन इन ऑपरेशनों को अन्य जुड़े हुए टूल से उपलब्ध कार्रवाइयों से अलग बताता है।
एजेंट-आधारित ऑटोमेशन का मूल्यांकन कर रही टीमों के लिए यह एक अहम बारीकी है।
यह मान नहीं लेना चाहिए कि review सेटिंग हर integration को कवर करती है। असल अनुमतियाँ इस पर निर्भर करती हैं कि एजेंट से कौन-से टूल जुड़े हैं और उनकी एक्सेस पॉलिसी कैसे कॉन्फ़िगर की गई है।
उदाहरण के लिए, किसी एजेंट के पास मॉनिटरिंग डेटा की सिर्फ़ पढ़ने वाली (read-only) पहुँच हो सकती है, लेकिन साथ ही उसके पास ऐसे डिप्लॉयमेंट सिस्टम के क्रेडेंशियल भी हो सकते हैं जो प्रोडक्शन में बदलाव कर सकता है।
मंज़ूरी ज़रूरी होने पर भी, इंजीनियर को प्रस्तावित कार्रवाई समझने के लिए पर्याप्त जानकारी चाहिए। हमारे परिदृश्य में, rollback को मंज़ूरी देने का मतलब सिर्फ़ यह मानना नहीं है कि ताज़ा डिप्लॉयमेंट संदिग्ध लगता है।
मंज़ूरी की प्रक्रिया में इच्छित ऑपरेशन, प्रभावित संसाधन और प्रासंगिक साक्ष्य सामने रखे जाने चाहिए, ताकि इंजीनियर उसके नतीजों का आकलन कर सके।
इंजीनियरों को किस चीज़ के लिए तैयार रहना चाहिए?
SRE और प्लेटफ़ॉर्म टीमों के लिए फ़ौरी बदलाव शायद इसमें होगा कि जाँच कैसे की जाती है।
इंजीनियर रोज़मर्रा की डायग्नोस्टिक जानकारी जुटाने में कम समय बिता सकते हैं और एजेंट द्वारा तैयार किए गए स्पष्टीकरणों और रिकवरी विकल्पों का मूल्यांकन करने में ज़्यादा।
इसके लिए फिर भी एप्लिकेशन आर्किटेक्चर, निर्भरताओं, डिप्लॉयमेंट प्रक्रियाओं और observability की गहरी जानकारी चाहिए।
एक संभावित दीर्घकालिक नतीजा भी है। अगर रोज़मर्रा के इंसीडेंट तेज़ी से ऑटोमेशन से संभाले जाने लगें, तो जूनियर इंजीनियरों को troubleshooting का अभ्यास करने के कम मौक़े मिल सकते हैं। संगठनों को सोचना होगा कि यह अनुभव कैसे विकसित किया जाए, ख़ासकर तब जब किसी अनजानी विफलता के लिए इंसानी प्रतिक्रिया चाहिए।
यह एक चिंता है जिसकी पड़ताल होनी चाहिए, मौजूदा incident-response उत्पादों का कोई प्रदर्शित नतीजा नहीं।
मौजूदा runbook (संचालन-निर्देशिका) यह तय करने में मदद कर सकते हैं कि एजेंट कैसे काम करें। एक उपयोगी runbook बताता है कि रिकवरी की कार्रवाई किन परिस्थितियों में उचित है, कौन-से क़दम ज़रूरी हैं और सफल रिकवरी की पुष्टि कैसे की जाए।
टीमें शुरुआत में एजेंटों को जाँच करने और कार्रवाइयाँ सुझाने दे सकती हैं, जबकि प्रोडक्शन में बदलाव स्थापित मंज़ूरी प्रक्रियाओं के अधीन रहें। ज़्यादा स्वचालित execution का मूल्यांकन ख़ास, अच्छी तरह समझे गए ऑपरेशनों के लिए, उचित सुरक्षा उपायों के साथ किया जा सकता है।
शुरुआती इंसीडेंट पर लौटें तो, हो सकता है एजेंट ने संबंधित डिप्लॉयमेंट और डेटाबेस एरर जल्दी पहचान लिए हों। rollback उचित है या नहीं, यह फिर भी इस पर निर्भर करता है कि उन घटनाओं का आपस में क्या संबंध है और एप्लिकेशन की स्थिति क्या है।
यहीं सिस्टम के बारे में इंजीनियर की जानकारी अनिवार्य बनी रहती है।
संदर्भ और आगे पढ़ने के लिए
हर स्रोत 14 अक्टूबर 2026 को खोला और जाँचा गया। दोनों शोध-पत्र preprint हैं, और Gemini Cloud Assist की क्षमता Preview में है तथा उस तक पहुँच सीमित है।
- Microsoft: Azure SRE Agent overview. उत्पाद की क्षमताएँ और जाँच के वर्कफ़्लो।
- Microsoft: Azure SRE Agent run modes. Review और autonomous मोड, जिनमें यह भी शामिल है कि मंज़ूरी कहाँ लागू होती है और कहाँ अन्य नियंत्रण चाहिए।
- Microsoft: Azure SRE Agent general availability announcement. 10 मार्च 2026 को प्रकाशित। यह विक्रेता की घोषणा है, प्रभावशीलता का स्वतंत्र प्रमाण नहीं।
- Google Cloud: Gemini Cloud Assist investigations. Preview स्थिति और पहुँच की सीमाएँ।
- Fu et al.: Incident-Arena: Getting agents to the last nine of reliability. Preprint 30 सितंबर 2026 को सबमिट किया गया। बेंचमार्क-विशिष्ट निष्कर्ष।
- Tian et al.: SRE-Marathon: A Continuous, Change-Driven Benchmark for Autonomous Site Reliability Agents. Preprint 26 सितंबर 2026 को सबमिट किया गया। लगातार विफलताओं वाला बेंचमार्क।