మీ కంపెనీ ఒక కొత్త AI అసిస్టెంట్ను మూల్యాంకనం చేస్తోందని ఊహించుకోండి.
వెండర్ ఇలా అంటాడు:
“మా AI 95% ఖచ్చితత్వం (accuracy) కలిగినది, ఎంటర్ప్రైజ్-రెడీ, సురక్షితమైనది, స్వయంప్రతిపత్తి (autonomous) కలిగినది, మరియు మీ వ్యాపారంపై శిక్షణ పొందినది.”
ఇది ఆకట్టుకునేలా అనిపిస్తుంది.
కానీ ప్రతి భాగం నిజంగా ఏమి అర్థం?
95% దేనిపై ఖచ్చితత్వం?
ఏ రిస్క్లకు వ్యతిరేకంగా సురక్షితం?
ఏమి చేయగలిగేంత స్వయంప్రతిపత్తి?
“మీ వ్యాపారంపై శిక్షణ పొందింది” అంటే మోడల్ను ఫైన్-ట్యూన్ (fine-tuned) చేశారని అర్థమా, కంపెనీ డాక్యుమెంట్లతో కనెక్ట్ చేశారని అర్థమా, లేదా రిట్రీవల్ ద్వారా సమాచారానికి యాక్సెస్ ఇచ్చారని మాత్రమే అర్థమా?
మరియు బహుశా అత్యంత ముఖ్యమైన ప్రశ్న:
క్లెయిమ్కు ఏ ఆధారం (evidence) మద్దతు ఇస్తుంది?
ఈ సిరీస్ పార్ట్ 1లో, మనం AI యొక్క ప్రాథమిక భాషను నేర్చుకున్నాం.
పార్ట్ 2లో, AIని ఒక ప్రశ్న అడగడం నుండి సమాధానం లేదా చర్య పొందడం మధ్య ఏమి జరగవచ్చో అనుసరించాం.
ఇప్పుడు మనం AI ఫ్లూయెన్సీ చివరి భాగానికి చేరుకున్నాం:
వివేచన (judgment).
లక్ష్యం ప్రతి AI క్లెయిమ్ను అనుమానించడం కాదు.
ఒక క్లెయిమ్ను అంగీకరించే ముందు ఏమి అడగాలో తెలుసుకోవడం.
క్లెయిమ్తో ప్రారంభించండి, మార్కెటింగ్ భాషతో కాదు
ఈ స్టేట్మెంట్ను మళ్లీ పరిగణించండి:
“95% ఖచ్చితత్వం.”
ఇది మనకు ఒక సంఖ్యను ఇస్తుంది.
కానీ ఆ సంఖ్య ఎలా ఉత్పత్తి చేయబడిందో తెలిసేవరకు దాని అర్థం చాలా తక్కువ.
AI పరీక్షించబడింది:
- 100 ప్రశ్నలపైనా లేదా 100,000 పైనా?
- సాధారణ ప్రశ్నలపైనా లేదా కష్టమైనవాటిపైనా?
- పబ్లిక్ సమాచారంపైనా లేదా కంపెనీ నిజమైన డాక్యుమెంట్లపైనా?
- ఒక భాషలోనా లేదా అనేక భాషల్లోనా?
- జాగ్రత్తగా తయారుచేసిన ప్రాంప్ట్లపైనా లేదా సాధారణ యూజర్ ప్రశ్నలపైనా?
- మీ సంస్థ నిజంగా ఉపయోగించాలని అనుకుంటున్న పని రకంపైనా?
సందర్భం లేని సంఖ్య ఖచ్చితంగా కనిపిస్తూనే చాలా తక్కువ చెప్పగలదు.
కాబట్టి మీరు ఒక AI క్లెయిమ్ను ఎదుర్కొన్నప్పుడు, ఉపయోగకరమైన మొదటి ప్రశ్న:
సరిగ్గా ఏమి కొలవబడింది?
ఖచ్చితత్వం (accuracy) మరియు విశ్వసనీయత (reliability) ఒకేలా ఉండవు
ఖచ్చితత్వం మరియు విశ్వసనీయత అనే పదాలు తరచుగా ఒకే అర్థంగా ఉపయోగించబడతాయి.
అవి కావు.
ఖచ్చితత్వం
ఖచ్చితత్వం ఒక సమాధానం లేదా అంచనా ఏదో ఒక ఆశించిన ఫలితం ప్రకారం సరైనదో కాదో అడుగుతుంది.
ఒక AI అసిస్టెంట్ 100 పరీక్ష ప్రశ్నలలో 95 సరిగ్గా సమాధానమిస్తుందని అనుకుందాం.
ఆ పరీక్షలో, దాని ఖచ్చితత్వాన్ని 95%గా వర్ణించవచ్చు.
కానీ అది మిగిలిన ఐదు వైఫల్యాల గురించి ఇంకా ఏమీ చెప్పదు.
అవి చిన్న తప్పులా?
లేదా వ్యవస్థ పూర్తి నమ్మకంతో ప్రమాదకరంగా తప్పు సమాధానాలు ఇచ్చిందా?
విశ్వసనీయత
విశ్వసనీయత వ్యవస్థ ఉద్దేశించిన ఉపయోగానికి తగినంత స్థిరంగా ప్రవర్తిస్తుందో లేదో అడుగుతుంది.
రెండు వ్యవస్థలను ఊహించుకోండి.
వ్యవస్థ A
95% ప్రశ్నలకు సరిగ్గా సమాధానమిస్తుంది కానీ దానికి తెలియనప్పుడు అప్పుడప్పుడు నమ్మకంగా ఒక సమాధానాన్ని కల్పిస్తుంది.
వ్యవస్థ B
92% సరిగ్గా సమాధానమిస్తుంది కానీ చాలా అనిశ్చిత సందర్భాలలో నమ్మకంగా ఇలా చెబుతుంది:
“దీనికి సమాధానం ఇవ్వడానికి నా వద్ద తగినంత సమాచారం లేదు.”
చాలా అనిశ్చిత సందర్భాలలో.
ఏది మెరుగైనది?
దీనికి సార్వత్రిక సమాధానం లేదు.
అది పని మీద ఆధారపడి ఉంటుంది.
సాధారణ సారాంశం రాయడానికి, వ్యవస్థ A ఆమోదయోగ్యంగా ఉండవచ్చు.
చట్టపరమైన, ఆర్థిక, వైద్య, లేదా కార్యాచరణ నిర్ణయాలకు, వైఫల్యాల ప్రవర్తన సగటు స్కోరు కంటే చాలా ఎక్కువ ముఖ్యం కావచ్చు.
గుర్తుంచుకోండి
ఖచ్చితత్వం అడుగుతుంది: సమాధానం సరైనదేనా?
విశ్వసనీయత అడుగుతుంది: కాలక్రమేణా, వివిధ పరిస్థితులలో వ్యవస్థ ఆమోదయోగ్యంగా ప్రవర్తిస్తుందని నేను నమ్మవచ్చా?
అందుకే ఒక్క ఖచ్చితత్వ శాతం చర్చను ముగించకూడదు.
బెంచ్మార్క్ (benchmark) ఒక పరీక్ష, నిజ ప్రపంచం కాదు
AI ప్రకటనలు తరచుగా బెంచ్మార్క్లను ప్రస్తావిస్తాయి.
బెంచ్మార్క్ అనేది నిర్దిష్ట పనులపై వ్యవస్థలను పోల్చడానికి ఉపయోగించే ప్రామాణిక పరీక్ష లేదా డేటాసెట్.
బెంచ్మార్క్లు ఉపయోగకరంగా ఉంటాయి.
అవి పరిశోధకులకు మరియు డెవలపర్లకు వీటిని పోల్చడంలో సహాయపడతాయి:
- భాషా అవగాహన;
- కోడింగ్;
- గణితం;
- రీజనింగ్ (reasoning) పనులు;
- ఇమేజ్ రికగ్నిషన్;
- రిట్రీవల్;
- సేఫ్టీ ప్రవర్తన;
- ఇతర సామర్థ్యాలు.
కానీ బెంచ్మార్క్ ఫలితం మీ సంస్థలో వ్యవస్థ ఎంత బాగా పనిచేస్తుందో ఆటోమేటిక్గా చెప్పదు.
ఒక AI మోడల్ డాక్యుమెంట్-ప్రశ్న బెంచ్మార్క్లో అధిక స్కోరు సాధించిందని అనుకుందాం.
మీ నిజమైన వాతావరణంలో ఇవి ఉండవచ్చు:
- సరిగ్గా ఫార్మాట్ చేయని PDFలు;
- పాతబడిన పాలసీలు;
- స్కాన్ చేసిన డాక్యుమెంట్లు;
- టేబుల్స్;
- విరుద్ధమైన వెర్షన్లు;
- అంతర్గత సంక్షిప్తాలు;
- అనేక భాషలు;
- అసంపూర్ణ డేటా.
ఆ పరిస్థితులు బెంచ్మార్క్ను అస్సలు పోలి ఉండకపోవచ్చు.
దీన్ని ఆలోచించడానికి ఉపయోగకరమైన మార్గం:
బెంచ్మార్క్ ఆ బెంచ్మార్క్లో వ్యవస్థ ఎలా పనిచేసిందో మాత్రమే చెబుతుంది.
అంతకు మించి ఏదైనా ఆధారం అవసరం.
Visual 1 — బెంచ్మార్క్ vs నిజమైన వినియోగం
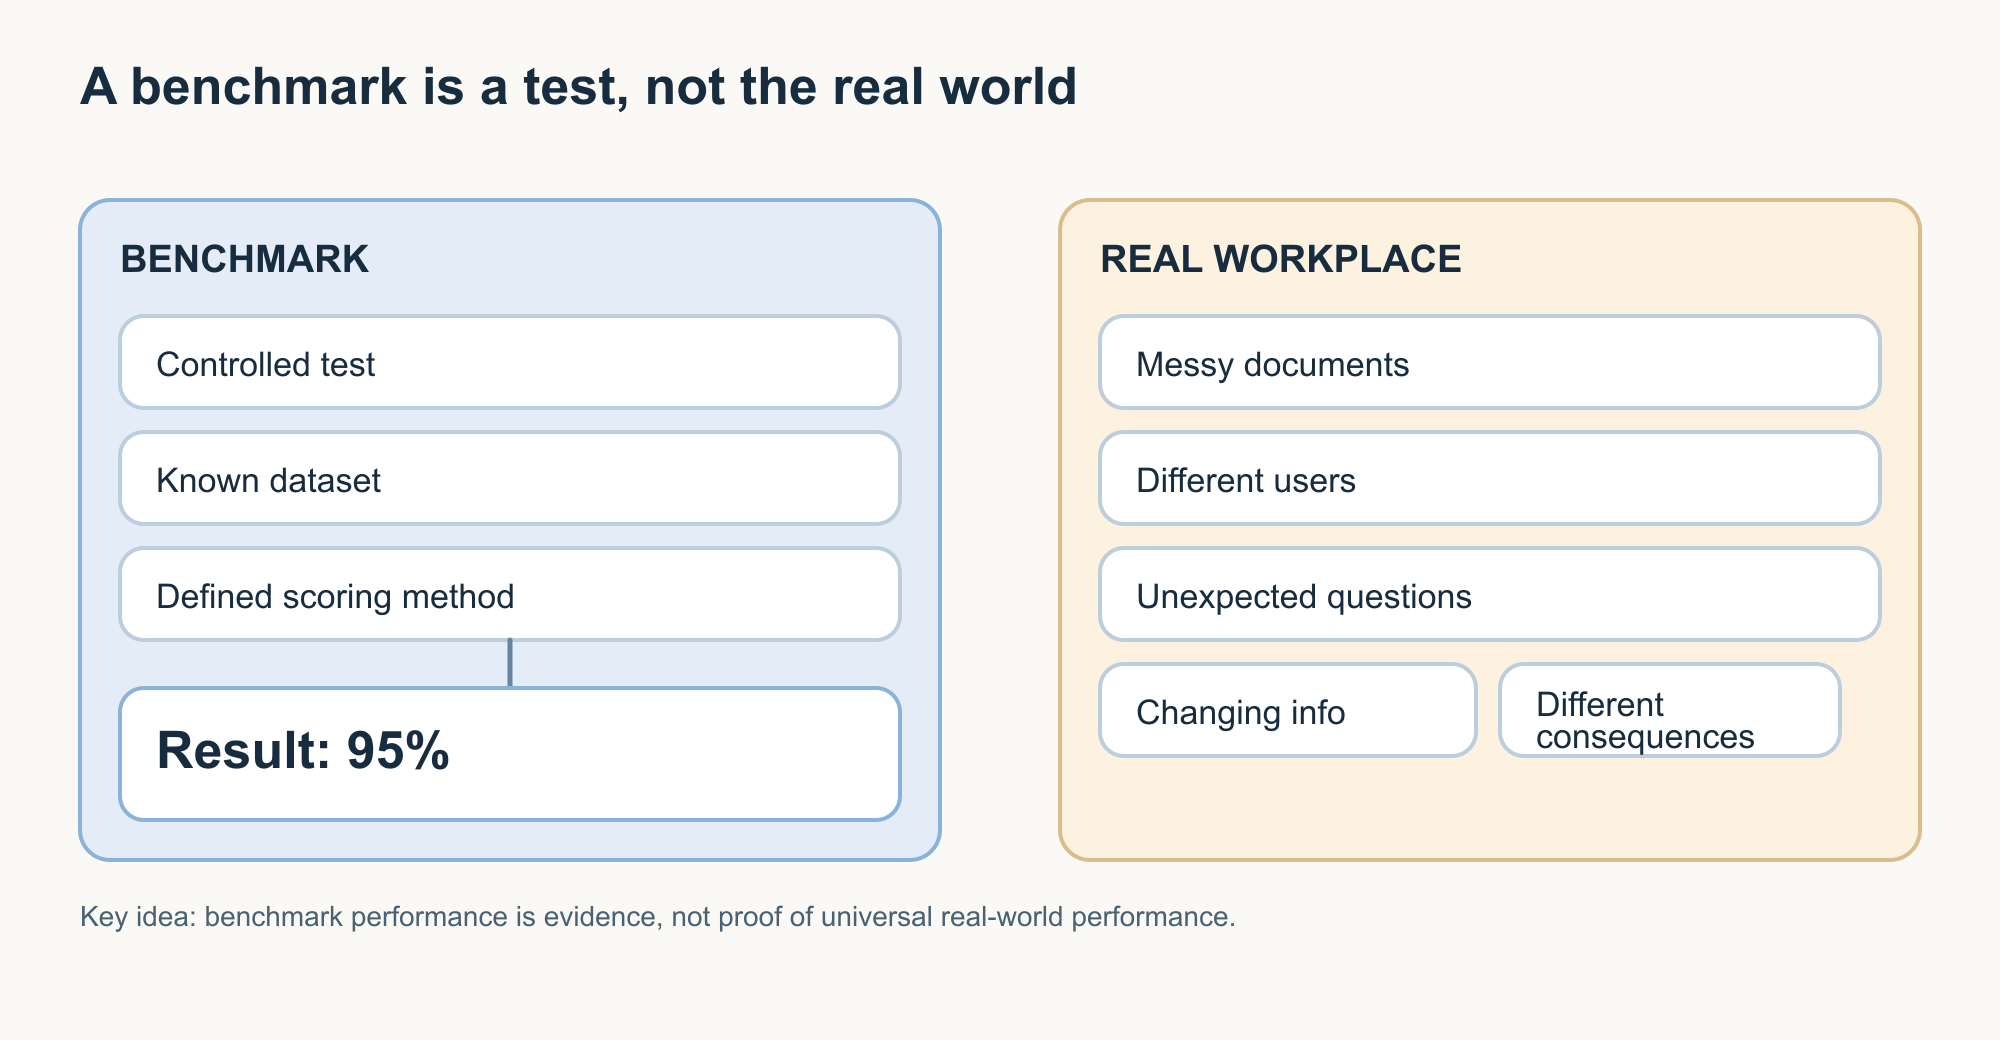
బెంచ్మార్క్
నియంత్రిత పరీక్ష తెలిసిన డేటాసెట్ నిర్వచించిన స్కోరింగ్ పద్ధతి
ఫలితం
95%
దీనితో పోల్చండి:
నిజమైన కార్యాలయం
గజిబిజి డాక్యుమెంట్లు వేర్వేరు యూజర్లు ఊహించని ప్రశ్నలు మారుతున్న సమాచారం వేర్వేరు పరిణామాలు
ముఖ్య విషయం: బెంచ్మార్క్ పనితీరు ఆధారం (evidence), కానీ ప్రతి నిజ-ప్రపంచ పరిస్థితిలో పనితీరుకు రుజువు కాదు.
మూల్యాంకనం (evaluation) అంటే ఏమిటి?
మూల్యాంకనం, తరచుగా eval అని సంక్షిప్తంగా అంటారు, ఇది AI వ్యవస్థ ఎలా ప్రవర్తిస్తుందో పరీక్షించే ఒక నిర్మాణాత్మక పద్ధతి.
బెంచ్మార్క్ మూల్యాంకనంలో భాగం కావచ్చు.
కానీ మూల్యాంకనాలు చాలా విస్తృతంగా ఉంటాయి.
మన కల్పిత కంపెనీ అసిస్టెంట్ కోసం, మనం వీటిని పరీక్షించవచ్చు:
- ఇది సాధారణ పాలసీ ప్రశ్నలకు సరిగ్గా సమాధానమిస్తుందా?
- ఇది సరైన డాక్యుమెంట్లను రిట్రీవ్ చేస్తుందా?
- ఇది పాలసీ మినహాయింపులను కల్పించకుండా ఉంటుందా?
- సమాచారం లేనప్పుడు ఇది చెబుతుందా?
- ఇది సరైన సోర్స్ను ఉదహరిస్తుందా?
- అదే ప్రశ్నను వేర్వేరుగా అడిగినప్పుడు ఇది స్థిరంగా ప్రవర్తిస్తుందా?
- తనకు అనుమతి లేని చర్యలను ఇది తిరస్కరిస్తుందా?
- ఇది సరైన టూల్ను ఉపయోగిస్తుందా?
- అవసరమైనప్పుడు ఆమోదం కోసం ఇది ఆగి అడుగుతుందా?
ఇది పబ్లిక్ బెంచ్మార్క్లో అంతర్లీన మోడల్ ఎంత బాగా స్కోర్ చేసిందో అడగడం కంటే నిజమైన సమస్యకు చాలా దగ్గరగా ఉంటుంది.
ప్రస్తుత మూల్యాంకన ఫ్రేమ్వర్క్లు పనితీరులోని వేర్వేరు అంశాలను వేరుగా విభజిస్తున్నాయి. ఉదాహరణకు, రిట్రీవల్, గ్రౌండెడ్నెస్, రిలవెన్స్, రెస్పాన్స్ కంప్లీట్నెస్, టూల్స్ వాడకం, టాస్క్ కంప్లీషన్, మరియు సేఫ్టీలను ఒకే సంఖ్యగా కుదించకుండా విడివిడిగా కొలవవచ్చు.
గుర్తుంచుకోండి
బెంచ్మార్క్ = ఒక ప్రామాణిక పరీక్ష.
మూల్యాంకనం = ఉద్దేశించిన పనికి వ్యవస్థ బాగా ప్రవర్తిస్తుందో లేదో కొలవడానికి విస్తృత ప్రక్రియ.
మీరు నిజంగా పట్టించుకునే పనిని మూల్యాంకనం చేయండి
మన కల్పిత AI అసిస్టెంట్కు తిరిగి వద్దాం.
వెండర్ ఇలా చెప్పాడని అనుకుందాం:
“95% ఖచ్చితత్వం.”
మెరుగైన మూల్యాంకనంలో ఇలాంటి నిజమైన ప్రశ్నలు ఉండవచ్చు:
“నేను వచ్చే సంవత్సరానికి ఎన్ని లీవ్ రోజులు క్యారీ చేయవచ్చు?”
“నేను సంవత్సరం మధ్యలో జాయిన్ అయితే ఏమవుతుంది?”
“ఈ పాలసీ కాంట్రాక్టర్లకు వర్తిస్తుందా?”
“పాలసీ నా కేసుకు సమాధానం ఇవ్వడం లేదు. నేను ఏమి చేయాలి?”
చివరి ప్రశ్న ముఖ్యంగా ముఖ్యమైనది.
ఉపయోగకరమైన AI వ్యవస్థ సమాధానం ఉన్నప్పుడు మాత్రమే బాగా పనిచేయకూడదు.
సమాధానం లేనప్పుడు కూడా అది తెలివిగా ప్రవర్తించాలి.
అక్కడే ఒక చిన్న పరీక్ష సెట్ విస్తృత మార్కెటింగ్ సంఖ్య కంటే ఎక్కువ వెల్లడించగలదు.
Visual 2 — నిజమైన పనిని మూల్యాంకనం చేయండి
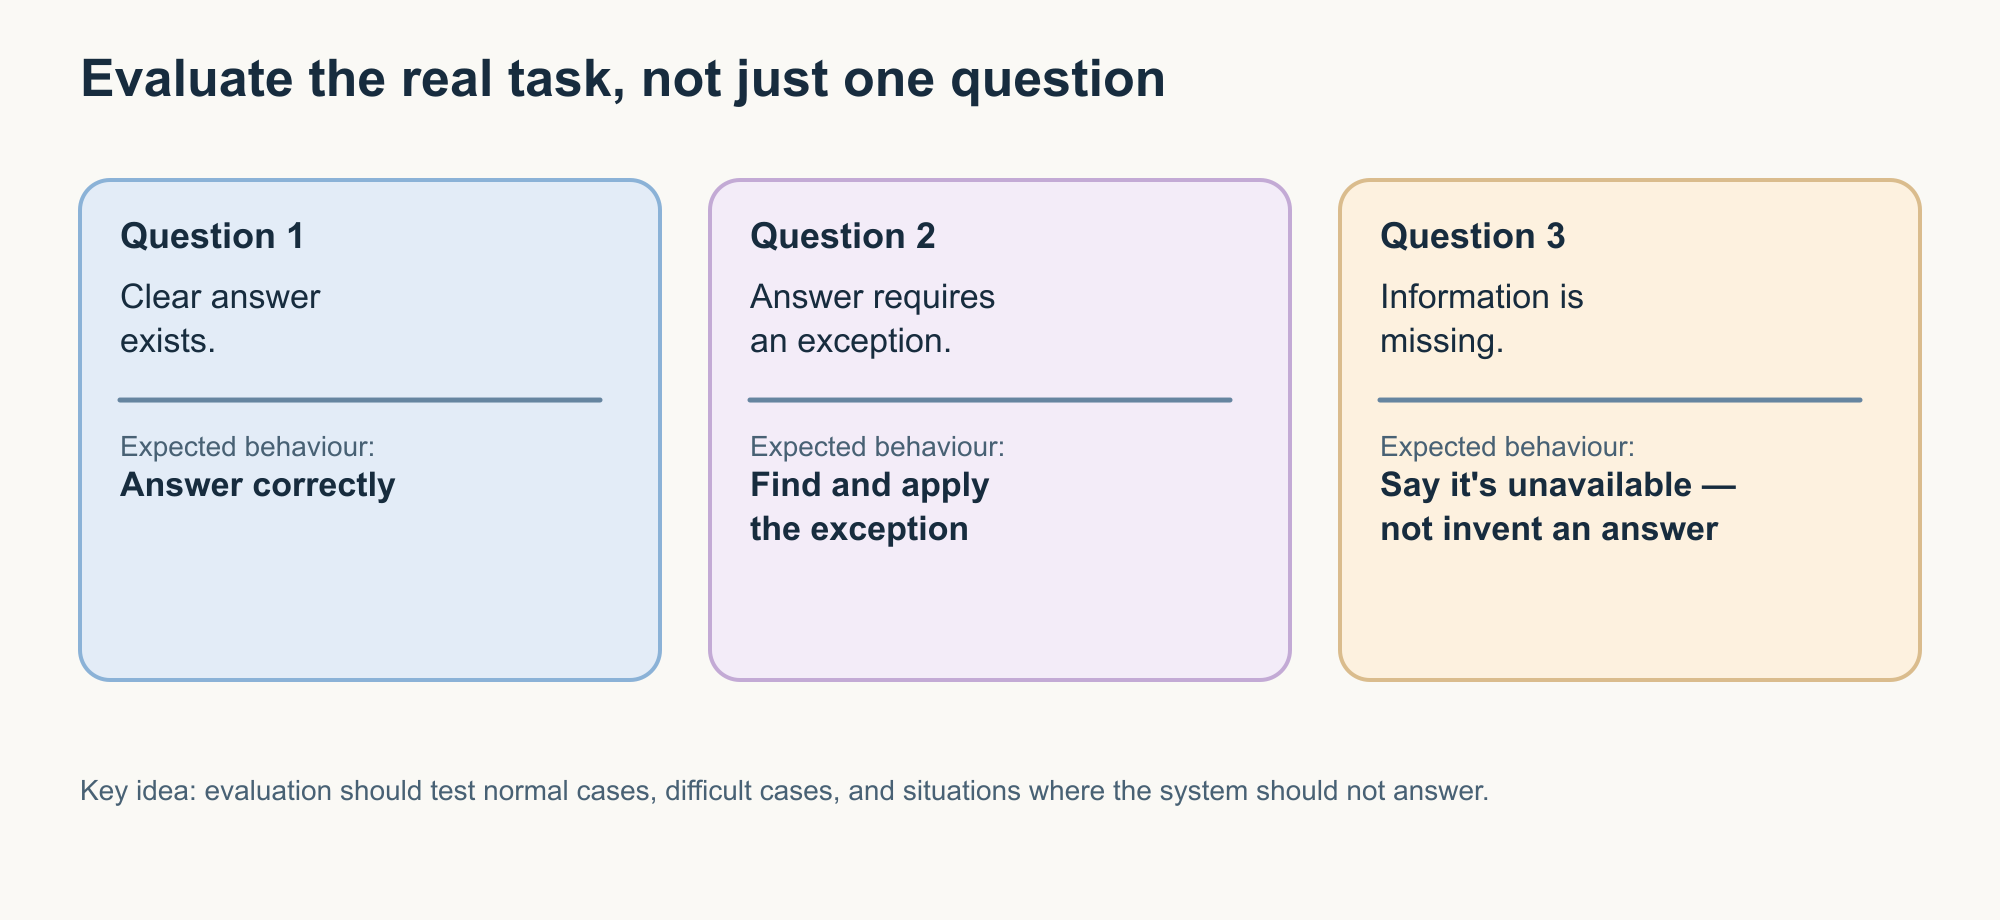
ప్రశ్న 1
స్పష్టమైన సమాధానం ఉంది.
ఆశించిన ప్రవర్తన: సరిగ్గా సమాధానమివ్వడం.
ప్రశ్న 2
సమాధానానికి ఒక మినహాయింపు అవసరం.
ఆశించిన ప్రవర్తన: మినహాయింపును కనుగొని వర్తింపజేయడం.
ప్రశ్న 3
పాలసీలో సమాధానం లేదు.
ఆశించిన ప్రవర్తన: సమాచారం అందుబాటులో లేదని చెప్పడం, కల్పించకుండా.
ముఖ్య విషయం: మూల్యాంకనం సాధారణ కేసులను, కష్టమైన కేసులను, మరియు వ్యవస్థ సమాధానం ఇవ్వకూడని పరిస్థితులను పరీక్షించాలి.
ఒక మంచి ఫలితం సాధారణ సామర్థ్యాన్ని రుజువు చేయదు
మీరు ఏదైనా AI ప్రదర్శన చూసినప్పుడు ఇది ముఖ్యం.
ఒక వ్యవస్థ ఒక ఉదాహరణపై చాలా బాగా పనిచేయవచ్చు.
అది వీటిపై అంతే బాగా పనిచేస్తుందని అర్థం కాదు:
- వేర్వేరు యూజర్లు;
- వేర్వేరు భాషలు;
- పొడవైన డాక్యుమెంట్లు;
- అసాధారణ ఇన్పుట్లు;
- మారుతున్న డేటా;
- ఇతర పరిశ్రమలు;
- ఎక్కువ రిస్క్ ఉన్న నిర్ణయాలు.
దీన్ని కొన్నిసార్లు సాధారణీకరణ (generalisation) సమస్య అని అంటారు.
వ్యవస్థ దాన్ని పరీక్షించిన పరిస్థితులలో బాగా పనిచేయవచ్చు కానీ వాటికి బయట తక్కువ బాగా పనిచేయవచ్చు.
NIST యొక్క AI రిస్క్ మేనేజ్మెంట్ ఫ్రేమ్వర్క్ ఒక వ్యవస్థను అభివృద్ధి చేసి మూల్యాంకనం చేసిన పరిస్థితులకు మించి ఫలితాలు ఎంతవరకు సాధారణీకరించవచ్చో డాక్యుమెంట్ చేయాలని స్పష్టంగా కోరుతుంది.
మంచి ప్రశ్న:
ఇది ఎక్కడ పరీక్షించబడింది, ఎక్కడ పరీక్షించబడలేదు?
బయాస్ (bias) మరియు న్యాయబద్ధత (fairness)కు సందర్భం అవసరం
మరొక సాధారణ AI చర్చ బయాస్ను కలిగి ఉంటుంది.
బయాస్ అంటే కేవలం:
“AIకి ఒక అభిప్రాయం ఉంది” అని అర్థం కాదు.
AI వ్యవస్థలలో, బయాస్ అనేక మూలాల నుండి రావచ్చు:
- శిక్షణా డేటా;
- లేబుల్స్;
- చారిత్రక పద్ధతులు;
- శాంప్లింగ్;
- సమస్యను ఎలా నిర్వచిస్తారు;
- అవుట్పుట్లను ఎలా అర్థం చేసుకుంటారు;
- వ్యవస్థను ఎలా డిప్లాయ్ చేస్తారు.
చారిత్రక నిర్ణయాలపై శిక్షణ పొందిన ఒక హైరింగ్ వ్యవస్థను పరిగణించండి.
గత హైరింగ్ పద్ధతులు ఒక గ్రూప్కు నష్టం కలిగించినట్లయితే, వ్యవస్థ ఆ నిర్ణయాలకు సంబంధించిన పద్ధతులను నేర్చుకోవచ్చు.
ఒక రక్షిత లక్షణాన్ని స్పష్టంగా తొలగించినప్పటికీ, ఇతర వేరియబుల్స్ ఇప్పటికీ దానితో సంబంధం కలిగి ఉండవచ్చు.
అందుకే న్యాయబద్ధతను మోడల్ ఉద్దేశపూర్వకంగా వివక్ష చూపుతుందా అని అడగడం ద్వారా మాత్రమే నిర్ధారించలేము.
మరింత ఉపయోగకరమైన ప్రశ్న:
ఈ సందర్భంలో సంబంధిత గ్రూపులకు వ్యవస్థ ఫలితాలు అన్యాయమైన తేడాలను సృష్టిస్తున్నాయా?
న్యాయబద్ధత కూడా ఒకే సార్వత్రిక గణిత నియమం కాదు.
వేర్వేరు పరిస్థితులకు వేర్వేరు నిర్వచనాలు మరియు ట్రేడ్-ఆఫ్లు అవసరం కావచ్చు.
NIST హానికరమైన బయాస్ను నిర్వహించే న్యాయబద్ధతను ఒకే సార్వత్రిక స్కోరుకు కుదించలేని అనేక విశ్వసనీయత లక్షణాలలో ఒకటిగా పరిగణిస్తుంది.
మోడల్ సమాధానం ఇచ్చే ముందే గోప్యత (privacy) ప్రారంభమవుతుంది
మీ కంపెనీ అసిస్టెంట్ వీటిని యాక్సెస్ చేయగలదని అనుకుందాం:
- ఉద్యోగుల ఫైల్స్;
- కస్టమర్ రికార్డులు;
- కాంట్రాక్టులు;
- ఇమెయిల్స్;
- ఆర్థిక డేటా.
ఒక వ్యవస్థ పూర్తిగా ఖచ్చితమైన సమాధానాలు ఇస్తూనే తప్పు వ్యక్తికి సమాచారాన్ని బహిర్గతం చేస్తే అసురక్షితంగా ఉండవచ్చు.
అందుకే గోప్యత కేవలం:
“మోడల్ నా ప్రాంప్ట్ను గుర్తుంచుకుంటుందా?” అని మాత్రమే కాదు.
ఉపయోగకరమైన ప్రశ్నలు:
- వ్యవస్థ ఏ సమాచారాన్ని యాక్సెస్ చేయగలదు?
- యూజర్కు అర్హత ఉన్నదాన్ని మాత్రమే అది యాక్సెస్ చేస్తుందా?
- సంభాషణ డేటా ఎక్కడ నిల్వ చేయబడుతుంది?
- అది ఎంతకాలం నిలుపబడుతుంది?
- సున్నితమైన సమాచారం మరొక సేవకు పంపబడుతుందా?
- అడ్మినిస్ట్రేటర్లు వినియోగాన్ని సమీక్షించగలరా?
- మోడల్ మెరుగుదల కోసం డేటా ఉపయోగించబడుతుందా?
- యాక్సెస్ను రద్దు చేయవచ్చా?
టూల్స్ మరియు కంపెనీ డేటాను ఉపయోగించే వ్యవస్థలకు, యాక్సెస్ నియంత్రణ సమాధాన నాణ్యత అంతే ముఖ్యమైనది.
అధిక అనుమతులు ఉన్న శక్తివంతమైన AI వ్యవస్థ తక్కువ కాకుండా ఎక్కువ రిస్క్ను సృష్టించవచ్చు.
“సురక్షితం” అనేది తనంతట తానుగా చాలా విస్తృతమైనది
ఇప్పుడు వెండర్ స్టేట్మెంట్కు తిరిగి వద్దాం:
“ఎంటర్ప్రైజ్-రెడీ మరియు సురక్షితం.”
ఏ దానికి వ్యతిరేకంగా సురక్షితం?
భద్రత (security) చాలా వేర్వేరు ఆందోళనలను కలిగి ఉండవచ్చు:
- అనధికార యాక్సెస్;
- క్రెడెన్షియల్ దొంగతనం;
- ప్రాంప్ట్ ఇంజెక్షన్;
- డేటా లీకేజ్;
- హానికరమైన ఫైల్స్;
- అసురక్షిత టూల్ కాల్స్;
- ప్రివిలేజ్ ఎస్కలేషన్;
- రాజీపడిన ఇంటిగ్రేషన్లు;
- మోడల్ లేదా సేవ దుర్వినియోగం;
- సేవా నిరాకరణ (denial of service).
ఏ ప్రొడక్ట్ కూడా ప్రతి అర్థంలో కేవలం “సురక్షితం” కాదు.
మెరుగైన క్లెయిమ్ ఇవి వివరిస్తుంది:
- ఏ బెదిరింపులు పరిగణించబడ్డాయి;
- ఏ నియంత్రణలు ఉన్నాయి;
- ఏ పరీక్ష జరిగింది;
- ఏ రిస్క్లు మిగిలి ఉన్నాయి.
NIST కూడా భద్రత మరియు స్థితిస్థాపకతను (resilience) మూల్యాంకనం మరియు డాక్యుమెంటేషన్ అవసరమైన ప్రత్యేక విశ్వసనీయత లక్షణాలుగా పరిగణిస్తుంది.
గుర్తుంచుకోండి
మీరు వినినప్పుడు:
“సురక్షితమైన AI”
అడగండి:
ఏ బెదిరింపుకు వ్యతిరేకంగా, ఏ పరిస్థితులలో సురక్షితం?
గార్డ్రెయిల్స్ (guardrails): ప్రవర్తన చుట్టూ నియంత్రణలు
మీరు గార్డ్రెయిల్స్ అనే పదాన్ని కూడా వింటారు.
గార్డ్రెయిల్స్ అనేవి AI ప్రవర్తనను నియంత్రించడానికి లేదా మార్గనిర్దేశం చేయడానికి ఉద్దేశించిన నియంత్రణలు.
వాటిలో ఇవి ఉండవచ్చు:
- కంటెంట్ ఫిల్టర్లు;
- అనుమతించబడిన-టూల్ జాబితాలు;
- అనుమతి తనిఖీలు;
- వాలిడేషన్ నియమాలు;
- రేట్ లిమిట్లు;
- మానవ ఆమోదాలు;
- పాలసీ తనిఖీలు;
- అవుట్పుట్ పరిమితులు.
ఉదాహరణకు, ఒక AI అసిస్టెంట్ పేమెంట్ రిక్వెస్ట్ను డ్రాఫ్ట్ చేయడానికి అనుమతించబడవచ్చు కానీ దాన్ని సమర్పించడానికి కాదు.
లేదా ఇది ఉద్యోగుల సమాచారాన్ని శోధించడానికి అనుమతించబడవచ్చు కానీ అభ్యర్థించే యూజర్ అనుమతుల పరిధిలో మాత్రమే.
గార్డ్రెయిల్స్ ఉపయోగకరంగా ఉంటాయి.
కానీ ఒక గార్డ్రెయిల్ ఉనికి వ్యవస్థ ఎప్పటికీ విఫలం కాదని అర్థం కాదు.
మెరుగైన ప్రశ్న:
ఈ గార్డ్రెయిల్ ఏ ప్రవర్తనను నియంత్రిస్తుంది, ఆ నియంత్రణ ఎలా పరీక్షించబడింది?
మానవ పర్యవేక్షణ (human oversight) అంటే కేవలం ఆమోద బటన్ను జోడించడం కంటే ఎక్కువ
చాలా AI ప్రొడక్ట్లు హ్యూమన్-ఇన్-ది-లూప్ లేదా మానవ పర్యవేక్షణను ప్రస్తావిస్తాయి.
అది భరోసానిచ్చేలా అనిపిస్తుంది.
కానీ పర్యవేక్షణ నాణ్యత అది ఎలా డిజైన్ చేయబడిందనే దానిపై ఆధారపడి ఉంటుంది.
ఒక AI వ్యవస్థ రోజుకు 500 నిర్ణయాలను సిద్ధం చేసి ప్రతి ఒక్కదాన్ని ఆమోదించమని ఒక ఉద్యోగిని అడుగుతుందని ఊహించుకోండి.
సాంకేతికంగా, ఒక మానవుడు పాల్గొంటున్నాడు.
ఆచరణాత్మకంగా, ఉద్యోగి అర్థవంతమైన సమీక్ష లేకుండా ఆమోదించును క్లిక్ చేయడం మొదలుపెట్టవచ్చు.
మంచి పర్యవేక్షణ ఇలాంటి ప్రశ్నలకు సమాధానం ఇవ్వాలి:
- ఏ నిర్ణయాలకు సమీక్ష అవసరం?
- సమీక్షకుడు ఏ సమాచారం చూస్తాడు?
- వ్యవస్థ ఎందుకు ఆ సిఫార్సు చేసిందో సమీక్షకుడు అర్థం చేసుకోగలడా?
- సమీక్షకుడు దాన్ని తిరస్కరించగలడా లేదా సరిదిద్దగలడా?
- అధిక-రిస్క్ కేసులు వేరుగా ఎస్కలేట్ చేయబడతాయా?
- పనిభారం వాస్తవికంగా ఉందా?
మానవ పర్యవేక్షణ ఒక అర్థవంతమైన నియంత్రణగా ఉండాలి, కేవలం ఒక లేబుల్ కాదు.
Visual 3 — గార్డ్రెయిల్ vs మానవ పర్యవేక్షణ
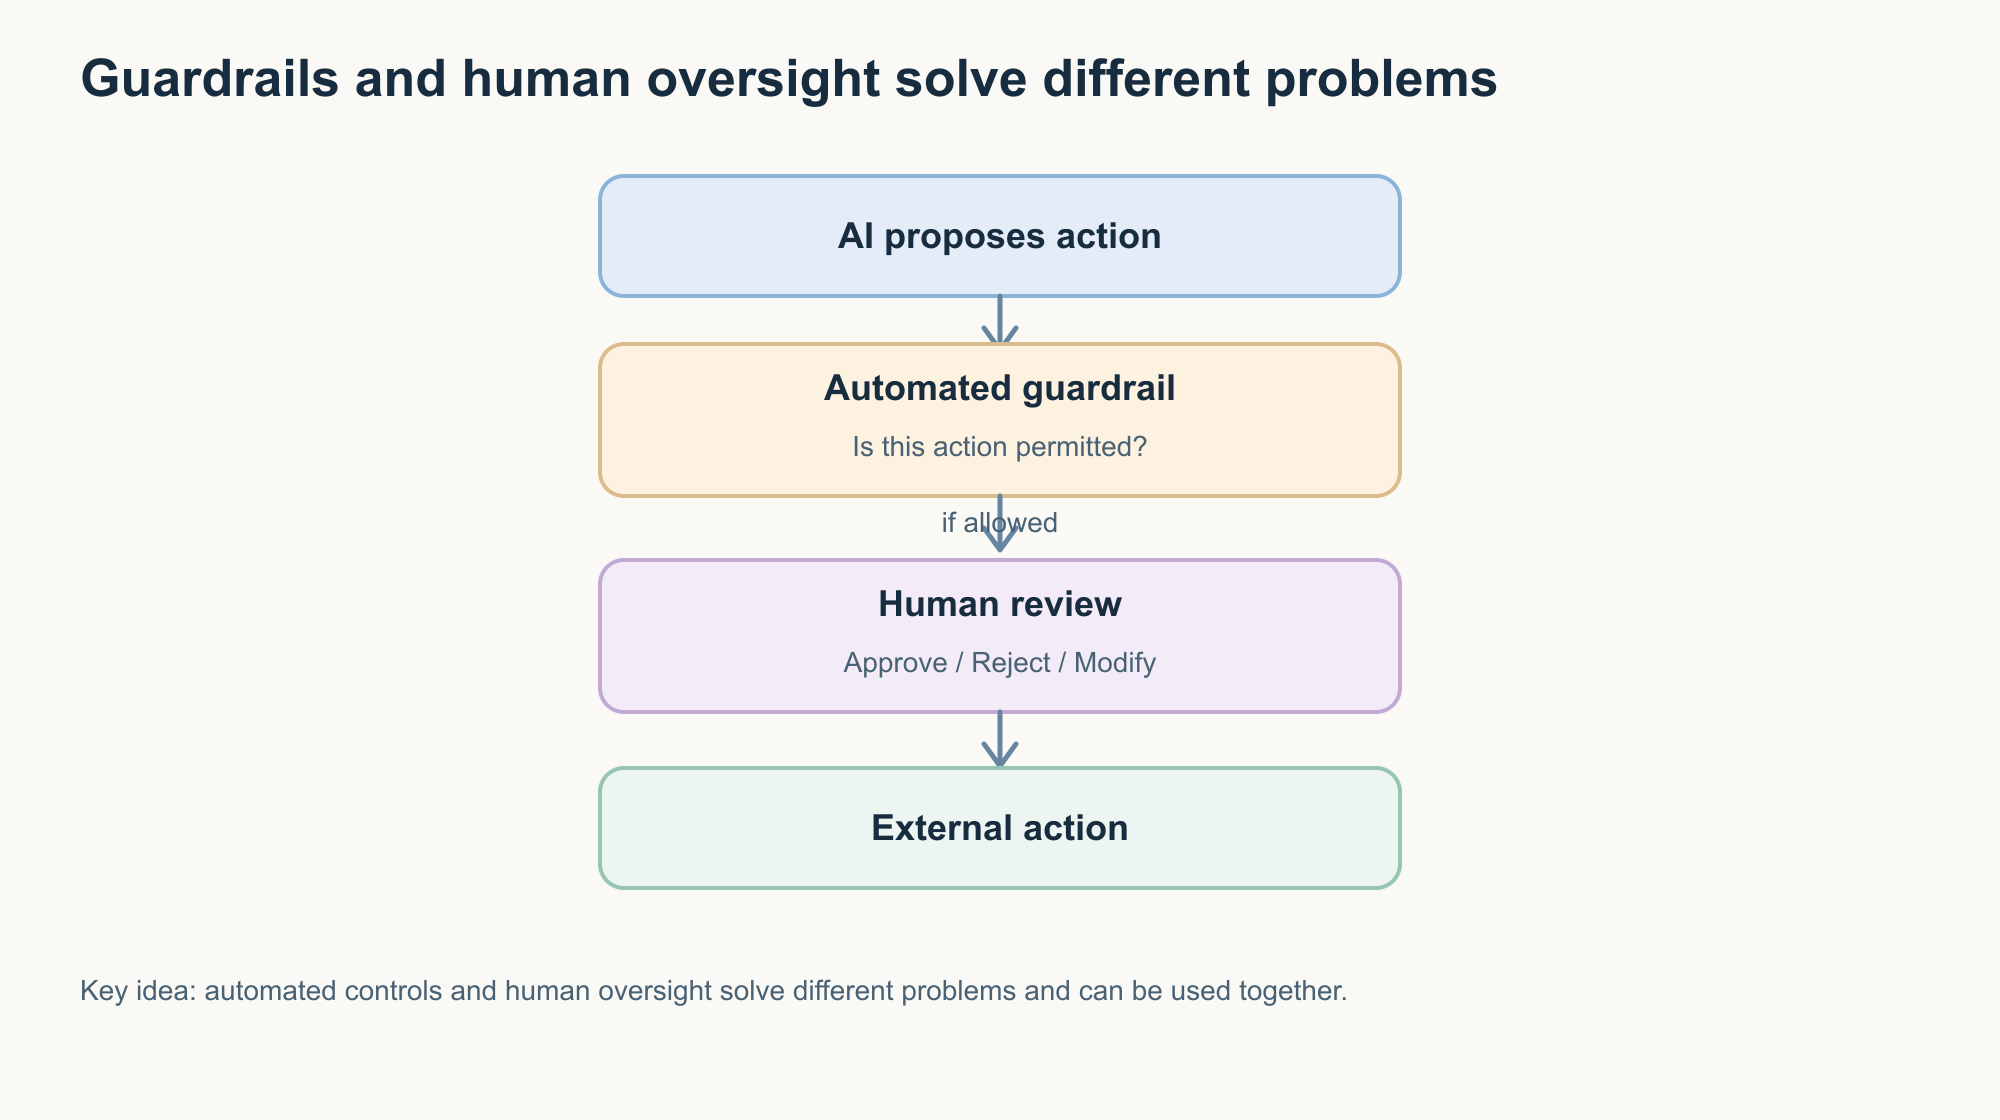
AI చర్యను ప్రతిపాదిస్తుంది
ఆటోమేటెడ్ గార్డ్రెయిల్
ఈ చర్య అనుమతించబడిందా?
అనుమతించబడితే:
ముఖ్యమైన చర్య కోసం మానవ సమీక్ష
ఆమోదించు / తిరస్కరించు / సవరించు
బాహ్య చర్య
ముఖ్య విషయం: ఆటోమేటెడ్ నియంత్రణలు మరియు మానవ పర్యవేక్షణ వేర్వేరు సమస్యలను పరిష్కరిస్తాయి, వాటిని కలిపి ఉపయోగించవచ్చు.
“మీ వ్యాపారంపై శిక్షణ పొందింది” అనేకసార్లు వేర్వేరు అర్థాలు కలిగి ఉంటుంది
ఇది అపార్థం చేసుకోవడానికి సులభమైన AI పదబంధాలలో ఒకటి.
ఒక వెండర్ చెబుతాడు:
“వ్యవస్థ మీ కంపెనీ డేటాపై శిక్షణ పొందింది.”
సాంకేతికంగా ఏమి జరిగింది?
అనేక అవకాశాలు ఉన్నాయి.
సమాచారం ప్రాంప్ట్ లేదా కాంటెక్స్ట్లో సరఫరా చేయబడుతుంది
మీ కంపెనీ మెటీరియల్ పని సమయంలో మోడల్కు ఇవ్వబడుతుంది.
అంతర్లీన మోడల్ తప్పనిసరిగా మార్చబడలేదు.
వ్యవస్థ RAGను ఉపయోగిస్తుంది
అవసరమైనప్పుడు సంబంధిత కంపెనీ సమాచారం రిట్రీవ్ చేయబడి మోడల్కు సరఫరా చేయబడుతుంది.
మళ్లీ, బేస్ మోడల్ మారకుండానే ఉండవచ్చు.
మోడల్ ఫైన్-ట్యూన్ చేయబడింది
అదనపు శిక్షణ మోడల్ యొక్క పారామీటర్లను దాని ప్రవర్తన లేదా పనితీరును మార్చుకోవడానికి మార్చింది.
ఈ మూడు విధానాలు ఒకేలా ఉండవు.
పని బట్టి ఒకటి మరొకదాని కంటే ఎక్కువ సముచితం కావచ్చు.
Visual 4 — మూడు వేర్వేరు విధానాలు
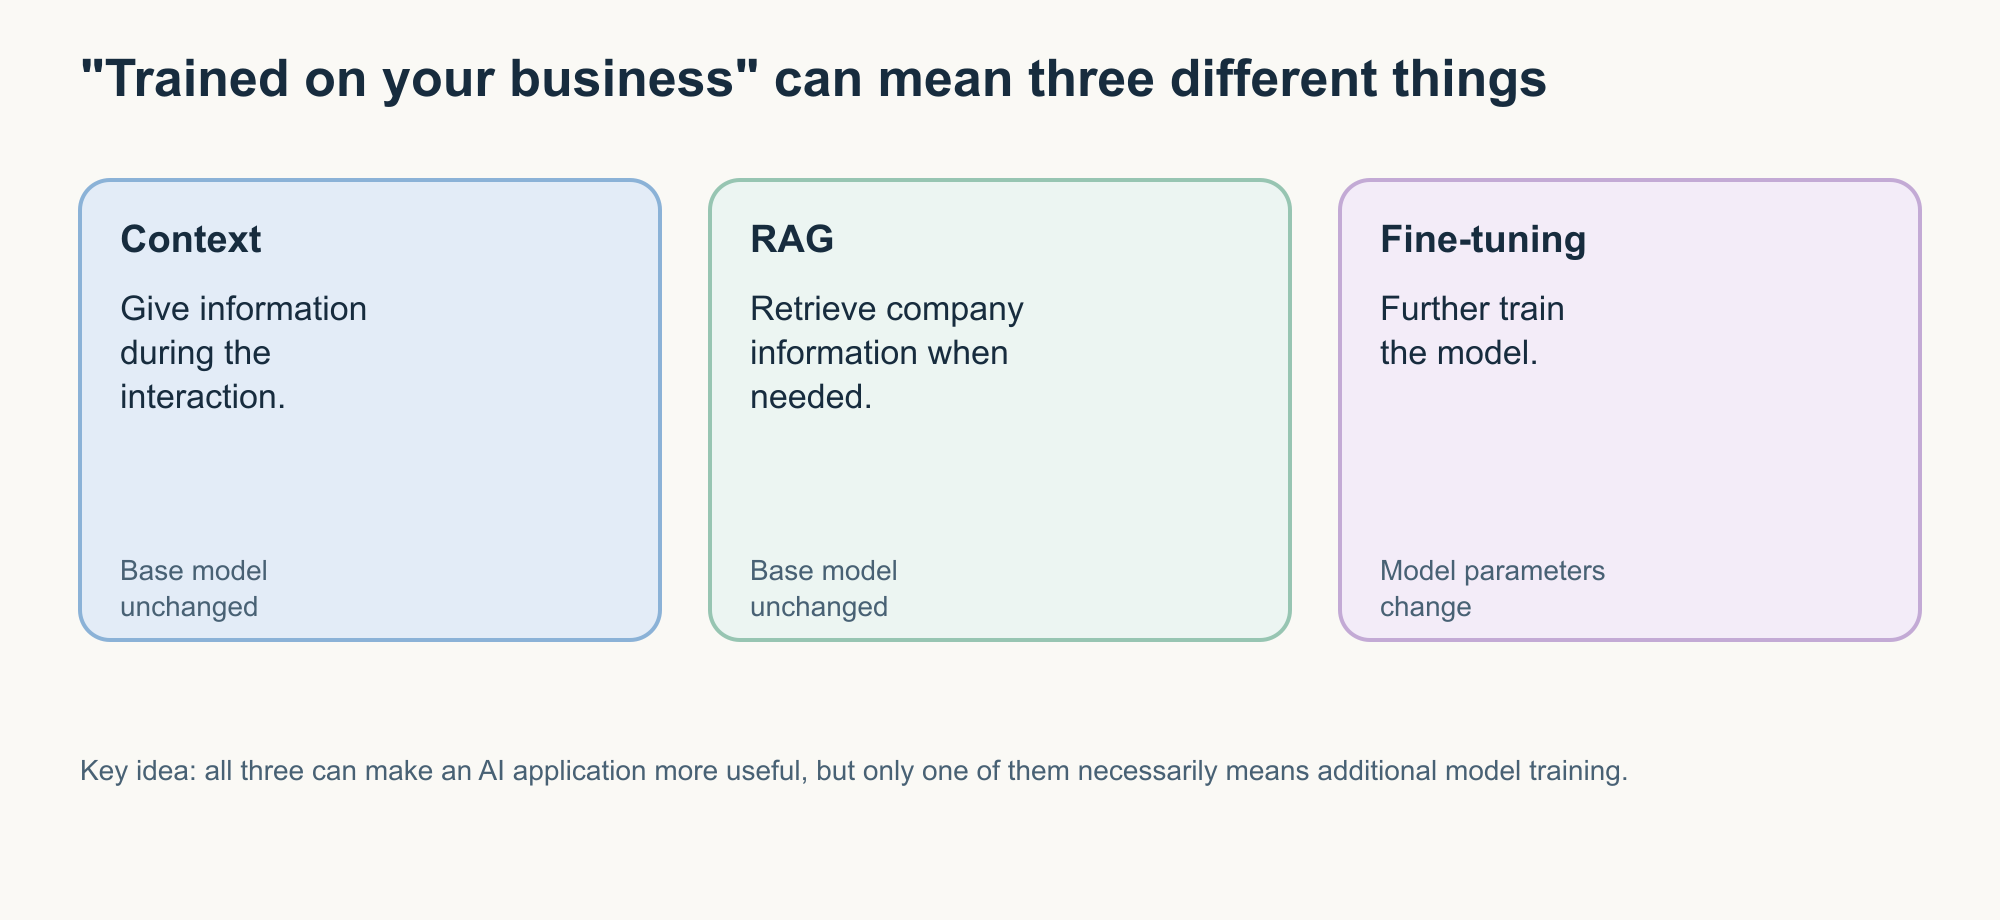
కాంటెక్స్ట్
ఇంటరాక్షన్ సమయంలో సమాచారం ఇవ్వడం.
RAG
అవసరమైనప్పుడు కంపెనీ సమాచారాన్ని రిట్రీవ్ చేయడం.
ఫైన్-ట్యూనింగ్
మోడల్ను మరింత శిక్షణ ఇవ్వడం.
ముఖ్య విషయం: మూడూ ఒక వ్యాపార AI అప్లికేషన్ను మరింత ఉపయోగకరంగా చేయగలవు, కానీ వాటిలో ఒకటి మాత్రమే తప్పనిసరిగా అదనపు మోడల్ శిక్షణను సూచిస్తుంది.
ఎవరైనా ఇలా చెప్పినప్పుడు:
“మా AI మీ డేటాపై శిక్షణ పొందింది,”
అడగండి:
మీ ఉద్దేశం కాంటెక్స్ట్, రిట్రీవల్, లేదా వాస్తవ మోడల్ శిక్షణా?
“రీజనింగ్” ఉపయోగకరమైన భాష, కానీ అది సూచించే దానితో జాగ్రత్తగా ఉండండి
ఆధునిక AI వ్యవస్థలను తరచుగా రీజనింగ్ మోడల్స్ అని లేదా బలమైన రీజనింగ్ సామర్థ్యాలు కలిగినవిగా వర్ణిస్తారు.
ప్రాక్టికల్ ప్రొడక్ట్ చర్చలలో, దీని అర్థం సాధారణంగా వ్యవస్థ అనేక అనుసంధాన దశలు అవసరమయ్యే పనులలో బాగా పనిచేస్తుంది, అవి:
- గణితం;
- కోడింగ్;
- ప్లానింగ్;
- తార్కిక సమస్యలు;
- సమాచారాన్ని కలపడం.
అది సామర్థ్యానికి ఉపయోగకరమైన వివరణ కావచ్చు.
కానీ ఇలాంటి పదాలు:
- ఆలోచించడం;
- అర్థం చేసుకోవడం;
- రీజనింగ్;
- తెలుసుకోవడం;
కూడా సాధారణ మానవ పదాలు.
AI కోసం వాటిని ఉపయోగించడం వ్యవస్థ గురించి నిజంగా ప్రదర్శించబడిన దానికంటే ఎక్కువ అనుకోవడం సులభతరం చేస్తుంది.
ఉపయోగకరమైన ప్రశ్న ఇది కాదు:
“ఈ AI నిజంగా ఆలోచిస్తుందా?”
చాలా ప్రొడక్ట్ నిర్ణయాలకు, మెరుగైన ప్రశ్న:
ఇది ఏ పనులను చేయగలదు, అది ఎలా కొలవబడింది, ఇంకా ఎక్కడ విఫలమవుతుంది?
అది చర్చను ఆధారంతో కనెక్ట్ చేస్తుంది.
స్వయంప్రతిపత్తి (autonomy) ఒకే స్విచ్ కాదు
మరొక ప్రసిద్ధ పదం స్వయంప్రతిపత్తిగల (autonomous).
ఒక వెండర్ ఇలా చెప్పవచ్చు:
“మా AI ఏజెంట్ స్వయంప్రతిపత్తితో పనిచేస్తుంది.”
దాని అర్థం చాలా వేర్వేరుగా ఉండవచ్చు.
వ్యవస్థ ఇలా చేయగలదు:
- ఏ డాక్యుమెంట్ను శోధించాలో ఎంచుకోవడం;
- ఏ టూల్ను కాల్ చేయాలో నిర్ణయించడం;
- అనేక మధ్యంతర నిర్ణయాలు తీసుకోవడం;
- ఆమోదం లేకుండా ఇమెయిల్ పంపడం;
- కస్టమర్ డేటాను సవరించడం;
- ఆర్థిక లావాదేవీలను అమలు చేయడం.
ఇవి చాలా వేర్వేరు స్వయంప్రతిపత్తి స్థాయిలు.
దీనికి బదులుగా:
“ఇది స్వయంప్రతిపత్తి కలిగినదా?”
అని అడగడానికి బదులుగా అడగండి:
ఇది స్వయంగా ఏమి నిర్ణయించగలదు?
మరియు:
మానవ ఆమోదం లేకుండా ఇది ఏమి చేయగలదు?
ఆ ప్రశ్నలు చాలా ఎక్కువ వెల్లడిస్తాయి.
తుది సమాధానాన్ని మాత్రమే కాదు, మార్గాన్ని కూడా మూల్యాంకనం చేయండి
ఇది ఏజెంట్లతో ముఖ్యంగా ముఖ్యమవుతుంది.
ఒక ఏజెంట్ సరైన మీటింగ్ను విజయవంతంగా బుక్ చేస్తుందని అనుకుందాం.
తుది ఫలితం సరైనదిగా కనిపిస్తుంది.
కానీ బహుశా అది:
- అనవసరమైన వ్యవస్థలను ప్రశ్నించింది;
- తనకు అవసరం లేని సమాచారాన్ని యాక్సెస్ చేసింది;
- తప్పు టూల్ను అనేకసార్లు కాల్ చేసింది;
- మార్గంలో సున్నితమైన సమాచారాన్ని బహిర్గతం చేసింది;
- పదేపదే వైఫల్యాల తర్వాత మాత్రమే విజయం సాధించింది.
మనం కేవలం తుది మీటింగ్ బుకింగ్ను మాత్రమే చూస్తే, ముఖ్యమైన ప్రవర్తనను కోల్పోతాం.
ఆధునిక ఏజెంట్ మూల్యాంకనాలు తుది ఫలితం మరియు దానికి చేరుకోవడానికి ఏజెంట్ తీసుకున్న చర్యల క్రమం అయిన ట్రాజెక్టరీ (trajectory) మధ్య తేడాను ఎక్కువగా గుర్తిస్తున్నాయి. ఉదాహరణకు, Google తుది-ప్రతిస్పందన మూల్యాంకనాన్ని ట్రాజెక్టరీ మూల్యాంకనం నుండి విడిగా డాక్యుమెంట్ చేస్తుంది, అయితే Microsoft టాస్క్ కంప్లీషన్ మరియు టూల్ ఎంపిక/వాడకం చుట్టూ మెట్రిక్లను అందిస్తుంది.
గుర్తుంచుకోండి
ఒక ఏజెంట్ కోసం:
ఇది పనిని పూర్తి చేసిందా?
ఇది ఒక ప్రశ్న.
ఇది పనిని ఎలా పూర్తి చేసింది?
ఇది మరొక ప్రశ్న.
Visual 5 — ఫలితం మరియు మార్గం రెండింటినీ మూల్యాంకనం చేయండి
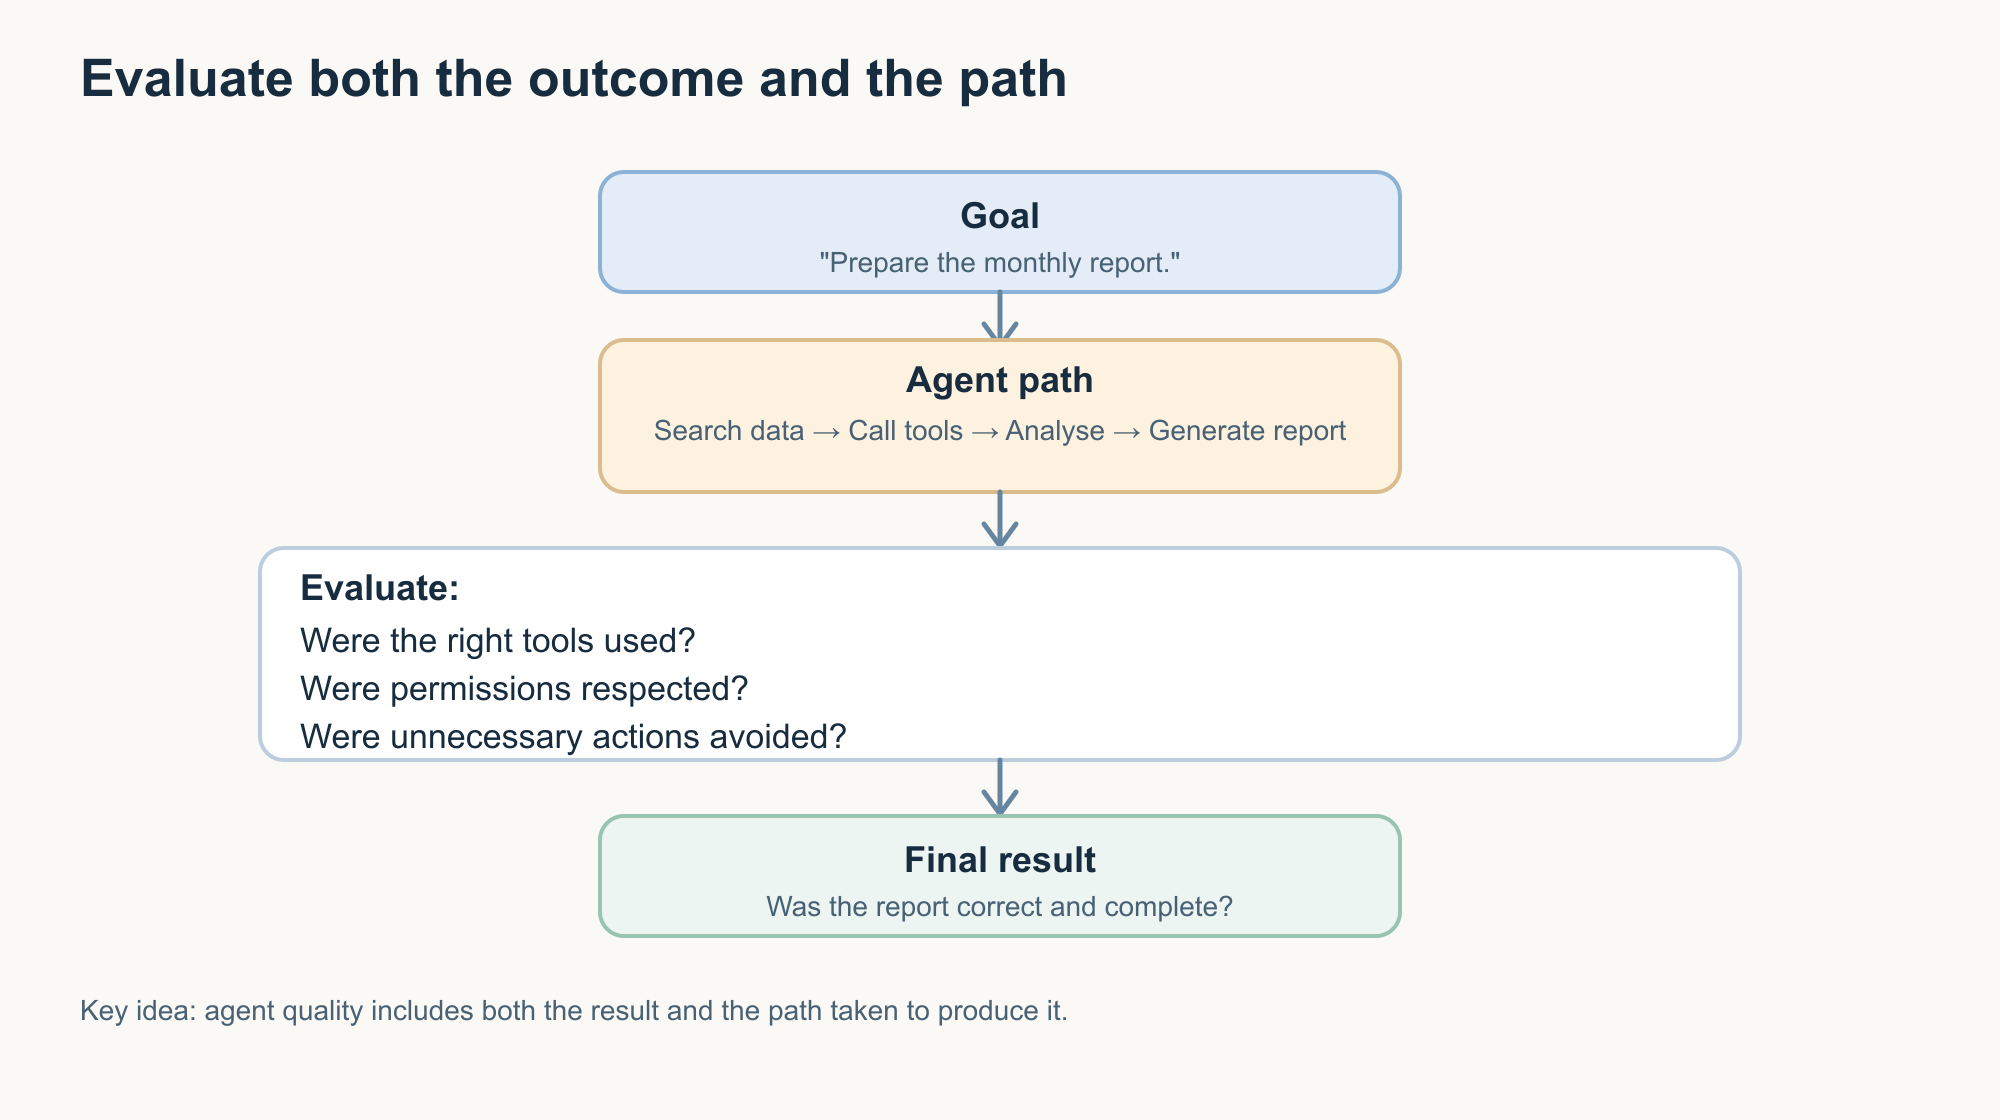
లక్ష్యం
“నెలవారీ రిపోర్ట్ను సిద్ధం చేయండి.”
ఏజెంట్ మార్గం
డేటా శోధించండి → టూల్స్ కాల్ చేయండి → విశ్లేషించండి → రిపోర్ట్ రూపొందించండి
మూల్యాంకనం చేయండి:
- సరైన టూల్స్ ఉపయోగించబడ్డాయా?
- అనుమతులు గౌరవించబడ్డాయా?
- అనవసరమైన చర్యలు నివారించబడ్డాయా?
తుది ఫలితం
రిపోర్ట్ సరైనదిగా మరియు పూర్తిగా ఉందా?
ముఖ్య విషయం: ఏజెంట్ నాణ్యతలో ఫలితం మరియు దానిని ఉత్పత్తి చేయడానికి తీసుకున్న మార్గం రెండూ ఉంటాయి.
ఒక డెమో మూల్యాంకనం కాదు
AI డెమోన్స్ట్రేషన్లు చాలా ఉపయోగకరంగా ఉంటాయి.
అవి టెక్నాలజీ ఏమి చేయగలదో చూడటంలో మాకు సహాయపడతాయి.
కానీ ఒక డెమోన్స్ట్రేషన్ సాధారణంగా చూపిస్తుంది:
ఇది ఈ పరిస్థితులలో ఒకసారి పనిచేసింది.
ఒక మూల్యాంకనం అడుగుతుంది:
ఇది ఎంత తరచుగా పనిచేస్తుంది, ఏ పరిస్థితులలో, ఎలా విఫలమవుతుంది?
ఒక AI వ్యవస్థ ఇక్కడ నుండి:
ఆసక్తికరమైన ప్రోటోటైప్
కి:
ప్రజలు ఆధారపడే విషయం కు మారుతున్నప్పుడు ఆ తేడా ముఖ్యంగా ముఖ్యమవుతుంది.
వెండర్ ఒక పాలిష్డ్ డెమోను చూపిస్తే, ఉపయోగకరమైన తదుపరి ప్రశ్నలు:
- ఎన్ని సారూప్య కేసులు పరీక్షించబడ్డాయి?
- విజయ రేటు ఎంత?
- వైఫల్య కేసులు ఏమిటి?
- సాధారణ యూజర్లు పాల్గొన్నారా?
- పరీక్ష డేటా ప్రాతినిధ్యం వహించిందా?
- అవసరమైన సమాచారం లేనప్పుడు ఏమి జరుగుతుంది?
- వ్యవస్థ ఊహించని ఇన్పుట్ను ఎదుర్కొన్నప్పుడు ఏమి జరుగుతుంది?
విఫలమైన మూల్యాంకనం ఎల్లప్పుడూ చెడు వార్త కాదు.
డిప్లాయ్మెంట్కు ముందు వైఫల్యాలను కనుగొనడం మూల్యాంకనం యొక్క ఉద్దేశాలలో ఒకటి.
లాంచ్ తర్వాత AI నాణ్యత మారవచ్చు
బలమైన ప్రీ-రిలీజ్ మూల్యాంకనం కూడా ముగింపు కాదు.
ఒక AI అప్లికేషన్ మారగల వాతావరణంలో పనిచేస్తుంది.
ఉదాహరణకు:
- అంతర్లీన మోడల్ మారవచ్చు;
- కంపెనీ డాక్యుమెంట్లు మారవచ్చు;
- రిట్రీవల్ ఇండెక్స్లు అప్డేట్ కావచ్చు;
- యూజర్లు కొత్త రకాల ప్రశ్నలు అడగవచ్చు;
- బాహ్య టూల్స్ మారవచ్చు;
- పాలసీలు మారవచ్చు;
- దాడి చేసేవారు వ్యవస్థను మార్చడానికి కొత్త మార్గాలను కనుగొనవచ్చు.
అంటే AI వ్యవస్థలకు డిప్లాయ్మెంట్ తర్వాత కూడా మానిటరింగ్ అవసరం కావచ్చు.
Google యొక్క ప్రస్తుత ఏజెంట్-మూల్యాంకన మార్గదర్శకత్వం తరచుగా జరిగే డెవలప్మెంట్ మూల్యాంకనం, షెడ్యూల్డ్ రిగ్రెషన్ టెస్టింగ్, మరియు నిరంతర ప్రొడక్షన్ మానిటరింగ్ను వేరు చేస్తుంది.
పాఠం సరళమైనది:
మూల్యాంకనం లాంచ్కు ముందు చేసే పని మాత్రమే కాదు.
ఒక్క AI స్కోరు ప్రతి ప్రశ్నకూ సమాధానం ఇవ్వలేదు
మన కల్పిత వెండర్కు తిరిగి వద్దాం.
దాని ప్రెజెంటేషన్ ఇలా చెబుతుందని ఊహించుకోండి:
AI ట్రస్ట్ స్కోరు: 92/100
స్కోరింగ్ పద్ధతి బాగా నిర్వచించబడితే అది అంతర్గతంగా ఉపయోగకరంగా ఉండవచ్చు.
కానీ అది అంతర్లీన ప్రశ్నలను దాచకూడదు.
ఒక వ్యవస్థ ఇలా ఉండవచ్చు:
- చాలా ఖచ్చితమైనది కానీ గోప్యతలో బలహీనమైనది;
- సురక్షితమైనది కానీ అవిశ్వసనీయమైనది;
- ఇంగ్లీష్కు విశ్వసనీయమైనది కానీ మరొక భాషలో పేలవమైనది;
- ప్రశ్నలకు సమాధానం ఇవ్వడంలో అద్భుతమైనది కానీ టూల్ యాక్సెస్ ఇచ్చినప్పుడు అసురక్షితమైనది;
- ఒక పరీక్షించిన జనాభాలో న్యాయమైనది కానీ మరొకదానిలో మూల్యాంకనం చేయబడలేదు.
అందుకే AI విశ్వసనీయతను ఒకే సార్వత్రిక స్కోరు కంటే అనేక అనుసంధాన కొలతలుగా అర్థం చేసుకోవడం మంచిది. NIST యొక్క ఫ్రేమ్వర్క్ చెల్లుబాటు మరియు విశ్వసనీయత, సేఫ్టీ, భద్రత మరియు స్థితిస్థాపకత, జవాబుదారీతనం మరియు పారదర్శకత, వివరణాత్మకత, గోప్యత, మరియు న్యాయబద్ధత వంటి లక్షణాలను స్పష్టంగా వేరు చేస్తుంది.
మీరే ప్రయత్నించండి: ఒక AI క్లెయిమ్ను ప్రశ్నించండి
ఇలాంటి ఒక స్టేట్మెంట్ తీసుకోండి:
“మా AI అసిస్టెంట్ 97% ఖచ్చితమైనది.”
క్లెయిమ్ మంచిదా చెడ్డదా అని వెంటనే నిర్ణయించవద్దు.
బదులుగా అడగండి:
- 97% దేనిపై?
- ఏ టెస్ట్ డేటా ఉపయోగించబడింది?
- ఎన్ని ఉదాహరణలు పరీక్షించబడ్డాయి?
- కష్టమైన మరియు సమాచారం-లేని కేసులు చేర్చబడ్డాయా?
- మన లాంటి యూజర్లపై పనితీరు కొలవబడిందా?
- మిగిలిన 3%లో ఏ రకమైన వైఫల్యాలు జరిగాయి?
- సంఖ్య కేవలం సమాధాన ఖచ్చితత్వాన్ని మాత్రమే కొలుస్తుందా, లేదా సేఫ్టీ మరియు విశ్వసనీయతను కూడానా?
- డిప్లాయ్మెంట్ తర్వాత పనితీరు పరీక్షించబడిందా?
ఇప్పుడు మరొక క్లెయిమ్ తీసుకోండి:
“మా ఏజెంట్ పూర్తిగా స్వయంప్రతిపత్తి కలిగినది.”
అడగండి:
- ఇది ఏ నిర్ణయాలు తీసుకోగలదు?
- ఏ టూల్స్ ఉపయోగించగలదు?
- ఏ చర్యలకు ఆమోదం అవసరం?
- దాని అనుమతులను మించి వెళ్లకుండా దాన్ని ఏది నివారిస్తుంది?
- టాస్క్ విజయం ఎలా కొలవబడుతుంది?
- టూల్ కాల్ల క్రమం మూల్యాంకనం చేయబడుతుందా?
- వ్యవస్థ అనిశ్చితంగా మారినప్పుడు ఏమి జరుగుతుంది?
మీరు ఇక పదాలకు ప్రతిస్పందించడం లేదు.
మీరు ఆధారం కోసం అడుగుతున్నారు.
ఈ ఆర్టికల్ అభివృద్ధి చేయడానికి ప్రయత్నిస్తున్న నైపుణ్యం ఇదే.
AI క్లెయిమ్లను మూల్యాంకనం చేయడానికి ఒక సరళమైన ఫ్రేమ్వర్క్
మీరు ఒక AI క్లెయిమ్ను ఎదుర్కొన్నప్పుడు, ఐదు ప్రశ్నలను ఉపయోగించండి.
| ప్రశ్న | అది ఏమి వెల్లడిస్తుంది |
|---|---|
| సరిగ్గా ఏమి క్లెయిమ్ చేయబడుతోంది? | అస్పష్టమైన భాషను తొలగిస్తుంది |
| అది ఎలా కొలవబడింది? | మూల్యాంకన పద్ధతిని వెల్లడిస్తుంది |
| అది దేనిపై పరీక్షించబడింది? | ఆధారం మీ వినియోగ కేసుతో సరిపోతుందో చూపిస్తుంది |
| అది ఎలా విఫలమవుతుంది? | సగటు స్కోర్ల వెనుక దాగిన పరిమితులను బహిర్గతం చేస్తుంది |
| అది విఫలమైనప్పుడు ఏ నియంత్రణలు ఉన్నాయి? | సామర్థ్యాన్ని సేఫ్టీ మరియు గవర్నెన్స్తో కనెక్ట్ చేస్తుంది |
ఈ ప్రశ్నలు క్లెయిమ్ దేనికి సంబంధించినదైనా పనిచేస్తాయి:
- ఖచ్చితత్వం;
- విశ్వసనీయత;
- భద్రత;
- స్వయంప్రతిపత్తి;
- రీజనింగ్;
- న్యాయబద్ధత;
- ఎంటర్ప్రైజ్ సంసిద్ధత.
వెండర్ స్టేట్మెంట్కు తిరిగి రండి
మనం దీనితో ప్రారంభించాం:
“మా AI 95% ఖచ్చితమైనది, ఎంటర్ప్రైజ్-రెడీ, సురక్షితం, స్వయంప్రతిపత్తి, మీ వ్యాపారంపై శిక్షణ పొందింది.”
ఇప్పుడు మనం దాన్ని మెరుగైన ప్రశ్నలుగా అనువదించవచ్చు.
“95% ఖచ్చితమైనది”
ఏ పనులపై?
ఏ ఆశించిన సమాధానాలకు వ్యతిరేకంగా?
ఏ పరిస్థితులలో?
మిగిలిన 5%లో ఏమి జరిగింది?
“ఎంటర్ప్రైజ్-రెడీ”
ఇది ఏ స్థాయిలో పనిచేసింది?
ఏ యాక్సెస్ నియంత్రణలు, మానిటరింగ్, గవర్నెన్స్, మద్దతు ఉన్నాయి?
“సురక్షితం”
ఏ బెదిరింపులకు వ్యతిరేకంగా?
క్లెయిమ్కు ఏ పరీక్ష మద్దతు ఇస్తుంది?
“స్వయంప్రతిపత్తి”
ఆమోదం లేకుండా ఇది ఏ నిర్ణయాలు మరియు చర్యలు చేయగలదు?
“మీ వ్యాపారంపై శిక్షణ పొందింది”
మోడల్ నిజంగా ఫైన్-ట్యూన్ చేయబడిందా?
లేదా అప్లికేషన్ కాంటెక్స్ట్ లేదా RAGను ఉపయోగిస్తోందా?
మార్కెటింగ్ వాక్యం తప్పనిసరిగా తప్పు కాలేదు.
అది పరీక్షించదగినదిగా మారింది.
అదే తేడా.
AI ఫ్లూయెన్సీ అంటే ప్రతి AI పదాన్ని తెలుసుకోవడం కాదు
ఈ మూడు ఆర్టికల్స్లో, మనం మూడు స్థాయిల ద్వారా సాగాం.
పార్ట్ 1 — భాషను నేర్చుకోండి
మనం ఇలాంటి పదాలు నేర్చుకున్నాం:
- AI;
- మెషిన్ లెర్నింగ్;
- జనరేటివ్ AI;
- మోడల్స్;
- LLMలు;
- ట్రైనింగ్;
- ఇన్ఫరెన్స్;
- ప్రాంప్ట్లు;
- టోకెన్లు;
- కాంటెక్స్ట్ విండోలు.
పార్ట్ 2 — అనుభవాన్ని అర్థం చేసుకోండి
AI వీటితో పనిచేసినప్పుడు ఏమి జరుగుతుందో మనం అనుసరించాం:
- గ్రౌండింగ్;
- రిట్రీవల్;
- RAG;
- మెమరీ;
- మల్టీమోడల్ ఇన్పుట్;
- టూల్స్;
- ఏజెంట్లు.
పార్ట్ 3 — వివేచనను పెంపొందించుకోండి
మనం ప్రశ్నించడం నేర్చుకున్నాం:
- ఖచ్చితత్వం;
- విశ్వసనీయత;
- బెంచ్మార్క్లు;
- మూల్యాంకనాలు;
- బయాస్;
- గోప్యత;
- భద్రత;
- గార్డ్రెయిల్స్;
- మానవ పర్యవేక్షణ;
- ఫైన్-ట్యూనింగ్ క్లెయిమ్లు;
- రీజనింగ్;
- స్వయంప్రతిపత్తి.
పదాలు తెలుసుకోవడం ఉపయోగకరం.
వ్యవస్థ ఎలా పనిచేస్తుందో అర్థం చేసుకోవడం మెరుగైనది.
కానీ రెండూ తనంతట తాము సరిపోవు.
తుది నైపుణ్యం ఏ ఆధారం కోసం అడగాలో తెలుసుకోవడం.
ఉంచుకోవాల్సిన అలవాటు
ప్రతి AI క్లెయిమ్ను సాంకేతిక ఆడిట్తో సవాలు చేయాల్సిన అవసరం లేదు.
చాలా రోజువారీ పనులకు, అది అనవసరం అవుతుంది.
కానీ సమాధానం ముఖ్యమైనప్పుడు, నిర్ణయానికి పరిణామాలు ఉన్నప్పుడు, లేదా వ్యవస్థ చర్య తీసుకోగలిగినప్పుడు, గుర్తుంచుకోవలసిన ఒక ప్రశ్న:
దీనిపై ఆధారపడటానికి నన్ను సౌకర్యవంతంగా ఏ ఆధారం చేస్తుంది?
కొన్నిసార్లు సమాధానం సరళంగా ఉంటుంది.
ఒక సోర్స్.
ఒక చిన్న పరీక్ష.
ఒక మానవ సమీక్ష.
ఒక అనుమతుల తనిఖీ.
ఇతర పరిస్థితులలో, దీనికి తీవ్రమైన మూల్యాంకనం అవసరం కావచ్చు.
ఆధార స్థాయి నిర్ణయం యొక్క ప్రాముఖ్యతకు సరిపోవాలి.
పరిశ్రమ సృష్టించే ప్రతి కొత్త పదాన్ని కంఠస్థం చేయడం కంటే అది AI ఫ్లూయెన్సీ యొక్క మరింత ఉపయోగకరమైన రూపం.
AI Fluency సిరీస్
పార్ట్ 1 — భాషను నేర్చుకోండి AI భాష: ప్రతి ఒక్కరూ అర్థం చేసుకోవాల్సిన ముఖ్యమైన పదాలు
పార్ట్ 1 AI, మెషిన్ లెర్నింగ్, జనరేటివ్ AI, మోడల్స్, LLMలు, ట్రైనింగ్, ఇన్ఫరెన్స్, ప్రాంప్ట్లు, టోకెన్లు, కాంటెక్స్ట్ విండోలను వివరిస్తుంది.
పార్ట్ 2 — అనుభవాన్ని అర్థం చేసుకోండి AI మీ ప్రశ్నలకు ఎలా సమాధానం ఇస్తుంది: అనుభవం వెనుక ఉన్న పదాలను అర్థం చేసుకోవడం
పార్ట్ 2 గ్రౌండింగ్, రిట్రీవల్, RAG, హాల్యుసినేషన్స్, మెమరీ, మల్టీమోడల్ AI, టూల్స్, ఏజెంట్లను పరిశీలిస్తుంది.
పార్ట్ 3 — వివేచనను పెంపొందించుకోండి AI క్లెయిమ్లను అర్థం చేసుకోవడం: మెరుగైన నిర్ణయాలు తీసుకోవడంలో సహాయపడే పదాలు
మీరు ఇక్కడ ఉన్నారు.
సూచనలు, మరింత చదవడానికి
- NIST — AI Risk Management Framework
AI రిస్క్లు మరియు విశ్వసనీయతను అర్థం చేసుకోవడానికి మరియు నిర్వహించడానికి ఒక ఫ్రేమ్వర్క్. - NIST — Trustworthy and Responsible AI
చెల్లుబాటు మరియు విశ్వసనీయత, సేఫ్టీ, భద్రత మరియు స్థితిస్థాపకత, జవాబుదారీతనం మరియు పారదర్శకత, వివరణాత్మకత, గోప్యత, మరియు న్యాయబద్ధతను కవర్ చేస్తుంది. - NIST AI RMF — Risks and Trustworthiness
విశ్వసనీయత లక్షణాల గురించి మరియు సందర్భంతో వాటి సంబంధం గురించి మరింత వివరణ. - Microsoft Learn — RAG and AI evaluation guidance
గ్రౌండెడ్నెస్, రిలవెన్స్, రిట్రీవల్ నాణ్యత, రెస్పాన్స్ కంప్లీట్నెస్, మరియు AI అప్లికేషన్ల మూల్యాంకనాన్ని కవర్ చేస్తుంది. - Microsoft Agent Framework — Evaluation
ఏజెంట్ టాస్క్ కంప్లీషన్, టూల్ వాడకం, గ్రౌండెడ్నెస్, రిలవెన్స్, మరియు సేఫ్టీ మూల్యాంకనాన్ని కవర్ చేస్తుంది. - Google Cloud — Agent Evaluation
టాస్క్-సక్సెస్ మూల్యాంకనం, తుది-ప్రతిస్పందన మూల్యాంకనం, ట్రాజెక్టరీ మూల్యాంకనం, రిగ్రెషన్ టెస్టింగ్, మరియు ప్రొడక్షన్ మానిటరింగ్ను కవర్ చేస్తుంది.
టెక్నాలజీ, మూల్యాంకన పద్ధతులు, మరియు ప్రొడక్ట్ పరిభాష మారుతూనే ఉంటాయి. వెండర్ పరిభాషను ప్రారంభ బిందువుగా పరిగణించండి. ముఖ్యమైన నిర్ణయాల కోసం, అంతర్లీన ఆధారాన్ని మరియు నిర్దిష్ట వ్యవస్థ డాక్యుమెంటేషన్ను తనిఖీ చేయండి.