

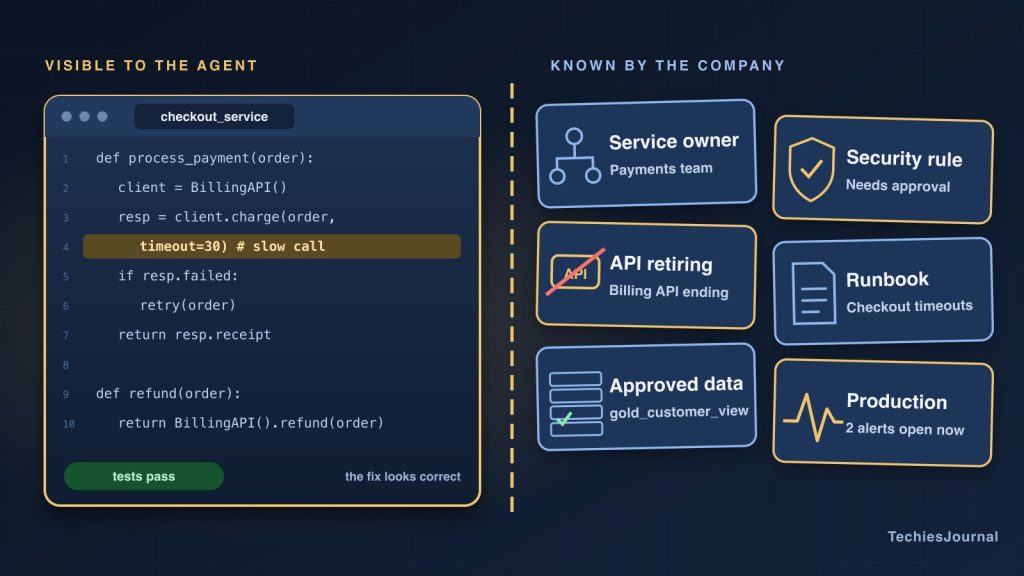
Coding agents सॉफ़्टवेयर को पढ़ने में काफ़ी बेहतर होते जा रहे हैं।
वे एक repository की जाँच कर सकते हैं, functions समझ सकते हैं, dependencies का पता लगा सकते हैं, tests लिख सकते हैं और एक साथ कई files बदल सकते हैं।
लेकिन एक समस्या है।
एक engineer को जो कुछ जानना ज़रूरी होता है, वह सब code में नहीं होता।
एक repository यह दिखा सकती है कि कोई API मौजूद है।
हो सकता है वह यह न दिखाए कि कंपनी ने उसका इस्तेमाल बंद करने का फ़ैसला कर लिया है।
वह दो customer tables दिखा सकती है।
हो सकता है वह यह न दिखाए कि business असल में किस पर भरोसा करता है।
वह यह दिखा सकती है कि कोई service कैसे deploy की गई है।
हो सकता है वह यह न दिखाए कि production में बदलावों को किसी दूसरी team को मंज़ूर करना होता है।
इससे एक अहम फ़र्क़ पैदा होता है:
एक coding agent code को समझ सकता है और फिर भी ग़लत फ़ैसला ले सकता है, क्योंकि वह यह नहीं समझता कि कंपनी कैसे काम करती है।
इस चित्र का पाठ-विकल्प
दो कॉलम। Repository क्या दिखाती है, जो agent को दिखाई देता है: source code, tests, APIs और configuration। कंपनी और क्या जान सकती है, जो अक्सर repository के बाहर होता है: service की ownership, स्वीकृत systems और data, security के नियम और production की स्थिति।
एक सरल production समस्या की कल्पना कीजिए
मान लीजिए एक developer किसी coding agent से कहता है:
Checkout service का timeout ठीक करो।
Agent repository खोलता है।
उसे checkout service मिल जाती है।
उसे धीमी call मिल जाती है।
वह एक संभावित समाधान पहचान लेता है।
केवल code को देखें तो जवाब सही लग सकता है।
लेकिन एक अनुभवी engineer कुछ ऐसा जान सकता है जो agent नहीं जानता।
शायद वह service ऐसी API पर निर्भर है जिसे बंद किया जा रहा है।
शायद उस dependency की ज़िम्मेदारी किसी दूसरी team के पास है।
शायद कोई security नियम एक तरह के बदलाव को रोकता है।
शायद इस समस्या का वर्णन करने वाला कोई runbook पहले से मौजूद है।
शायद checkout में production के बदलावों के लिए अतिरिक्त मंज़ूरी चाहिए।
इनमें से कोई भी बात source code में ज़रूरी नहीं कि दिखे।
इसलिए agent ऐसा बदलाव तैयार कर सकता है जो तकनीकी रूप से सही हो, पर कंपनी के लिए ग़लत हो।
यह समस्या coding से बड़ी है
इंसान engineers शायद ही कभी केवल source code के भरोसे काम करते हैं।
वे इनका भी इस्तेमाल करते हैं:
- team का ज्ञान
- architecture के नियम
- documentation
- tickets
- monitoring
- deployment की प्रक्रियाएँ
- security policies
- दूसरी teams के साथ बातचीत।
समय के साथ engineers ऐसी बातें सीख लेते हैं:
नए काम के लिए इस API का इस्तेमाल मत करो।
यह dataset नया लगता है, लेकिन validated वाला इस्तेमाल करो।
इस service की ज़िम्मेदारी Payments के पास है।
इस production बदलाव के लिए मंज़ूरी चाहिए।
यह failure आम तौर पर बताती है कि कोई दूसरा system उपलब्ध नहीं है।
यह ज्ञान उन्हें सही फ़ैसला लेने में मदद करता है।
एक coding agent को भी उस जानकारी में से कुछ चाहिए।
Database का उदाहरण
एक सरल उदाहरण पर विचार कीजिए।
एक coding agent को customer data चाहिए।
उसे दो tables मिलती हैं:
customer_master_v2
और
gold_customer_view
पहली वाली ज़्यादा नई लगती है।
केवल नाम और schemas देखने वाला agent उसे इस्तेमाल करने का फ़ैसला कर सकता है।
लेकिन कंपनी की data team जान सकती है कि gold_customer_view ही स्वीकृत स्रोत है, क्योंकि उसकी validation पूरी हो चुकी है।
Agent की लिखी SQL बिल्कुल सही हो सकती है।
Program चल सकता है।
Data भी ठीक-ठाक दिख सकता है।
लेकिन agent ने फिर भी ग़लत स्रोत चुना।
समस्या ख़राब coding की नहीं थी।
समस्या कंपनी की जानकारी के न होने की थी।
इसीलिए coding assistants repository के बाहर देखना शुरू कर रहे हैं
प्रमुख coding platforms इस पर ध्यान देना शुरू कर रहे हैं।
GitHub Copilot कंपनियों और repositories को यह निर्देश देने देता है कि काम कैसे किया जाना चाहिए।
Google का Data Agent Kit coding agents को कंपनी के data environment की जानकारी तक पहुँचने में मदद करता है।
OpenAI और Anthropic ऐसे तरीक़े देते हैं जिनसे coding agents कंपनी के निर्देशों का इस्तेमाल कर सकते हैं और दूसरे tools और systems से जुड़ सकते हैं।
Products अलग हैं, लेकिन दिशा एक जैसी है।
Coding agents को ऐसी जानकारी दी जा रही है जो स्वाभाविक रूप से source code में नहीं रहती।
इसमें ये शामिल हो सकते हैं:
- कौन-सा system इस्तेमाल होना चाहिए
- किसी service का मालिक कौन है
- testing कैसे की जानी चाहिए
- कौन-सा data source स्वीकृत है
- production में अभी क्या हो रहा है।
अहम बात tool का नाम नहीं है।
अहम बात यह है कि अब repository काफ़ी नहीं है।
लेकिन agent को सब कुछ दे देना समाधान नहीं है
एक साफ़ समाधान दिखता है:
Coding agent को कंपनी की सारी जानकारी तक पहुँच दे दो।
इससे एक अलग समस्या पैदा होती है।
एक कंपनी के पास हज़ारों documents, tickets, संदेश और policies हो सकती हैं।
कुछ पुराने होंगे।
कुछ आपस में टकराएँगे।
कुछ अप्रासंगिक होंगे।
कुछ में संवेदनशील जानकारी होगी।
अगर यह सब agent को दे दिया जाए, तो agent ज़्यादा सक्षम होने के बजाय और ज़्यादा उलझ सकता है।
इसलिए लक्ष्य यह नहीं होना चाहिए:
Agent को वह सब दे दो जो हम जानते हैं।
एक बेहतर लक्ष्य यह है:
Agent को उस काम के लिए सही जानकारी दो।
अगर agent checkout ठीक कर रहा है, तो उसे checkout runbook, service की ownership की जानकारी और production के मौजूदा alerts की ज़रूरत पड़ सकती है।
उसे शायद HR documents या असंबंधित customer records की ज़रूरत नहीं होगी।
जानकारी भरोसेमंद भी होनी चाहिए
एक और मुद्दा है।
मान लीजिए एक पुराना document कुछ कहता है और मौजूदा security policy कुछ और।
Agent को किसका पालन करना चाहिए?
इंसान engineers अक्सर इसे अनुभव से सुलझा लेते हैं।
वे जानते हैं कि कौन-सा document मौजूदा है।
वे जानते हैं कि किस team के पास अधिकार है।
वे जानते हैं कि कौन-से नियम अनिवार्य हैं।
एक AI agent शायद यह न जान पाए, जब तक कंपनी इसे साफ़ न कर दे।
इसका मतलब है कि संगठनों को केवल इस बारे में नहीं सोचना होगा:
Agent कौन-सी जानकारी तक पहुँच सकता है?
बल्कि इस बारे में भी:
Agent को किस जानकारी पर भरोसा करना चाहिए?
जैसे-जैसे agents को बड़े बदलाव करने की अनुमति मिलेगी, यह और ज़्यादा अहम हो सकता है।
एक व्यावहारिक सवाल से शुरू कीजिए
कंपनियों को तुरंत कोई विशाल AI knowledge system बनाने की ज़रूरत नहीं है।
इसके बजाय एक कहीं सरल शुरुआत संभव है।
कोई एक ऐसा काम लीजिए जो coding agents पहले से करते हैं और पूछिए:
एक अनुभवी engineer को ऐसा क्या जानना पड़ेगा जो repository में नहीं है?
किसी production fix के लिए इसमें ये शामिल हो सकते हैं:
- service की ownership
- deployment के नियम
- security की पाबंदियाँ
- मौजूदा incident की स्थिति।
किसी data के काम के लिए इसमें ये शामिल हो सकते हैं:
- स्वीकृत dataset
- business की परिभाषाएँ
- data-quality के नियम।
किसी नए feature के लिए इसमें ये शामिल हो सकते हैं:
- architecture के फ़ैसले
- स्वीकृत libraries
- product की ज़रूरतें।
फिर पूछिए:
वह जानकारी आज कहाँ रहती है?
यह सवाल तब भी उपयोगी है जब कंपनी कभी coding agents अपनाए ही नहीं।
अगर जवाब यह है:
केवल एक engineer को यह पता है।
तो कंपनी के सामने पहले से ही ज्ञान की समस्या है।
Coding agents एक पुरानी engineering समस्या को उजागर कर सकते हैं
यह coding agents के ज़्यादा दिलचस्प नतीजों में से एक हो सकता है।
कंपनियों में अहम ज्ञान हमेशा इन जगहों पर बिखरा रहा है:
- repositories
- documents
- tickets
- dashboards
- team की बातचीत
- लोगों की याददाश्त।
इंसान इन टुकड़ों को जोड़ने में अच्छे हो गए।
Coding agents इस बिखराव को ज़्यादा साफ़ दिखा देते हैं।
अगर कोई agent ज़रूरी जानकारी न होने की वजह से काम सुरक्षित रूप से पूरा नहीं कर पाता, तो हो सकता है कि असली मुद्दा कोई नई AI समस्या न हो।
हो सकता है संगठन ने उस जानकारी को शुरू में कभी साफ़ किया ही नहीं।
नज़रिया
Coding agents सॉफ़्टवेयर को समझने में बेहतर होते जा रहे हैं।
लेकिन सॉफ़्टवेयर को समझना और उसे चलाने वाली कंपनी को समझना एक ही बात नहीं है।
Repository agent को बता सकती है कि code क्या करता है।
हो सकता है वह agent को यह न बताए:
- कंपनी किस system पर भरोसा करती है
- कौन-सी team service की मालिक है
- कौन-सा नियम प्राथमिकता रखता है
- कौन-सा बदलाव अनुमत है
- अभी क्या हो रहा है।
इसीलिए coding agents के विकास का अगला चरण बेहतर models जितना ही context पर भी निर्भर हो सकता है।
यह पूछने से पहले:
हमारा coding agent कितना शक्तिशाली है?
शायद एक ज़्यादा उपयोगी सवाल यह हो सकता है:
क्या agent को हमारी कंपनी के काम करने के तरीक़े के बारे में इतना पता है कि वह सही फ़ैसला ले सके?
अगर जवाब नहीं है, तो उसे और मज़बूत model देने से समस्या शायद हल न हो।
सही जानकारी देने से हो सकती है।
संबंधित लेख: AI Agents Need Identities, Not API Keys देखता है कि एक agent कैसे साबित करता है कि वह कौन है, और MCP, A2A and WebMCP: Three Connections an AI Agent May Need देखता है कि agents दूसरे tools और systems से कैसे जुड़ते हैं।
स्रोत और आगे पढ़ने के लिए
स्रोत समीक्षा: 5 अक्टूबर 2026।
- GitHub Docs — Custom instructions for GitHub Copilot. Repository-wide, path-specific, agent और organization के निर्देश, और वे किस क्रम में लागू होते हैं।
- GitHub Docs — Adding organization custom instructions for GitHub Copilot. Organization के owners ऐसे निर्देश कैसे तय करते हैं जो पूरे organization के सदस्यों पर लागू होते हैं।
- GitHub Docs — Managing custom properties for repositories in your organization. Repositories का वर्णन करने वाले structured metadata fields, जैसे ownership या criticality।
- Google Cloud — Data Agent Kit overview. Coding agents development environment से Google Cloud की data services के साथ कैसे काम कर सकते हैं।
- OpenAI Developer Documentation — Agent Skills for Codex. Codex के लिए पैकेज किए गए, किसी खास काम के निर्देश। AGENTS.md पर साथ वाली गाइड ChatGPT Learn पर है।
- OpenAI Developer Blog — Shell, Skills and Compaction. दोहराई जा सकने वाली प्रक्रियाओं को skills के रूप में पैकेज करने पर OpenAI का मार्गदर्शन।
- Anthropic — Connect Claude Code to tools via MCP. Claude Code remote tools और data sources से कैसे जुड़ता है।
- Anthropic — Claude Code managed settings. Claude Code के लिए organization-स्तर के नियंत्रण, जिनमें यह भी शामिल है कि कौन-से tool connections अनुमत हैं।